
하둡 에코시스템의 구성과 각 프로젝트의 역할

저번 포스팅에서는, Map Reduce 에 대하여 공부하였습니다. 지금까지 HDFS, YARN, MapReduce 라는 하둡의 핵심 세 가지를 차례로 살펴보았는데, 실제 현장에서 "하둡을 쓴다" 고 말할 때 이 셋만 쓰는 경우는 거의 없습니다. 그 주변에는 데이터를 가져오고, 질의하고, 스케줄링하고, 권한을 관리하는 프로젝트들이 겹겹이 붙어 있으며, 이것들을 한데 묶어 하둡 에코시스템(Hadoop Ecosystem) 이라고 부릅니다.
이번에는 그 에코시스템에 어떤 것들이 있고, 각각 대략 어떤 역할을 맡는지 한 번 정리해보려 합니다. 개별 기술을 깊게 파는 글이라기보다는, 지도를 한 장 그려두고 나중에 필요할 때 찾아올 수 있도록 하는 것이 목적입니다. 그리고 지금은 개발이 멈췄거나 Apache Attic 으로 물러난 프로젝트들도 일부러 함께 담았습니다. 오래된 클러스터나 예전 자료를 보다 보면 여전히 마주치게 되는 이름들이고, "왜 이게 쓰였고 왜 밀려났는지" 를 아는 것이 결국 지금 쓰는 도구를 이해하는 데에도 도움이 되기 때문입니다.
📘 분산 시스템의 이해와 하둡의 등장 배경 📘 하둡의 핵심 구성요소와 이론 📘 YARN(Yet Another Resource Negotiator) 기본 이론 📘 Map Reduce 기본 이론과 실습
1. 에코시스템을 계층으로 보기
하둡 관련 프로젝트를 처음 접하면 이름만 수십 개라 어디서부터 봐야 할지 막막합니다. 저는 이름을 하나씩 외우는 대신 "데이터가 흘러가는 순서" 로 줄을 세워보니 훨씬 정리가 잘 되었습니다.
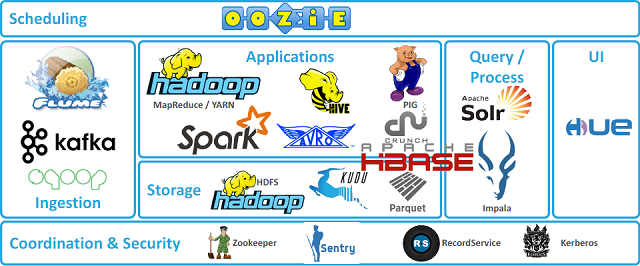
출처 : 하둡 에코시스템 구성도
데이터는 대체로 다음과 같은 순서를 지나갑니다.
- 가져오기 (Ingestion) : 외부 데이터베이스나 로그, 메시지 큐에서 데이터를 클러스터 안으로 끌어옵니다.
- 저장하기 (Storage) : 가져온 데이터를 분산 파일 시스템이나 분산 데이터베이스에 쌓습니다.
- 자원 나누기 (Resource Management) : 그 데이터를 처리할 작업에 CPU 와 메모리를 배분합니다.
- 처리하기 (Processing) : 배분받은 자원 위에서 실제 연산을 수행합니다.
- 질의하기 (Query) : 처리한 결과를 사람이 SQL 같은 익숙한 언어로 꺼내 봅니다.
- 엮고 지키기 (Orchestration & Governance) : 이 모든 단계를 순서대로 실행하고, 클러스터의 상태를 합의하고, 권한을 통제합니다.
에코시스템의 프로젝트들은 대부분 이 여섯 자리 중 하나에 들어갑니다. 아래에서는 이 순서를 따라가며 각 자리에 어떤 프로젝트가 있는지 살펴보겠습니다.
1.1. 왜 이렇게 여러 개로 나뉘어 있을까
하둡이 처음 나왔을 때는 저장은 HDFS, 처리는 MapReduce 라는 두 축이 전부였습니다. 그런데 실제로 쓰다 보니 "MapReduce 코드를 직접 짜는 일" 자체가 부담이었습니다. 간단한 집계 하나를 위해 Java 클래스를 몇 개씩 만들어야 했으니까요.
그래서 SQL 로 쓰면 MapReduce 로 바꿔주는 도구(Hive)가 나왔고, 스크립트로 데이터 흐름을 표현하고 싶다는 요구에서 또 다른 도구(Pig)가 나왔으며, 배치가 아니라 실시간에 가깝게 읽고 쓰고 싶다는 요구에서 분산 데이터베이스(HBase)가 나왔습니다. 즉 에코시스템은 한 번에 설계된 것이 아니라, 핵심에서 부족했던 부분을 채우는 프로젝트가 하나씩 붙어 만들어진 결과입니다. 그래서 이름이 아무리 많아 보여도, 각 프로젝트가 "무엇이 불편해서 나왔는지" 를 함께 기억하면 훨씬 오래 남습니다.
1.2. 사실 하둡도 다른 프로젝트에서 떨어져 나왔다
재미있는 점은 하둡 자신도 처음부터 독립 프로젝트가 아니었다는 사실입니다. 하둡은 원래 Apache Nutch 라는 오픈소스 웹 검색 엔진 프로젝트의 하위 모듈로 출발했습니다. Nutch 팀은 웹 전체를 크롤링해 색인을 만들려 했는데, 그러려면 수십억 개의 페이지를 저장하고 처리할 기반이 필요했습니다. 마침 구글이 발표한 GFS 와 MapReduce 논문을 참고해 이 기반을 구현했고, 이 부분이 검색과는 별개로 쓸모가 있다는 것이 드러나면서 2006년 하둡이라는 이름으로 독립하게 되었습니다.
에코시스템이 계속 갈라져 나가는 방식 자체가, 하둡이 태어난 방식과 같다는 점이 개인적으로는 인상 깊었습니다.
2. 저장 계층
데이터가 실제로 앉는 자리입니다. 파일 단위로 크게 쌓는 쪽과, 레코드 단위로 빠르게 찾아 쓰는 쪽이 나뉩니다.
2.1. HDFS (Hadoop Distributed File System)
하둡의 분산 파일 시스템이며, 에코시스템 대부분이 이 위에 데이터를 올려둡니다. 큰 파일을 블록으로 쪼개 여러 노드에 복제해 두고, 노드 하나가 죽어도 읽기가 계속되도록 만든 것이 핵심입니다. 한 번 쓰고 여러 번 읽는(Write Once, Read Many) 패턴에 맞춰 설계되어 있어, 파일 중간을 수정하는 작업에는 어울리지 않습니다. "대용량을 순차로 훑는 일" 에 강한 저장소라고 이해하면 편합니다.
HDFS 의 내부 구조와 읽기·쓰기 흐름, 고가용성 구성, 그리고 Hadoop 3 에서 들어온 Erasure Coding 은 하둡의 핵심 구성요소와 이론 에서 자세히 다루었습니다.
2.2. Apache HBase
HDFS 위에서 동작하는 분산 NoSQL 데이터베이스입니다. HDFS 가 파일을 통째로 훑는 데 강하다면, HBase 는 수십억 건 중에서 특정 행 하나를 밀리초 단위로 찾아오는 데 강합니다. 구글의 Bigtable 논문을 따른 구조로, 행 키(Row Key)를 기준으로 데이터를 정렬해 저장합니다. 그래서 행 키를 어떻게 설계하느냐가 성능의 대부분을 결정합니다. 특정 키 구간에 쓰기가 몰리면 한 리전 서버만 뜨거워지는(Hotspotting) 문제가 생기기 때문입니다.
배치 분석용 저장소 위에 실시간 조회 창구를 하나 더 얹는 그림이라고 보면 이해가 쉽습니다.
2.3. Apache Kudu
HDFS 와 HBase 사이의 빈자리를 겨냥해 나온 저장소입니다. HDFS 는 스캔에 강하지만 수정이 어렵고, HBase 는 단건 조회에 강하지만 대량 스캔 분석에는 부담이 있었습니다. Kudu 는 컬럼 지향으로 저장하면서도 행 단위 갱신을 지원해, 계속 바뀌는 데이터를 곧바로 분석 질의에 태우는 용도를 노렸습니다. Impala 와 짝을 이뤄 쓰이는 경우가 많았습니다.
2.4. Apache Ozone
비교적 최근에 하둡 진영에서 나온 오브젝트 스토리지입니다. HDFS 의 네임노드가 파일 메타데이터를 메모리에 들고 있다 보니, 작은 파일이 수억 개가 되면 데이터 용량보다 네임노드가 먼저 한계에 부딪히는 문제가 있었습니다.
Ozone 은 메타데이터 관리 구조를 분리해 이 한계를 완화하고, S3 호환 인터페이스를 제공해 클라우드 환경과도 맞물리도록 설계되었습니다. HDFS 를 당장 대체한다기보다, 작은 파일이 아주 많은 워크로드를 위한 선택지가 하나 더 생겼다고 보는 편이 맞습니다.
2.5. Alluxio
저장소라기보다 저장소 앞에 놓이는 캐시 계층입니다. 과거 Tachyon 이라는 이름이었습니다. 연산 노드와 저장소가 물리적으로 떨어져 있을 때(예를 들어 클라우드에서 오브젝트 스토리지를 쓰는 경우) 같은 데이터를 반복해서 읽으면 네트워크 비용이 계속 발생합니다. Alluxio 는 자주 읽는 데이터를 메모리에 들고 있으면서 이 비용을 줄여줍니다.
데이터 지역성(Data Locality) 이 무너진 환경에서 그 손실을 다시 메우려는 시도라고 이해하면 되겠습니다.
3. 자원 관리 계층
3.1. YARN (Yet Another Resource Negotiator)
클러스터의 CPU 와 메모리를 어떤 작업에 얼마나 줄지 결정하는 자리입니다. Hadoop 2.0 에서 MapReduce 로부터 자원 관리 역할을 떼어낸 덕분에, 같은 클러스터 위에서 MapReduce 와 Spark 같은 서로 다른 엔진이 함께 돌 수 있게 되었습니다.
에코시스템에서 YARN 이 중요한 이유가 바로 여기에 있습니다. 처리 엔진이 여러 개로 늘어날 수 있었던 것은, 자원 관리가 따로 떨어져 나왔기 때문입니다. 스케줄러와 큐, 아키텍처 전반은 YARN 기본 이론 에 정리해 두었습니다.
3.2. Apache Mesos 와 Kubernetes
같은 자리를 놓고 YARN 과 경쟁했던 이름들입니다.
- Mesos : 하둡 계열에 한정되지 않는 범용 클러스터 자원 관리자입니다. 한때 Spark 를 돌리는 주요 선택지 중 하나였으나, 지금은 사실상 개발이 멈춰 Apache Attic 으로 물러났습니다.
- Kubernetes : 컨테이너 오케스트레이터로 출발했지만, 지금은 Spark 나 Flink 를 띄우는 자리에서 YARN 을 대신하는 경우가 많아졌습니다. Spark 는 3.1 부터 쿠버네티스 지원이 정식(GA)이 되었습니다.
정리하면, "자원을 나눠주는 자리" 는 하나이지만 그 자리에 앉는 도구는 YARN → Mesos → Kubernetes 순으로 무게 중심이 옮겨왔다고 볼 수 있습니다.
4. 처리 계층
자원을 받아 실제 연산을 수행하는 엔진들입니다. 같은 자리를 놓고 세대가 여러 번 교체되어 온 영역이기도 합니다.
4.1. MapReduce
Map 과 Reduce 두 단계로 데이터를 나눠 처리하는, 하둡의 1세대 처리 엔진입니다. 단계 사이의 중간 결과를 디스크에 쓰기 때문에 안정적인 대신 느립니다.
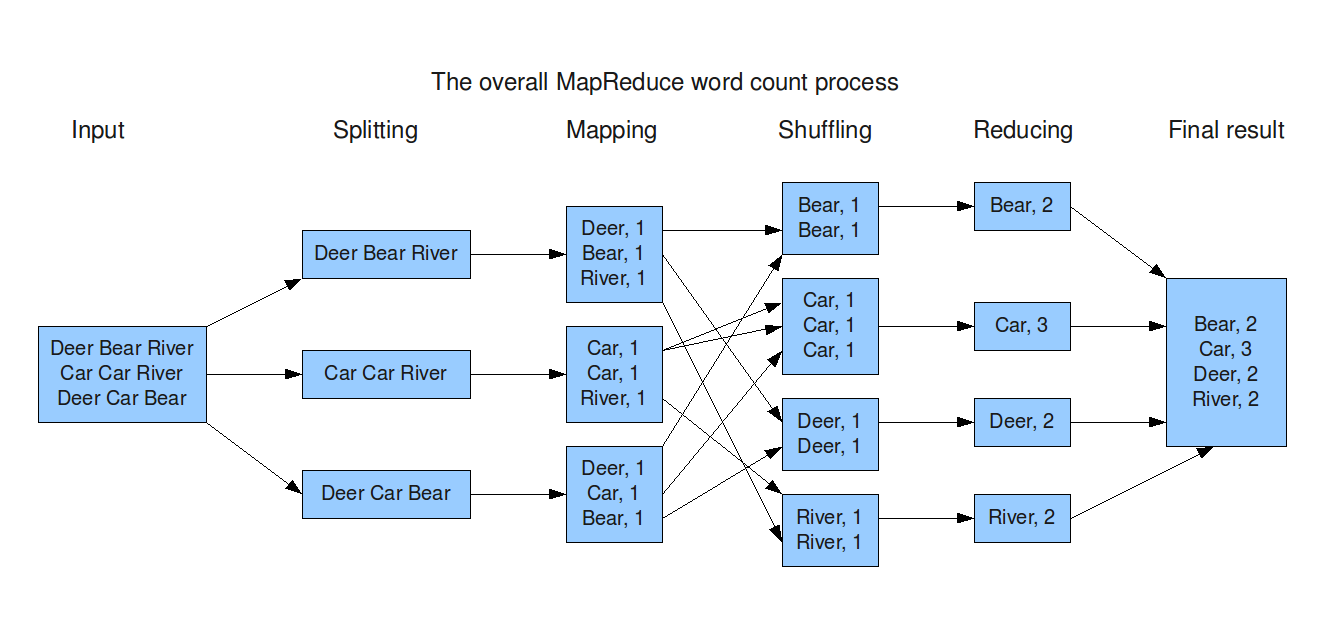
출처 : MapReduce 처리 흐름
지금은 새 파이프라인을 MapReduce 로 짜는 경우가 거의 없지만, 분산 처리의 기본 개념을 이해하는 출발점으로서의 가치는 여전하다고 생각합니다. 자세한 동작 방식은 Map Reduce 기본 이론과 실습 에서 다루었습니다.
4.2. Hadoop Streaming
MapReduce 를 Java 가 아닌 언어로 쓰기 위한 장치입니다. 표준 입력으로 받아 표준 출력으로 내보내는 프로그램이기만 하면, Python 이든 셸 스크립트든 Mapper 와 Reducer 로 쓸 수 있게 해줍니다. Java 를 쓰지 않는 분석가들이 하둡에 처음 발을 들이는 통로 역할을 했던 기능입니다.
4.3. Apache Tez
MapReduce 의 "단계마다 디스크에 떨군다" 는 제약을 걷어내기 위해 나온 실행 엔진입니다. 작업을 Map 과 Reduce 의 반복이 아니라 하나의 DAG(Directed Acyclic Graph, 방향성 비순환 그래프) 로 표현해, 불필요한 중간 저장을 줄입니다.
주로 사용자가 직접 쓰기보다는 Hive 가 내부적으로 선택하는 실행 엔진으로 만나게 됩니다. 같은 Hive 쿼리라도 실행 엔진을 MapReduce 에서 Tez 로 바꾸면 속도가 확 달라지는 이유가 여기에 있습니다.
4.4. Apache Spark
중간 결과를 가능한 한 메모리에 두고 처리하는 엔진으로, 현재 이 자리의 사실상 표준입니다. 배치뿐 아니라 스트리밍(Structured Streaming), 머신러닝(MLlib), SQL(Spark SQL), 그래프(GraphX) 까지 하나의 프레임워크로 다루는 점이 강점입니다.
Spark 는 하둡 없이도 동작하지만, 저장소로 HDFS 를, 자원 관리자로 YARN 을 쓰는 조합이 오랫동안 널리 쓰였습니다. 하둡을 공부하는 일이 Spark 를 이해하는 데에도 도움이 되는 이유가 여기에 있습니다.
4.5. Apache Flink
Spark 가 배치를 기본으로 두고 스트리밍을 얹었다면, Flink 는 스트리밍을 기본으로 두고 배치를 그 특수한 경우로 다룹니다. 이벤트가 발생한 시각(Event Time)을 기준으로 창(Window)을 나누고, 늦게 도착한 데이터까지 다룰 수 있게 설계되어 있어 실시간 처리에 강점이 있습니다. 상태(State)를 엔진이 직접 관리하고 체크포인트로 복구하는 구조도 특징입니다.
4.6. Apache Storm 과 Apache Samza
Flink 이전에 실시간 처리 자리를 맡았던 이름들입니다.
- Storm : 들어온 이벤트를 한 건씩 흘려보내며 처리하는 구조로, 지연 시간이 매우 짧다는 점이 강점이었습니다. 다만 정확히 한 번(Exactly-once) 처리 보장이나 상태 관리 면에서 후발 주자에 밀렸습니다.
- Samza : LinkedIn 에서 만들어진 스트림 처리 프레임워크로, Kafka 와 YARN 을 전제로 설계된 점이 특징이었습니다.
두 프로젝트 모두 지금은 Spark Streaming 과 Flink 에 자리를 거의 내준 상태입니다.
4.7. Apache Mahout
하둡 위에서 머신러닝 알고리즘을 돌리기 위한 라이브러리였습니다. 추천, 군집화, 분류 알고리즘을 MapReduce 로 구현해 제공했습니다. 다만 MapReduce 로 반복 연산을 수행하는 방식은 머신러닝에 특히 불리했습니다. 반복할 때마다 디스크를 거쳐야 했기 때문입니다. 그래서 Mahout 은 이후 MapReduce 기반 알고리즘을 걷어내고 Spark 위로 방향을 바꿨지만, 그 사이 Spark MLlib 이 이미 자리를 잡은 뒤였습니다.
5. 질의 계층
처리 결과를 사람이 익숙한 언어로 꺼내 보는 자리입니다. 대부분 SQL 을 입구로 삼습니다.
5.1. Apache Hive
HDFS 에 쌓인 파일에 테이블이라는 옷을 입혀 SQL 로 조회할 수 있게 해주는 프로젝트입니다. 사용자가 HiveQL 로 쿼리를 쓰면 Hive 가 이를 MapReduce 나 Tez, Spark 작업으로 바꿔 실행합니다.
여기서 반드시 함께 기억할 것이 Hive Metastore 입니다. 어떤 경로의 파일이 어떤 스키마를 가진 어떤 테이블인지를 담아두는 카탈로그인데, Hive 뿐 아니라 Spark, Presto, Impala 같은 다른 엔진들도 이 메타스토어를 함께 바라봅니다. 그래서 실무에서는 Hive 자체보다 메타스토어가 더 오래 살아남는 경우가 많습니다.
Hive 의 응답 속도를 끌어올리기 위해 도입된 LLAP(Live Long And Process) 도 함께 알아둘 만합니다. 데몬을 상주시켜 데이터를 캐시해 두고 질의를 받는 구조로, 뒤에 나올 상주형 엔진들과 같은 문제의식에서 나왔습니다.
5.2. Apache Impala 와 Trino
Hive 가 쿼리를 배치 작업으로 바꿔 실행하다 보니, 아무리 단순한 질의라도 응답까지 시간이 걸린다는 불만이 있었습니다. 이를 해결하기 위해 질의 전용으로 상주하는 엔진들이 등장했습니다.
- Impala : Cloudera 에서 만들어 이후 Apache 프로젝트가 된 엔진입니다. 하둡 클러스터에 데몬 형태로 상주하며 HDFS·HBase·Kudu 데이터를 직접 읽어 응답합니다.
- Trino : 과거 Presto 라는 이름으로 알려졌던 엔진으로, 2020년 Trino 로 이름이 바뀌었습니다. 하둡뿐 아니라 여러 저장소를 커넥터로 묶어 한 번에 질의할 수 있다는 점이 특징입니다.
둘 다 중간 결과를 디스크에 떨구지 않고 메모리에서 처리하기 때문에 대화형 질의에 적합합니다. 대신 아주 무거운 배치 작업에는 오히려 어울리지 않을 수 있습니다.
5.3. Apache Drill
스키마를 미리 정의하지 않아도 JSON 이나 Parquet 파일에 바로 SQL 을 던질 수 있다는 점을 내세운 질의 엔진입니다. Schema-free SQL 이라는 표현을 썼습니다. 탐색적으로 데이터를 들여다보는 용도에서는 편했지만, Trino 와 Spark SQL 이 같은 영역을 넓게 덮으면서 지금은 활발히 쓰이지는 않습니다.
5.4. Apache Phoenix
HBase 위에 SQL 계층을 얹어주는 프로젝트입니다. HBase 는 기본적으로 API 로 다뤄야 하는데, Phoenix 를 쓰면 JDBC 로 접속해 SQL 로 조회하고 보조 인덱스까지 쓸 수 있습니다. HBase 를 쓰는데 개발자들이 SQL 을 요구할 때 그 중간을 메워준 도구라고 보면 됩니다.
5.5. Apache Kylin
OLAP 큐브를 미리 만들어두는 방식으로 대용량 집계 질의에 대응하는 엔진입니다. 자주 쓰는 차원 조합의 집계 결과를 사전에 계산해 HBase 등에 저장해두고, 질의가 들어오면 이미 계산된 값을 꺼내주는 구조입니다. 질의 시점에 계산하는 대신 미리 계산해두고 꺼내 쓴다는, 전통적인 데이터 웨어하우스의 접근을 하둡 위에 옮겨온 사례입니다.
5.6. Apache Solr
Lucene 기반의 분산 검색 엔진입니다. 엄밀히 하둡 프로젝트는 아니지만, 하둡에 쌓인 데이터를 색인해 전문 검색(Full-text Search)을 제공하는 조합으로 함께 자주 쓰였습니다. 앞서 말했듯 하둡 자체가 검색 엔진 프로젝트에서 갈라져 나왔다는 점을 떠올리면, 이 둘이 다시 만나는 그림이 흥미롭게 느껴집니다.
6. 데이터 수집 계층
클러스터 바깥의 데이터를 안으로 들여오는 자리입니다.
6.1. Apache Sqoop
관계형 데이터베이스와 하둡 사이에서 데이터를 옮기기 위한 도구입니다. 이름부터가 SQL 과 Hadoop 을 합친 것입니다. MySQL 이나 Oracle 의 테이블을 HDFS 나 Hive 로 가져오고(import), 반대로 내보내는(export) 일을 MapReduce 작업으로 수행합니다.
다만 Sqoop 은 2021년 Apache Attic 으로 이동해 더 이상 개발되지 않습니다. 기존 클러스터에서는 여전히 마주치게 되지만, 새로 구성한다면 Spark JDBC 나 CDC(Change Data Capture) 도구 같은 다른 수단을 찾게 되는 자리입니다.
6.2. Apache Flume
로그처럼 끊임없이 흘러들어오는 데이터를 모아 HDFS 로 넣기 위한 도구입니다. Source 에서 받아 Channel 에 담아두고 Sink 로 내보내는 구조라, 중간에 버퍼를 두어 유실을 줄입니다. Flume 역시 지금은 개발이 사실상 멈춘 상태이며, 같은 자리를 Kafka 나 NiFi 가 맡는 경우가 많아졌습니다. 다만 수집 파이프라인을 Source · Channel · Sink 로 나눠 보는 사고방식 자체는 지금 도구들에도 그대로 남아 있습니다.
6.3. Apache Kafka
엄밀히 말하면 하둡에서 출발한 프로젝트는 아니지만, 오늘날 수집 계층에서 가장 자주 만나는 이름입니다. 발행-구독(Pub-Sub) 구조의 분산 메시지 큐로, 데이터를 보내는 쪽과 받는 쪽을 떼어놓는 완충 지대 역할을 합니다.
수집한 데이터를 Kafka 에 먼저 쌓아두고, 그 뒤에서 Spark 나 Flink 가 꺼내 처리하는 구성이 널리 쓰입니다. 참고로 Kafka 도 예전에는 브로커 관리에 ZooKeeper 를 썼지만, 지금은 자체 합의 방식인 KRaft 로 넘어오며 ZooKeeper 의존을 걷어냈습니다.
6.4. Apache NiFi
데이터 흐름을 화면에서 그려서 구성하는 도구입니다. 어디서 읽어 어떤 변환을 거쳐 어디로 보낼지를 박스와 선으로 연결해 만들고, 각 구간의 처리량과 대기열을 눈으로 확인할 수 있습니다. 또 하나의 특징은 데이터 출처(Provenance) 추적입니다. 어떤 데이터가 언제 어느 경로로 지나갔는지를 기록해두기 때문에, 문제가 생겼을 때 되짚어보기 좋습니다.
6.5. Apache Gobblin
LinkedIn 에서 만들어진 데이터 수집 프레임워크입니다. Sqoop, Flume 처럼 출처별로 도구가 갈라져 있던 상황을 하나의 프레임워크로 통합하려는 시도였습니다. 수집·변환·품질 검사·적재를 한 흐름으로 묶어 관리한다는 방향성이었고, 지금도 Apache 프로젝트로 남아 있습니다.
7. 워크플로와 코디네이션
작업들을 순서대로 엮고, 분산된 노드들이 같은 상태를 바라보게 만드는 자리입니다.
7.1. Apache Oozie
하둡 작업들을 순서와 조건에 따라 엮어 실행하는 워크플로 스케줄러입니다. "Sqoop 으로 가져오고, MapReduce 로 처리하고, Hive 테이블에 적재한다" 같은 흐름을 XML 로 정의해 돌립니다. Workflow(작업의 DAG), Coordinator(시간이나 데이터 조건에 따른 실행), Bundle(여러 Coordinator 묶음)이라는 세 층으로 나뉘어 있는 점이 특징입니다.
7.2. Apache Airflow
파이프라인을 파이썬 코드로 정의하는 워크플로 스케줄러입니다. XML 대신 코드로 DAG 를 작성하기 때문에 반복되는 작업을 함수로 묶거나 조건에 따라 흐름을 바꾸기가 훨씬 수월합니다. 하둡 전용 도구는 아니지만, Oozie 가 맡던 자리를 사실상 대부분 이어받았습니다. 지금 데이터 파이프라인을 새로 구성한다면 가장 먼저 후보에 오르는 이름입니다.
7.3. Azkaban
Airflow 이전에 Oozie 의 대안으로 꼽히던 스케줄러입니다. 역시 LinkedIn 에서 만들어졌고, Oozie 의 XML 설정이 번거롭다는 점을 겨냥해 간단한 속성 파일로 의존 관계를 정의하도록 했습니다.
7.4. Apache ZooKeeper
분산 시스템에서 여러 노드가 하나의 상태에 합의하도록 돕는 코디네이션 서비스입니다. 설정 정보를 공유하고, 누가 리더인지 정하고, 분산 잠금을 관리하는 일을 맡습니다. 에코시스템에서 ZooKeeper 는 눈에 잘 띄지 않지만 곳곳에 들어가 있습니다. HDFS 네임노드 이중화에서 어느 쪽이 Active 인지 가려내는 일도, HBase 가 리전 서버의 생사를 파악하는 일도 ZooKeeper 를 거칩니다. 분산 시스템에서 "합의" 가 왜 따로 떼어낼 만큼 어려운 문제인지는 분산 시스템의 이해와 하둡의 등장 배경 에서 다루었습니다.
8. 개발과 분석 인터페이스
클러스터에 사람이 접속해 작업을 던지고 결과를 보는 창구입니다.
- Hue (Hadoop User Experience) : 하둡 클러스터를 웹 브라우저에서 다루기 위한 UI 입니다. Hive 쿼리를 실행하고, HDFS 파일을 탐색하고, Oozie 워크플로를 관리하는 일을 한 화면에서 할 수 있습니다.
- Apache Zeppelin : 웹 노트북 도구입니다. 셀 단위로 Spark, SQL, 셸 명령을 섞어 실행하고 결과를 표나 차트로 바로 볼 수 있어, 탐색적 분석에 자주 쓰였습니다.
- Apache Livy : Spark 작업을 REST API 로 제출할 수 있게 해주는 서버입니다. 애플리케이션이 직접 spark-submit 을 호출하지 않고도 Spark 세션을 만들고 코드를 던질 수 있게 해줍니다.
- Jupyter : 하둡 전용은 아니지만, PySpark 커널을 붙여 Spark 작업을 노트북에서 다루는 구성이 널리 쓰이면서 Zeppelin 의 자리를 상당 부분 가져갔습니다.
9. 저장 포맷과 테이블 포맷
프로젝트는 아니지만, 에코시스템을 이야기할 때 빠지지 않는 축입니다. 같은 데이터라도 어떤 포맷으로 쌓아두느냐에 따라 질의 비용이 크게 달라지기 때문입니다.
9.1. 파일 포맷
- SequenceFile : 하둡 초기부터 있던 Key-Value 이진 포맷입니다. 작은 파일 여러 개를 하나로 묶는 용도로도 쓰였습니다.
- RCFile : 행을 묶음으로 나눈 뒤 그 안에서 컬럼별로 저장하는, 열 지향 포맷의 초기 형태입니다. 이후 ORC 에 자리를 넘겼습니다.
- Avro : 행 단위로 저장하는 포맷입니다. 레코드를 통째로 읽고 쓰는 작업과 스키마 변경(Schema Evolution)에 강해, 수집 단계에서 자주 쓰입니다.
- Parquet : 열 단위로 저장하는 포맷입니다. 필요한 컬럼만 읽어올 수 있고 같은 타입의 값이 모여 있어 압축률도 좋습니다. 분석 질의에서는 사실상 기본 선택지입니다.
- ORC (Optimized Row Columnar) : 역시 열 단위 포맷이며, Hive 와 함께 발전해 왔습니다. 블록 단위 통계를 들고 있어 조건에 맞지 않는 구간을 통째로 건너뛰는 데 강점이 있습니다.
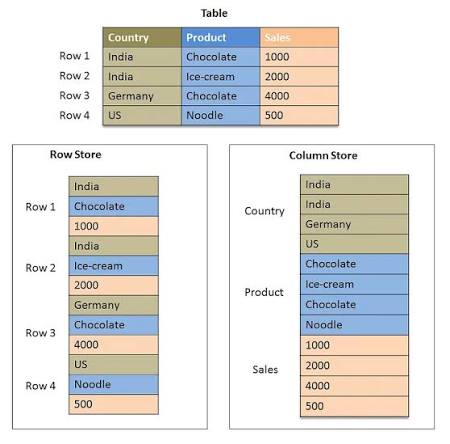
출처 : 행 기반 · 열 기반 저장 비교
정리하면 들여올 때는 행 기반, 분석할 때는 열 기반이라는 흐름으로 기억해두면 편합니다.
9.2. 테이블 포맷
파일 포맷이 "한 파일을 어떻게 쓸 것인가" 의 문제였다면, 테이블 포맷은 "수많은 파일을 묶어 하나의 테이블로 어떻게 다룰 것인가" 의 문제입니다. 기존 Hive 테이블은 사실상 디렉토리 경로에 의존했기 때문에, 쓰는 도중에 읽으면 중간 상태가 보이거나, 특정 행 몇 개만 수정하는 일이 어려웠습니다. 이를 해결하기 위해 나온 것들입니다.
- Apache Iceberg : 메타데이터로 테이블의 스냅샷을 관리해 트랜잭션과 시점 조회(Time Travel), 스키마 변경을 지원합니다.
- Apache Hudi : 갱신과 삭제가 잦은 워크로드를 겨냥해, 증분 처리(Incremental Processing)에 초점을 둔 포맷입니다.
- Delta Lake : Databricks 에서 시작된 포맷으로, 트랜잭션 로그를 통해 ACID 를 보장합니다.
이 테이블 포맷들은 저장소가 HDFS 에서 오브젝트 스토리지로 옮겨가는 흐름과 맞물려 있습니다. 하둡 에코시스템의 무게 중심이 어디로 향하고 있는지를 보여주는 부분이기도 합니다.
10. 운영과 보안
클러스터를 세우고 나면 그때부터가 진짜 시작입니다. 상태를 보고, 권한을 나누고, 흐름을 추적하는 도구들이 이 자리에 있습니다.
- Apache Ambari : 클러스터 설치와 설정, 상태 모니터링을 웹 화면에서 다루기 위한 관리 도구입니다. 한동안 개발이 멈춰 Apache Attic 으로 물러났다가 이후 개발이 재개된, 조금 특이한 이력을 가진 프로젝트입니다.
- Apache Bigtop : 여러 프로젝트의 버전 조합을 맞춰 빌드하고 패키징해주는 프로젝트입니다. 각 프로젝트가 따로 릴리스되다 보니 서로 맞는 버전을 고르는 일 자체가 일이었는데, 그 부분을 맡아줍니다.
- Apache Ranger : 어떤 사용자가 어떤 테이블·컬럼·경로에 접근할 수 있는지 권한을 한곳에서 정의하고 강제합니다. 접근 이력도 함께 남깁니다.
- Apache Sentry : Ranger 와 같은 자리를 맡던 권한 관리 프로젝트입니다. 지금은 Apache Attic 으로 물러났고, 그 역할은 Ranger 로 모였습니다.
- Apache Knox : 클러스터 바깥에서 들어오는 요청을 한 관문으로 모아 인증을 처리하는 게이트웨이입니다. 각 서비스 포트를 외부에 직접 열지 않아도 되게 해줍니다.
- Apache Atlas : 데이터가 어디서 와서 어디로 갔는지, 즉 계보(Lineage) 와 메타데이터를 관리합니다. Ranger 와 연동해 태그 기반 권한 정책을 거는 구성도 가능합니다.
- Kerberos : Apache 프로젝트는 아니지만, 하둡의 인증은 기본적으로 Kerberos 를 씁니다. 보안을 켠 클러스터에서 작업을 제출하려면 티켓을 먼저 받아야 하는 이유가 이것입니다.
여기에 더해 상용 배포판 쪽에서는 Cloudera Manager 처럼 설치와 운영을 통합해주는 도구를 사용했습니다. 과거 Cloudera(CDH)와 Hortonworks(HDP)가 각각의 배포판을 내놓다가 2019년 두 회사가 합병하면서, 지금은 CDP 라는 이름으로 정리되었습니다.
11. 지금은 멈췄지만, 한때 널리 쓰였던 프로젝트들
에코시스템을 정리하다 보면 "분명 자료에는 자주 나오는데 지금은 잘 안 쓴다" 는 이름들이 꽤 나옵니다. Apache 재단에서는 개발이 멈춘 프로젝트를 Apache Attic 이라는 곳으로 옮겨 보관하는데, 하둡 에코시스템에서도 이 길을 걸은 프로젝트가 적지 않습니다.
이런 프로젝트들을 굳이 알아둘 필요가 있을까 싶기도 하지만, 저는 두 가지 이유에서 의미가 있다고 생각합니다. 하나는 오래된 클러스터를 인수인계 받으면 실제로 마주치게 되기 때문이고, 다른 하나는 왜 밀려났는지를 알면 지금 쓰는 도구가 무엇을 해결한 것인지가 선명해지기 때문입니다.
11.1. Apache Pig
MapReduce 를 직접 짜기 번거롭다는 문제를, Hive 와는 다른 방식으로 풀었던 프로젝트입니다. Hive 가 SQL 을 택했다면, Pig 는 Pig Latin 이라는 데이터 흐름 전용 스크립트 언어를 택했습니다.
A = LOAD 'data' USING PigStorage(',') AS (name:chararray, age:int);
B = FILTER A BY age > 20;
C = GROUP B BY name;
DUMP C;
이렇게 단계별로 데이터를 변형해 나가는 방식이라, SQL 로 표현하기 까다로운 여러 단계의 가공 작업에서는 오히려 읽기 편했습니다. 한때 Hive 와 함께 하둡의 양대 질의 도구로 불렸습니다. 다만 SQL 을 아는 사람이 압도적으로 많았고, 이후 Spark 가 비슷한 흐름형 API 를 훨씬 좋은 성능으로 제공하면서 자리를 잃었습니다. 지금은 사실상 개발이 멈춘 상태입니다.
11.2. 그 밖에 물러난 프로젝트들
- Apache Sqoop : RDBMS 와 하둡 사이의 데이터 이동을 맡았습니다. 2021년 Attic 으로 이동했습니다.
- Apache Flume : 로그 수집을 맡았습니다. Kafka 와 NiFi 에 자리를 내주고 개발이 멈췄습니다.
- Apache Sentry : 권한 관리를 맡았습니다. 같은 역할의 Ranger 로 통합되며 Attic 으로 이동했습니다.
- Apache Giraph : 대규모 그래프 처리를 위한 프레임워크였습니다. 구글 Pregel 모델을 따랐으나, Spark GraphX 등에 밀렸습니다.
- Apache Hama : 역시 BSP(Bulk Synchronous Parallel) 모델 기반의 분산 연산 프레임워크였습니다.
- Apache Tajo : 하둡 위의 분산 데이터 웨어하우스 시스템으로, 국내 개발자들이 주도해 만든 프로젝트라 한때 국내에서 화제가 되기도 했습니다.
- Apache Falcon : 데이터 수명 주기와 복제 정책을 관리하는 도구였습니다.
- Apache Slider : 기존 애플리케이션을 YARN 위에서 장기 실행 서비스로 띄우기 위한 프로젝트였습니다. 이후 그 기능이 YARN 본체로 흡수되었습니다.
- Apache Crunch : MapReduce 파이프라인을 자바 코드로 조립하기 위한 라이브러리였습니다.
- Apache Chukwa : 대규모 클러스터의 로그와 지표를 수집·분석하기 위한 시스템이었습니다.
- Apache Whirr : 클라우드 위에 하둡 클러스터를 자동으로 띄우기 위한 도구였습니다. 지금은 클라우드 제공사의 관리형 서비스가 이 역할을 대신합니다.
- Apache Mesos : YARN 과 경쟁하던 범용 자원 관리자였습니다. Kubernetes 가 자리를 가져가며 물러났습니다.
이 목록을 놓고 보면 하나의 흐름이 보입니다. 같은 자리를 여러 프로젝트가 경쟁하다가, 결국 사용자 층이 넓거나 다른 생태계와 잘 맞물리는 쪽이 남았다는 것입니다. Pig 가 SQL 에 밀린 것, Sentry 가 Ranger 로 모인 것, Mesos 가 Kubernetes 에 밀린 것 모두 같은 모양입니다.
12. 한눈에 보기
지금까지 살펴본 프로젝트들을 자리별로 모으면 다음과 같습니다.
| 계층 | 프로젝트 | 한 줄 역할 | 현재 상태 |
|---|---|---|---|
| 저장 | HDFS | 큰 파일을 블록으로 쪼개 복제해 두는 분산 파일 시스템 | 사용 |
| 저장 | HBase | 행 키로 특정 레코드를 빠르게 찾는 분산 NoSQL | 사용 |
| 저장 | Kudu | 컬럼 저장이면서 행 단위 갱신을 지원 | 사용 |
| 저장 | Ozone | 작은 파일이 많은 환경을 겨냥한 오브젝트 스토리지 | 사용 |
| 저장 | Alluxio | 저장소 앞에 놓이는 캐시 계층 | 사용 |
| 자원 관리 | YARN | 클러스터의 CPU·메모리를 작업에 배분 | 사용 |
| 자원 관리 | Mesos | 범용 클러스터 자원 관리자 | 중단 |
| 처리 | MapReduce | Map·Reduce 두 단계로 나눠 처리하는 1세대 엔진 | 레거시 |
| 처리 | Tez | 작업을 DAG 로 표현해 중간 저장을 줄인 실행 엔진 | 사용 |
| 처리 | Spark | 중간 결과를 메모리에 두는 범용 처리 엔진 | 사용 |
| 처리 | Flink | 스트리밍을 기본으로 삼는 처리 엔진 | 사용 |
| 처리 | Storm · Samza | 초기 실시간 스트림 처리 프레임워크 | 쇠퇴 |
| 처리 | Mahout | 하둡 위의 머신러닝 라이브러리 | 쇠퇴 |
| 질의 | Hive | 파일에 테이블을 입혀 SQL 로 조회 | 사용 |
| 질의 | Impala · Trino | 상주 데몬으로 대화형 질의를 처리 | 사용 |
| 질의 | Drill | 스키마 정의 없이 파일에 바로 SQL | 쇠퇴 |
| 질의 | Phoenix | HBase 위의 SQL 계층 | 사용 |
| 질의 | Kylin | OLAP 큐브를 미리 계산해 두는 엔진 | 사용 |
| 질의 | Pig | 데이터 흐름 전용 스크립트 언어 | 중단 |
| 수집 | Sqoop | RDBMS 와 하둡 사이의 데이터 이동 | 중단 |
| 수집 | Flume | 로그처럼 흘러드는 데이터를 모아 적재 | 중단 |
| 수집 | Kafka | 보내는 쪽과 받는 쪽을 떼어놓는 메시지 큐 | 사용 |
| 수집 | NiFi | 화면에서 그려 만드는 데이터 흐름 도구 | 사용 |
| 수집 | Gobblin | 수집·변환·적재를 통합한 프레임워크 | 사용 |
| 워크플로 | Oozie | 하둡 작업들을 순서대로 엮어 실행 | 레거시 |
| 워크플로 | Airflow | 파이썬 코드로 정의하는 파이프라인 | 사용 |
| 워크플로 | Azkaban | 속성 파일로 의존 관계를 정의하는 스케줄러 | 쇠퇴 |
| 코디네이션 | ZooKeeper | 분산 노드 사이의 합의와 리더 선출 | 사용 |
| 인터페이스 | Hue · Zeppelin · Livy | 웹 UI, 노트북, REST 기반 작업 제출 | 사용 |
| 포맷 | Avro · Parquet · ORC | 행 기반 수집 포맷과 열 기반 분석 포맷 | 사용 |
| 포맷 | Iceberg · Hudi · Delta | 파일 묶음을 하나의 테이블로 다루는 테이블 포맷 | 사용 |
| 운영 | Ambari · Bigtop | 설치·설정·모니터링과 배포판 빌드 | 사용 |
| 보안 | Ranger · Knox · Atlas | 권한, 관문, 계보 관리 | 사용 |
| 보안 | Sentry | 권한 관리 (Ranger 로 통합) | 중단 |
13. 조금 더 들어가보기 : 에코시스템의 공통 기반과 공통 한계
지금까지 프로젝트를 계층별로 훑었습니다. 그런데 이것들을 나란히 놓고 보면 공통된 기반과 공통된 약점이 보입니다. 그 부분을 한 층 내려가 정리해보겠습니다.
13.1. 대부분이 JVM 위에서 돈다
HDFS, YARN, MapReduce, HBase, Hive, Spark, Kafka, ZooKeeper. 이 목록의 거의 전부가 JVM 위에서 동작합니다. 그래서 JVM 의 특성이 곧 에코시스템의 특성이 되었습니다.
가장 크게 드러나는 것이 가비지 컬렉션입니다. 힙이 커질수록 한 번의 수집에 걸리는 시간이 길어지는데, 이것이 분산 시스템에서는 단순한 지연으로 끝나지 않습니다.
- 네임노드가 수십 초 멈추면 클러스터의 모든 메타데이터 연산이 함께 멈춥니다.
- HBase 리전 서버가 멈추면 ZooKeeper 세션이 만료되어 죽은 것으로 간주됩니다. 살아 있는데 쫓겨나는 것입니다.
- Kafka 브로커가 멈추면 복제가 밀려 동기화 목록에서 빠집니다.
멈춤이 곧 장애 판정으로 이어지는 구조라, "느린 것" 과 "죽은 것" 을 구분할 수 없다는 분산 시스템의 근본 문제가 GC 라는 형태로 계속 나타납니다. 그래서 이 진영에서는 힙을 줄이려는 노력이 이어졌습니다. 힙 바깥(off-heap)에 데이터를 두고 GC 대상에서 빼거나, 운영체제의 페이지 캐시에 맡기는 방식입니다. Kafka 가 자체 캐시를 크게 두지 않고 페이지 캐시에 기대는 것이 대표적입니다.
13.2. 직렬화 비용이 생각보다 크다
노드 사이로 데이터를 옮기려면 객체를 바이트로 바꾸고 다시 객체로 되돌려야 합니다. 이 변환이 분산 처리에서 무시할 수 없는 비용입니다. 자바 기본 직렬화는 느리고 결과물도 큽니다. 그래서 에코시스템은 일찍부터 별도 형식을 썼습니다. 하둡 내부의 Writable, 프로젝트 간 통신의 Protocol Buffers, 데이터 파일의 Avro 같은 것들입니다.
여기서 스키마를 따로 두는 형식이 유리한 이유도 나옵니다. 필드 이름을 매 레코드마다 반복해 넣지 않아도 되므로 크기가 줄고, 파싱도 빨라집니다. 그리고 가장 빠른 것은 아예 변환하지 않는 것입니다. 컬럼 포맷을 읽어 그대로 메모리에 올리고 그 위에서 연산하는 방식이 성능을 크게 끌어올린 배경입니다.
13.3. 페이지 캐시와 zero-copy
Kafka 가 디스크를 쓰면서도 빠른 이유가 여기 있습니다. 파일을 읽어 네트워크로 보내는 일은 보통 커널 버퍼 → 사용자 공간 → 다시 커널 버퍼 → 네트워크 로 여러 번 복사됩니다. 그런데 리눅스에는 사용자 공간을 거치지 않고 커널 안에서 곧바로 보내는 방법이 있습니다.
Kafka 는 메시지를 가공하지 않고 그대로 내보내므로 이 경로를 쓸 수 있습니다. 복사도 줄고 문맥 전환도 줄어듭니다. 여기에 더해 운영체제의 페이지 캐시가 최근에 쓴 데이터를 메모리에 들고 있으므로, 갓 들어온 메시지를 읽는 컨슈머는 사실상 디스크를 건드리지 않습니다. 디스크에 쓰지만 디스크에서 읽지 않는 구조입니다.
13.4. 순차 쓰기가 싼 이유
에코시스템 전반에서 반복되는 설계가 덧붙이기만 하고 고치지 않는 것입니다. HDFS 도, Kafka 도, 테이블 포맷들도 그렇습니다. 이유는 저장 장치의 성질입니다. 위치를 옮겨 다니며 조금씩 쓰는 것보다 한곳에 이어서 크게 쓰는 것이 훨씬 쌉니다. 회전 디스크에서는 탐색 시간 때문이었고, SSD 에서도 지우기 단위가 커서 제자리 수정이 비쌉니다.
그래서 "고치지 않고 새로 쓴 뒤 나중에 정리한다" 는 방식이 여기저기서 나옵니다. 이 방식의 대가가 앞서 여러 번 본 작은 파일과 정리 작업입니다.
13.5. 대규모에서 무엇이 먼저 막히는가
에코시스템을 크게 굴릴 때 부딪히는 지점을 모아두면 이렇습니다.
- 메타데이터를 아는 하나의 주체 : 네임노드, 메타스토어, 카탈로그
- JVM 힙과 GC : 힙을 키우면 멈춤이 길어지고, 멈춤은 장애 판정이 됩니다
- 직렬화와 데이터 이동 : 계산보다 옮기는 비용이 큽니다
- 작은 파일 : 개수가 크기보다 먼저 한계를 만듭니다
새 도구를 볼 때 이 네 가지가 어떻게 다뤄지는지를 확인하면, 그것이 어디까지 버틸지 대략 가늠할 수 있습니다.
결론
에코시스템을 정리하면서 가장 크게 느낀 점은, 이름을 하나씩 외우는 방식으로는 오래 남지 않는다는 것입니다. 대신 데이터가 들어와서 저장되고 처리되어 조회되기까지의 순서를 먼저 그려두고, 각 자리에 어떤 프로젝트가 앉아 있는지를 채워 넣으니 훨씬 잘 붙었습니다. 새로운 이름을 만나도 "이건 어느 자리에 앉는 것인가" 를 먼저 물으면 대략의 성격이 짐작되기 때문입니다.
또 하나 인상 깊었던 것은, 이 프로젝트들이 처음부터 한 벌로 설계된 것이 아니라 핵심에서 불편했던 지점을 메우며 하나씩 붙어 왔다는 사실입니다. MapReduce 를 직접 짜기 번거로워서 Hive 와 Pig 가 나왔고, 배치로는 즉시 조회가 어려워서 Impala 와 Trino 가 나왔으며, 단계마다 디스크에 떨구는 것이 아까워서 Tez 와 Spark 가 나왔습니다. 그래서 각 프로젝트를 볼 때 "무엇이 불편해서 만들어졌는가" 를 함께 보면 이해가 훨씬 빨라진다는 것을 알게 되었습니다.
특히 이번에 개발이 멈춘 프로젝트들까지 함께 정리해보길 잘했다고 생각합니다. Pig 가 SQL 에 밀리고, Sentry 가 Ranger 로 흡수되고, Mesos 가 Kubernetes 에 자리를 내주는 과정을 보면서, 기술이 사라지는 데에도 그 나름의 이유가 있고 그 이유를 아는 것이 결국 지금 남은 기술을 이해하는 길이라는 생각이 들었습니다. 오래된 자료에서 낯선 이름을 만났을 때 당황하지 않을 수 있다는 것도 작지 않은 소득이었습니다.
물론 지금은 클라우드 환경과 오브젝트 스토리지, 그리고 Iceberg 같은 테이블 포맷으로 무게 중심이 옮겨가면서 여기 적은 프로젝트 중 상당수는 현장에서 마주칠 일이 줄고 있습니다. 그럼에도 저장과 자원 관리와 처리를 나누어 생각하는 방식 자체는 도구가 바뀌어도 그대로 남기 때문에, 각 자리가 왜 필요했는지를 이해해두는 일은 여전히 값어치가 있다고 생각합니다.