
하둡의 핵심 구성요소와 이론

저번 포스팅에서는, 하둡이 어떻게 등장했는지를 공부하고 정리해봤습니다. 이번에는 그러한 하둡의 핵심 요소들에 대하여 공부하고 포스팅하겠습니다.
1. HDFS
HDFS 는 Hadoop 의 핵심 아키텍처 중 하나입니다.
HDFS 의 아키텍처에도 따로 Block File System, NameNode, DataNode 등이 있습니다.
HDFS 가 무엇인지를 본격적으로 알아보기 전에, HDFS 가 어떤 철학과 목표를 가지고 만들어졌는지, 그 특징은 무엇인지를 간단하게 공부하고 넘어가겠습니다.
① HDFS 는 하드웨어 장애에 대처할 수 있어야 합니다. HDFS를 구성하는 분산 서버에는 다양한 장애가 발생할 수 있습니다. 예를 들면 하드디스크에 오류가 생겨서 데이터 저장에 실패하는 경우, 디스크 복구가 불가능해 데이터가 유실되는 경우, 네트워크 장애가 생겨 특정 분산 서버에 네트워크 접근이 안되는 경우 등이 있을 수 있습니다. HDFS는 이런 장애를 빠른 시간에 감지하고 대처할 수 있게 설계되어 있습니다. HDFS에 데이터를 저장하면, 복제본도 함께 저장되어 데이터 유실을 방지하며, 분산 서버 사이에는 주기적으로 health check 를 통해 빠른 시간에 장애를 감지하고 대처할 수 있게 됩니다.
② HDFS 는 Streaming 식 데이터 접근에 최적화 되어있습니다. HDFS는 사용자 요청을 빠르게 처리하는 것보다 동일 시간 내에 더 많은 데이터를 안정적으로 처리하는 데 중점을 둡니다. 따라서 중간부터 읽고, 쓰는 Random Access 방식보다는 처음부터 순차적으로 읽어가는 Streaming 방식에 최적화되어 있습니다. 가끔 이 Streaming 방식이 카프카처럼 실시한 데이터 스트리밍과 헷갈릴 수 있는데, 그런 스트리밍을 의미하는것이 아니라, 처음부터 끝까지 순차적으로 데이터를 읽는데에 특화되었다는 의미입니다. 이런 방식으로 인해 사용자와 상호작용이 많은 트랜잭션 기반 서비스(예 : 인터넷 뱅킹, 쇼핑몰 등)보다는 대규모 데이터를 일괄 처리하는 배치 처리(batch processing)에 더 적합합니다.
③ HDFS 는 대용량 데이터셋 처리에 유리합니다. HDFS는 하나의 파일이 수 기가바이트(GB)에서 수 테라바이트(TB)에 이르는 크기로 저장될 수 있도록 설계되어 있습니다. 이를 통해 높은 데이터 전송 대역폭(bandwidth)을 지원하며, 수백 대의 노드로 구성된 클러스터를 효율적으로 운영할 수 있습니다. HDFS는 단일 인스턴스에서 수천만 개 이상의 파일을 관리할 수 있습니다. 여기서 말하는 데이터 전송 대역폭은, 한 번에 얼마나 많은 데이터를 빠르게 보낼 수 있는가를 의미합니다.
④ HDFS 는 심플하고, 일관성이 있습니다.
데이터 무결성을 유지하기 위해, HDFS는 한 번 저장한 데이터는 수정하지 않고 읽기만 가능한 모델을 따릅니다. 이를 write-once-read-many 모델이라 하며, 데이터가 저장된 후 변경되지 않음으로써 무결성을 보장합니다.
기존에는 저장 후 수정이 전혀 불가능했으나, 현재는 파일의 끝부분에 데이터를 append 하는 방식은 지원됩니다.
이러한 단순한 일관성 모델은 데이터 처리량을 높이며, 특히 MapReduce와 같은 처리 방식에 큰 장점을 제공합니다.
⑤ HDFS 는 데이터를 직접 옮기지 않고, 데이터가 위치한 노드에서 연산을 실행합니다. 컴퓨팅 처리를 위해 데이터를 이동시키는 것보다, 연산 작업을 데이터가 위치한 곳으로 이동시키는 것이 비용과 성능 면에서 더 유리합니다. 이는 특히 데이터 양이 방대할수록 더욱 중요합니다. 네트워크 혼잡을 줄이고 시스템 전체의 처리량을 높일 수 있기 때문입니다. HDFS는 이를 고려하여, 데이터가 위치한 노드에서 연산이 실행되도록 처리합니다. 이러한 접근 방식은 전체 클러스터의 효율성을 높이는 데 크게 기여합니다.
⑥ HDFS 는 여러 플랫폼 간의 이식성을 가지고 있습니다. HDFS는 다양한 하드웨어 및 운영체제 환경에서 동일한 기능을 제공할 수 있도록 설계되어 있습니다. 인텔이나 AMD 칩이 설치된 서버에서도 문제없이 동작하며, CentOS나 Red Hat Linux와 같은 다양한 리눅스 배포판에서도 동일하게 사용할 수 있습니다. 이는 HDFS의 서버 코드가 Java 언어로 구현되어 있기 때문에 가능한 일입니다. Java의 플랫폼 독립성이 HDFS의 높은 이식성과 호환성을 보장해 줍니다. 이러한 특성은 HDFS가 대용량 데이터 저장 플랫폼으로 널리 채택되는 중요한 이유 중 하나입니다.
1.1. Block File System
HDFS는 블록 구조로 동작하는 분산 파일 시스템입니다. HDFS에 저장되는 모든 파일은 일정 크기의 블록 단위로 분할되어 여러 서버에 분산 저장됩니다. 기본 블록 크기는 128MB이며, 설정을 통해 조정이 가능합니다. ( 하둡 V1 에서는 64MB였습니다. ) 이러한 블록 기반 구조 덕분에 로컬 디스크의 제한을 넘어서 페타바이트(PB) 단위의 대용량 데이터 저장이 가능하게 됩니다.
hdfs-site.xml 에서 직접 변경은 가능하지만, 추천을 하지는 않습니다.
<property>
  <name>dfs.blocksize</name>
  <value>134217728</value> <!-- 128MB -->
</property>
HDFS에서 파일과 블록은 다음과 같은 규칙을 따른다
| 구분 | 설명 | 예시 |
|---|---|---|
| 파일과 블록 관계 | 하나의 파일은 하나 또는 여러 개의 블록에 저장됩니다. | 파일 A → 블록 1개 또는 여러 개로 분할 저장 |
| 블록 관리 | 어떤 파일이 어떤 블록에 저장되는지는 Namenode가 메모리 내 메타데이터로 관리합니다. | - |
| 블록 독립성 | 하나의 블록에는 여러 파일이 저장되지 않으며, 항상 단일 파일 전용입니다. | 블록 B에는 오직 파일 A 일부만 저장 가능 |
| 블록 분할 | 파일 크기가 블록 크기를 초과하면, 파일은 여러 블록에 나뉘어 저장됩니다. | 파일 크기 : 128MB + 10byte → 블록 1 : 128MB, 블록 2 : 10byte |
| 블록 크기 미만의 파일 | 파일 크기가 블록보다 작아도 전체 블록을 할당받지만, 사용된 용량만 실제 디스크에 저장됩니다. | 파일 크기 : 1MB, 블록 크기 : 128MB → 블록은 1MB만 사용 |
| 블록이 나눠떨어지지 않는 경우 | 파일이 블록 크기로 나눠떨어지지 않으면, 마지막 블록은 남은 크기만큼 점유합니다. | 파일 크기 : 129MB, 블록 크기 : 128MB → 블록 1 : 128MB, 블록 2 : 1MB |
| 디스크 점유 공간 | 실제 디스크에서 점유하는 공간은 블록 전체가 아닌, 파일의 실제 크기만큼입니다. | 블록 크기 : 128MB, 파일 크기 : 1MB → 디스크 사용 : 1MB |
이렇게 Block System 을 유지하므로써 다음과 같은 장점을 가질 수 있게 되었다.
① Seek Time 감소
HDFS는 블록 크기를 고정하여 디스크 탐색 시간을 줄일 수 있습니다. 디스크 탐색 시간은 데이터 위치를 찾는 탐색 시간(seek time)과 해당 위치로 디스크 헤드를 이동시키는 검색 시간(search time)의 합입니다. 하둡이 처음 개발될 당시 일반적인 하드디스크의 평균 탐색 시간은 약 10ms였고, 디스크 I/O 대역폭은 100MB/s였습니다. HDFS는 탐색 시간이 전체 처리 시간의 1%를 넘지 않도록 하는 것을 목표로 했으며, 이를 위해 100MB를 넘지 않고 2의 제곱수에 가까운 64MB를 블록 크기로 선택했습니다.
그러나, 큰 파일을 처리하기 위한 효율성과 그 동안 하드웨어 및 네트워크의 성능도 향상되는 과정을 통하여 V2 에서는 128MB 로 변경 되었습니다. ( + 클러스터의 효율성 때문이기도 합니다. -> 메타데이터 관리가 더 수월해짐. )
② 메타데이터 크기 감소 Namenode는 블록 위치, 파일 이름, 디렉토리 구조, 권한 정보 등의 메타데이터를 메모리에 상주시키고 관리합니다. 블록 크기를 크게 설정하면 하나의 파일을 저장하는 데 필요한 블록 수가 줄어들며, 이에 따라 관리해야 할 메타데이터의 양도 줄어듭니다. 예를 들어 블록 크기가 128MB인 경우, 200MB 파일은 두 개의 블록으로 나뉘며, Namenode는 해당 블록에 대한 정보만 관리하면 됩니다.
반면 일반적인 파일 시스템은 4KB 또는 8KB 크기의 블록을 사용하기 때문에, 동일한 크기의 파일을 저장하려면 수만 개의 블록과 그에 대한 메타데이터가 필요합니다. 예를 들어 블록 크기가 4KB인 경우, 200MB 파일은 약 5만 개의 블록으로 나뉘고, 5만 개의 메타데이터 항목을 Namenode가 관리해야 합니다. Namenode는 단일 서버에서 메타데이터를 처리하므로, 메타데이터가 많아질 경우 성능 저하 및 안정성 문제로 이어질 수 있습니다. 일반적으로 Namenode는 100만 개의 블록을 저장할 때 약 1GB의 힙 메모리를 사용합니다.
③ 클라이언트와 Namenode 간 네트워크 통신 비용 감소 클라이언트가 HDFS에 저장된 파일에 접근할 때는 먼저 Namenode에 해당 파일을 구성하는 블록의 위치를 조회합니다. 이때 블록 크기가 작아 블록 수가 많으면, 조회해야 할 메타데이터가 많아지거나 조회 횟수가 증가하게 됩니다.
하지만 블록 크기를 크게 설정하면 파일당 블록 수가 줄어들어 조회에 필요한 정보가 간소화되고, 통신 횟수도 줄어듭니다. 클라이언트는 데이터를 스트리밍 방식으로 처리하기 때문에, 초기 조회 이후에는 특별한 경우가 아니면 Namenode와의 추가적인 통신 없이 작업을 이어나갈 수 있습니다. 이로 인해 전체적인 통신 비용이 줄어듭니다.
1.2. NameNode 와 DataNode
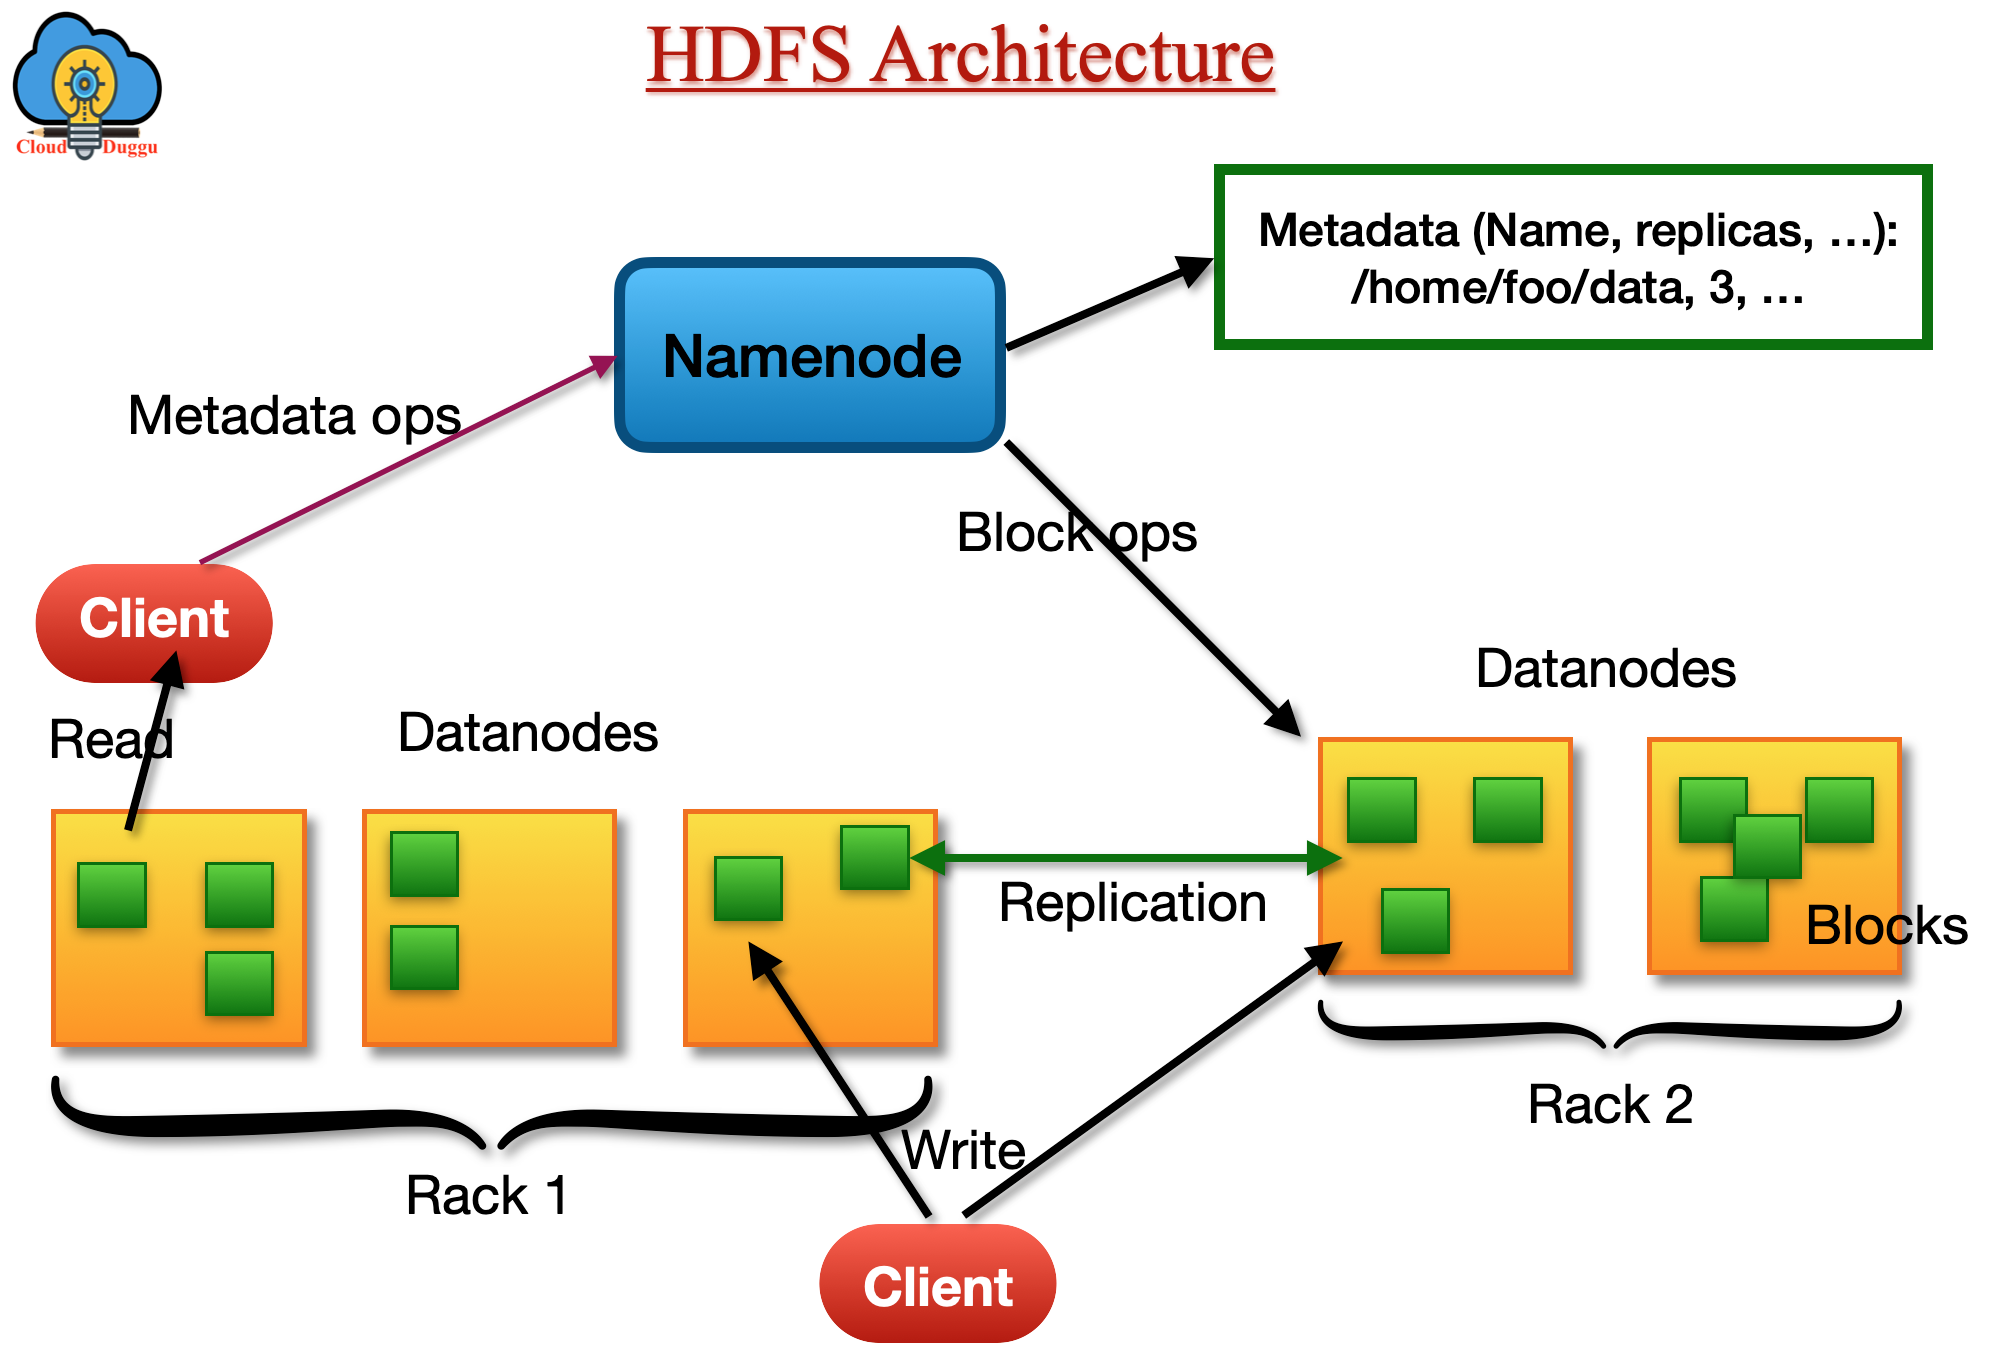
출처 : HDFS 아키텍처
NameNode
NameNode는 HDFS의 핵심 구성요소로서, 블록의 위치, 권한 등과 같은 메타데이터를 관리하는 역할을 합니다. 모든 메타데이터는 기본적으로 메모리에 유지되며, 영속성을 위해 다음의 두 가지 파일 형태로도 디스크에 기록됩니다.
하나는 File System Image 입니다. NameNode가 처음 시작된 이후부터의 HDFS 네임스페이스 전체 정보를 포함합니다. 디렉터리 구조, 파일명, 파일크기, 생성시간, 수정시간, 블록 매핑 정보, 접근 제어 정보, 복제 수, 파일 상태 등을 포함하고 있습니다.
다른 하나는, Edit Log 입니다. NameNode가 처음 시작된 이후부터 발생한 모든 변경사항을 기록한 로그 파일입니다.
하둡의 NameNode 는 시작된 이후의 네임스페이스 정보를 File System Image 에 기록하고, 그 정보를 메모리에 올림으로써 빠르게 조회 할 수 있도록 합니다. 그리고 변경된 사항들은 전부 Edit Log 에 저장합니다. 이후 NameNode 를 내렸다가 올리게 되면, Secondary NameNode 에 의해서 디스크에 있는 Edit Log 와 File System Image 가 병합을 하며 새로운 File System Image 가 만들어지게 됩니다. 그리고 그걸 다시 메모리에 올림으로써, 최신 정보를 유지하고 빠르게 조회 할 수 있도록 합니다.
이러한 NameNode 의 역할은 크게 다섯 가지가 있습니다.
① 메타데이터 관리 파일 시스템을 구성하는 메타데이터를 관리합니다. 메타데이터는 파일 이름, 디렉토리 구조, 파일 크기, 접근 제어 정보(access/auth control) 및 파일과 블록 간의 매핑 정보를 포함합니다. 클라이언트 요청에 신속하게 응답하기 위해 메타데이터는 메모리 상에서 유지되며, 위에서 이야기한 것처럼 디스크에 기록하기도 합니다.
② 데이터노드 관리 클러스터 내의 모든 DataNode 리스트를 유지하고 관리합니다. 관리자에 의한 명시적인 명령 또는 모니터링 결과에 따라 DataNode 상태 정보를 업데이트하거나 변경합니다.
③ 데이터노드 모니터링 각 DataNode는 3초마다 NameNode에 heartbeat를 전송합니다. heartbeat에는 데이터노드 상태 정보와 데이터노드에 저장된 블록 목록(block report)이 포함됩니다. NameNode는 heartbeat 정보를 바탕으로 DataNode의 가용성, 디스크 용량 상태 등을 판단합니다. 일정 시간 동안 heartbeat를 수신하지 못한 DataNode는 장애가 발생한 노드로 간주됩니다.
④ 블록 관리 NameNode는 각 블록의 위치, 복제 상태, 소유 관계 등을 관리합니다. 장애가 발생한 DataNode가 발견되면, 해당 노드에 있던 블록을 다른 정상 노드로 복제합니다. 디스크 용량이 부족한 노드가 있을 경우, 블록을 용량이 여유 있는 노드로 이동시킵니다. 블록의 복제본 수를 유지하여, 기준 복제 수보다 부족하거나 많은 경우 적절히 추가 복제 또는 삭제 작업을 수행합니다.
⑤ 클라이언트 요청 처리 클라이언트가 HDFS에 접근할 때는 반드시 NameNode를 통해 먼저 접속합니다. 파일을 저장할 경우, 파일 존재 여부 확인, 저장 권한 검사 등을 수행합니다. 파일을 조회할 경우, 블록이 저장된 DataNode의 위치 정보를 반환합니다.
DataNode
DataNode 는 클라이언트가 HDFS에 저장하는 파일을 디스크에 유지하는 Node 입니다. 저장하는 파일은 크게 두 종류인데, 하나는 실제 데이터(Raw Data) 다른 하나는, checksum 이나 created time 등 메타데이터가 설정된 파일입니다.
이러한 DataNode 는 다음과 같은 기능을 합니다.
① 실제 데이터 처리 클라이언트로 부터 실제 데이터의 read/write 요청을 받아 처리합니다.
② block 생성,복제,삭제 NameNode 로부터 명령을 받아서, 자신의 디스크에 있는 block 을 생성, 복제, 삭제를 수행합니다.
③ heartbeat 전송 HDFS 의 상태를 NameNode 에게 heartbeat 로 전송합니다.
④ block 정보 전송 NameNode에게 자신이 가진 데이터 block 들의 리스트와 상태를 전송합니다.
1.3. Secondary NameNode
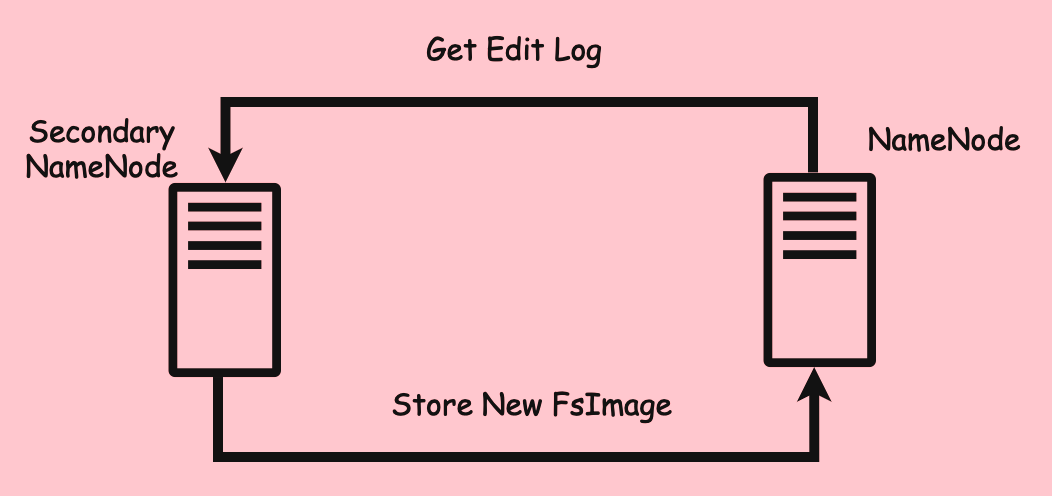
출처 : Secondary Namenode
Secondary NameNode 는 이름만 들어보면, 이중화 구성을 통해 NameNode 가 다운되면, Active 되는 Standby Node 라고 생각할 수 있습니다. 그러나, Secondary NameNode 는 클러스터 환경에서의 고가용성 역할을 담당하지 않습니다.
Secondary NameNode 는 NameNode 가 수행하는 File System Image 를 생성하는 역할을 분담합니다. 왜냐하면 NameNode 는 위에서 설명한 것처럼 HDFS 의 Entrypoint 로써 클라이언트에게 File 과 관련된 기능을 제공하기 때문입니다. NameNode 가 이 본연의 역할에 집중할 수 있도록, Secondary NameNode 가 NameNode 의 Edit Log 를 Merge 해 새로운 New File System Image 를 생성하는 역할을 맡습니다.
Secondary NameNode 는 NameNode 가 올라오는 과정에서 현재까지의 Edit Log 을 File System Image 와 병합하여 최신의 File System Image 를 생성하는 작업을 합니다. 그러기 위해서 Secondary NameNode 는 주기적으로 NameNode 의 Edit Log 을 조회합니다. 그리고 Edit Log 의 변경 사항에 대한 기록과 File System Image 를 병합하여 새로운 New FsImage 를 생성합니다.
마지막으로 새롭게 생성된 File System Image 는 NameNode 로 전달됩니다. ( 즉, NameNode 가 내려갔다 올라올 때마다, 병합 작업을 수행해줌. )
1.4. Replication
HDFS는 Fault Tolerance 를 위해 각 블록을 여러 개 복제하여 저장합니다. 이 복제 개수를 복제 수(Replication Factor)라고 하며, 파일을 생성할 때 애플리케이션에서 직접 지정할 수 있습니다. 기본 복제 수는 일반적으로 3개입니다.
예를 들어, 하나의 블록이 있다면 HDFS는 이를 세 개의 다른 서버에 나누어 저장함으로써 한 서버가 고장 나더라도 데이터 유실이 발생하지 않도록 합니다. 복제 수는 파일이 생성된 이후에도 변경이 가능하며, HDFS의 파일은 일반적으로 하나의 writer만 동시에 접근할 수 있도록 설계되어 있습니다. 단, append나 truncate와 같은 일부 예외적인 연산에서는 파일에 대한 부분적 접근이 허용됩니다.
HDFS에서는 이러한 블록의 복제를 관리하는 주체가 네임노드(NameNode)입니다. 네임노드는 각 데이터노드(DataNode)로부터 주기적으로 하트비트(heartbeat)와 블록 리포트(block report)를 받습니다. 네임노드는 이 정보를 바탕으로 고장이 발생한 노드를 파악하고, 해당 노드에 저장된 블록이 손실되지 않도록 다른 노드에 복제본을 자동으로 생성합니다. 또한, 특정 노드의 저장 용량이 부족할 경우 블록을 여유 공간이 있는 다른 노드로 옮기기도 하며, 복제 수가 지정된 값보다 적거나 많은 경우 이를 자동으로 조정합니다.
HDFS는 데이터를 여러 개의 복제본(replica)으로 저장하여, 신뢰성과 성능을 높이는 구조입니다. 그런데 단순히 복제본을 여러 개 만든다고 해서 성능과 안정성이 자동으로 좋아지는 것은 아닙니다. 복제본이 어디에 저장되느냐, 즉 replica의 위치는 HDFS의 전체 성능과 안정성에 큰 영향을 미칩니다.
이처럼 HDFS는 복제본의 배치 전략(replica placement policy)을 매우 중요하게 생각하며, 이 전략은 기존의 다른 분산 파일 시스템과 HDFS를 차별화하는 핵심 요소 중 하나입니다. HDFS는 이 기능을 위해 실제 운영 환경에서 수많은 경험과 실험을 통해 정책을 지속적으로 개선해왔습니다.
배치 전략이 노리는 것은 세 가지입니다. 하나는 장애가 발생하더라도 다른 노드에 저장된 복제본으로 데이터를 안전하게 복구하는 데이터 신뢰성입니다. 또 하나는 데이터가 여러 위치에 분산되어 있어 일부 서버나 랙이 실패하더라도 데이터를 읽고 쓸 수 있는 가용성 향상입니다. 마지막은 복제본이 네트워크 안에서 효율적으로 분산되게 해, 불필요한 네트워크 트래픽을 줄이고 성능을 높이는 것입니다. 이렇게 세 가지를 중점으로 개선되어왔습니다.
이 정책 중 가장 대표적인 것이 바로 랙 인식 복제 배치(Rack-aware Replica Placement)입니다.
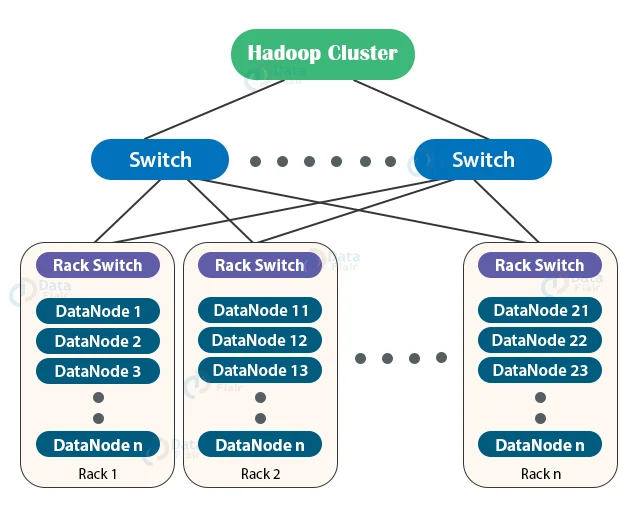
출처 : 하둡 클러스터 이미지와 랙 구조
대규모 HDFS 클러스터에서 컴퓨팅 인스턴스들은 여러 개의 서버 랙(rack)에 나뉘어 배치됩니다. 서로 다른 랙에 위치한 서버끼리는 랙 내 스위치를 통해 통신하기 때문에, 같은 랙 내 통신보다 더 많은 네트워크 대역폭이 필요합니다. 이런 구조적인 특성을 고려하여 Hadoop은 Rack Awareness 기능을 제공합니다. 이 기능을 통해 NameNode는 각 DataNode의 랙 ID를 인식하고, 이를 바탕으로 복제본의 위치를 결정합니다.
HDFS의 기본 복제 수는 일반적으로 3입니다. 이때 기본 복제 배치 정책인 BlockPlacementPolicyDefault는 다음과 같은 방식으로 복제본의 위치를 결정합니다. 첫 번째 복제본은 가능한 한 데이터를 쓰고 있는 클라이언트(writer)와 같은 랙에 있는 DataNode에 저장됩니다. 만약 writer가 특정 DataNode 위에서 직접 실행 중이라면, 해당 노드 자체에 데이터를 저장합니다. 반면 writer가 일반 노드라면, 같은 랙 내에서 임의의 DataNode를 선택해 데이터를 저장합니다.
두 번째와 세 번째 복제본은 writer와는 다른 랙에 있는 서로 다른 DataNode에 저장되도록 합니다. 이를 통해 총 두 개의 랙에 복제본이 분산되며, 하나의 랙에 장애가 발생하더라도 다른 랙에 데이터가 존재하기 때문에 안정성을 보장할 수 있습니다.
이러한 정책은 여러 가지 장점을 가집니다. 먼저 첫 번째 복제본을 writer와 동일한 랙에 저장함으로써 랙 간 네트워크 트래픽을 줄일 수 있어 쓰기 성능이 향상됩니다. 또한 대부분의 장애가 랙 전체보다는 개별 노드에서 발생하기 때문에, 복제본을 두 개의 랙에만 분산시켜도 충분한 신뢰성과 가용성을 확보할 수 있습니다.
반면 단점 역시 존재합니다. 복제본을 완전히 다른 랙에 각각 분산시키는 방식에 비해 전체 네트워크 대역폭 사용량을 줄이지는 못합니다. 또한 복제본이 1:2의 비율로 분포되기 때문에 랙 간에 데이터가 균등하게 분산되지 못하는 문제가 발생할 수 있습니다.
만약 복제본 수가 3보다 많아지는 경우, 네 번째 복제본부터는 무작위로 랙과 노드를 선택하되, 랙당 복제본 수가 일정 상한선 이하가 되도록 조정합니다. 이때 상한선은 (복제본 수 - 1) / 랙 수 + 2로 계산됩니다. NameNode는 기본적으로 하나의 블록에 대해 동일한 DataNode에 여러 복제본을 저장하는 것을 허용하지 않기 때문에, 하나의 블록이 가질 수 있는 최대 복제본 수는 클러스터 내 DataNode의 총 수와 같습니다.
블록 복제본이 위치할 노드를 선정하는 순서는 다음과 같습니다.
- 랙 인식 규칙을 기준으로 복제본이 배치될 후보 노드를 선정.
- 그런 다음 해당 후보 노드가 정책에서 요구하는 스토리지 타입을 가지고 있는지 확인.
- 만약 후보 노드가 요구되는 스토리지 타입을 가지고 있지 않다면, NameNode는 다른 후보 노드를 탐색.
- 위의 절차로도 적절한 노드를 찾을 수 없다면, fallback 스토리지 타입을 사용하는 노드를 대상으로 복제본을 배치하려고 시도.
조금 풀어서 설명하면, 랙 인식 규칙 기준으로 후보 Node 들을 선정하고, 정책을 SSD 스토리지 타입으로 정했다고 가정한다면, SSD 스토리지 타입을 가지고 있는지 후보 Node 들을 탐색합니다. 그러다가 결국 없다면, fallback 으로 지정한 Disk 에 복제본을 배치한다고 할 수 있겠습니다.
그 외에도 네 가지 정책이 추가로 있습니다.
① BlockPlacementPolicyRackFaultTolerant
해당 정책은 블록 복제본을 최소 3개의 서로 다른 랙에 분산시켜, 2개의 랙이 동시에 장애가 발생하더라도 데이터의 가용성을 유지하도록 돕습니다. ( Github Code Link )
-- hdfs-site.xml
<property>
  <name>dfs.block.replicator.classname</name>
  <value>org.apache.hadoop.hdfs.server.blockmanagement.BlockPlacementPolicyRackFaultTolerant</value>
</property>
② BlockPlacementPolicyWithNodeGroup
해당 정책은 노드 그룹 개념을 통해, 동일한 물리적 호스트에서 실행되는 가상 머신(VM)들 간의 장애 전파를 방지합니다. 즉, 동일한 노드 그룹에는 둘 이상의 복제본이 배치되지 않으며, 이는 가상화된 환경에 적합하다고 할 수 있습니다. ( Github Code Link )
-- core-site.xml
<property>
  <name>net.topology.impl</name>
  <value>org.apache.hadoop.net.NetworkTopologyWithNodeGroup</value>
</property>
<property>
  <name>net.topology.nodegroup.aware</name>
  <value>true</value>
</property>

-- hdfs-site.xml
<property>
  <name>dfs.block.replicator.classname</name>
  <value>org.apache.hadoop.hdfs.server.blockmanagement.BlockPlacementPolicyWithNodeGroup</value>
</property>
③ AvailableSpaceBlockPlacementPolicy
해당 정책은 데이터 노드의 디스크 사용률을 고려하여, 가능한 한 덜 사용된 노드를 선택해 블록을 배치할 수 있도록합니다. 이는 공간 균형을 유지하고 특정 노드에 과도하게 부하가 집중되는 것을 방지합니다. ( Github Code Link )
-- hdfs-site.xml
<property>
  <name>dfs.block.replicator.classname</name>
  <value>org.apache.hadoop.hdfs.server.blockmanagement.AvailableSpaceBlockPlacementPolicy</value>
</property>

<property>
  <name>dfs.namenode.available-space-block-placement-policy.balanced-space-preference-fraction</name>
  <value>0.6</value>
</property>

<property>
  <name>dfs.namenode.available-space-block-placement-policy.balanced-space-tolerance</name>
  <value>5</value>
</property>

<property>
  <name>dfs.namenode.available-space-block-placement-policy.balance-local-node</name>
  <value>false</value>
</property>
④ AvailableSpaceRackFaultTolerantBlockPlacementPolicy
해당 정책은 AvailableSpaceBlockPlacementPolicy 의 방식과 RackFaultTolerant 특성을 결합한 방식입니다. 즉, 가능한 최대 랙 수로 블록을 분산시키면서, 낮은 디스크 사용률을 가진 노드를 우선적으로 선택하려고 합니다. ( Github Code Link )
-- hdfs-site.xml
<property>
  <name>dfs.block.replicator.classname</name>
  <value>org.apache.hadoop.hdfs.server.blockmanagement.AvailableSpaceRackFaultTolerantBlockPlacementPolicy</value>
</property>

<property>
  <name>dfs.namenode.available-space-rack-fault-tolerant-block-placement-policy.balanced-space-preference-fraction</name>
  <value>0.6</value>
</property>

<property>
  <name>dfs.namenode.available-space-rack-fault-tolerant-block-placement-policy.balanced-space-tolerance</name>
  <value>5</value>
</property>
Replica 데이터 읽는 순서
HDFS에서는 하나의 블록을 여러 개의 노드에 복제하여 저장합니다. 이때 데이터를 읽는 과정에서 성능을 높이기 위해, HDFS는 클라이언트와 물리적으로 가까운 위치에 있는 복제본(replica)으로부터 데이터를 읽으려 시도합니다. 이를 복제본 선택(Replica Selection)이라고 부릅니다.
예를 들어, 클라이언트가 DataNode와 동일한 노드에서 실행되고 있다면, 해당 노드에 저장된 복제본을 바로 읽습니다. 만약 동일한 노드에 복제본이 없다면, 같은 랙(Rack)에 있는 노드를 우선적으로 선택하여 데이터를 읽습니다. 만약 이 또한 불가능하다면, 최종적으로는 다른 랙이나 다른 데이터센터에 있는 복제본을 선택하게 됩니다.
특히, HDFS 클러스터가 여러 데이터센터에 걸쳐 있는 경우에는 같은 데이터센터에 있는 복제본을 우선적으로 읽습니다. 이렇게 하는 이유는 글로벌 네트워크 대역폭(bandwidth)의 사용을 줄이고, 데이터 접근 지연 시간(latency)을 최소화하기 위한 전략이라고 할 수 있습니다.
SafeMode
Safemode는 NameNode가 기동될 때 진입하는 일종의 보호 상태입니다. 이 모드에서는 블록 복제와 같은 쓰기 작업이 일어나지 않으며, 전체 클러스터가 안정적인 상태에 도달할 때까지 읽기 전용 상태로 유지됩니다.
Safemode 동안 NameNode는 각 DataNode로부터 block report를 받아, 현재 클러스터에 존재하는 모든 블록들이 제대로 복제되어 있는지를 확인합니다. 이때, 모든 블록 중 일정 비율 이상이 정상적으로 복제되어 있다고 판단되면, Safemode에서 벗어나게 됩니다. 이 비율(%)은 환경 설정을 통해 조정할 수 있습니다.
Safemode에서 벗어난 이후에는, 아직 복제본 개수가 부족한 블록들에 대해 복제 작업이 자동으로 수행됩니다. 즉, Safemode는 클러스터가 완전히 동작하기 전까지 데이터를 보호하고, 일관성을 유지하기 위한 중요한 초기 상태라고 할 수 있습니다.
hdfs dfsadmin -safemode get   # SafeMode 상태 확인
hdfs dfsadmin -safemode enter # SafeMode 켜기
hdfs dfsadmin -safemode leave # SafeMode 끄기
1.5. Read 와 Write 시 내부에서 벌어지는 일
HDFS Write
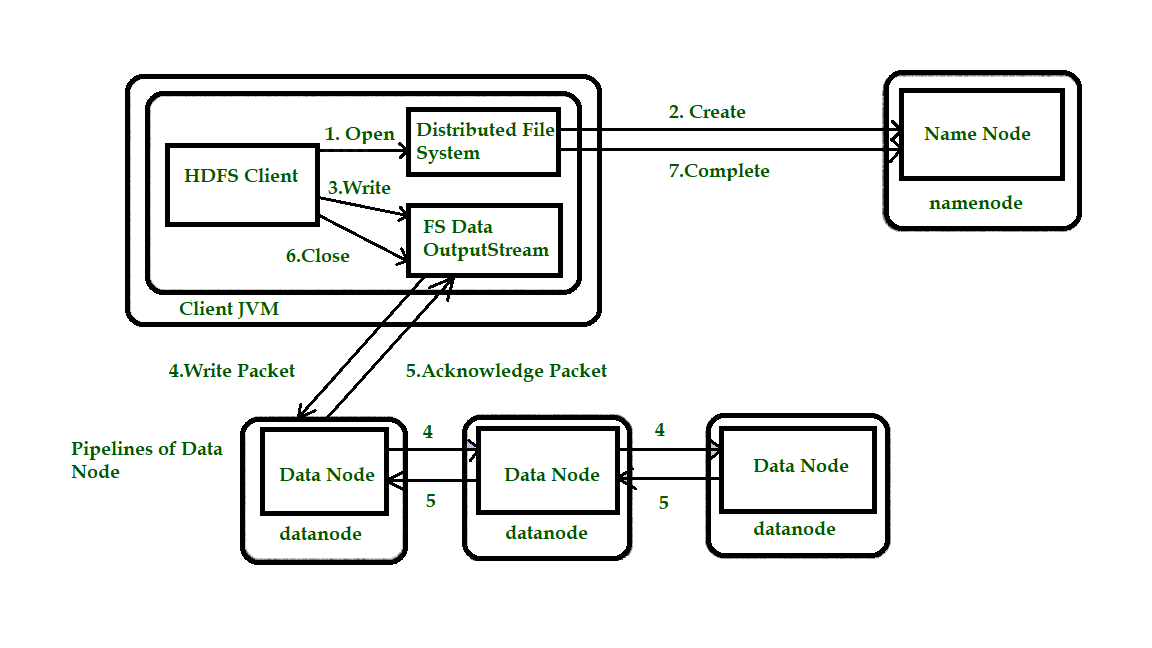
출처 : HDFS Write
- 새로운 파일 생성은 클라이언트가
DistributedFileSystem에서create()메소드 호출합니다. DistributedFileSystem는 RPC로 namenode에 연결하고, 새로운 파일 생성을 시작합니다. 이때 Namenode 은 새로운 파일 생성 요청에 대한 verification을 진행합니다. verification 은 파일이 이미 존재하는지, 해당 경로에 대한 권한 등을 확인합니다. 이 때 verification 에서 실패하면 client에서는IOException이 발생합니다. verification에 성공하면 namenode 에서 해당 파일에 대한 record 가 생성됩니다.- namenode 에서 파일 record 가 생성되면 클라이언트에
FSDataOutputStream가 리턴 됩니다.FSDataOutputStream은 write 를 수행합니다. FSDataOutputStream은 datanode 와 namenode 와 상호작용하는DFSOutputStream객체를 가지고 있습니다.DFSOutputStream는 클라이언트가 데이터를 write 하기 위한 packet을 만듭니다. 해당 packet 은DataQueue에 들어갑니다.DataStreamer가 NameNode에 새 블록 할당을 요청하고, 복제에 사용할 바람직한 DataNode를 선택하는 과정을 가집니다.- 복제 과정은 DataNode들로 파이프라인을 생성하면서 시작합니다. 기본적으로는 복제 수준이 3이기 때문에 파이프라인에 3개의 DataNode가 있게 됩니다.
DataStreamer는DataQueue로부터 데이터를 consume 해서 파이프라인의 첫번째 datanode 에 저장할 패킷을 전송합니다.- 하나의 파이프라인으로 묶인 모든 데이터노드는 저장을 위해 받은 packet 을 모두 저장하고, 이것을 파이프라인의 다음 데이터노드로 foward 합니다.
DFSOutputStream의 AckQueue는 DataNodes로부터 '가능' 이라는 승인을 받으면 저장되는 queue입니다.- 파이프라인의 모든 데이터노드로부터 Ack 가 Queue 에 들어오면, AckQueue 는 삭제됩니다. 만약 하나의 datanode 라도 데이터 저장과 ack 전송에 실패하면, Ack Queue 에 받은 패킷정보를 보고 재시작을 할 수 있습니다.
- 클라이언트의 write 작업이 끝나면,
close()메소드가 호출됩니다.close()는 모든 남은 data packet 을 flush 하고 ack 를 기다립니다. - 마지막 ack까지 도착하면 클라이언트는 namenode에 write 작업이 끝났음을 알리며, 마무리 됩니다.
HDFS Read
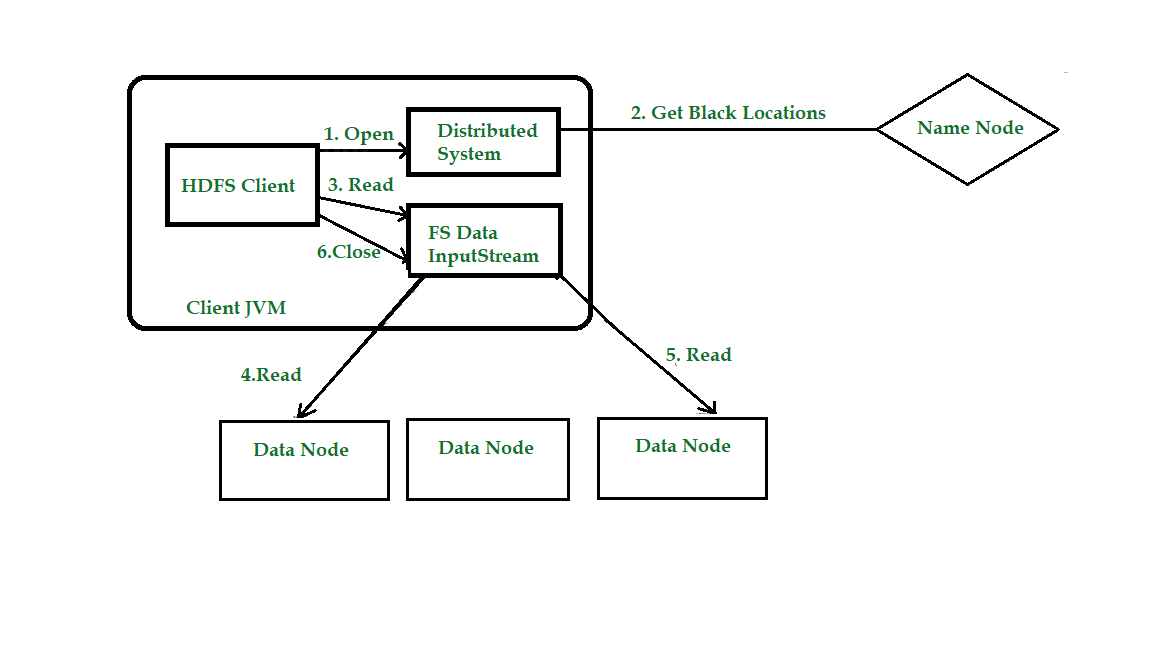
출처 : HDFS Read
- 클라이언트가
DistributedFileSystem의open()메소드로 HDFS 파일을 읽겠다는 요청을 시작합니다. DistributedFileSystem은 RPC로 namenode 에 연결합니다.- open 대상이 되는 파일의 메타데이터를 조회합니다. 이 때 메타데이터 안에는 해당 파일이 저장되어있는 block의 location 정보 등이 있습니다. (한 번에 모든 블록정보를 리턴하지 않고 처음 몇개의 블록의 주소를 리턴합니다.)
- 메타데이터 요청에 대한 응답으로 해당 블록(copy본 포함)을 가진 Datanode 들의 주소가 리턴됩니다.
- 받은 DataNode 주소정보로
FSDataInputStream객체를 만들어 client에게 전달됩니다.FSDataInputStream는 DataNode 와 NameNode 와 상호작용할 수 있는DFSInputStream객체를 가지고 있습니다. client가DFSInputStream에 대해 read() 메소드를 호출하고 대상 파일의 첫 번째 블록이 있는 datanode 와 connection 을 맺습니다. 이때 연결하는 대상은 primary datanode로, 가장 가까운 데이터 노드를 찾게 됩니다. a. 예1 - Local Block First. block A 가 datanode 1 에 primary 버전이 있고 datanode 2,3 에 replica 버전이 있다고 합시다. 이때 datanode2 에 위치한 client 에서 block A 에 대해 read 요청이 온다면, 자신의 로컬인 datanode 2의 replica 버전에서 데이터를 읽습니다. b. 예2 - Rack Awareness. block A 가 rack a에 위치한 datanode 1 에 primary 버전이 있고, rack b에 위치한 datanode 2 와 rack b에 위치한 datanode 3 에 replica 버전이 있다고 합시다. 이때 rack2 에 위치한 datanode 4에 있는 client 에서 block A 에 대해 read 요청이 온다면, 자신과 같은 rack2 에 위치한 datanode 2의 replica 버전에서 데이터를 읽습니다. - 데이터는
read()메소드를 반복해서 호출할때마다 stream 형태로 리턴됩니다. read 과정은 end of block 에 도달 할 때까지 지속됩니다. - end of block 에 도달하면,
DFSInputStream은 datanode 와의 연결을 끊고, 해당 파일의 다음 블록이 위치한 데이터 노드와 연결을 맺습니다. 이 과정은 해당 파일의 모든 블록을 읽을 때까지 반복 됩니다. - read 과정이 끝나면 client 는
close()로 모든 연결과 스트림을 닫고 마무리 됩니다.
2. Hadoop H/A 클러스터
Hadoop v1.x 버전 까지는 NameNode 는 SPOF(single point of failure)였습니다. 즉, 하나의 NameNode 가 망가지면 서비스 전체가 망가지는 구조였습니다. Hadoop 의 기본 아키텍처는 NameNode를 Master, Datanode 들을 Slave 로 하는 Master-Slave 구조입니다. 이 중 namenode 는 하나의 인스턴스, datanode 는 수평적 확장이 가능했으므로 namenode는 bottleneck 이 되기 쉬웠습니다. namenode 가 이용 불가능한 상태라면, datanode가 아무리 많더라도 클러스터 전체가 이용 불가능해집니다.
초기 버전에서는 namenode의 데이터 유실을 방지하는 secondary namenode 가 있었지만 Availability 문제를 완전히 해결하지는 못하였습니다. 이러한 상태라면 예상치 못한 장애 뿐만 아니라, 계획된 업그레이드나 업데이트를 위해서 downtime 이 발생할 수 밖에 없었습니다. 그래서 등장한 것이 H/A 아키텍처입니다.
HA 클러스터에서는 하나의 NameNode가 Active 상태로 동작하고, 다른 하나는 Standby 상태로 대기하고 있습니다. 이 두 NameNode는 항상 실행 중이며, Active NameNode에 장애가 발생하면 Standby NameNode가 자동으로 Active 상태로 전환되어 서비스를 지속할 수 있게 합니다. 이를 통해 다운타임을 최소화할 수 있습니다.
Standby NameNode는 단순한 대기 상태가 아니라, Hadoop 클러스터의 자동 장애 조치(Failover) 기능을 수행하며, 백업 NameNode로서의 역할도 담당합니다. 이로 인해 관리자가 수동으로 전환할 필요 없이 자동화된 장애 복구가 가능하며, 유지보수 작업 중에도 Graceful Failover를 기대할 수 있습니다.
HA 환경에서 데이터를 안정적으로 관리하기 위해 해결해야 할 두 가지 주요 이슈
첫 번째 : Active와 Standby NameNode는 항상 동기화되어야 합니다. 두 NameNode가 같은 상태를 유지하지 않으면 장애 발생 시 데이터 손실이 발생할 수 있습니다.
두 번째 : 동시에 두 개의 Active NameNode가 존재하면 안 됩니다. 두 개의 Active NameNode 가 있으면, 각 NameNode 가 관리하는 데이터의 일관성이 깨질 수가 있습니다. ( 실제로 네트워크가 단절되면 2개의 Active NameNode 가 일시적으로 생기기도 합니다. ) 이런 상황을 Split-brain이라고 부르며, 두 NameNode가 각각 다른 메타데이터를 관리하게 되어 심각한 데이터 충돌이 발생할 수 있습니다. 이를 방지하기 위해 Fencing이라는 절차를 통해 한쪽 NameNode의 접근을 차단하고, 단 하나의 Active NameNode만 존재하도록 보장합니다.
HA Architecture의 구현 방식
Hadoop에서 HA 환경을 구현하는 방법은 크게 두 가지가 있습니다.
첫 번째 : Quorum Journal Nodes 사용 여러 개의 JournalNode를 통해 NameNode 간 로그를 공유하고 동기화합니다. 다수결(Quorum) 방식을 통해 데이터 일관성과 장애 복구를 보장합니다.
두 번째 : NFS 기반의 공유 저장소 사용 Active와 Standby NameNode가 같은 스토리지를 바라보도록 구성합니다. 이 방식은 구현이 상대적으로 단순하지만, NFS 자체의 안정성과 성능에 의존하게 됩니다.
이 둘에 대해서는 아래에서 더 자세히 설명하도록 하겠습니다. 그리고 그 전에, 이러한 H/A 클러스터를 구성 할 수 있게 해준 핵심 엔진인 Zookeeper 와 Hadoop 의 관계를 조금 짚어보고 가겠습니다.
2.1. 클러스터 구성 위해 잠시 짚어갈 Zookeeper
Apache Zookeeper 에 대한 명확한 이론은 다른 포스팅에서 알아볼 예정이며, 지금은 이 Zookeeper 가 대략 무엇인지, 그리고 Hadoop 의 H/A Cluster 를 구성하기 위해 왜 필요한지만 간략하게 작성하겠습니다. Apache ZooKeeper는 분산 시스템에서 서버들 간의 상태를 관리하고 조율하는 역할을 수행하는 중앙 집중형 코디네이션 서비스입니다. Hadoop 클러스터에서는 NameNode의 고가용성(High Availability, H/A)을 구성할 때 필수적으로 사용됩니다.
기본적으로 Hadoop은 하나의 NameNode만을 사용합니다. 이 NameNode가 다운되면 전체 HDFS가 작동을 멈추기 때문에, 서비스 안정성을 위해 NameNode를 Active/Standby 구조로 이중화하는 것이 중요합니다. 이때 어느 NameNode가 Active가 될지 결정하고 상태를 감시하는 역할을 ZooKeeper가 맡습니다.
ZooKeeper는 Ephemeral 노드와 Watch 기능을 통해 두 NameNode의 상태를 감시합니다. 두 NameNode는 ZooKeeper에 연결되며, 서로 중복되지 않도록 하나만 Active 상태가 될 수 있습니다. Active로 선출된 NameNode는 ZooKeeper 내 ZNode를 선점하고, 나머지 하나는 Standby 상태로 대기합니다. 만약 Active NameNode가 비정상 종료되면 ZooKeeper는 이 연결이 끊긴 것을 감지하고, 대기 중이던 Standby NameNode를 자동으로 Active로 승격시킵니다. 이를 통해 서비스 중단 없이 NameNode를 전환할 수 있습니다.
해당 과정을 살펴보면, 다음과 같습니다.
첫번째, NameNode 상태 정보를 ZooKeeper의 ZNode에 등록합니다. HDFS 클러스터가 HA 모드로 구성되면, 각 NameNode는 ZKFailoverController(ZKFC) 프로세스를 함께 실행합니다. 이 ZKFC는 ZooKeeper와 연결되며, 자신의 NameNode가 Active 또는 Standby 상태인지를 나타내는 정보를 ZooKeeper의 ZNode에 Ephemeral(임시) ZNode로 등록합니다.
/hadoop-ha/[nameservice]/ActiveStandbyElectorLock
이 ActiveStandbyElectorLock 노드는 단 하나의 NameNode만 소유할 수 있으며, 이를 통해 현재 Active NameNode를 결정합니다. ( 이로써 스플릿 브레인 현상을 어느정도는 방어해 줄 수 있습니다. Zookeeper 는 자체 엔진만으로 Lock 을 구현할 수 있을만큼 동시성 이슈를 민감하게 처리 할 수 있습니다. )
두번째, Ephemeral ZNode와 Watcher를 통한 상태 감지 및 장애 인식을 합니다.
각 NameNode에는 ZKFailoverController(ZKFC)가 함께 실행되며, ZooKeeper와 연결됩니다.
이 ZKFC는 자신이 관리하는 NameNode가 Active 상태가 되었을 때, ZooKeeper 내부의 /hadoop-ha/[nameservice]/ActiveStandbyElectorLock 경로에 Ephemeral ZNode를 생성합니다. Ephemeral ZNode는 해당 ZKFC와 ZooKeeper 간의 세션이 유지되는 동안만 존재하며, 세션이 끊기면 자동으로 삭제됩니다.
이 ZNode에는 다른 Standby 상태의 ZKFC 인스턴스들이 watcher를 등록합니다. ZooKeeper는 해당 ZNode에 변화(삭제, 수정 등)가 발생하면, watch를 등록한 모든 ZKFC에게 일회성 이벤트 알림을 전달합니다. 이 이벤트는 Active NameNode가 비정상 종료되어 세션이 끊어지고, ZNode가 삭제된 경우 발생합니다.
이 알림을 받은 Standby NameNode들의 ZKFC는 장애 상황을 감지하고 즉시 Leader Election(리더 선출) 절차에 참여하게 됩니다. 이렇게 ZooKeeper는 자체적으로 장애를 처리하지는 않지만, Ephemeral ZNode와 watch 메커니즘을 통해 상태 변화를 빠르게 감지하고 알림을 전달함으로써, 클라이언트 측에서 장애 복구가 가능하도록 보조하는 역할을 수행합니다.
세번째, ZKFC가 상태 변화 감지 후 리더 선출을 진행합니다. Ephemeral ZNode 삭제는 ZooKeeper 내부적으로 watcher 메커니즘을 통해 모든 ZKFC에 통지됩니다. 각 Standby NameNode의 ZKFC는 각 NameNode 의 상태를 주기적으로 확인하다가, 이를 감지하고 즉시 Leader Election(리더 선출)에 참여합니다. 이 리더 선출은 ZooKeeper의 ActiveStandbyElector 클래스를 통해 구현되며, 선출된 리더만이 ActiveStandbyElectorLock ZNode에 새로 Ephemeral 노드를 생성할 권한을 획득합니다. 결국, 단 하나의 Standby NameNode만이 승격되어 Active 상태로 전환됩니다.
네번째, 새로운 Active NameNode 등록 및 상태를 반영합니다. 리더로 선출된 NameNode는 ZooKeeper의 ActiveStandbyElectorLock 경로에 Ephemeral ZNode를 생성하여 자신이 새로운 Active임을 등록합니다. 이후 클러스터의 다른 구성 요소(DataNode, Client 등)는 ZooKeeper에서 이 정보를 조회하여, 새롭게 승격된 NameNode로 연결합니다. 이 과정을 통해 서비스는 중단 없이 지속됩니다.
다섯번째, 기존 장애 NameNode 복구 후 Standby로 재등록합니다. 장애로 인해 종료되었던 NameNode가 재시작되면, 해당 노드의 ZKFC는 다시 ZooKeeper와 연결하여 Standby 상태로 클러스터에 참여합니다. 이때 ZooKeeper는 이미 Active가 존재함을 알고 있으므로, 중복 활성화를 방지하고 해당 노드를 Standby로만 유지합니다.
Apache Zookeeper 에 대한 더 자세한 이야기는 추후 Zookeeper 를 더 깊게 공부하고 다뤄보겠습니다. 현재는 zNode 의 개념과, watch 의 개념. 그리고 분산락의 개념 정도만 알아두어도, 하둡을 공부하는데에 문제가 없을것으로 생각됩니다.
2.2. Quorum Journal Nodes H/A
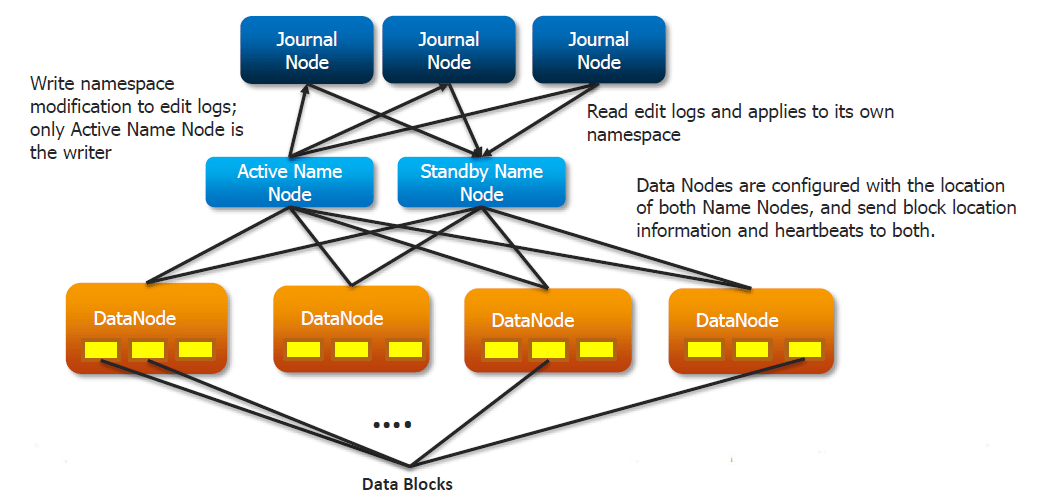
출처 : Quorum Journal Nodes
HDFS의 고가용성(HA) 아키텍처에서 Quorum Journal Nodes(QJN)이 필요하게 된 이유는, Zookeeper만으로는 EditLog 동기화 및 데이터 일관성 유지가 어렵기 때문입니다. Zookeeper는 주로 NameNode의 상태 관리와 Active/Standby 전환을 담당하지만, HDFS에서 중요한 역할을 하는 EditLog의 저장과 동기화는 처리하지 못합니다. 또한, 두 개의 NameNode가 동시에 Active가 되는 Split-brain 현상을 방지하기 위해서는, Quorum Journal Nodes와 같은 별도의 메커니즘이 필요합니다.
Active와 Standby NameNode는 Journal Nodes라는 별도의 노드 그룹(또는 데몬 프로세스)을 통해 동기화를 유지합니다. Journal Nodes는 ring topology로 서로 연결되어 있습니다. Journal Node에 들어온 request는 ring 구조를 따라 다른 노드로 복사됩니다. 이로 인해 특정 Journal Node에 failure가 발생해도 Fault Tolerance가 보장됩니다. Active NameNode는 Journal Node에 있는 EditLogs를 업데이트합니다. Standby NameNode는 Journal Node로부터 EditLogs의 변경 사항을 읽고, 그것을 자신의 namespace에 적용합니다. Failover 시에 Standby NameNode는 Active NameNode가 되기 전에 우선 자신이 가진 metadata의 내용이 Journal Node에 있는 모든 업데이트를 반영한 상태인지 확인합니다. Journal Node의 모든 데이터가 싱크되었다면 그때 Active NameNode가 됩니다. 모든 DataNode는 Active NameNode와 Standby NameNode의 IP 주소를 모두 알고 있습니다. DataNode는 자신의 heartbeat와 block report 데이터를 두 NameNode에게 보냅니다. 이로 인해 Standby는 Active가 되기 전에 이미 DataNode 정보와 block location 정보를 모두 알고 있으므로 빠르게 failover를 수행할 수 있습니다.
특히, Split-brain 현상을 방지하기 위해, QJN은 하나의 NameNode만이 EditLog를 기록하도록 보장합니다. Standby NameNode가 QJN에 대한 write 권한을 획득하면, 다른 NameNode는 Active 상태로 전환되지 못하도록 막습니다. 이 과정은 Fencing이라고 하며, 이를 통해 두 NameNode가 동시에 Active 상태가 되는 문제를 예방할 수 있습니다. Fencing이 완료된 후, Standby는 Active 역할을 수행할 수 있게 됩니다.
2.3. Shared Storage H/A
링 형 구조로 별도 저널 노드들이 서로 연결되어 동기화하는 Quorum Journal Nodes 방법도 있지만, 하나의 스토리지를 공유하는 Shared Storage 방식도 있습니다. 먼저 Active NameNode는 EditLog를 공유 스토리지에 기록합니다. 이후 Standby NameNode는 공유 스토리지에 저장된 EditLog를 읽어 자신의 namespace에 반영합니다. 이 과정은 Standby NameNode가 Active NameNode로서의 역할을 맡을 준비가 되도록 도와줍니다.
Failover가 발생하면, Standby NameNode는 공유 스토리지에 있는 EditLog의 모든 변경 사항을 반영한 후, Active NameNode로 전환됩니다. 이때, Standby NameNode는 모든 변경 사항을 적용한 후에 Active 상태로 변환되기 때문에 데이터 일관성을 유지할 수 있습니다.
또한, Split-brain을 방지하기 위해, Shared Storage 환경에서도 fencing 메커니즘이 필요합니다. 여기서 Fencing은 두 개의 NameNode가 동시에 Active 상태가 되는 것을 방지하는 방법입니다. 하둡을 관리하는 관리자는 적어도 하나의 fencing 방법을 설정해야 합니다.
다양한 fencing 방법이 있을 수 있는데... 예를 들어, 문제가 되는 NameNode의 프로세스를 종료시키거나, 해당 NameNode 의 공유 스토리지에 대한 액세스 권한을 취소하는 방식이 있을 수 있습니다. 그레이스풀한 종료가 어려운 환경에 있다면, STONITH(Shoot the Other Node in the Head) 라는 마지막 수단으로 사용할 수 있는 fencing 방법이 있습니다. STONITH는 특수 전원 공급 장치를 이용해 활성화된 NameNode의 머신을 강제로 종료시킵니다. 이를 통해, Split-brain 상황을 방지하고 시스템의 일관성을 유지할 수 있습니다.
2.4. Failover
결국 위와 같은 방법들을 공부해야 하는 이유는, 클러스터 환경에서 장애 조치를 어떻게 할 것인가를 위해서입니다. 여기서 장애 조치는, 시스템에 문제가 발생했을 때, 이를 감지하고 두 번째 시스템으로 자동으로 전환하는 과정을 의미합니다 장애 조치에는 두 가지 방식이 있는데, 관리자가 계획적이고 의도적으로 진행하는 Graceful Failover 가 있고, 관리자가 의도하지 않은 타이밍에 갑자기 진행되는 Atomic Failover 가 있습니다.
우리가 위에서 알아보았던, Zookeeper 를 통한 Failover 과정은 이러한 Atomic Failover 과정이라고 할 수 있습니다.
2.5. Observer NameNode ( ONN )
하둡에 대한 첫 게시글인 분산 시스템의 이해와 하둡의 등장 배경 에서 Version 에 대한 포스팅 부분에서 미처 이야기 하지 못한 부분이 바로 Observer NameNode 입니다. Observer NameNode 는 하둡 3.x 버전부터 사용 할 수 있습니다. ( 의도적으로 빼먹은 건 아니고, 깜빡했다 ㅎㅎ... )
그럼 대체 Observer NameNode 가 무엇이고 왜 생긴 것일까요. 위에서 포스팅한 HA 아키텍처에서 Active NameNode는 클라이언트의 모든 요청을 받으며, Standby NameNode는 단순히 Active NameNode와 같도록 동기화만 수행합니다. HA는 달성되었지만, 여전히 단일 Active NameNode가 병목 현상을 일으키는 문제는 발생할 수 있습니다. 단일 Active NameNode에 부하가 심해지면, HA를 이용하여 Failover가 발생하더라도 부하로 인해 Active NameNode를 사용할 수 없는 상태가 연쇄적으로 발생할 수 있습니다.
그렇기에 등장한 것이 Observer NameNode 입니다. Observer NameNode는 HDFS에서 Active NameNode와 Standby NameNode의 기능을 결합한 역할을 합니다. Standby NameNode는 Active NameNode와 동기화되어 있지만, 실제로 클라이언트의 요청을 처리하지 않고, 장애 발생 시 Failover를 위해 대기만 합니다. 반면, Observer NameNode는 Standby와 유사하게 상태를 유지하지만, Active NameNode처럼 읽기 요청도 처리할 수 있습니다. 즉, Observer NameNode는 데이터를 읽는 요청을 받아들일 수 있으며, 이를 통해 Active NameNode의 부하를 분산시킬 수 있습니다.
HDFS의 일반적인 사용 사례는 "write-once-read-many" 접근 방식을 따릅니다. 즉, 한 번 쓰고 여러 번 읽는 경우가 많습니다. 이러한 특성 덕분에 Observer NameNode가 읽기 요청을 분담함으로써 Active NameNode의 부하를 크게 줄일 수 있습니다. 결국 Active NameNode가 처리해야 할 읽기 작업의 양이 줄어들어 시스템의 전체 성능을 개선할 수 있습니다.
이에 따라, NameNode 는 하둡 3 버전부터, HA Hadoop Cluster 에서 3가지 상태를 가질 수 있게 됩니다. ( Active, Standby, Observer ) 또한, NameNode 의 상태를 변경할 때는 다음과 같은 규칙이 있습니다.
active → observer ( : ❌ 불가능 ) observer → active ( : ❌ 불가능 ) active → standby → observer ( : ✅ 가능 ) observer → standby → active ( : ✅ 가능 )
즉, 가능한 전이 순서는 반드시 중간에 standby를 거쳐야 합니다. 이렇게 정한 이유는, 일반적으로 안정성과 일관성 유지를 위한 것입니다. 특히 observer는 passive(수동적) 역할이기 때문에, 곧바로 서비스를 운영하는 active로 전환되면 위험할 수 있어 이런 제한을 둡니다.
Read-Write 의 일관성 유지 방법 ( 하나의 클라이언트 - read your own writes )
기존 하둡은 쓰기 작업이 완전히 종료되어 close() 메서드가 실행됨으로써 NameNode의 edit log에 반영되고, 해당 block이 최종적으로 commit되기 전까지는, 다른 클라이언트는 물론, 동일 클라이언트라도 그 데이터는 보장되지 않았습니다.
그렇기 때문에 write 도중 read 를 하여도 문제가 되지 않게끔 설계가 되어있었습니다. 하지만 하둡 V3 에 등장한 Observer NameNode 는, wrtie 가 close() 는 되었지만, NameNode 로부터 복사를 완료하지 못하여 일관성을 보장하지 못하는 경우가 발생하게 됩니다.
위에서 설명하였듯, Observer NameNode 는 Active NameNode 와 비슷한 역할을 하지만 read 전용입니다. 그런데 일관성이 깨지게 되면, 읽기 성능에 문제가 발생하게 됩니다. 그래서 하둡 V3 부터는 State ID 라는 것을 도입하게 됩니다.
Iceberg 나, Hudi 등을 공부한 적이 있다면, 이 테이블 포멧들이 ACID 를 보장해 줄 때, 스냅샷 아이디라는 것을 쓰는 걸 알 수 있습니다. 하둡도 비슷한 개념으로 State ID 를 사용합니다.
state ID는 Namenode의 transaction ID를 기반으로 생성되며, 클라이언트 측에서 내부적으로 저장 및 관리됩니다. 클라이언트는 이 state ID를 RPC 요청의 헤더에 포함시켜 NameNode에 전달합니다. 이 state ID는 Hadoop 내부의 DFSClient와 같은 구성 요소에서 메모리 상으로 유지되며, 클라이언트가 쓰기나 읽기 작업을 수행할 때마다 갱신되고 전송됩니다 예를 하나 들어보겠습니다.
클라이언트가 Active NameNode를 통해 데이터를 HDFS에 씁니다. Active NameNode는 클라이언트가 요청한 데이터를 DataNode에 저장하도록 지시하고, 해당 작업에 대한 transaction ID를 생성합니다. 클라이언트는 이 transaction ID를 기반으로 state ID를 갱신합니다.
클라이언트가 데이터를 읽기 위해 Observer NameNode 에 읽기를 요청합니다. 이 때, 클라이언트는 이전에 갱신한 state ID를 Observer NameNode에 전달합니다. Observer NameNode는 자신이 가지고 있는 현재 transaction ID와 클라이언트가 보낸 state ID를 비교합니다. ( 하나의 클라이언트일 경우, write 한 쪽에서 계속 state ID 를 가지고 있게 때문에 가능합니다. )
만약, Observer NameNode의 transaction ID가 클라이언트가 보낸 state ID보다 같거나 더 최신이라면, Observer는 읽기 작업을 수행합니다. 결과적으로, 클라이언트는 자신이 쓴 최신 데이터를 바로 읽을 수 있습니다. 하지만 클라이언트가 갱신된 상태 ID를 보내지 않은 경우, Observer NameNode가 클라이언트의 요청을 처리하는 데 있어 최신 상태를 반영하지 못할 수 있습니다. 그럴 경우에는 이전 데이터를 읽게 됩니다.
💡 Stats ID 는 “파일 단위”나 “디렉토리 단위”가 아니라, HDFS 전체 메타데이터의 글로벌한 변경 순서를 나타내는 값입니다.
Observer NameNode 의 Edit Log Tailing
Observer NameNode에게 Edit log tailing은 매우 중요한 기능입니다. 이는 Active NameNode에 기록되는 새로운 트랜잭션들을 Observer NameNode가 얼마나 빠르게 반영하느냐에 따라, 읽기 요청 처리 시의 일관성과 정확도가 결정되기 때문입니다. Observer NameNode는 읽기 전용 요청을 처리하여 Active NameNode의 부하를 줄이는 역할을 합니다. 그러나 메타데이터가 최신 상태로 반영되지 않으면 오래된 데이터를 응답하게 되어 전체 시스템 신뢰도에 악영향을 줄 수 있습니다. 따라서 Edit log tailing의 반영 지연 시간, 즉 latency를 줄이는 것이 성능 향상에 매우 중요합니다.
기존의 Edit log tailing 방식은 HTTP 기반 통신을 사용하였고, Edit log가 디스크에 flush된 이후에야 Observer가 로그를 tailing할 수 있었습니다. 이 방식은 통신 속도와 디스크 I/O 의존성 측면에서 latency가 클 수밖에 없었습니다.
이를 개선하기 위해 새롭게 도입된 Edit Tailing Fast-Path 방식은 latency를 줄이기 위한 두 가지 핵심 변경점을 포함하고 있습니다. 첫째, 기존의 HTTP 통신 대신 RPC 기반 통신을 사용하여 더욱 빠르고 효율적인 로그 전달이 가능해졌습니다. RPC는 무거운 기능 없이 간단하게 통신할 수 있고, 개발자가 어떻게 통신할지 직접 정할 수 있어서, 불필요한 지연이 줄어들고 더 빠르게 데이터를 주고받을 수 있습니다. 둘째, JournalNode의 in-memory cache를 활용함으로써 디스크에 로그가 기록되기를 기다릴 필요 없이 메모리에서 직접 edit log 항목을 가져올 수 있게 되었습니다. 이로 인해 Observer NameNode는 거의 실시간에 가까운 로그 반영이 가능해졌습니다.
결과적으로 Edit Tailing Fast-Path는 Observer NameNode의 latency를 획기적으로 줄이며, 메타데이터 반영 속도를 높여 전체 HDFS 시스템의 성능과 신뢰성을 향상시키는 데 크게 기여하게 되었습니다.
Client-side Proxy Provider
ObserverReadProxyProvider 라는 클래스는 클라이언트가 데이터를 읽을 때 사용되는 새로운 클라이언트 측 프록시 제공자입니다. 이 클래스는 기존의 ConfiguredFailoverProxyProvider 를 상속받아 만들어졌습니다. 이를 통해 클라이언트는 데이터를 읽을 때 active namenode뿐만 아니라 observer namenode에서도 읽을 수 있게 됩니다.
클라이언트가 읽기 요청을 보내면, ObserverReadProxyProvider는 먼저 클러스터 내에서 사용 가능한 observer namenode를 통해 데이터를 읽으려 시도합니다. 만약 모든 observer namenode에서 읽기에 실패할 경우, 그때서야 active namenode로 요청을 보냅니다.
Read-Write 의 일관성 유지 방법 ( 여러 다른 클라이언트 - Maintaining Client Consistency)
앞에서 설명한 "read your own writes" 개념에 따라, 클라이언트 'A'가 active NameNode에 a.txt 파일을 생성했다고 가정합니다. 이 경우, 'A'가 observer NameNode에 데이터를 읽으라고 요청하면, observer는 a.txt 파일이 완전히 생성되었는지 확인한 후에 응답합니다. 즉, 'A'는 자신이 쓴 데이터를 바로 읽을 수 있습니다.
하지만 'A'가 파일을 생성한 뒤, 이 사실을 HDFS와 무관한 다른 클라이언트 'B'에게 알려주었다고 해봅시다. 이후 'B'가 HDFS에서 a.txt를 읽으려고 시도할 경우, 해당 파일을 읽을 수 있다는 보장은 없습니다. 이유는 'B'가 observer NameNode를 통해 데이터를 읽으려 할 때, 해당 observer가 아직 최신 메타데이터로 동기화되지 않았을 수 있기 때문입니다.
이러한 문제, 즉 클라이언트 간의 일관성 결여를 해결하기 위해 msync()라는 기능이 도입되었습니다. msync()를 호출하면 클라이언트는 active NameNode의 최신 상태 ID(state ID)를 동기화하게 됩니다. 이 과정을 거치면 이후 모든 읽기 요청은 해당 시점까지의 메타데이터와 일치하게 됩니다. 즉, 'B'가 msync()를 먼저 호출한 후 a.txt를 조회하면, 파일을 정상적으로 읽을 수 있게 됩니다.
msync()를 사용하기 위해 애플리케이션 코드를 따로 수정할 필요는 없습니다. 클라이언트는 observer NameNode에서 읽기를 수행하기 전에 자동으로 msync()를 호출하여 초기화 전에 발생한 쓰기를 볼 수 있도록 합니다.
또한 ObserverReadProxyProvider는 자동 msync() 모드를 지원합니다. 이 모드를 설정하면 일정한 간격으로 자동으로 msync()를 수행하며, 클라이언트가 일정 시간 이상 오래된 데이터를 읽지 않도록 보장합니다. 단, 이 기능은 msync() 호출마다 active NameNode에 RPC를 수행하므로 성능 오버헤드가 발생할 수 있으며, 기본 설정으로는 비활성화되어 있습니다.
설정 방법은 아래와 같습니다.
-- hdfs-site.xml
<property>
  <name>dfs.client.observer.auto-msync.enabled</name>
  <value>true</value>
</property>

<property>
  <name>dfs.client.observer.auto-msync.interval.ms</name>
  <value>5000</value> <!-- 5초마다 `msync()` 수행 -->
</property>
이 내용을 좀 더 직관적이고, 순서대로 정리를 해보겠습니다.
-
A 클라이언트(foo)가 a.txt 파일 생성 A는 active NameNode에 a.txt 파일을 생성하는 write 요청을 보냅니다. 이 write는 active NameNode에서 처리되고, 이후 observer NameNode로 메타데이터가 비동기 전파됩니다.
-
B 클라이언트(bar)가 observer NameNode에 read 요청 B는 a.txt 파일을 읽기 위해 observer NameNode에 read 요청을 보냅니다. 하지만 이 시점에 observer NameNode가 아직 최신 메타데이터(a.txt 생성 정보)를 받지 못했을 가능성이 있습니다.
-
B가 a.txt를 읽지 못하는 경우 발생 observer가 아직 동기화되지 않았다면, B는 a.txt 파일을 찾을 수 없거나 존재하지 않는다는 응답을 받을 수 있습니다.
-
클라이언트 간 일관성 문제 발생 같은 시점에 A는 파일을 볼 수 있는데, B는 볼 수 없는 read-your-own-writes 불일치 상황이 발생합니다.
-
이를 해결하기 위한
msync()호출 B가msync()를 명시적으로 호출하거나 자동msync()기능이 활성화되어 있다면, B는 active NameNode의 최신 상태 ID를 동기화합니다. -
B가 observer에 다시 read 요청 이제 observer는 active NameNode에서 전파된 최신 메타데이터 상태를 반영하게 되어, B는 정상적으로 a.txt를 읽을 수 있습니다.
msync()가 동작하면, 클라이언트가 msync() 호출 → active NameNode에 최신 state ID 요청 → active NameNode가 최신 state ID 응답 → 클라이언트는 해당 state ID 기준으로 observer NameNode와 동기화 여부 확인 → observer가 최신이면 observer에서 read, 아니면 active로 read 우회의 과정을 거칩니다.
3. Eraser Coding
3.1. Software Data Fault Tolerance
Hadoop은 기본적으로 데이터의 내결함성을 보장하기 위해 하나의 데이터 블록에 대해 3개의 복제본(replica)을 생성하여 저장합니다. 이 복제본들은 서로 물리적으로 다른 위치에 저장되며, 일반적으로는 서로 다른 머신, 다른 랙(Rack), 심지어는 서로 다른 데이터 센터에 분산시켜 저장합니다. 이와 같은 방식은 특정 하드웨어에 장애가 발생하더라도 데이터가 유실되지 않도록 보호하는 역할을 합니다.
복제본 기반의 데이터 보호 방식은 매우 강력한 내결함성을 제공하는 반면, 다음과 같은 단점이 존재합니다. 첫째, 동일한 데이터를 여러 벌 저장해야 하기 때문에 데이터를 저장할 때 시간과 리소스가 더 많이 소모됩니다. 특히 Write 작업 시 성능 저하가 발생할 수 있습니다. 둘째, 3개의 복제본을 유지하기 위해 실제 데이터 크기의 3배 이상의 저장 공간이 필요하게 되므로, 저장 비용이 상당히 증가합니다.
이러한 문제를 해결하기 위한 방안 중 하나로 Hadoop 3에서는 Erasure Coding(삭제 코드) 기법을 도입하여 스토리지 효율성과 내결함성을 동시에 확보하고자 하였습니다. (※ Erasure Coding에 대해서는 아래에서 다루겠습니다.)
3.2. Hardware Data Fault Tolerance & RAID
Hadoop 클러스터는 위에서 설명한 것처럼 소프트웨어적으로 복제본을 통해 데이터 유실을 방지할 수 있습니다. 하지만, 시스템 전체의 내결함성 수준을 더 높이기 위해 하드웨어 차원에서의 보완 방법을 함께 적용하는 경우도 있습니다.
대표적인 방법 중 하나는 RAID(Redundant Array of Independent Disks) 구성을 통해 하드웨어 자체에서 장애에 대응하는 것입니다. 예를 들어 RAID-5나 RAID-6 같은 방식은 디스크 일부에 패리티(Parity) 정보를 저장함으로써, 특정 디스크가 고장나더라도 데이터를 복구할 수 있도록 합니다.
하드웨어 기반의 Fault Tolerance는 소프트웨어를 수정하지 않고도 데이터 보호 수준을 향상시킬 수 있다는 장점이 있습니다. 그러나 이러한 RAID 구성을 사용하면 추가적인 저장 공간이 필요하며, 데이터 저장 또는 복구 시 더 많은 시스템 자원이 소모되므로 비용이 증가합니다. 그러면, 본격적인 Hadoop 의 Eraser Coding 을 알아보기 전에, RAID 의 개념을 간단하게나마 짚고 넘어가겠습니다.
RAID 란?
RAID는 Redundant Array of Inexpensive Disks의 약자로, 여러 개의 독립적인 하드 디스크를 하나의 논리적인 장치로 묶어 데이터를 저장하는 기술입니다. 우리말로는 보통 중복 배열 디스크 또는 복수 저가형 디스크 배열이라고 번역됩니다.
즉, 1개의 Disk 를 가상화로 각 독립적인 배열 Drive 로 나누는 것을 RAID 라고 합니다. ( ex - 1개의 Disk 를 가지고 있지만, C 드라이브와 D 드라이브로 나누는 것. ) 회사 by 회사겠지만, 보통 현업에서는 1 Disk 당, 1 Drive 로 Mapping 하여 사용하는 것이 일반적입니다.
RAID는 디스크를 배열로 가상화하여 구성함으로써, 성능(Performance), 용량(Capacity), 신뢰성(Reliability) 측면에서 시스템을 향상시키는 효과가 있습니다. 예를 들어, 데이터를 병렬로 읽고 쓸 수 있어 I/O 성능이 향상되며, 일부 디스크에 장애가 발생하더라도 나머지 디스크의 정보로 데이터를 복구할 수 있는 내결함성을 제공합니다. RAID 구현 방식은 크게 하드웨어 RAID와 소프트웨어 RAID로 나뉩니다.
하드웨어 RAID는 전용 RAID 컨트롤러를 사용하여 RAID 구성을 물리적으로 관리합니다. 이 방식은 운영체제와 독립적으로 동작하며, 시스템 자원 소모가 적고 안정성 및 성능이 뛰어나다는 장점이 있습니다. 다만, 전용 장비가 필요하므로 구축 비용이 높고, 컨트롤러 고장 시 전체 시스템이 영향을 받을 수 있는 단점도 존재합니다. 소프트웨어 RAID는 RAID 기능을 운영체제가 직접 구현하여 관리하는 방식입니다. 별도의 하드웨어가 필요 없기 때문에 비용이 저렴하고 설정이 유연하지만, CPU와 메모리 등 시스템 자원을 더 많이 사용하게 되며, 성능 면에서는 하드웨어 RAID에 비해 다소 낮을 수 있습니다.
RAID는 구성 방식에 따라 RAID 0, RAID 1, RAID 5, RAID 6, RAID 10 등 여러 레벨로 나뉘며, 각 방식은 데이터 보호 수준, 쓰기/읽기 성능, 디스크 사용 효율성에 따라 선택하게 됩니다. 이렇게 0, 1, 5, 6, 10 등으로 나누는 것은 하드웨어 RAID든 소프트웨어 RAID든 둘 다에서 구현할 수 있는 구성 방식입니다.
아래는 RAID 의 종류 몇 가지를 정리하였습니다. ( Hadoop 내용이기 때문에, RAID 내용은 간단하게 기본적인 내용만 정리하였습니다. )
RAID 0
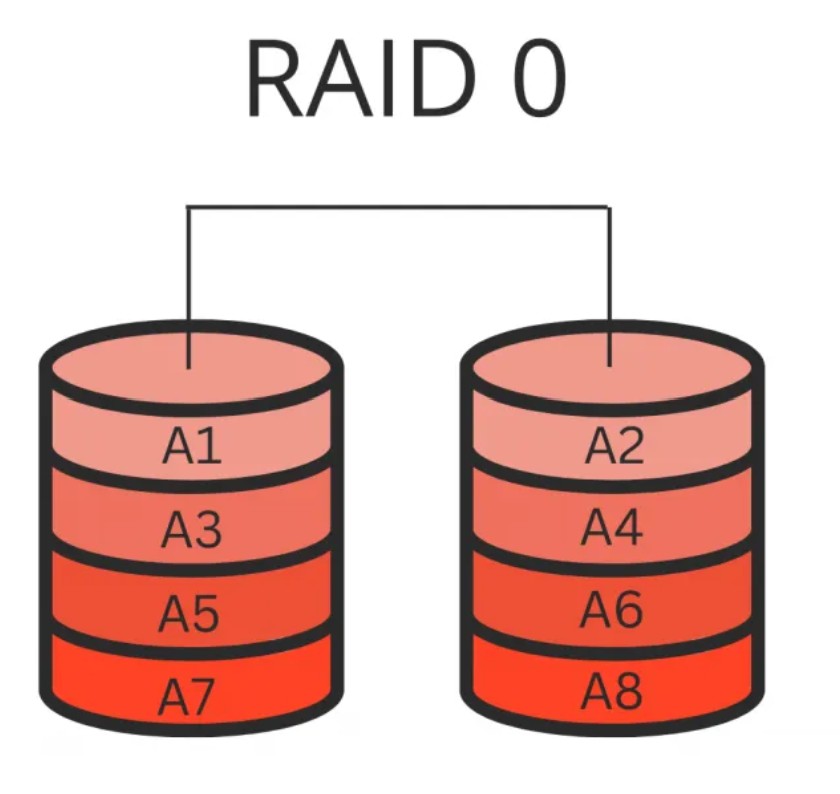
출처 : RAID 0 Image
RAID 0은 데이터를 블록 단위로 분할(striping)하여 여러 드라이브에 분산 저장하는 방식입니다. 이 구성은 데이터를 순차적으로 나누어 각 디스크에 배열처럼 저장하기 때문에, 드라이브 수만큼 동시에 읽기/쓰기 작업이 가능합니다. 그 결과, I/O 성능이 매우 우수하며 저장 공간의 손실도 없이 전체 디스크 용량을 모두 활용할 수 있습니다. 또한, 패리티 계산이나 중복 저장이 없기 때문에 오버헤드가 전혀 발생하지 않는다는 장점이 있습니다.
하지만 RAID 0은 데이터 중복(redundancy)이 전혀 없는 구조입니다. 즉, 하나의 디스크라도 고장이 나면 해당 디스크에 저장된 데이터는 복구가 불가능하며, 전체 파일이 손상될 가능성이 매우 높습니다. 이로 인해 RAID 0은 신뢰성보다는 성능이 중요한 경우에만 적합합니다.
따라서 RAID 0은 데이터 보존이 중요하지 않은 임시 작업 공간이나 고속 캐시, 비중요 테스트 환경 등에 활용되며, 데이터 보관이나 복구가 필요한 환경에서는 절대 권장되지 않습니다.
RAID 1
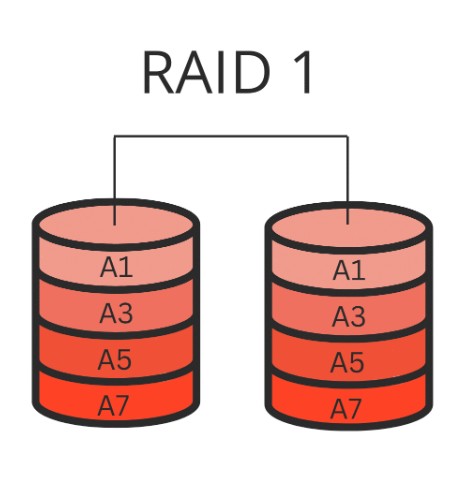
출처 : RAID 1 Image
RAID 1은 동일한 데이터를 최소 두 개의 드라이브에 동일하게 저장하는 방식입니다. 이 구조는 하나의 드라이브에 장애가 발생하더라도, 다른 드라이브에 동일한 데이터가 저장되어 있기 때문에 데이터 유실 없이 안정적인 운영이 가능합니다. 즉, 장애 허용(fault tolerance) 능력이 RAID 0보다 훨씬 뛰어납니다.
또한, RAID 1은 읽기(Read) 성능이 우수한 편입니다. 데이터는 두 개의 디스크 중 더 빠르게 접근 가능한 쪽에서 읽을 수 있기 때문에, 병렬 읽기가 가능하여 응답 속도가 향상됩니다. 반면, 쓰기(Write) 성능은 RAID 0에 비해 느릴 수 있습니다. 동일한 데이터를 모든 드라이브에 중복 저장해야 하기 때문입니다. 또한 RAID 1은 물리적으로 두 개의 드라이브를 사용하더라도, 실제로 사용할 수 있는 용량은 절반 수준인 50%입니다. 예를 들어, 1TB 디스크 2개를 구성하면 실질적으로는 1TB의 공간만 사용할 수 있습니다.
따라서 RAID 1은 데이터 안정성이 중요한 시스템에 적합하며, 속도보다 가용성과 복구 가능성을 우선시하는 환경에서 많이 사용됩니다.
RAID 5, 6를 배우기전에, Parity 에 대하여
RAID 5와 RAID 6은 단순 복제(RAID 1)나 분산 저장(RAID 0)과 달리, '패리티(Parity)'라는 개념을 기반으로 데이터 복구 기능을 제공합니다. 이 패리티가 RAID의 핵심적인 복구 메커니즘이기 때문에, 먼저 Parity가 무엇인지 이해하지 못하면 RAID 5/6의 구조와 동작 원리를 이해하기 어렵습니다.
Parity(패리티)는 컴퓨터 과학에서 데이터의 오류 검출을 위해 사용하는 비트입니다. 일반적으로는 7비트의 원래 데이터에 1비트의 Parity Bit를 추가하여 전송 도중 발생할 수 있는 데이터 오류를 감지할 수 있게 합니다.
Parity는 크게 두 가지 방식이 있다 :
- Even Parity (짝수 패리티) : 전체 비트 중 1의 개수가 짝수가 되도록 Parity Bit를 설정
- Odd Parity (홀수 패리티) : 전체 비트 중 1의 개수가 홀수가 되도록 Parity Bit를 설정
Parity 예시 : 7비트 데이터 → 8비트 패리티 처리
| 7 bits of data | 1-bit count | 8 bits (Even Parity) | 8 bits (Odd Parity) |
|---|---|---|---|
0000000 |
0 | 00000000 |
00000001 |
1010001 |
3 | 10100011 |
10100010 |
1101001 |
4 | 11010010 |
11010011 |
1111111 |
7 | 11111111 |
11111110 |
패리티 비트는 단순한 오류 감지뿐만 아니라, RAID 시스템에서는 장애 디스크의 데이터를 복구하는 핵심 요소로 발전했습니다.
Parity 블록의 특징
주로 XOR 연산을 사용하여 생성하며, 복수의 데이터 블록들을 XOR 연산한 결과를 패리티 블록에 저장합니다. 디스크 하나가 고장나면, 나머지 데이터 + 패리티로 유실된 블록을 복구할 수 있습니다.
💡 XOR(배타적 논리합, Exclusive OR) 연산 : 두 개의 비트가 서로 다를 때 1, 같을 때는 0을 반환하는 논리 연산입니다. 💡 0 ⊕ 0 = 0 그리고, 1 ⊕ 1 = 0 그리고, 0 ⊕ 1 = 1 그리고, 1 ⊕ 0 = 1 가 있습니다.
Parity 예제 : 5개의 디스크 중 1개가 장애 발생한 경우
⭕ 정상 상태 예시 :
| DISK 1 | DISK 2 | DISK 3 | DISK 4 | DISK 5 (Parity) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 = 0⊕0⊕0⊕0 |
| 0 | 1 | 0 | 1 | 0 = 0⊕1⊕0⊕1 |
| 0 | 1 | 1 | 0 | 0 = 0⊕1⊕1⊕0 |
| 1 | 0 | 0 | 1 | 0 = 1⊕0⊕0⊕1 |
| 1 | 0 | 0 | 0 | 1 = 1⊕0⊕0⊕0 |
❌ DISK 3 장애 발생 시 :
| DISK 1 | DISK 2 | DISK 3 (❌) | DISK 4 | DISK 5 (Parity) |
|---|---|---|---|---|
| 0 | 0 | ❌ | 0 | 0 |
| 0 | 1 | ❌ | 1 | 0 |
| 0 | 1 | ❌ | 0 | 0 |
| 1 | 0 | ❌ | 1 | 0 |
| 1 | 0 | ❌ | 0 | 1 |
Parity 복구 방식
패리티는 XOR 연산이기 때문에, 유실된 블록을 제외한 모든 블록과 패리티를 XOR 하면 유실된 블록 값을 역산할 수 있습니다.
RAID 5
그럼 다시 RAID 로 돌아와서, 이번에는 RAID 5입니다.
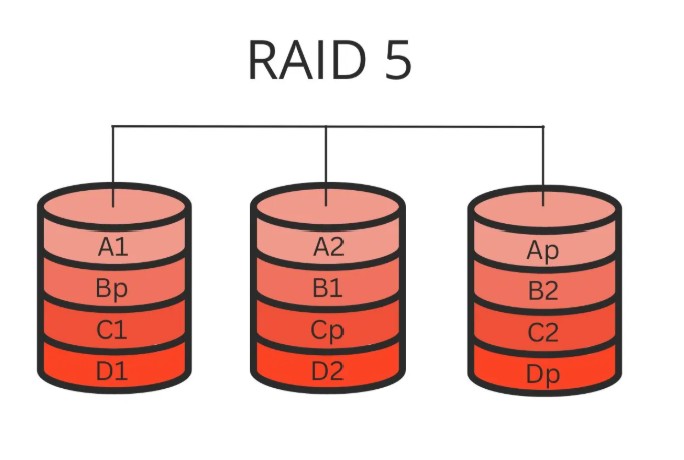
출처 : RAID 5 Image
RAID 5는 최소 3개 이상의 드라이브로 구성해야 하는 스토리지 방식입니다. 하나의 데이터 블록을 여러 드라이브에 나누어 저장하며, 개별 블록을 통째로 복제하지는 않습니다. 대신, 패리티(parity) 라고 불리는 특별한 블록을 추가로 생성하여 다른 드라이브에 분산 저장합니다.
만약 하나의 드라이브에 장애가 발생하면, 해당 드라이브에 있던 데이터 블록은 다른 드라이브에 있는 데이터와 패리티 블록을 이용해 복구할 수 있습니다. 이로 인해 단일 드라이브 장애 시에도 제로 다운타임(Zero downtime)이 보장되며, 읽기 성능도 빠른 편입니다.
RAID 5는 전체 디스크 용량 중 약 33% (3개 드라이브 기준)를 패리티 저장 공간으로 사용하므로, 데이터 보호를 유지하면서도 RAID 1과 비교해 더 높은 저장 효율을 제공합니다. 예를 들어, 3개의 1TB 드라이브로 RAID 5를 구성하면 총 3TB의 용량이 필요하지만, 실제 저장 가능한 데이터 용량은 2TB입니다. 이는 하나의 디스크 분량이 패리티 저장용으로 사용되기 때문입니다. 만약 1TB의 데이터를 저장하려면, 최소 1.5TB 이상의 총 디스크 용량이 필요하다는 뜻입니다.
일반적으로는 4개의 드라이브로 구성해 약 25%의 용량 손실로 운영하는 경우가 많습니다. 예를 들어, 4개의 1TB 드라이브를 RAID 5로 구성하면 총 4TB 용량 중 3TB만 사용할 수 있습니다. 하지만 데이터를 저장할 때마다 패리티를 계산해야 하므로 쓰기 성능은 다소 느려집니다. 또한 두 개 이상의 드라이브가 동시에 장애가 발생하면 데이터 복구가 불가능하다는 단점이 있습니다.
RAID 5는 최대 16개 드라이브까지 확장할 수 있으며, 디스크 수가 제한된 파일 서버나 애플리케이션 서버에 적합한 구성 방식입니다.
하나 예시를 들어보겠습니다.
4개의 디스크가 있다고 생각해봅시다. 각 디스크에는 데이터 조각과 함께 패리티라는 특별한 정보가 저장되어 있습니다. 패리티는 데이터를 복구하는 데 필요한 ‘체크포인트’ 같은 역할을 합니다. 예를 들어, 디스크 1에는 숫자 5, 디스크 2에는 숫자 7, 디스크 3에는 숫자 3이 저장되어 있다고 합시다. 디스크 4에는 이 숫자들을 XOR 연산한 결과인 패리티 값이 저장됩니다.
만약 디스크 2가 고장 나서 숫자 7을 잃어버렸다면, 나머지 숫자들과 패리티 값을 이용해 잃어버린 숫자 7을 다시 계산해 복구할 수 있습니다. 이처럼 RAID 5는 하나의 디스크가 고장 나도 데이터를 잃지 않고 복구할 수 있게 해주는 방식입니다.
RAID 6
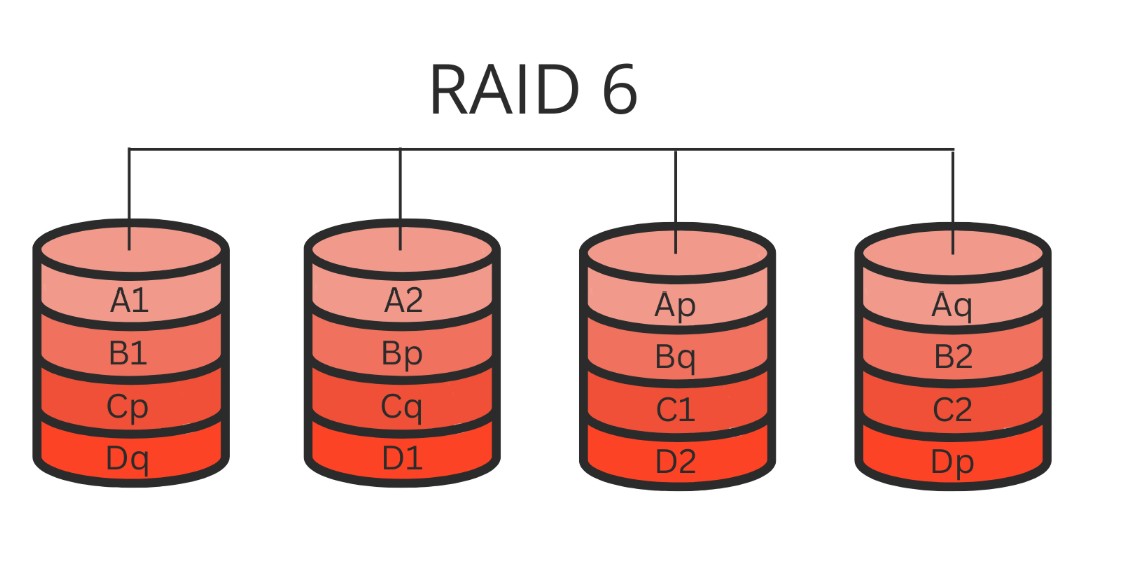
출처 : RAID 6 Image
RAID 6는 RAID 5와 매우 유사한 방식이지만, 패리티(parity) 블록이 두 개의 드라이브에 나누어 저장된다는 점이 가장 큰 차이점입니다. 또한, RAID 5에서 사용되는 XOR 연산 대신에 Reed-Solomon 부호라는 더 복잡한 방식으로 패리티를 생성합니다.
RAID 6는 최소 4개의 드라이브로 구성해야 하며, 동시에 두 개의 드라이브에 장애가 발생해도 데이터를 복구할 수 있다는 강력한 내결함성을 가지고 있습니다. 읽기 성능은 RAID 5와 비슷하지만, 패리티 블록이 하나 더 추가되기 때문에 쓰기 성능은 RAID 5보다 느린 편입니다. 이러한 특징 때문에 RAID 6는 읽기 위주의 트랜잭션이 많은 웹 서버에 적합하며, 쓰기 작업이 빈번한 무거운 데이터베이스에는 적합하지 않습니다.
💡 Reed-Solomon 부호란? 내부 구현은 아직 정확히 공부하지 않았지만, 데이터가 손상되거나 일부가 사라져도, 이 코드를 통해 원래 데이터를 복원할 수 있게 해주는 알고리즘입니다.
하나 예시를 들어보겠습니다.
4개의 디스크로 RAID 6를 구성했다고 가정해봅시다. 이때, 데이터 블록뿐 아니라 두 종류의 패리티 정보가 각각 다른 두 디스크에 나누어 저장됩니다. 예를 들어, 디스크 1과 디스크 2에는 데이터가 저장되어 있고, 디스크 3과 디스크 4에는 두 가지 다른 패리티 정보가 저장됩니다. 만약 디스크 2와 디스크 4가 동시에 고장 나더라도, 나머지 디스크에 저장된 데이터와 두 종류의 패리티 정보를 이용해 손실된 데이터를 모두 복구할 수 있습니다.
이처럼 RAID 6는 한 번에 두 개의 디스크 장애까지 견딜 수 있어, 더 높은 안정성이 필요한 환경에서 많이 사용됩니다.
RAID 10
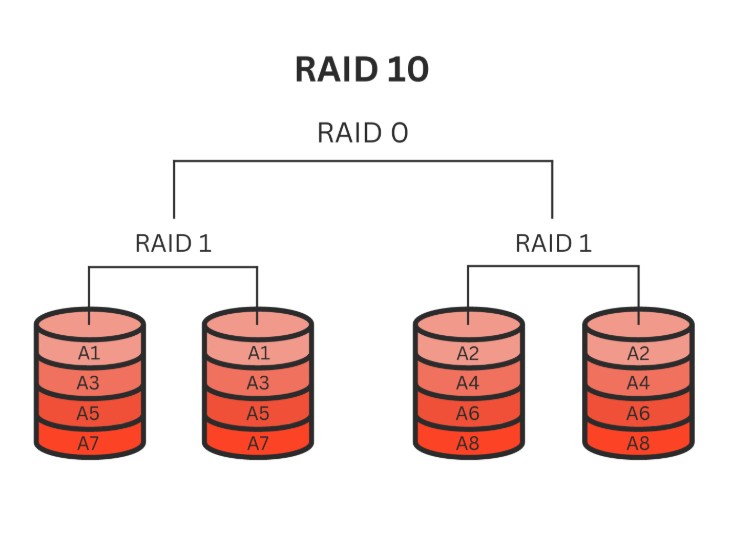
출처 : RAID 10 Image
RAID 10은 RAID 0과 RAID 1의 장점을 결합한 시스템입니다. ( 그래서 RAID 10 이 아니라, RAID 1 + 0 이라고 보는게 맞다 :D ) 모든 데이터 블록에 대해 복제본을 다른 드라이브에 유지하면서, 전체 데이터 블록을 서로 두 개 이상의 드라이브에 나누어 분배하는 방식입니다. 최소 4개의 드라이브가 필요합니다.
RAID 10은 RAID 0 수준의 빠른 속도와 RAID 1 수준의 높은 내결함성을 동시에 보장합니다. 하나의 드라이브에 장애가 발생해도 복제본이 유지된 다른 드라이브를 통해 데이터를 복구할 수 있습니다. 다만, 용량 측면에서는 RAID 1과 동일하게 50%만 활용할 수 있어, RAID 5나 RAID 6에 비해 저장 공간 효율성이 떨어지고 비용이 더 높다는 단점이 있습니다.
RAID 특징들을 간단히 표로 정리
| 특징 | RAID 0 | RAID 1 | RAID 5 | RAID 6 | RAID 10 |
|---|---|---|---|---|---|
| 최소 드라이브 수 | 2 | 2 | 3 | 4 | 4 |
| 내결함성 | 없음 | 단일 드라이브 장애 가능 | 단일 드라이브 장애 가능 | 두 개 드라이브 장애 가능 | 각 서브어레이별 1개 장애 가능 |
| 읽기 성능 | 높음 | 중간 | 낮음 | 낮음 | 높음 |
| 쓰기 성능 | 높음 | 중간 | 낮음 | 낮음 | 중간 |
| 용량 활용도 | 100% | 50% | 67% ~ 94% | 50% ~ 88% | 50% |
| 주요 사용처 | 고성능 워크스테이션, 실시간 데이터 처리 | 운영체제, 트랜잭션 데이터베이스 | 데이터 웨어하우스, 웹서버, 아카이빙 | 데이터 백업, 고가용성 서버 | 빠른 데이터베이스, 파일 서버, 애플리케이션 서버 |
내결함성과 성능을 모두 고려한다면 RAID 5, RAID 6, RAID 10 중에서 선택할 수 있습니다. 다만, RAID 10은 용량 손실이 크고 비용이 많이 들기 때문에, 현실적으로는 RAID 5를 가장 많이 선택하는 편입니다.
3.3. Hadoop's Eraser Coding
이제 하둡에서 Erasure Coding이 어떻게 이루어지는지 공부해보겠습니다. 기본적으로 하둡은 Replication을 위한 복제 데이터를 2개까지 복사해둡니다. 이는 장애 대응에 효과적이라는 장점이 있지만, Disk 활용 면에서는 최악이라고 할 수 있습니다. 왜냐하면, 클러스터 환경을 통틀어 1TB 정도 공간이 있다고 가정한다면, Replication을 위한 복제본까지 담기 위해, 실제 데이터는 333.33GB밖에 담지 못하게 되기 때문입니다.
이러한 문제를 해결하기 위해 Hadoop V3부터는 Erasure Coding 방법을 기용하였습니다. RAID는 하드웨어 방식과 소프트웨어 방식으로 나뉘는데, 하드웨어 RAID는 별도의 RAID 컨트롤러 카드를 통해 구현됩니다. 이 컨트롤러가 패리티 계산이나 읽기·쓰기 작업을 전담하기 때문에 시스템의 CPU에 부담을 주지 않고 빠른 성능을 제공하는 장점이 있습니다. 하지만 컨트롤러 카드 자체가 고가라는 단점이 있습니다.
반면 소프트웨어 RAID는 기존 컴퓨터의 구조를 그대로 사용하면서 디스크만 추가하면 별도의 하드웨어 없이도 RAID를 구현할 수 있어 비용을 절감할 수 있습니다. 하지만 모든 작업이 CPU 리소스를 공유하기 때문에 다른 작업들과 리소스를 나누게 되어 전반적인 처리 속도가 느려질 수 있습니다.
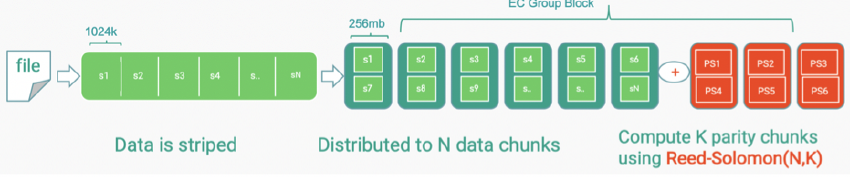
💡 중요 💡 N : 몇개의 chunk 로 나눌지 K : 몇개의 parity 로 구성할지 RS(N,K) 로 표현함.
Hadoop의 Erasure Coding은 RAID 방식을 소프트웨어로 구현한 기술입니다. RAID 5나 RAID 6처럼 패리티를 이용해 데이터를 복구하는 방식이지만, 패리티를 계산하는 방식에서 차이를 보입니다. 데이터를 여러 개의 조각으로 나누고, Reed-Solomon과 같은 알고리즘을 사용해 패리티 데이터를 생성합니다. 이 방식은 데이터 보호 수준을 유연하게 설정할 수 있다는 점에서 기존 RAID와 차별화됩니다. 예를 들어, n개의 블록으로 데이터를 분할하고, 여기에 대해 k개의 패리티 블록을 추가하면, 총 n+k개의 블록 중 최대 k개의 블록이 손실되더라도 n개의 데이터 블록이 남아있다면 원본 데이터를 복구할 수 있습니다. 이러한 구조는 일반적으로 RS(n, k) 형태로 표현됩니다.
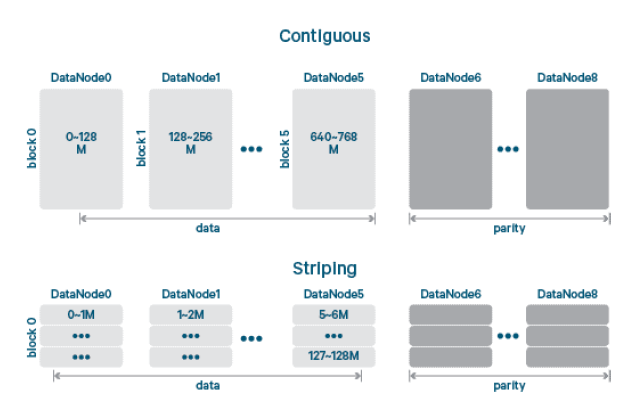
위 그림은 Hadoop에서 Erasure Coding 이 적용되기 전과 후의 블록 구조 차이를 보여줍니다. 즉, 하나의 논리적 블록(Logical Block)을 기반으로 패리티(parity)를 구성하는 방식의 변화를 설명한 것입니다. 참고로 논리적 블록 크기 자체는 Erasure Coding 가 적용되더라도 바뀌지 않습니다.
먼저, Contiguous Block 구조는 하나의 논리 블록이 하나의 물리 블록(Storage Block)에 그대로 저장되는 방식입니다. 이 구조에서는 하나의 파일을 순차적으로 읽을 수 있고, 구현이 간단하다는 장점이 있습니다. 만약 Erasure Coding 을 적용해야 한다면 데이터를 조각내어 여러 디스크에 분산시켜야 하므로, 이렇게 단일 블록에 저장하는 구조에서는 병렬 처리나 패리티 분산 저장이 어렵습니다. 단일 블록 단위로만 처리되기 때문에 또한 병렬 처리나 IO 분산이 불가능합니다.
반면, Striped Block 구조는 하나의 논리 블록을 더 작은 단위인 셀(cell)로 쪼갠 다음, 이 셀들을 stripe(여러 셀로 구성된 집합)로 구성해, 여러 개의 스토리지 블록 세트에 라운드로빈 방식으로 나눠 저장합니다. 쉽게 말하면, 데이터를 얇게 썰어서 여러 디스크에 고르게 분산시켜 저장하는 것입니다.
읽을 때도 마찬가지로, 하나의 논리 블록을 구성하는 여러 셀을 병렬로 동시에 읽을 수 있기 때문에, 읽기 속도(read performance)가 기존 구조보다 더 빨라질 수 있습니다.
이러한 방식 덕분에 단일 블록에 대해서도 병렬 처리가 가능해지므로, 성능 향상이라는 측면에서도 효과가 큽니다.
Erasure Coding 의 장점
Erasure Coding의 가장 큰 장점은 데이터 복구 능력을 유지하면서도 저장 공간을 훨씬 더 효율적으로 사용할 수 있다는 점입니다. 기존의 Hadoop은 장애 대비를 위해 하나의 블록을 3개까지 복제(3-way replication) 하다 보니, 전체 저장 공간의 2/3가 복제본 저장에 소모되는 비효율이 있었습니다.
하지만 EC를 도입하면, 예를 들어 RS(6,3)처럼 6개의 데이터 블록과 3개의 패리티 블록을 사용해 총 9개의 블록을 구성하게 됩니다.
이 경우 3개의 블록이 손상되더라도 나머지 블록으로 원래 데이터를 복원할 수 있고,
전체 저장 공간의 활용률도 훨씬 높아지게 됩니다.
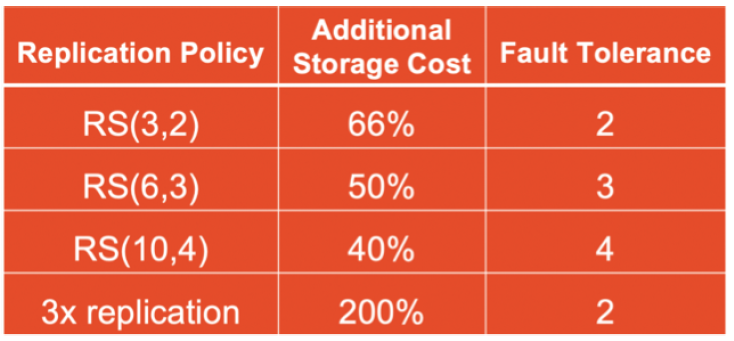
해당 이미지를 보면 알 수 있듯, RS(10, 4) 로 구현하면, 스토리지의 40%만을 복원을 위해 쓰게 되지만, 기존 방식대로 하게 된다면 200%를 복원을 위해 사용하게 됩니다. 이러한 차이를 극명하게 볼 수 있는 표라고 할 수 있습니다.
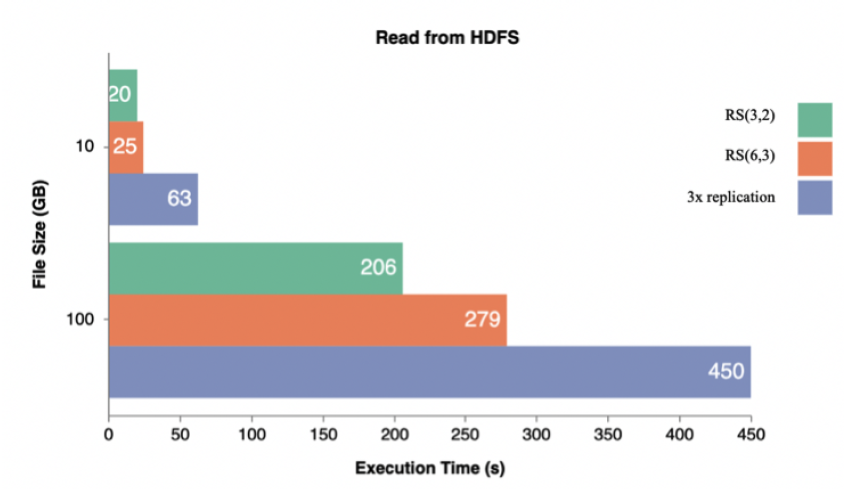
또한 앞서 설명한 Striped Block 구조 덕분에 병렬 처리가 가능해지므로, 파일을 읽는 성능이 기존보다 더 개선되는 결과도 함께 얻을 수 있습니다.
해당 이미지는 다른 개발자가 직접 테스트한 성능 지표 참고자료입니다.
Erasure Coding 의 단점
물론 단점도 존재합니다. RAID에서와 마찬가지로, 단순 복제 방식에 비해 Erasure Coding 은 더 많은 계산이 필요합니다.
데이터를 저장할 때는 패리티를 계산하는 인코딩(encoding) 작업이 필요하고, 손상된 데이터를 복구할 때는 디코딩(decoding) 작업이 필요하기 때문에, 특히 쓰기 성능(write performance) 면에서는 기존보다 느려질 수 있습니다.
하지만 이 단점도 완전히 해결 불가능한 것은 아닙니다. Intel에서 제공하는 ISA-L encoder 라이브러리 덕분에, 패리티 계산 속도가 개선되어 성능 저하를 어느 정도 줄일 수 있었습니다. 실제로 측정해보면, 쓰기 성능은 약 30% 정도만 감소하는 것으로 나타났습니다.
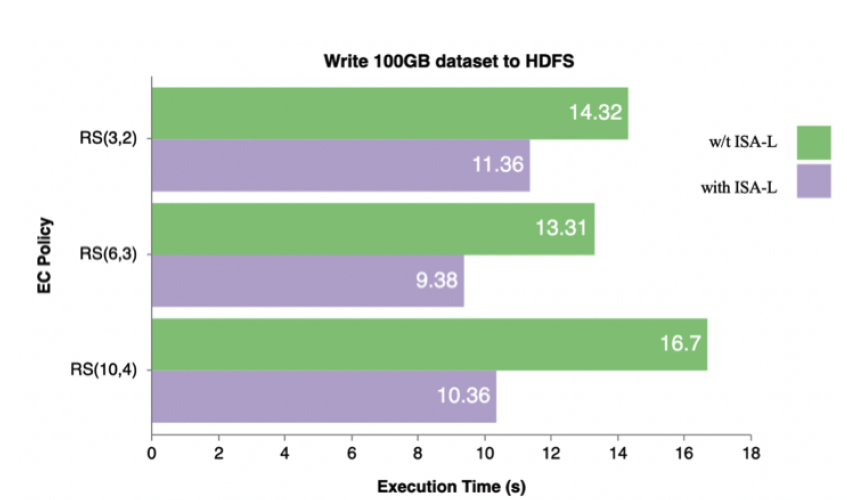
해당 성능 지표를 보면 알 수 있듯 ISA-L(인텔의 인코딩/디코딩 라이브러리) 사용 시 쓰기 성능이 크게 개선됩니다. 패리티가 많아질수록 인코딩 부담이 커져 기본적으로 쓰기 시간이 늘어나지만, ISA-L 덕분에 이를 상당 부분 줄일 수 있습니다. 따라서, 하둡에서 Erasure Coding을 쓸 때 ISA-L 같은 하드웨어 최적화 라이브러리가 성능 병목을 완화하는 데 매우 중요합니다.
3.4. FIFO Queue vs Fair Call Queue
Hadoop과 같은 분산 시스템에서는 여러 클라이언트가 동시에 서버(NameNode, DataNode 등)에 요청을 보냅니다. 이러한 요청들은 곧바로 처리될 수 없고, 잠시 저장해두었다가 순차적으로 처리해야 하는 상황이 자주 발생합니다.
이를 위해 사용하는 구조가 바로 Call Queue (요청 큐) 입니다.
💡 요청 큐는 클라이언트로부터 들어온 작업 요청을 임시로 보관하고, 서버의 가용한 리소스에 맞춰 하나씩 꺼내 처리하기 위한 대기열 구조입니다.
FIFO Queue란?
출처 : FIFO Queue
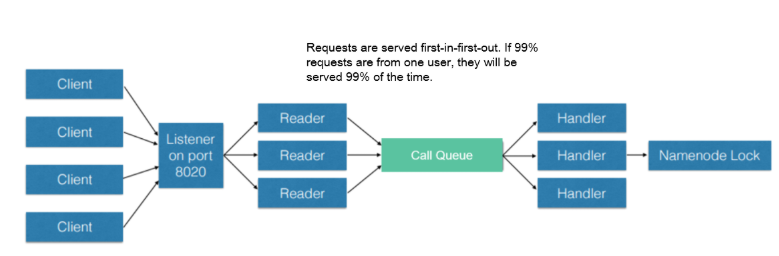
FIFO (First-In-First-Out) Queue는 먼저 들어온 요청을 먼저 처리하는 방식의 큐(queue)입니다. Hadoop에서 Fair Call Queue가 도입되기 전까지는 클라이언트의 모든 요청을 이 단일 FIFO 큐에 저장한 뒤, 요청 도착 순서대로 처리하는 구조가 사용되었습니다.
설정은 core-site.xml 에서 할 수 있으며 다음과 같습니다. ( * 설정이 없을 경우 기본으로는 FIFO Queue 를 활용합니다. )
<property>
  <name>ipc.server.callqueue.class</name>
  <value>org.apache.hadoop.ipc.FifoCallQueue</value>
  <description>RPC 요청 처리 시 FIFO Queue를 사용하도록 설정</description>
</property>
클라이언트로부터 작업 요청이 도착하면, Reader Thread가 이 요청을 하나의 FIFO 큐에 저장합니다. Handler가 작업을 수행할 준비가 되면, 이 큐에서 맨 앞에 있는 요청을 하나씩 꺼내어 처리합니다.
작업의 예시로는 정보 조회나, 생성, append 작업, 파일리스트 조회(대규모의 경우 병목 발생), 변경 등이 있습니다. 이는 애플리케이션을 통한 작업이든, hdfs dfs 명령어를 통한 작업이든 동일합니다.
이러한 방식은 단순하고 구현이 쉬우며, 요청 순서를 그대로 유지할 수 있다는 장점이 있습니다. 하지만, 분산 시스템 환경에서는 심각한 단점을 가지고 있어, 결과적으로 공정성과 성능 문제가 발생했습니다.
FIFO Queue 의 단점
FIFO 구조의 가장 큰 문제는, 특정 클라이언트가 다량의 요청... 혹은 무거운 요청을 전송할 경우 큐를 사실상 점령하게 된다는 것입니다. 이러한 heavy user로 인해 다른 사용자들의 요청은 뒤로 밀려, 전체 시스템의 응답 시간이 심각하게 지연됩니다.
⛔️ 예 : 하나의 유저가 수천 개의 요청을 보낼 경우, 다른 모든 유저의 요청은 해당 요청 뒤에 대기하게 되어 수백 ms 이상의 지연 발생
또한, Hadoop의 NameNode는 파일 시스템 메타데이터를 관리하는 핵심 구성요소로, 클러스터의 모든 read, write, create, delete 요청이 이 노드를 거칩니다. 그런데 이러한 FIFO Queue 를 사용하게 되면, 요청들을 병렬로 처리할 수 없고, 모든 요청이 하나의 줄에서 순차적으로 처리되기 때문에 병목이 매우 심각하게 발생합니다. 실제로 과거 하둡을 운영하는 업체들은 수많은 클러스터에서 수 ms~수백 ms 단위의 응답 지연이 빈번히 발생했으며, 이는 전체 시스템의 성능 저하로 이어졌습니다.
그럴경우 과거에는 큐를 독점한 사용자 요청을 강제로 종료(kill) 하는 방식으로 문제를 해결하려 했습니다. 하지만, 그렇게 kill 을 해버리면, 이미 처리 중이던 요청을 강제로 종료하면서 데이터 무결성 손상이 생기거나, 종료 도중 오류 발생 시 재시도 실패, 그리고 심한 경우 클러스터 전체가 수 시간 동안 멈추는 상황까지 발생하였습니다.
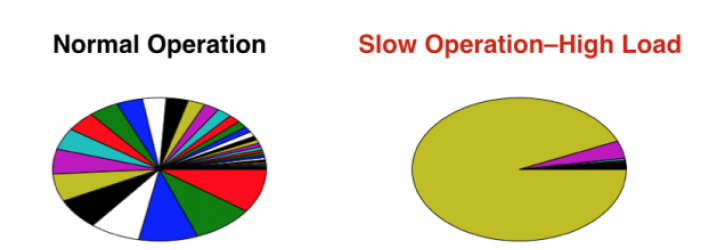
그리고 가장 큰 문제는 대량 요청이 사용자의 잘못된 MapReduce 작업에 의해 자주 발생했다는 점입니다. 의도하지 않았더라도, 이러한 작업은 위 그림처럼 과도한 요청을 발생시켜 시스템 전체에 부하를 유발합니다.
더 나아가, 의도적으로 이러한 작업을 수행할 경우 DDoS 공격처럼 시스템을 마비시키는 악의적인 행위도 가능해집니다. 따라서, 단순한 FIFO 처리 방식은 공정성 결여뿐만 아니라, 보안 측면에서도 취약하다는 문제가 있습니다.
💡 DDos 란? : 분산 서비스 거부 공격으로, 여러 대의 컴퓨터(분산된 여러 공격자)가 동시에 특정 서버나 네트워크에 대량의 요청을 보내서 정상적인 서비스가 정상적으로 작동하지 못하도록 방해하는 공격입니다.
Fair Call Queue 란?
출처 : Fair Call Queue
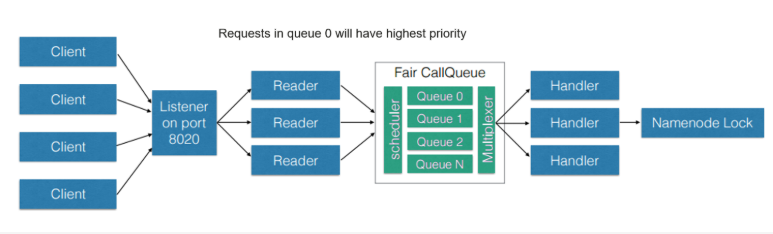
Hadoop에서 기존의 FIFO Queue가 가진 한계를 극복하기 위해, 라우터에서 사용하는 QoS(Quality of Service) 기능에서 영감을 받아 FIFO Queue를 Fair Call Queue로 교체하였습니다. QoS는 네트워크 장비에서 트래픽을 관리해 각 서비스가 적절한 품질을 유지하도록 보장하는 기술입니다. 이를 Hadoop의 요청 처리에 적용하여, 클라이언트별 요청이 공정하게 처리되고, 특정 클라이언트의 과도한 요청으로 인해 전체 서비스가 지연되는 문제를 해결하고자 하였습니다.
설정은 core-site.xml 에서 다음과 같이 할 수 있습니다.
<property>
  <name>ipc.server.callqueue.class</name>
  <value>org.apache.hadoop.ipc.FairCallQueue</value>
  <description>RPC 요청 처리 시 Fair Call Queue를 사용하도록 설정</description>
</property>
Fair Call Queue는 크게 scheduler, multiplexer , 그리고 multi-level queue 이렇게 세 가지 구성 요소로 이루어져 있습니다.
-
RPC Scheduler 각 클라이언트별 큐에 담긴 요청들을 적절한 비율로 선택하여 처리하는 역할을 합니다. 클라이언트 간 공정성을 보장하고, 자원을 효율적으로 분배하여 응답 지연을 최소화합니다.
-
Multi-level Queue 각 클라이언트별로 분리된 요청들이 들어가는 여러 개의 큐로, 클라이언트마다 독립적인 대기열을 가집니다. 이렇게 분리함으로써, 한 클라이언트의 요청이 다른 클라이언트의 요청 처리에 영향을 주지 않도록 합니다. 총 4단계의 큐로 구성되었습니다. (priority 0 ~ 3)
-
RPC Multiplexer 여러 클라이언트로부터 들어오는 요청들을 받아 각각의 클라이언트별 큐로 분배하는 역할을 합니다. 즉, 요청을 한 곳에 몰아두지 않고 각 사용자별로 요청을 분리하여 관리합니다.
이러한 구조 덕분에 Fair Call Queue는 특정 사용자의 과도한 요청이 전체 시스템 성능 저하를 초래하는 문제를 효과적으로 완화하며, Hadoop 클러스터의 안정성과 응답성을 높였습니다.
Fair Call Queue - RPC Scheduler
클라이언트의 RPC 요청이 Listen Queue에 도착하면, 여러 개의 Reader Thread가 요청을 RpcScheduler에 전달합니다. RpcScheduler는 요청을 여러 개의 Priority Queue로 분리하여 저장합니다. 각 요청은 우선순위(priority)를 계산한 뒤, 해당 Priority Queue에 할당됩니다. RPC Scheduler는 pluggable 구조로 되어 있어, 다양한 구현체를 선택할 수 있습니다.
RPC Scheduler 의 기본 구현체는 DecayRpcScheduler입니다. ( 깃허브 코드 ) DecayRpcScheduler는 각 사 사용자마다 얼마나 많은 요청을 보내는지를 추적하고, 이 정보를 기준으로 우선순위를 부여합니다. 다만, 오래 전에 보낸 요청은 중요도를 줄이기 위해 시간에 따라 수치를 감소시키는(decay) 방식으로 처리합니다.
동작 과정을 풀어서 설명해보겠습니다. 먼저 사용자가 RPC 요청을 보낼 때마다, 그 사용자에 대한 요청 횟수(count)를 기록합니다. 그 후 5초마다(sweep period) 모든 사용자에 대해 요청 수를 다시 계산합니다. 이 때 순히 요청 수를 더하는 것이 아니라, 기존 요청 수에 Decay Factor를 곱합니다. 예를 들면, 기존 요청 수가 10이고 decay factor가 0.5라면 10 × 0.5 를 해서 5 가 됩니다.
위에서 Decay 된 값에 이번 sweep 주기 동안 새롭게 들어온 요청 수를 더합니다. Decay 된 값이 5이고, 새 요청이 4건이면 5 + 4 해서 9 가 됩니다. 그리고 모든 사용자의 decay된 요청 수를 합산하여 전체 요청량을 구합니다. 그 중 각 사용자가 차지하는 비율에 따라 우선순위(priority)를 부여합니다.
계산된 우선순위는 캐시에 저장되어 다음 sweep 때까지 유지되며, 요청이 들어올 때는 이 priority를 기준으로 적절한 priority queue에 분류됩니다. 만약 새 사용자가 등장하여 요청을 보낸다면, 이전 캐시가 없기 때문에 on-the-fly로 우선순위를 계산합니다. 이때도 전체 요청 대비 비율을 따져서 임시로 priority가 부여됩니다.
다음은 예시를 보겠습니다. Sweep 주기는 5초, Decay Factor 는 0.5로 잡은 상태에서 3명의 User 클라이언트로부터 요청이 들어오는 상황입니다.
📌 요청 수 변화 및 우선순위 계산 예시
| 시간(초) | 사용자 | 이전 요청 수 | Decay 적용 후 | 새 요청 수 | 현재 요청 수 (Decay + 새 요청) | 전체 합 | 전체 대비 비율 | Priority |
|---|---|---|---|---|---|---|---|---|
| 0 | userA | 0 | - | 10 | 10 | 24 | 41.7% | 2 |
| 0 | userB | 0 | - | 8 | 8 | 33.3% | 2 | |
| 0 | userC | 0 | - | 6 | 6 | 25.0% | 1 | |
| 5 | userA | 10 | 5 | 4 | 9 | 18.75 | 48.0% | 2 |
| 5 | userB | 8 | 4 | 2 | 6 | 32.0% | 2 | |
| 5 | userC | 6 | 3 | 0.75 | 3.75 | 20.0% | 1 | |
| 10 | userA | 9 | 4.5 | 0 | 4.5 | 10.125 | 44.4% | 2 |
| 10 | userB | 6 | 3 | 0 | 3 | 29.6% | 2 | |
| 10 | userC | 3.75 | 1.875 | 0.75 | 2.625 | 25.9% | 1 |
📌 우선순위 기준 (기본 설정)
| 전체 점유율 기준 | Priority | 설명 |
|---|---|---|
| ≥ 50% | 3 | 최하 우선순위 |
| 25% ~ 50% | 2 | 중간 사용자 |
| 12.5% ~ 25% | 1 | 일반 사용자 |
| < 12.5% | 0 | 최상 우선순위 |
참고로 Sweep 주기와 Decay Factor 는 core-site.xml 에서 설정해줄 수 있습니다.
<property>
  <name>ipc.server.callqueue.sweep.period.ms</name>
  <value>5000</value>
  <description>Sweep 주기를 밀리초 단위로 설정 (기본 5초)</description>
</property>
<property>
  <name>ipc.server.callqueue.decay.factor</name>
  <value>0.5</value>
  <description>Decay Factor 값을 설정 (기본 0.5)</description>
</property>
Fair Call Queue - Multi-level Queue
Multi-level Queue는 요청(Call)을 우선순위나 중요도에 따라 여러 개의 레벨(계층) 큐로 나누어 관리하는 큐 구조입니다. 높은 우선순위 큐의 요청이 먼저 처리되고, 만약 해당 큐에 요청이 없으면 낮은 우선순위 큐의 요청을 처리합니다.
Fair Call Queue - RPC Multiplexer
RPC Multiplexer 는 여러 우선순위 큐에서 요청을 효율적으로 처리하기 위한 컴포넌트입니다. 여러 우선순위 큐(예 : high-priority, low-priority)를 비교하여 요청을 선택합니다. 이 때 높은 우선순위 큐를 더 자주 처리하여 중요한 요청을 우선적으로 처리합니다. 동시에, 낮은 우선순위 큐도 일정 비율로 처리하여 starvation(처리 지연)을 방지합니다.
Multiplexer 는 현재 구현체로 WeightedRoundRobinMultiplexer가 하드코딩되어 있습니다. ( 깃허브 코드 ) WeightedRoundRobinMultiplexer 는 각 우선순위 큐별로 가중치(weight)를 부여하고, 그 비율에 따라 요청을 처리합니다.
기본 가중치는 다음과 같습니다
| 우선순위 레벨 | 가중치 (Weight) | 처리 방식 |
|---|---|---|
| Highest priority (0) | 8 | 큐에서 8개의 요청을 연속으로 꺼내서 처리 |
| 2nd highest priority (1) | 4 | 큐에서 4개의 요청을 꺼내서 처리 |
| 3rd highest priority (2) | 2 | 큐에서 2개의 요청을 꺼내서 처리 |
| Lowest priority (3) | 1 | 큐에서 1개의 요청을 꺼내서 처리 |
이 방식으로 높은 우선순위 큐에서 더 많은 요청을 먼저 처리하지만, 낮은 우선순위 큐도 적절히 처리하여 처리 지연 현상(starvation)을 방지 합니다. 이러한 흐름을 간단히 정리하면, Fair Call Queue 가 도입되면 RPC Scheduler 가 Decay Factor 로 우선순위를 나누어 총 4개의 Multi-level Queue 에 작업을 넣어줍니다. 그리고 RPC Multiplexer 가 그 큐에서 우선순위에 따라 가중치를 부여해, 적정 수의 작업을 꺼내 처리할 수 있게 합니다.
Fair Call Queue - Backoff
Backoff는 priority-weighting 메커니즘에 추가로 동작하는 기능입니다. BackOff 는 요청을 즉시 처리하지 않고 클라이언트에게 예외(Exception)를 던지는 방식입니다. 전형적으로 request queue가 가득 찼을 때 발생합니다.
또한, backkoff by response time 기능을 제공하기도 한느데 이는 높은 우선순위 큐의 요청 처리가 너무 느려질 경우, 낮은 우선순위 큐의 요청을 backoff 합니다. 예를 들어, priority 1의 response time threshold가 10초로 설정되어 있는데, 해당 큐의 평균 응답 시간이 12초라면, priority 2 이하의 요청은 backoff exception을 받습니다. 반면에 priority 0과 1의 요청은 정상 처리됩니다.
이 방식은 시스템에 부하가 높아져 높은 우선순위 사용자까지 영향받을 때, heavy user에게 backoff를 강제하는 효과가 있습니다. 따라서 Hadoop Client를 사용하는 어플리케이션 개발자는 backoff에 의한 예외가 자주 발생한다면, 자신의 요청이 시스템에 과도한 부하를 주고 있지 않은지 점검할 필요가 있습니다.
<!-- Backoff 기능 활성화 -->
<property>
  <name>ipc.decay.scheduler.enable.backoff</name>
  <value>true</value>
</property>

<!-- 응답시간 기반 Backoff 기준 활성화 -->
<property>
  <name>ipc.decay.scheduler.enable.response.time.backoff</name>
  <value>true</value>
</property>

<!-- Priority 1의 응답시간 Backoff 기준 (초 단위) -->
<property>
  <name>ipc.decay.scheduler.response.time.threshold.priority.1</name>
  <value>10</value>
</property>
Fair Call Queue - Identity Provider
위에서 설명한 RPC Scheduler 는 사용자 단위로 요청 수, 우선순위, decay, backoff 등을 관리합니다. 때 "사용자"를 어떻게 정의할지 정하는 것이 바로 IdentityProvider입니다. 예를 들어, userA, userB의 요청을 분리하고 싶다면 user.name 기준으로 식별해야 합니다. 반면 동일 사용자가 다양한 서비스나 IP에서 오는 요청을 분리하고 싶을 수도 있습니다.
기본은 UserIdentityProvider로, 단순히 client의 username 으로 구분합니다.
Cost based Fair Call Queue ?
Fair Call Queue는 사용자 간의 요청 수를 기준으로 priority 처리를 시도합니다. 하지만, 요청이 얼마나 비싼 작업인지에 대한 고려는 부족합니다. 결과적으로, 요청 수는 같지만 시스템 자원을 과도하게 사용하는 사용자가 공정성을 해칠 수 있습니다.
예를 들어, 다음 3가지 요청을 생각해봅시다. getFileInfo 요청 1000개와, listStatus 요청 1000개 (큰 디렉토리 대상), 그리고 mkdir 요청 1000개 가 있습니다. getFileInfo, listStatus는 단순 조회라서 가볍습니다. 반면, mkdir은 파일시스템에 직접 변경을 가하고, exclusive lock이 필요해서 훨씬 무겁습니다.
하지만 Fair Call Queue는 단순히 "1000번 요청"만 보니, 이 차이를 구분 못합니다. 하둡은 이 문제를 해결하기 위해, 요청 하나하나가 시스템 자원을 얼마나 사용하는지를 계산해서 우선순위에 반영하는 Cost-based Fair Call Queue 기능을 도입했습니다. 즉, 요청 수가 아니라 요청을 처리하는 데 걸린 시간을 기준으로 판단합니다. 무거운 요청을 자주 보내는 사용자는 자동으로 낮은 우선순위를 받는다고 볼 수 있습니다.
Cost based Fair Call Queue 는 요청 처리에 걸린 실제 시간 + 사용된 lock의 종류에 따라 가중치를 부여합니다.
-
단순 작업 : lock 없이 실행된 시간 → 그대로 반영 (×1)
-
공유 락(shared lock)이 걸린 작업 : ×10 가중치
-
배타 락(exclusive lock)이 걸린 작업 : ×100 가중치
단, 요청을 기다리는 시간(queue 대기)이나 락을 얻기까지 걸리는 시간은 계산에 포함되지 않습니다. 저도 이 부분을 공부할 때 이해가 좀 되지 않아서, 표로 정리해보았습니다. 먼저, 3명의 사용자가 각기 다른 요청을 한 경우 아래 표와 같이 됩니다.
| 사용자 | 요청 종류 | 실행 시간(ms) | Lock 종류 | 가중치 | Cost 계산 (시간 × 가중치) |
|---|---|---|---|---|---|
| userA | getFileInfo | 10 | 없음 | ×1 | 10 |
| userB | listStatus | 20 | Shared Lock | ×10 | 200 |
| userC | mkdir | 15 | Exclusive Lock | ×100 | 1500 |
그러면, 다음 표처럼 우선순위를 계산합니다. (비중 기준)
| 사용자 | Cost | 전체 비중 (%) | 우선순위 (기본 기준) |
|---|---|---|---|
| userA | 10 | 0.58% | 0 (최상위) |
| userB | 200 | 11.7% | 0 (최상위) |
| userC | 1500 | 87.7% | 3 (최하위) |
그러면, 요청 반복 시 누적 Cost 변화가 일어납니다. (이 때, Decay 는 고려하지 않습니다.)
| 사용자 | 요청 1회당 Cost | 요청 횟수 | 누적 Cost |
|---|---|---|---|
| userA | 10 | 2회 | 20 |
| userB | 200 | 2회 | 400 |
| userC | 1500 | 2회 | 3000 |
최종적으로는 아래 표와 같이 됩니다.
| 사용자 | 전체 비중 (%) | 우선순위 |
|---|---|---|
| userA | 0.58% | 0 |
| userB | 11.7% | 0 |
| userC | 87.7% | 3 |
설정은 core-site.xml 에서 가능합니다. 이 설정을 추가하면 Fair Call Queue가 요청의 실제 비용까지 고려해서 사용자 우선순위를 조정할 수 있습니다.
<property>
  <name>ipc.costprovider.class</name>
  <value>org.apache.hadoop.ipc.WeightedTimeCostProvider</value>
</property>
이러한 방법을 통해, FIFO Queue 의 단점을 보완하고, 무엇보다 DoS 공격에 대해서 일정 수준 이하의 낮은 latency를 보장할 수 있게 되었습니다.
결론
이번 포스팅에서는 하둡의 핵심 이론들을 알아보았습니다. HDFS 의 아키텍처부터 시작해서 HA 구성, ONN 그리고 EC 와 Fair Call Queue 까지... 회사에서 단순히 하둡을 다루는 거 만으로는 알 수 없었던 방대한 지식들을 공부 할 수 있었습니다.
하둡은 단순한 분산 파일 시스템 이상의 의미를 지닙니다. 수많은 요청과 데이터가 오가는 대규모 환경에서 어떻게 안정성과 성능을 유지하는지, 어떤 원리와 기법들이 그 바탕에 있는지를 알게 되면, 비로소 하둡을 ‘잘 다룬다’는 말이 어떤 의미인지 깊이 공감할 수 있습니다. 이번 학습을 통해 알게 된 여러 메커니즘들은 단순히 기술적인 지식에 머무르지 않고, 실제 현장에서 마주하는 문제들을 해결하는 강력한 무기가 되어줄 것입니다.
앞으로도 하둡과 같은 대규모 시스템을 다루면서, 이론과 실무의 간극을 줄이고, 지속적으로 성장해 나가야겠다는 다짐을 하게 되었습니다. 이 글을 읽은 사람도 하둡을 한층 더 깊이 이해하고, 복잡한 시스템 속에서 자기만의 통찰을 얻어갔으면 좋겠습니다. 그럼 다음 포스팅에서는 YARN 을 공부하고 정리해보겠습니다.
공부 참고 자료
📑 1. HDFS NameNode RPC QoS 최적화
📑 3. 하둡 3.0에선 무엇이 달라졌을까? ( Erasure Coding 을 이해하기 좋은 글 )