
Map Reduce 기본 이론과 실습

저번 포스팅에서는, YARN 에 대하여 공부하였습니다. 이번에는 하둡의 핵심 요소 중 하나인 Map Reduce 에 대하여 공부한 내용을 포스팅하겠습니다.
📘 분산 시스템의 이해와 하둡의 등장 배경 📘 하둡의 핵심 구성요소와 이론 📘 YARN(Yet Another Resource Negotiator) 기본 이론%20%EA%B8%B0%EB%B3%B8%20%EC%9D%B4%EB%A1%A0.html)
1. Map Reduce
MapReduce는 대용량 데이터를 분산 환경에서 효율적으로 처리하기 위한 병렬 처리 프로그래밍 모델이자 프레임워크입니다. 이 모델은 원래 2004년 구글에서 발표되었으며, Apache Hadoop은 이를 오픈소스 프레임워크로 구현하였습니다. Hadoop의 MapReduce는 특히 HDFS와 함께 사용되어, 수백 GB에서 수 PB 규모의 데이터를 여러 대의 컴퓨터에 나눠 처리할 수 있도록 설계되었습니다.
MapReduce는 데이터를 Key-Value 형태로 가공하며, 처리 과정은 크게 Map 단계와 Reduce 단계로 나뉩니다. Map 단계에서는 데이터를 분할하고 병렬로 처리하며, Reduce 단계에서는 그 결과를 수집하고 통합합니다.
이 구조 덕분에 개발자는 Map과 Reduce 함수만 정의하면 되고, 나머지 작업(Job 분할, Task 배정, 장애 복구 등)은 Hadoop이 자동으로 처리합니다. 또한 Java를 기본으로 하지만, C++, Python 등 다양한 언어도 지원됩니다 (예 : Hadoop Streaming 사용 시). 따라서 개발자는 인프라 걱정 없이 비즈니스 로직 구현에 집중할 수 있습니다.
2. MapReduce 알고리즘과 구동방식
MapReduce는 크게 두 가지 함수로 구성되어 있습니다.
-
📌 Map Function 입력 데이터를
(key1, value1)형태로 받아, 이를(key2, value2)형태의 중간 결과로 변환합니다.ex :
(key1, value1) → (key2, value2) -
📌 Reduce Function Map 단계에서 생성된 중간 결과들을 key 기준으로 그룹화한 뒤, 같은 key를 갖는 값들의 리스트를 받아 최종 결과
(key3, value3)을 생성합니다.ex :
(key2, List<value2>) → (key3, value3)
이러한 두 단계를 통해 데이터는 분산 환경에서 병렬로 처리되며, 최종적으로 집계 및 가공된 결과를 얻게 됩니다. 또한 MapReduce 의 구동 방식은 크게 세 가지입니다.
-
🔹 Local 단일 JVM 에서 전체 Job 을 실행하는 방식으로, 테스트 용도 정도로만 쓰이지 실제로는 이러한 방식으로 운영하지 않습니다.
-
🔹 Classic Hadoop 1.0 버전때까지 유지하던 Map Reduce 분산 처리 방식이며, 1개의 Job Tracker 와 여러개의 Task Tracker 를 사용하는 초기 Map Reduce 방식입니다.
-
🔹 YARN Hadoop 2.0 YARN 도움 이후의 Map Reduce 방식입니다. Map Reduce 이외의 워크로드도 수용이 가능한 버전입니다.
이러한 Map Reduce 는, 단순하고 사용이 편리하며, 특정 데이터 모델이나 스키마에 의존적이지 않은 유연성을 가지고 있고, 저장 구조도 독립적입니다. 또한 데이터 복제에 기반한 내구성과 자체 재시도 로직을 통한 내고장성도 확보하고 있으며, 하둡을 활용한 높은 확장성을 가지고 있다는 장점이 있습니다. 그러나, 고정된 단일 데이터 흐름을 가지고 있고, Hive 등이 있지만 여전히 DBMS 보다는 불편한 스키마 질의, 그리고 작업 데이터를 처리하기에 적합하지 않고, 기술 지원이 어렵다는 단점등을 가지고 있습니다.
그럼 지금부터, MapReduce 에 대해 좀 더 자세히 공부한 내용을 정리해보겠습니다.
3. Map Reduce 1.0 & 기본
파트를 1.0 과 2.0 으로 나누기는 하였지만, Map Reduce 1.0 과 2.0 이 크게 차이가 있지는 않습니다.
어느정도 단점을 보완해주고, YARN 을 통해 구동하는가 안하는거 정도라고 할 수 있습니다. 그래서 현재 1.2 파트에서는 1.0과 현재 Map Reduce 의 기본이 되는 부분을 공부하고 정리하였습니다. 다음 파트인 MapReduce 2.0 에서는 변동사항만 정리할 예정입니다.
3.1. Hadoop 1.x에서의 MapReduce 구성 요소
Hadoop 1.x에서는 클래식 MapReduce 모델을 사용하며, 다음과 같은 주요 컴포넌트로 구성됩니다.
-
JobTracker (1개) : 클러스터 전체에서 Job의 실행을 총괄하는 마스터 역할을 합니다. 클라이언트로부터 Job을 받아 Task로 나누고, 적절한 TaskTracker에게 분배합니다.
-
TaskTracker (여러 개) : 각각의 노드에 존재하며, JobTracker로부터 Task를 할당받아 실제로 Map 또는 Reduce 작업을 수행합니다.
-
Client : 사용자가 직접 작성한 MapReduce Job을 hadoop jar 명령어로 실행하면, 이 Job을 제출하는 주체가 됩니다.
-
HDFS : Job 실행 중 사용되는 입력 파일, 중간 파일, 출력 파일 등은 모두 HDFS 상에 저장됩니다. Mapper/Reducer 간의 데이터 공유도 HDFS를 통해 수행됩니다.
3.2. MapReduce는 언제 동작하는가?
MapReduce는 단순한 파일 업로드, 다운로드, 삭제와 같은 명령어에서는 동작하지 않습니다.
즉, hdfs dfs -put, -get, -ls, -rm 같은 명령어를 사용할 때는 MapReduce가 관여하지 않으며,
이 경우 HDFS 클라이언트가 직접 NameNode와 DataNode에 요청을 보내 처리합니다.
반면, 다음과 같은 경우에는 MapReduce 엔진이 실제로 Job을 실행합니다.
-
hadoop jar로 실행한 MapReduce 프로그램
-
Hive, Pig, Oozie 등에서 MapReduce 백엔드를 사용하는 쿼리 실행
-
Sqoop import/export 작업
-
기타 사용자 정의 분석 Job
이처럼 MapReduce는 “분산 처리 Job”이 필요한 경우에만 실행됩니다. 쉽게 풀어보면, Hadoop 작업 자체에서 동작하려면 MapReduce 프레임워크를 사용한 코딩이 필요합니다. Hive 와 같은 엔진에서는 Hive에서 쿼리를 작성하면, Hive가 내부적으로 이 쿼리를 MapReduce 작업(또는 Spark, Tez 같은 다른 실행 엔진)으로 변환해 줍니다. ( Hive 설정이나 환경에 따라 MapReduce가 기본 실행 엔진이거나 다른 엔진일 수 있습니다. )
3.3. MapReduce Task 구동 절차
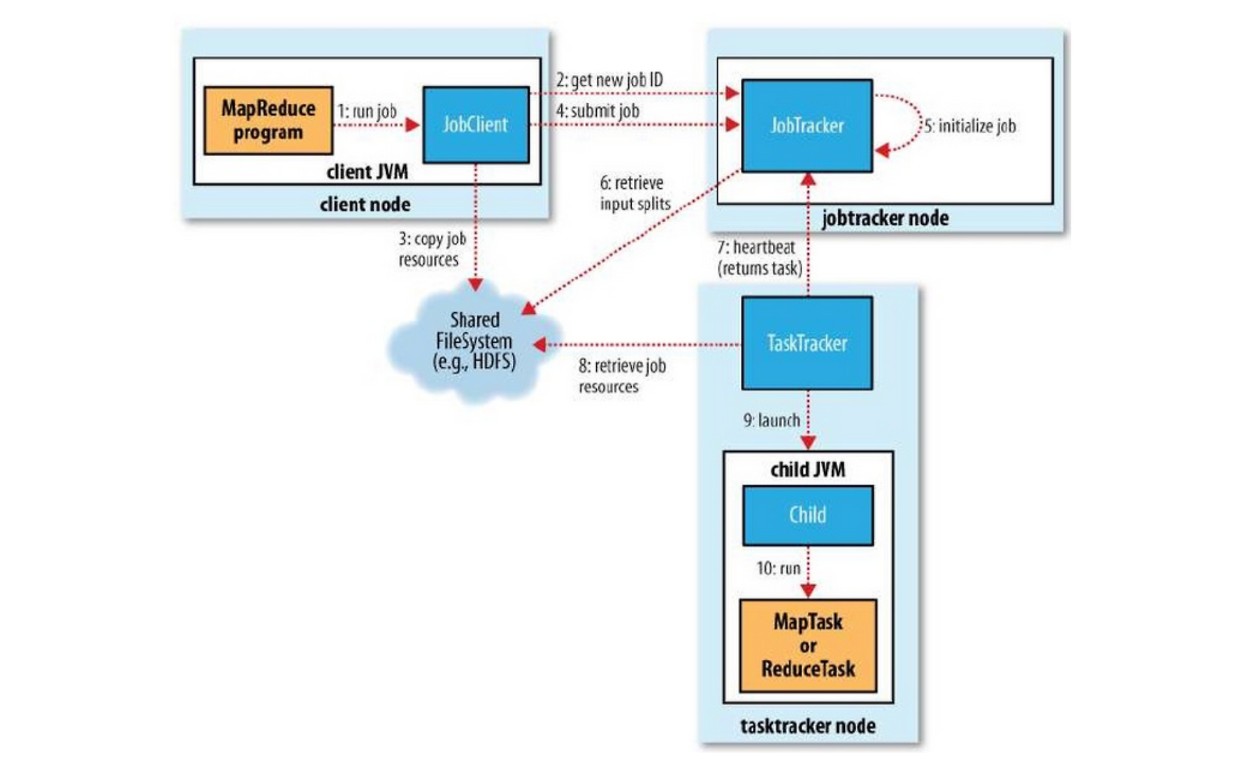
-
사용자 애플리케이션 실행 사용자가 클라이언트에서 MapReduce 프로그램을 실행하면, 내부적으로
JobClient가 생성되고 실행됩니다. -
Job ID 발급 요청 JobClient는 클러스터의 JobTracker에 연결하여 새로운 Job ID를 요청합니다.
-
Job 리소스 HDFS 업로드 실행에 필요한 코드, 설정 파일, 라이브러리 등을 HDFS에 업로드합니다.
-
JobTracker에 Job 제출 JobClient는 JobTracker에게 Job을 제출하며, 이후 작업 스케줄링은 JobTracker가 관리합니다.
-
Job 초기화 JobTracker는 제출된 Job에 대한 초기화 작업을 수행합니다 (메타정보 구성, 디렉터리 생성 등).
-
InputSplit 검색 HDFS에서 입력 데이터를 블록 단위로 나눈 후, 각 블록의 위치 정보를 기준으로
InputSplit을 구성합니다. InputSplits 는, 물리적 Block 들을 논리적으로 그루핑 한 개념이라고 볼 수 있습니다. InputSplit 은 Mapper 의 입력 데이터를 분할하는 방식을 제공하기 위해, 데이터 위치와 읽어 들이는 길이를 정의합니다. -
Task 할당 요청 (Heartbeat) TaskTracker는 주기적으로 JobTracker에 하트비트를 보내며, 실행 가능한 Task가 있는지 확인합니다.
-
Job 리소스 로컬 복사 Task가 할당되면, TaskTracker는 HDFS에서 필요한 Job 리소스를 자신의 로컬 디렉터리로 복사합니다.
-
Child JVM 실행 TaskTracker는 자식 JVM 프로세스를 생성하여, Map 또는 Reduce Task를 실행할 준비를 합니다.
-
Map 또는 Reduce Task 실행 할당받은 Task를 실행하여 실제 데이터 처리(Map 또는 Reduce 로직)를 수행합니다.
💬 참고 : 위 절차는 Hadoop 1.x (MapReduce v1) 기준입니다. Hadoop 2.x 이상에서는 YARN이 도입되며 JobTracker/TaskTracker가 ResourceManager/NodeManager로 대체됩니다.
3.4. MapReduce 동작 과정
MapReduce 는 다음 6가지 동작 과정을 가집니다.
-
입력 데이터 분할 (Input Splitting)
- 대용량 입력 파일을 여러 개의 Input Split으로 나눕니다.
- 각 Split은 병렬로 처리할 수 있는 최소 단위입니다.
- 보통 HDFS 블록 크기(예 : 128MB)를 기준으로 나뉩니다.
-
맵(Map) 단계
- 각 Input Split에 대해 Map 함수가 병렬로 실행됩니다.
- Map 함수는 입력 데이터를 키-값 쌍 (key-value pair)으로 변환합니다.
- 예를 들어, 텍스트 파일을 줄 단위로 읽어 단어별로
(단어, 1)쌍을 만듭니다. - Map 함수 결과는 메모리 버퍼에 임시 저장됩니다.
-
중간 정렬 및 병합 (Sort and Merge)
- Map 출력 결과는 내부에서 키를 기준으로 정렬됩니다.
- 정렬된 결과는 디스크에 임시 저장되며, 여러 Map 결과를 병합(merge)합니다.
- 이 단계는 후속 작업인 Shuffle을 원활하게 만듭니다.
-
셔플(Shuffle)
- 각 Mapper에서 정렬된 데이터를 Reducer로 전송합니다.
- 동일한 키를 가진 모든 값이 하나의 Reducer에 모이도록 데이터를 네트워크로 이동시킵니다.
- 이 과정은 Map과 Reduce 작업의 중간 단계로 네트워크 I/O를 많이 발생시킵니다.
-
리듀스(Reduce) 단계
- Reducer는 전달받은 키별로 그룹화된 값을 입력받아 집계 연산을 수행합니다.
- 예를 들어,
(단어, [1,1,1,...])값을 받아 단어 등장 횟수를 합산합니다. - Reduce 함수 결과는 최종 출력(key-value 쌍)으로 생성됩니다.
-
결과 저장 (Output)
- Reduce 작업의 결과는 HDFS 같은 분산 파일 시스템에 저장됩니다.
- 출력 파일은 여러 파티션으로 나누어 저장될 수 있습니다.
요약해보면, 아래 표처럼 볼 수 있겠습니다.
| 단계 | 설명 |
|---|---|
| 1. 입력 분할 | 데이터를 여러 Split으로 나눔 |
| 2. 맵(Map) | 각 Split에 대해 Map 함수 실행 |
| 3. 정렬 및 병합 | Map 결과를 키별로 정렬, 병합 |
| 4. 셔플(Shuffle) | 키별로 데이터를 Reducer에 전송 |
| 5. 리듀스(Reduce) | 키별로 집계 작업 수행 |
| 6. 출력 저장 | 최종 결과를 분산 파일 시스템에 저장 |
3.5. MapReduce 예시
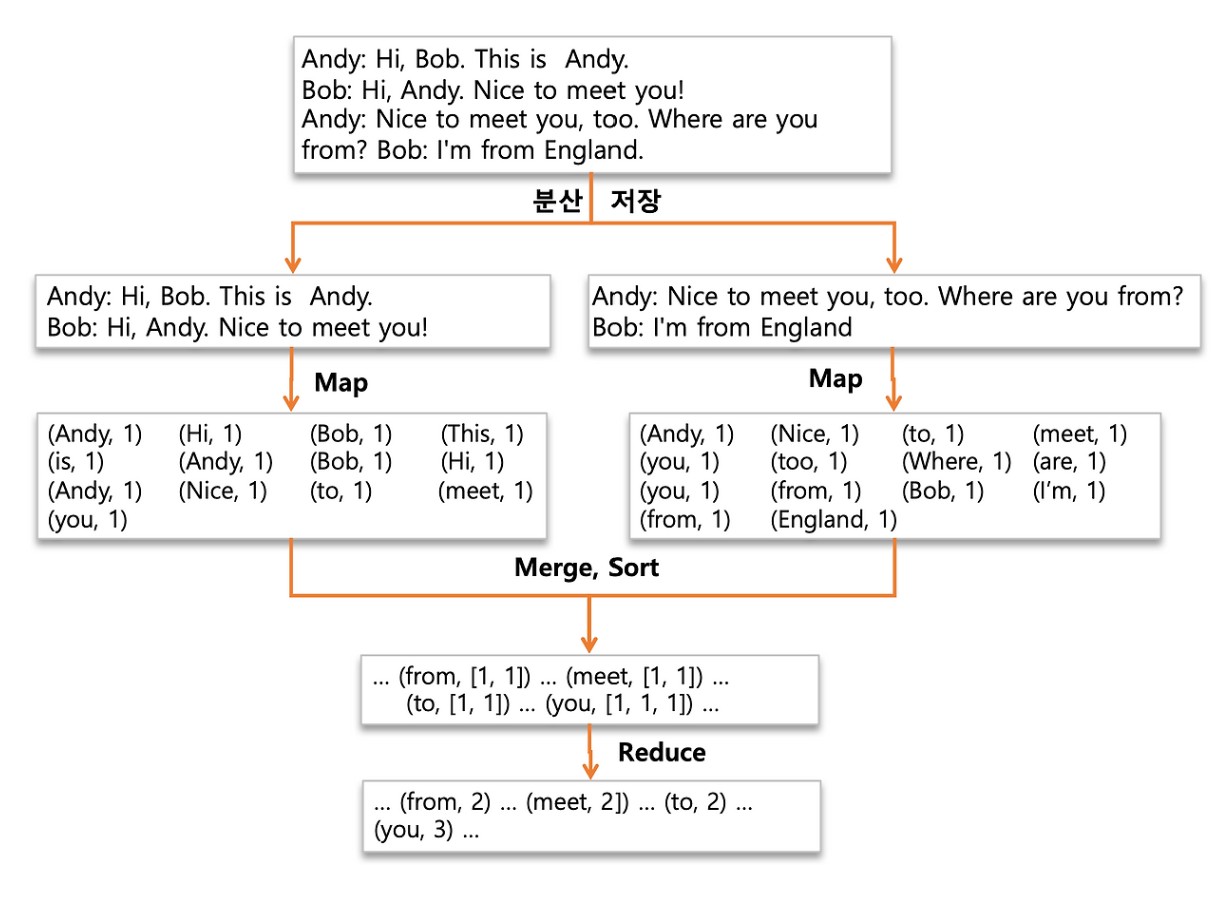
출처 : Map Reduce 예시
-
입력 데이터 분할 (Input Splitting) 100GB짜리 텍스트 파일이 있다고 합시다. 이 파일은 HDFS에 저장되고, 128MB 크기 단위로 쪼개집니다. 각 128MB 조각 하나가 하나의 Input Split이 됩니다.
-
맵(Map) 단계 각 Input Split은 별도의 Map Task에 할당되어 병렬로 처리됩니다. Map 함수는 텍스트를 줄 단위로 읽고, 각 줄에서 단어를 분리해
(단어, 1)쌍을 생성합니다. 예를 들어, 한 줄에 “Andy and Bob”이 있으면(Andy, 1),(and, 1),(Bob, 1)이런 식입니다. 이렇게 모든 단어에 대해 1씩 붙여서 중간 결과를 만듭니다. -
중간 정렬 및 병합 (Sort & Merge) 각 Map Task가 만든
(단어, 1)쌍들은 키(단어) 기준으로 내부 정렬됩니다. 메모리 버퍼가 차면 디스크에 spill 하여 임시 저장되고, 여러 번 spill된 데이터는 하나로 병합됩니다. 이 과정 덕분에 후속 작업인 Shuffle이 효율적으로 진행됩니다. -
셔플(Shuffle) 각 Map Task가 정렬한 단어별 데이터를, 동일한 단어를 처리할 Reduce Task로 네트워크를 통해 전송합니다. 즉, “Andy”에 해당하는 모든
(Andy, 1)데이터는 특정 Reduce Task로 모입니다. 이 단계는 Map과 Reduce 사이에서 데이터를 재분배하는 중요한 과정입니다. -
리듀스(Reduce) 단계 Reduce Task는 한 단어에 대한 모든 1들의 리스트를 전달받아 합계를 계산합니다. 예를 들어,
(Andy, [1, 1, 1, 1])이면 최종적으로(Andy, 4)가 됩니다. 이 계산을 모든 단어에 대해 수행합니다. -
결과 저장 (Output) 최종
(단어, 총횟수)결과들은 HDFS 같은 분산 파일 시스템에 저장됩니다. 결과 파일들은 여러 개의 파티션으로 나뉠 수 있습니다.
MapReduce 의 해당 과정을 통해, 수백 GB 텍스트 파일에서도 단어별 등장 횟수를 효율적으로 셀 수 있습니다.
3.6. MapReduce 예시 구현을 위한 인터페이스
MapReduce는 다음과 같은 인터페이스 흐름을 통해 입력 데이터를 처리하고 출력까지 생성합니다 :
- Input → Mapper → Combiner(선택 사항) → Partitioner → Shuffle/Sort → Reducer → Output
🔹 Input : TextInputFormat
입력 데이터를 (k1, v1) 형태로 읽어오는 역할을 합니다. 보통 k1은 byte offset, v1은 텍스트 줄(String)입니다. 입력 포맷은 데이터 구조에 따라 달라질 수 있습니다.
🔹 Mapper : (k1, v1) → (k2, v2)
핵심 비즈니스 로직이 구현되는 부분입니다. 입력 데이터를 사용자가 정의한 방식으로 (k2, v2) 형식으로 변환합니다.
예시를 워드 카운트로 들어보면, (0, "Hello world") → ("Hello", 1), ("world", 1) 가 됩니다.
🔹 Combiner (선택 사항) : (k2, list(v2)) → (k2, v2')
로컬에서 중복된 key를 먼저 합쳐 Shuffle 트래픽을 줄이는 역할을 합니다. 작은 로컬 reduce 역할을 하며, 결과 정확성에 영향을 주지 않는 경우에만 사용됩니다.
예시를 들어보면, ("word", [1,1,1]) → ("word", 3) 이라고 할 수 있습니다.
🔹 Partitioner : (k2, v2') → #Reducer
각 key를 어떤 Reducer에 보낼지 결정합니다. 기본은 hash(k2) % numReducers 방식이며, 사용자 정의도 가능합니다. 동일한 key는 항상 같은 Reducer로 가야 하므로 정합성에 중요합니다.
🔹 Shuffle/Sort 각 Mapper의 출력 데이터를 네트워크를 통해 Reducer로 전송합니다. 이 과정에서 key별로 데이터를 정렬(Sort)하고, 같은 key를 하나로 병합(Merge)합니다. MapReduce 전체에서 가장 많은 트래픽이 발생하는 구간입니다.
🔹 Reducer : (k2, list(v2')) → (k3, v3)
정렬되고 그룹화된 데이터를 입력받아 최종 결과를 생성합니다. 사용자가 정의한 reduce() 함수가 실행됩니다.
예시를 들어보면, 다음과 같이 됩니다. ("Hello", [1,1,1]) → ("Hello", 3)
🔹 Output : TextOutputFormat
최종 결과를 (k3, v3) 형식으로 출력 파일에 저장합니다. 보통 HDFS에 텍스트 파일 형태로 저장됩니다.
🔸 Combiner와 Partitioner는 성능 최적화에 큰 역할을 하며, 네트워크 병목을 줄이는 데 매우 중요합니다.
3.7. Combiner 와 Reducer 의 차이
Combiner는 Hadoop MapReduce에서 성능을 최적화하기 위한 선택적인 처리 단계입니다. Reducer처럼 동작하지만, Map Task가 끝난 후 로컬 노드에서 실행되어 중간 데이터를 간략화하는 역할을 합니다.
즉, Reduce 작업을 미리 일부 수행함으로써, 전체적인 데이터 처리량을 줄여주는 보조적인 도구라고 볼 수 있습니다. 이 때문에 종종 "로컬 Reducer(Local Reducer)", "세미 Reducer(Semi-Reducer)"라고도 불립니다. MapReduce에서 가장 병목(Bottleneck)이 심한 단계는 Map → Reduce 사이의 Shuffle 단계입니다.
Map Task는 (key, value) 쌍들을 생성하며, 이 결과는 네트워크를 통해 Reducer로 전송되며, 이 과정에서 매우 많은 양의 데이터 전송이 발생할 수 있습니다. Combiner는 이 중간 결과를 로컬에서 먼저 집계하여, Shuffle 단계로 넘어가는 데이터의 양을 줄여줍니다. 예를 들어 다음과 같은 문장이 있다고 가정해봅시다.
Hello Hello Hello World World Bye Combiner 없이 처리할 경우 Map Task는 각 단어를 만나면 다음과 같은 (단어, 1) 형식의 출력을 생성합니다
("Hello", 1)
("Hello", 1)
("Hello", 1)
("World", 1)
("World", 1)
("Bye", 1)
이 모든 값은 그대로 Shuffle 단계를 거쳐 Reducer에게 전달되며, 네트워크로 6개의 레코드가 전송됩니다.
하지만 Combiner가 있을 경우 Combiner는 Map Task의 출력값을 받아 로컬에서 먼저 집계를 수행합니다. 그러면 다음과 같이 합쳐지게 됩니다.
("Hello", 3)
("World", 2)
("Bye", 1)
이제 Shuffle을 통해 Reducer로 보내야 할 데이터는 단 3개입니다. 네트워크로 전송되는 데이터가 절반으로 줄어든 셈입니다. 그림으로 보면, 아래와 같습니다.
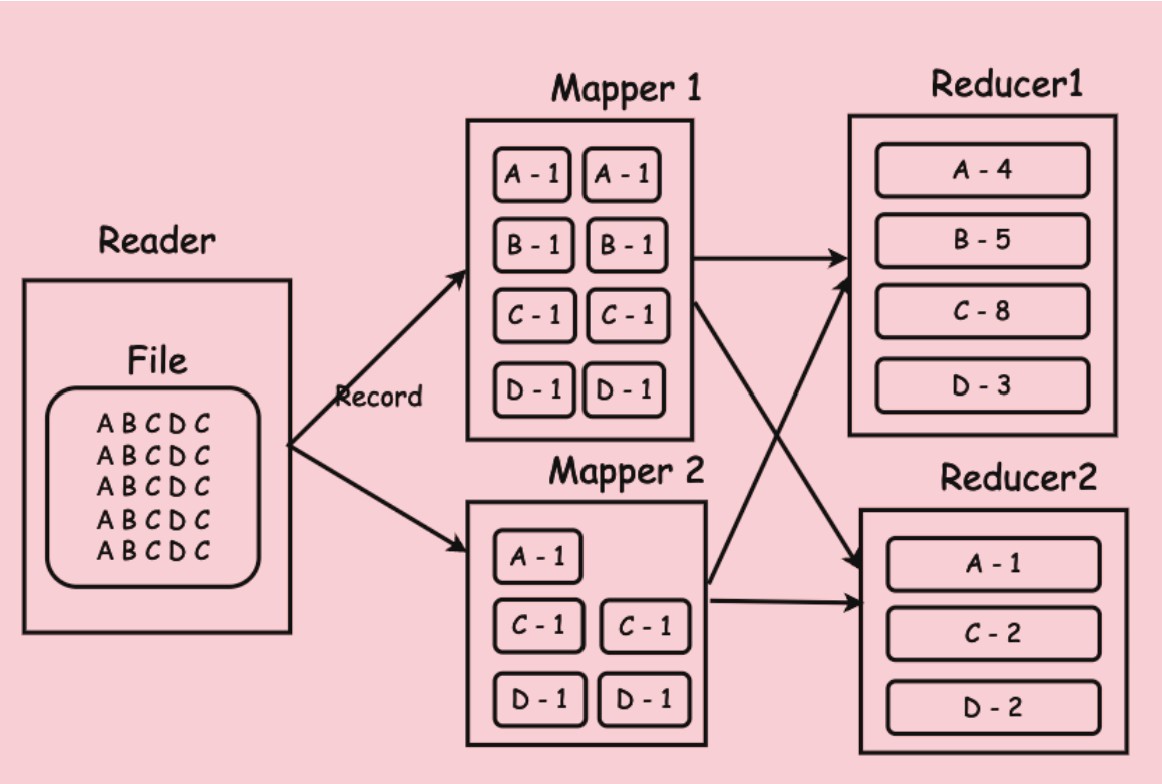
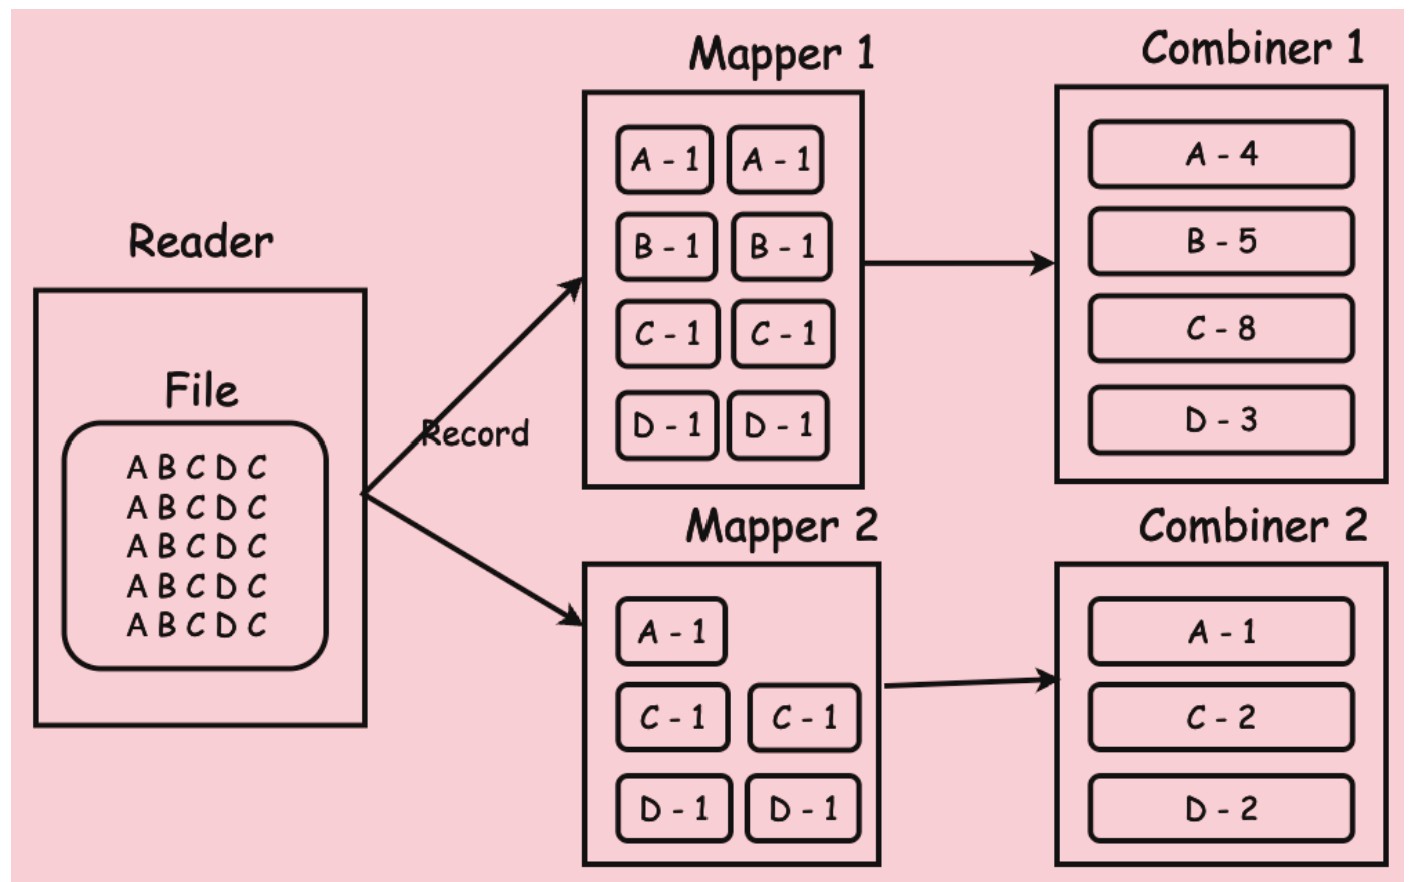
출처 : Combiner 사용 전, 후 이미지
단, Combiner 를 사용 할 때에는 주의할 점이 있습니다.
먼저 Combiner는 실행이 보장되지 않습니다. Hadoop이 내부적으로 최적화 여부를 판단해서 실행할 수도 있고, 하지 않을 수도 있습니다.
그리고 Reducer와 동일한 로직을 사용하지만, 항상 안전한 것은 아닙니다. Combiner가 안전하게 사용되려면 연산이 다음 두 조건을 만족해야 합니다
-
결합 법칙(Associative) : (a + b) + c == a + (b + c)
-
교환 법칙(Commutative) : a + b == b + a
예를들면, Sum, Count, Min, Max는 안전하다고 할 수 있습니다. 하지만 Average, TopK, Percentile 등은 부정확한 결과를 낼 수 있기 때문에 사용하면 안 됩니다. 그렇기 때문에 Combiner 는 데이터 중복이 많고, 중간 결과의 크기를 줄이고 싶을 때, 그러면서 연산이 결합 가능하고 교환 가능할 때
즉, Word Count, Histogram, Sum, Max/Min 계산 등 누적 합산 또는 단순 통계성 작업일 때 사용하는 것이 좋으며, 하둡 내부적으로도 그렇게 판단하고 동작합니다.
3.8. MapReduce 실행 흐름 및 상태 갱신
MapReduce 프로그램이 실행되면, 클라이언트 노드에서 사용자가 작성한 Job이 JobClient를 통해 JobTracker에게 제출됩니다. JobTracker는 전체 Job을 여러 개의 Task로 분할하고, 클러스터 내 적절한 노드에 Task를 분배하여 실행하도록 합니다.
각 Task는 워커 노드에서 실행되며, 해당 노드의 TaskTracker가 이를 관리합니다. 실제 Map 또는 Reduce 작업은 Child JVM에서 수행되며, 이는 각 Task가 서로 영향을 주지 않도록 하기 위한 구조입니다.
Task는 실행 도중에 현재 진행 상황이나 카운터 값 등을 TaskTracker를 통해 JobTracker에게 주기적으로 보고합니다. 또한 TaskTracker는 일정한 주기로 heartbeat를 보내어 자신의 정상 동작 여부를 JobTracker에게 알립니다. 사용자는 JobClient를 통해 Job의 상태를 지속적으로 확인할 수 있으며, JobTracker는 TaskTracker로부터 받은 정보를 바탕으로 전체 작업의 상태를 관리합니다.
만약 Task가 실행 중 장애가 발생하거나, TaskTracker가 일정 시간 동안 heartbeat를 보내지 않으면, JobTracker는 해당 Task를 실패로 간주합니다. 이후 동일한 데이터를 처리할 수 있는 다른 노드에 해당 Task를 재실행하도록 명령합니다.
이러한 방식으로 일부 노드에 장애가 발생하더라도 전체 Job은 자동으로 복구되며, 일정 시간의 지연이 있을 수는 있지만 대부분 정상적으로 완료됩니다. 이처럼 MapReduce는 장애 허용성을 갖춘 구조로 설계되어 있어, Job 상태 관리와 복구가 사용자 개입 없이 자동으로 처리됩니다.
3.9. 분산 캐싱
분산 캐시는 하둡 맵리듀스에서 맵(Map)과 리듀스(Reduce) 작업에 필요한 정적 파일(참조 데이터, 라이브러리, 설정 파일 등)을 클러스터 내 모든 노드에 자동으로 배포하여, 각 노드의 로컬 디스크에서 빠르게 접근할 수 있게 하는 기능입니다.
이를 통해 매번 HDFS에서 해당 파일을 읽지 않고, 로컬에 캐시된 파일을 사용함으로써 I/O 성능을 향상시키고 네트워크 부하를 줄입니다. 주로 작은 크기의 참조 데이터, 공통 라이브러리, 설정 파일 등을 배포하는 데 사용됩니다.
기본적으로 맵리듀스 프레임워크는 분산 캐시에 등록된 파일을 작업 실행 시점에 클러스터 내 모든 노드에 자동으로 배포하고, 로컬에 캐싱하는 작업을 자동으로 수행합니다. 각 TaskTracker(NodeManager) 노드는 분산 캐시에 등록된 파일을 자동으로 HDFS에서 다운로드하여 로컬 디렉터리에 저장하며, 작업 중인 태스크는 분산 캐시에 등록된 파일을 로컬 경로를 통해 접근할 수 있습니다. 즉, 분산 캐시에 등록된 파일의 ‘배포 및 로컬 캐싱’은 자동으로 처리되며, 이 부분을 개발자가 직접 구현할 필요는 없습니다.
하지만 분산 캐시 기능이 자동 배포를 지원하더라도, 다음 부분은 개발자가 직접 수행해야 합니다.
-
분산 캐시에 사용할 파일을 사전에 HDFS에 업로드해야 합니다. 당연한 소리이긴 하지만, 분산 캐시는 HDFS에 저장된 파일을 클러스터 전체로 배포하는 개념이기 때문입니다.
-
맵리듀스 작업 실행 시 분산 캐시에 사용할 파일을 명시적으로 등록해야 합니다. 예를 들어 Java API에서는 아래와 같이 분산 캐시에 파일을 등록합니다.
DistributedCache.addCacheFile(new URI("/path/in/hdfs/file.txt"), job.getConfiguration());
4. Map Reduce 2.0 변동사항
MapReduce 1.0은 일괄 처리(batch processing)만을 지원하며, 데이터 간의 상호작용이 없는 비대화형 처리 방식이었습니다.
그리고 MapReduce Job을 작성하는 것이 복잡하고, 이를 처리할 수 있는 숙련된 개발자가 부족하다는 문제가 있었습니다. 또한, MapReduce Job은 다양한 비즈니스 요구사항에 부합하지 않는 경우가 많았고, 기업에서 필요로 하는 보안성이나 고가용성(high availability) 같은 기능이 부족하다는 점도 큰 제약이었습니다. 즉, MapReduce 1.0은 단순하고 정적인 데이터 처리에는 적합했지만, 유연하고 다양한 처리 요구를 수용하기에는 구조적으로 한계가 있었습니다.
그렇지만 Hadoop 2.x 과 함께 들어온 MapReduce 2.0은 기존 MapReduce 1.0 구조의 한계를 극복하기 위해 JobTracker의 역할을 분리하는 아키텍처 개선을 도입하였습니다. 기존에는 JobTracker가 자원관리(Resource Management)와 작업 스케줄링, Job 생명주기 관리 등 모든 역할을 수행했으나, 2.0에서는 이를 분리하여 새로운 YARN (Yet Another Resource Negotiator) 구조를 도입했습니다.
YARN은 클러스터 전체의 자원을 중앙에서 관리하고, 다양한 형태의 애플리케이션 실행을 가능하게 합니다. 즉, 기존 MapReduce 외에도 실시간 처리, 대화형 쿼리, 그래프 처리, 스트리밍 등 다양한 워크로드를 지원할 수 있게 되었으며, 이를 통해 Hadoop이 일괄처리 플랫폼에서 범용 데이터 처리 플랫폼으로 진화할 수 있었습니다.
MapReduce 2.0은 다음과 같은 이점을 가집니다.
- 자원 관리와 Job 생명주기 관리의 분리로 인한 구조적 효율성 향상
- 여러 형태의 분산 Job 생명주기 관리 지원
- 다양한 애플리케이션 프레임워크 실행 가능 (예 : Spark, Tez, Flink 등)
- 대화형 처리 및 실시간 처리 지원
- MapReduce 코드를 직접 작성하지 않아도 되는 프레임워크 사용 가능
- 더 많은 비즈니스 모델에 적합
- 보안성과 고가용성 개선
- 분산 캐시 기능 향상
특히, 분산 캐시 기능이 향상됨에 따라, DistributedCache 는 더이상 사용되지 않게 되었으며, 아래처럼 addCacheFile 을 사용합니다.
Job job = Job.getInstance(conf, "Example Distributed Cache Job");
job.addCacheFile(new URI("/path/in/hdfs/file.txt#alias")); // alias 는 심볼릭 링크다. 저 alias 로 추후 파일을 쉽게 찾아 읽을 수 있다.
| 항목 | MapReduce 1.0 | MapReduce 2.0 (YARN 기반) |
|---|---|---|
| 처리 방식 | 일괄 처리만 지원 | 일괄 + 실시간 + 스트리밍 등 다양 |
| 실행 구조 | JobTracker 단일 구성 | ResourceManager + ApplicationMaster로 분리 |
| 확장성 | 낮음 | 높음 |
| 유연성 | 정적 | 동적, 다양한 프레임워크 지원 |
| 보안 / 가용성 | 부족함 | 보안성과 고가용성 강화 |
| 지원 애플리케이션 | MapReduce만 지원 | Spark, Tez, Flink 등 다양한 엔진 지원 |
| Job 작성 | 복잡한 MapReduce 코드 필요 | 다양한 API 사용 가능 (Java, SQL, Scala 등) |
| 기업 적용성 | 낮음 | 다양한 비즈니스 모델에 적용 가능 |
MapReduce 1.0은 단일 JobTracker 구조로 인해 처리 유형, 확장성, 유연성에서 한계가 있었으며, 다양한 기업 요구사항을 충족하기 어려웠습니다. 반면 MapReduce 2.0은 YARN 기반으로 아키텍처를 개선하여 자원 관리와 Job 관리 기능을 분리하고, 다양한 처리 방식과 프레임워크를 지원함으로써 보다 확장 가능하고 유연한 데이터 처리 플랫폼으로 발전하였습니다.
5. Map Reduce 기능과 프로그래밍 실습
6. Map Reduce 프로그래밍의 한계
6.1 프로그래밍 시간이 오래 걸림
Java 프로그래밍으로 MapReduce 프레임워크와 인터페이스에 맞추어 대용량 분산 데이터를 처리할 수 있는 것은 큰 발전입니다. 하지만, MapReduce 작업을 하려면 데이터 파싱부터 처리, 정렬, 조인까지 모든 과정을 Java로 직접 구현해야 합니다. 예를 들어, 단순한 로그 파일에서 특정 조건의 데이터를 뽑아 집계하려면, 로그 형식을 파싱하는 코드부터 시작해서, 원하는 집계 로직을 모두 Java 코드로 작성해야 합니다. 이 과정은 복잡하고 시간이 많이 소요됩니다. 따라서 SQL이나 Pig, Hive와 같은 데이터 조작을 쉽게 할 수 있는 도구들이 많이 등장한 이유가 바로 여기에 있습니다. 이들은 복잡한 MapReduce 코드를 자동으로 생성해 주므로 개발 시간을 크게 줄여 줍니다.
6.2 데이터 모델과 스키마의 부재
MapReduce에서는 HDFS에 저장된 파일의 형식만 지정할 수 있을 뿐, 파일 안의 내용을 해석하는 책임은 전적으로 개발자에게 있습니다. 즉, 데이터를 어떻게 파싱하고, 어떤 필드를 읽어들일지 모두 직접 코딩해야 합니다. 예를 들어, CSV 파일이 조금이라도 형식이 바뀌거나 새로운 필드가 추가되면, 파싱 코드를 수정해야 하며, 이는 유지보수를 어렵게 만듭니다. 또한, 복잡한 데이터 타입이나 계층적 데이터 모델을 표현하는 것도 쉽지 않습니다. 예외 처리 또한 개발자가 직접 처리해야 하므로, 잘못된 데이터가 섞여 있을 때 발생하는 오류를 모두 감당해야 합니다. 이처럼 스키마와 데이터 모델이 없으면 데이터의 변화에 유연하게 대응하기 어렵고, 복잡한 데이터 처리가 힘듭니다.
6.3 고정된 데이터 흐름
MapReduce 작업은 기본적으로 Map 단계와 Reduce 단계라는 고정된 두 단계의 데이터 흐름을 따릅니다. 예를 들어, "단어 수 세기" 같은 작업은 입력 데이터를 Map에서 키-값 쌍으로 변환하고, Reduce에서 집계하는 구조로 매우 명확합니다. 하지만 더 복잡한 데이터 처리 로직이나 여러 단계가 필요한 경우, 여러 MapReduce 작업을 체인처럼 연결해야 하며, 각 작업마다 컴파일과 실행 과정을 반복해야 합니다. 이는 개발과 테스트 사이클이 길어지고, 빠르게 아이디어를 검증하기 어렵게 만듭니다. 또한, MapReduce 자체는 동적 데이터 흐름이나 분기 처리와 같은 유연한 작업 흐름을 지원하지 않으므로, 복잡한 워크플로우 구현에는 한계가 있습니다.
6.4 낮은 효율성과 느린 속도
MapReduce는 장애 허용(fault tolerance)과 확장성(scalability)을 보장하기 위해 중간 결과를 HDFS에 저장하는 체크포인트 방식을 사용합니다. 예를 들어, Map 작업이 끝난 후 결과를 디스크에 저장하고, 그 결과를 Reduce 작업이 읽어 처리합니다. 이 때문에 네트워크와 디스크 입출력이 많아지고, 전체 작업 속도가 느려집니다. 또한, 데이터 그룹핑을 위해 외부 정렬과 병합 과정을 거치는데, 이 과정 역시 많은 자원을 소모합니다. 때문에 논리적으로 병렬로 처리할 수 있는 작업도 외부 정렬 등으로 인해 순차적인 단계가 생겨 전체 처리 속도가 제한됩니다. 복잡한 작업이나 긴 데이터 처리 흐름에서는 이런 비효율성이 크게 누적되어, 최신 분산 처리 시스템들이 MapReduce 대신 DAG 기반의 워크플로우를 사용하는 이유가 되기도 합니다. ( Hive 의 Tez 도 DAG 기반입니다. )
이처럼 MapReduce는 대용량 데이터 처리를 가능하게 했지만, 직접 코드를 작성해야 하는 번거로움, 고정된 처리 흐름, 그리고 성능상의 한계로 인해 현대 데이터 처리 환경에서는 이를 보완하거나 대체할 수 있는 다양한 프레임워크와 도구들이 함께 사용되고 있습니다.
결론
MapReduce를 공부하면서 느낀 점은, 처음 접할 때는 그 구조와 흐름이 복잡하고 어렵게 느껴졌지만, 실제로는 매우 직관적이고 체계적인 분산 처리 모델이라는 것입니다. 대량의 데이터를 작은 단위로 나누고, 각 단위 작업을 병렬로 처리한 뒤 결과를 모아 최종 결과를 만드는 방식은 대규모 데이터 처리에서 매우 효과적이라는 걸 새삼 깨달았습니다. 특히, 자원 관리와 작업 스케줄링이 자동화되어 있어 개발자가 복잡한 분산 환경의 문제를 직접 관리하지 않아도 된다는 점이 인상적이었고, 이런 점이 MapReduce가 오랫동안 빅데이터 처리의 표준으로 자리 잡을 수 있었던 이유라고 생각합니다.
하지만 동시에, MapReduce가 모든 작업에 최적화된 해법은 아니라는 점도 알게 되었습니다. 복잡한 연산이나 반복적인 작업에서는 성능 한계가 있고, 최근 등장한 다양한 분산 처리 기술들과 비교했을 때 유연성에서 부족한 부분도 있다는 점에서 MapReduce의 한계를 인정할 수밖에 없습니다. 그럼에도 불구하고, 분산 데이터 처리의 기본 개념을 이해하는 데 있어 MapReduce만큼 좋은 출발점은 드물다고 생각합니다.
결국 이번 공부를 통해 데이터 엔지니어로서 분산 처리 시스템의 본질을 이해하는 데 큰 도움이 되었고, 앞으로 더 복잡한 시스템이나 최신 기술을 접할 때 MapReduce에서 배운 기본 원리와 설계 철학을 바탕으로 더욱 깊이 있는 이해와 응용이 가능할 것이라는 자신감을 얻었습니다. 데이터 처리 시스템을 설계하거나 최적화할 때 이 모델이 가진 강점과 한계를 모두 고려하는 균형 잡힌 시각이 필요하다는 점도 다시 한 번 마음에 새겼습니다.