
YARN(Yet Another Resource Negotiator) 기본 이론

저번 포스팅에서는, 하둡의 핵심을 공부하였습니다. 이번에는 Hadoop V2 의 핵심인 YARN 에 대하여 공부한 내용을 포스팅 하도록 하겠습니다.
📘 분산 시스템의 이해와 하둡의 등장 배경 📘 하둡의 핵심 구성요소와 이론
1. YARN
2012년 이전, Hadoop을 이용해 대용량 처리를 하려면 MapReduce 모델을 기반으로 Java, Python, Ruby, 혹은 Pig 프레임워크를 사용해 개발해야 했습니다.
하지만 Hadoop 2.0과 함께 등장한 Yarn은 MapReduce 프로그래밍 모델의 제약에서 벗어나, 다양한 멀티프로세싱 프로그램을 Hadoop 자원을 활용해 자유롭게 실행할 수 있게 해주었습니다. Yarn은 대용량 멀티프로세싱 처리에서 성능 향상과 유연한 실행 엔진(execution engine)을 제공한다는 점이 큰 장점입니다. 또한, 시간이 지나면서 Spark와 같은 다양한 분산 처리 프레임워크도 Yarn을 지원하게 되면서, 하둡 생태계에서 필수적인 리소스 관리 플랫폼으로 자리잡았습니다.
이러한 YARN 에 대하여, 지금부터 공부하고, 정리한 내용을 포스팅 해보도록 하겠습니다.
1.1. YARN 이란
출처 : YARN
Yarn은 Hadoop 2.0부터 도입된 클러스터 자원 관리 시스템(Resource Manager)입니다. 이전 Hadoop 버전에서는 MapReduce라는 특정 프로그래밍 모델에만 의존해서 작업을 처리했는데, Yarn이 도입되면서 MapReduce에 국한되지 않고 다양한 종류의 분산 처리 작업을 실행할 수 있게 되었습니다.
Yarn의 주요 역할은 클러스터 내 여러 노드의 자원을 효율적으로 관리하고 할당하여, 여러 애플리케이션이 동시에 안정적으로 실행될 수 있도록 조율하는 것입니다. 즉, 여러 사용자가 다양한 작업을 동시에 실행해도 자원이 과도하게 집중되거나 낭비되지 않고, 적절하게 분배되어 전체 시스템의 효율성과 안정성을 높입니다.
Yarn은 또한 실행 환경을 유연하게 제공하여, Apache Spark, Flink, Tez 같은 다양한 분산 처리 프레임워크도 지원합니다. 이로 인해 빅데이터 처리의 범위가 단순한 배치 작업에서 실시간 스트리밍, 머신러닝, 그래프 처리 등으로 확장될 수 있었습니다.
1.1.1. Yarn의 대표적인 Use-Cases
Yarn이 등장하면서 Hadoop 기반 클러스터는 다음과 같은 장점과 가능성을 갖게 되었습니다.
-
🔍 배치 작업뿐 아니라 반복 작업과 실시간 스트리밍 처리 지원 과거 Hadoop은 일괄 처리(batch processing)에 초점이 맞춰져 있었으나, Yarn 덕분에 지속적으로 데이터를 처리하는 스트리밍 작업과 주기적으로 반복 실행되는 작업들도 효율적으로 수행할 수 있게 되었습니다. 예를 들어, 실시간 로그 분석, 실시간 추천 시스템 등 웹 서비스에 필요한 빠른 데이터 처리가 가능해졌습니다.
-
🔍 클러스터 자원 활용률 극대화 클러스터 내 자원을 한 애플리케이션이 모두 사용하지 않을 때, Yarn이 자원을 다른 애플리케이션에 재할당해 줌으로써 자원 활용률을 크게 향상시켰습니다. 이는 비용 절감과 클러스터 운영 효율을 높이는 데 중요한 역할을 합니다.
-
🔍 통합 클러스터 운영 데이터 저장(HDFS), 데이터 처리(MapReduce, Spark 등), 데이터 조회 등 다양한 작업을 단일 클러스터에서 함께 처리할 수 있어 운영 관리가 간편해졌고, 데이터 이동에 필요한 시간과 비용도 줄일 수 있었습니다.
-
🔍 다양한 애플리케이션 동시 실행 지원 한 클러스터에서 여러 종류의 애플리케이션이 동시에 안정적으로 실행되어, 여러 팀이나 서비스가 하나의 클러스터를 공유할 수 있습니다.
1.1.2. Container 란?
Docker 를 사용해보신 분들이라면, Container 의 개념을 어느정도 알고 계실 것입니다.
컨테이너는 소프트웨어 실행 환경을 하나의 패키지로 묶은 경량화된 가상화 기술입니다. 여기에는 애플리케이션이 동작하는 데 필요한 코드, 라이브러리, 설정 파일 등이 포함되어 있어, 어디서든 동일한 환경에서 실행할 수 있습니다.
컨테이너 기술은 리눅스의 cgroup과 namespace 같은 기능을 활용하여, 하나의 물리적 서버 내에서도 각각의 컨테이너가 독립적으로 CPU, 메모리, 네트워크 자원을 사용할 수 있도록 격리합니다. 이 격리 덕분에 서로 다른 컨테이너가 충돌하거나 간섭하지 않고, 안정적으로 동시에 실행될 수 있습니다.
컨테이너를 사용하는 주요 이유와 장점은 다음과 같습니다
-
📦 책임 분리(Separation of responsibility) 개발자는 애플리케이션 코드와 그에 필요한 의존성만 신경 쓰면 되고, 배포 환경의 세부 사항(운영체제 버전, 라이브러리 충돌 등)은 크게 신경 쓸 필요가 없습니다. 덕분에 개발과 운영 간 협업이 원활해지고, 배포 및 테스트 과정에서 환경 문제로 인한 오류가 줄어듭니다.
-
📦 높은 이식성(Portability) 컨테이너는 운영체제 수준에서 가상화되므로, 리눅스 기반 서버라면 어느 환경에서든 동일하게 실행할 수 있습니다. 단, 컨테이너가 정상적으로 작동하려면 해당 시스템이 컨테이너 실행을 지원해야 하며, 일반적으로 Linux/amd64 아키텍처에서 가장 원활합니다.
-
📦 애플리케이션 격리(Application isolation) 컨테이너마다 CPU, 메모리, 스토리지, 네트워크 같은 자원을 할당하고 제한할 수 있기 때문에, 하나의 서버에서 여러 컨테이너가 동시에 실행되어도 서로 간섭 없이 안정적으로 작동합니다. 이는 시스템 안정성과 보안성을 높이는 데도 도움이 됩니다.
최근에는 Kubernetes 같은 오케스트레이션 도구와 함께 컨테이너를 사용해, 대규모 분산 시스템을 효율적으로 운영하는 사례가 많아지고 있습니다. Yarn도 이런 컨테이너 개념을 차용해 클러스터 자원 관리에 적용함으로써, 더욱 세밀하고 유연한 자원 할당과 작업 관리를 가능하게 합니다.
1.2. YARN 아키텍처
출처 : YARN 과 HDFS
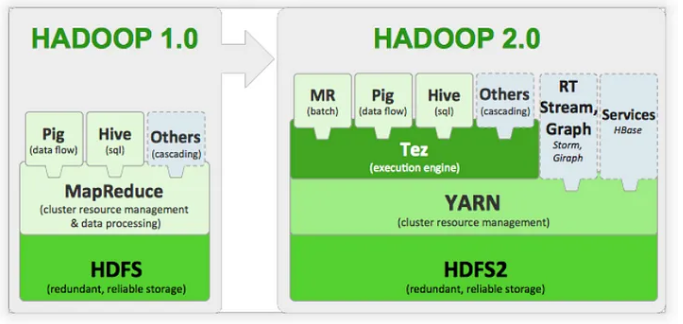
Yarn 과 HDFS 자체는 완전히 독립적입니다. Yarn은 CPU, 메모리와 같은 컴퓨팅 자원을 할당하고 관리하는 자원 관리 소프트웨어입니다. 반면, HDFS는 분산 파일 시스템으로 데이터 저장(스토리지) 역할만 수행합니다. 따라서 Yarn과 HDFS는 완전히 독립적인 시스템이며, 서로 다른 역할을 맡고 있습니다.
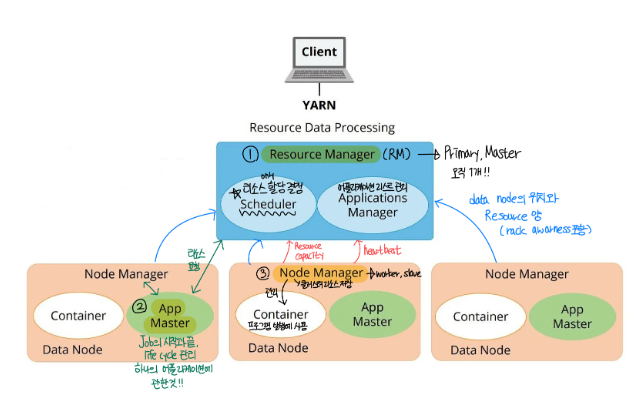
즉, Yarn은 저장소와 관계없이 클러스터의 컴퓨팅 자원 관리에 집중합니다. 그러한 Yarn 의 Architecture 는 크게 3가지 역할을 하는 컴포넌트로 구성 되어있습니다.
-
Resource Manager : 클러스터 전체 자원 관리 및 스케줄링
-
Application Master : 개별 애플리케이션의 자원 요청 및 관리
-
Node Managers : 각 노드에서 자원 할당 및 작업 실행
출처 : YARN 아키텍처
그럼 YARN 의 기본과 핵심 아키텍처를 하나하나 알아보도록 하겠습니다.
1.2.1. Resource Manager (RM)
Resource Manager(RM)는 YARN 클러스터에서 가장 중요한 마스터 컴포넌트입니다. 클러스터 내 모든 컴퓨팅 자원(CPU, 메모리 등)을 총괄 관리하는 관리 본부 역할을 합니다. 예를 들어, 회사 내 여러 부서가 공유하는 컴퓨터 자원을 중앙에서 효율적으로 배분하는 총무팀이라고 생각할 수 있습니다.
RM은 클러스터 내에 존재하는 모든 노드들의 상태와 자원 정보를 알고 있으며, Rack Awareness(서로 물리적으로 가까운 서버 그룹 간의 네트워크 우선순위)도 고려해 자원 할당을 최적화합니다. RM 내부에는 여러 서비스가 존재하지만, 그 중에서도 Scheduler가 핵심입니다. Scheduler는 각 애플리케이션이 요청한 자원 요구사항을 분석해, 누가 언제 얼마나 자원을 쓸지 결정합니다.
대표적인 Scheduler로는 Capacity Scheduler, Fair Scheduler 등이 있습니다. 이들은 클러스터 자원을 공평하게 나누거나, 우선순위에 따라 할당하는 정책을 구현합니다. 이렇게 RM은 단순히 자원을 할당하는 역할뿐 아니라, 리소스 할당 정책을 적용하고, 자원 사용 현황을 모니터링하며 장애 대응을 위한 정보도 관리합니다.
YARN 의 Scheduler 에 대해서는 아래 3번 챕터에서 좀 더 자세하게 정리하겠습니다.
1.2.2. Application Master (AM)
Application Master(AM)는 YARN에서 실행되는 각각의 애플리케이션에 대해 별도로 실행되는 매니저 프로세스입니다. 클러스터 전체를 관리하는 RM과 달리, AM은 특정 애플리케이션 단위의 프로젝트 팀장 역할을 합니다. 애플리케이션이 시작될 때 가장 먼저 실행되는 컨테이너(Container)로서, 자신의 작업에 필요한 리소스를 RM에 요청하고 할당받은 자원을 활용해 작업을 수행합니다.
예를 들어, 데이터 분석 작업 팀의 팀장이라면, RM에게 ‘CPU 4개, 메모리 8GB를 달라’고 요청하고, 할당받으면 그 자원을 기반으로 작업을 진행하는 식입니다. AM은 할당받은 자원 내에서 작업 단위를 관리하고, 필요에 따라 추가 자원 요청, 작업 상태 모니터링, 오류 처리 등을 담당합니다. AM이 실패하면 해당 애플리케이션 작업 자체가 실패할 수 있으므로 안정성과 복구 메커니즘도 중요합니다. 또한 AM은 각기 다른 분산 처리 프레임워크(예 : MapReduce, Spark, Tez 등)에 맞게 구현되며, 프레임워크별로 자원 관리 및 작업 조정 방법이 다를 수 있습니다.
1.2.3. Node Manager
Node Manager 는 클러스터 내 여러 노드(서버)에서 실행되는 에이전트입니다. 각 Node Manager 는 ‘서버 담당 기술자’로 비유할 수 있으며, 해당 노드의 상태와 리소스를 RM에 주기적으로 보고(heartbeat)합니다. Node Manager 는 CPU 코어 수, 사용 가능한 메모리 양 등 자신의 노드 자원 용량(capacity)을 관리합니다.
YARN Scheduler가 할당을 결정하면 NM은 해당 자원 일부를 컨테이너(Container) 단위로 배정하고, 클라이언트가 제출한 작업을 실행합니다. 컨테이너는 리소스 격리를 위해 독립적인 실행 공간을 제공하며, CPU, 메모리, 네트워크 사용량을 제한할 수 있습니다. 또한 NM은 자원 사용량 모니터링, 컨테이너 시작 및 종료, 장애 감지와 복구 등 작업을 수행합니다.
Node Manager 는 Resource Manager 의 지시에 따라 컨테이너 상태를 주기적으로 보고하며, RM은 이를 통해 클러스터 자원 현황을 정확히 파악할 수 있습니다. NodeManager 내부에는 Container Manager, NodeStatusUpdater, NodeHealthChecker 등의 서비스가 있어, 각각 컨테이너 관리, 상태 업데이트, 노드 건강 체크 기능을 수행합니다. 이처럼 NM은 클러스터 내 물리적 하드웨어 자원을 추상화하여 YARN 애플리케이션에 안정적으로 제공하는 역할을 합니다.
1.3. YARN 의 작업 흐름
출처 : YARN 전체적인 흐름
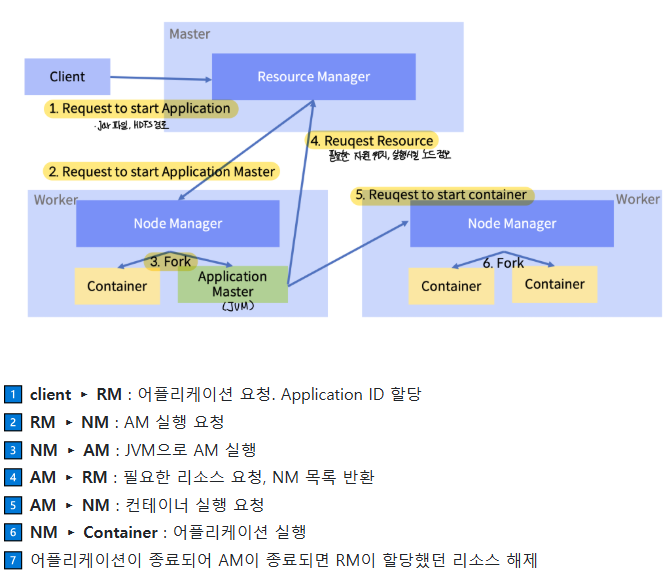
작업의 흐름을 먼저 간단히 정리하고, 세부적으로 들여다보겠습니다.
-
클라이언트가 어플리케이션 실행 요청을 보냅니다.
- 사용자가 작업을 실행하고 싶을 때, 클라이언트 프로그램이 Yarn API를 통해 실행 요청을 합니다.
- ResourceManager가 이 요청을 받고 유효하다고 판단하면, 클라이언트에게 고유한 Application ID(작업 식별 번호)를 할당합니다.
-
ResourceManager가 NodeManager에게 Application Master 실행을 요청합니다.
- ResourceManager는 클러스터 내 노드들 중 하나의 NodeManager에게 Application Master라는 특별한 프로그램을 실행하라고 지시합니다.
- Application Master는 해당 어플리케이션의 작업 진행을 총괄 관리하는 역할을 합니다.
-
NodeManager가 컨테이너 안에서 Application Master를 실행합니다.
- NodeManager는 ResourceManager의 요청을 받고, 새 컨테이너(작업 실행 공간)를 만들어 JVM(Java Virtual Machine)을 실행하여 Application Master를 띄웁니다.
-
Application Master가 ResourceManager에게 필요한 리소스를 요청합니다.
- Application Master는 작업에 필요한 리소스(메모리, CPU, 네트워크, 컨테이너 개수 등)를 ResourceManager에 요청합니다.
- ResourceManager는 클러스터 전체 리소스 상황을 파악해, 사용할 수 있는 NodeManager 목록을 Application Master에 전달합니다.
-
Application Master가 할당받은 NodeManager에 컨테이너 실행을 요청합니다.
- 받은 NodeManager들에게 실제 작업을 수행할 컨테이너 실행을 요청합니다.
-
NodeManager들이 컨테이너를 실행하고 어플리케이션을 동작시킵니다.
- NodeManager들은 각 컨테이너 안에 JVM을 새로 띄워 어플리케이션을 실행합니다.
- 작업이 끝나면 Application Master도 종료되고, ResourceManager는 종료된 Application Master가 사용하던 자원을 해제합니다.
이제 좀 더 세부적으로 들여다보겠습니다.
1.3.1. client ▸ RM : Application 실행 요청
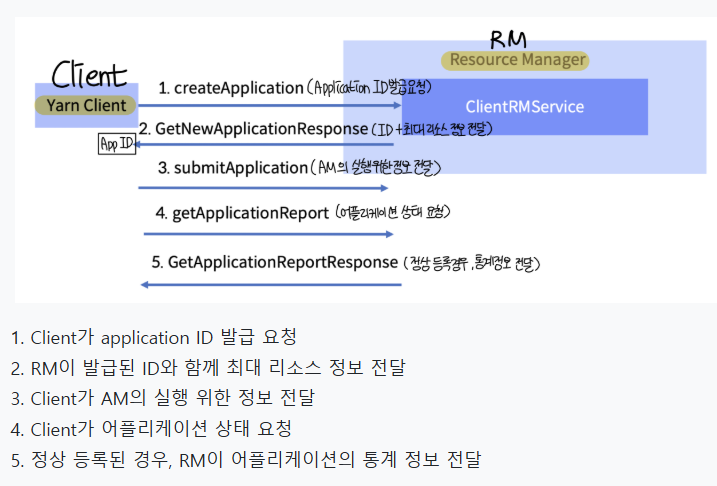
YARN 클러스터에서 어플리케이션을 실행하려면 클라이언트가 ResourceManager에게 일련의 요청을 순서대로 보내야 합니다. 이 과정에서 어플리케이션을 식별할 수 있는 ID를 발급받고, 실행 계획을 제출하며, 실행 상태를 모니터링할 수 있는 정보를 얻게 됩니다.
-
클라이언트가 Application ID를 요청합니다 클라이언트가 YARN 클러스터에서 새로운 어플리케이션을 실행하려면 먼저 Application ID가 필요합니다. 이를 위해
ClientRMService의createNewApplication()메소드를 호출합니다.💡 예시 : 사용자가 Spark 작업을 제출하면, Spark 클라이언트가 내부적으로
createNewApplication()을 호출하여 YARN에 새 작업 ID를 요청합니다. -
YARN이 Application ID와 리소스 정보를 반환합니다
ClientRMService는 요청을 받고, 새로운 Application ID와 함께 클러스터에서 사용 가능한 최대 리소스 정보를 포함한GetNewApplicationResponse객체를 클라이언트에 전달합니다. 예 : 최대 사용 가능한 메모리, 최대 CPU 코어 수 등💡 예시 : 클러스터 전체에서 한 컨테이너당 8GB 메모리, 4코어까지 할당 가능하다는 정보가 함께 전달됩니다.
-
클라이언트가 Application 제출 요청을 보냅니다 클라이언트는 Application ID가 정상적으로 발급되었는지 확인한 후,
ClientRMService의submitApplication()메소드를 호출하여 어플리케이션 실행 요청을 보냅니다. 이때 ApplicationSubmissionContext 객체를 파라미터로 전달합니다. 이 객체에는 실행에 필요한 다양한 정보가 포함되어 있습니다 :- Application ID
- Application Name (예 : "ETL Job for 2025-06-03")
- Queue name (예 : "default", "etl")
- Application Priority
- 필요한 리소스 (메모리, CPU 등)
- Application Master 실행 명령이 담긴
ContainerLaunchContext
💡 예시 : "spark-etl-job"이라는 작업을
etl큐에 제출하며, 메모리 4GB, CPU 2코어, 실행 명령은spark-submit으로 설정합니다. -
클라이언트가 Application 상태를 요청합니다 클라이언트는 어플리케이션이 정상적으로 등록되었는지 확인하기 위해
getApplicationReport()를 호출합니다. -
ResourceManager가 ApplicationReport를 반환합니다 ResourceManager는 요청에 따라 해당 어플리케이션의 상태 및 실행 정보를 담은
ApplicationReport객체를 반환합니다. 이 보고서는 어플리케이션의 실행 상태를 모니터링할 때 유용합니다.ApplicationReport에 포함된 정보 :
항목 설명 Application ID 어플리케이션의 고유 ID User 실행한 사용자 이름 Queue 실행된 큐 이름 Application Name 어플리케이션 이름 ApplicationMaster Host ApplicationMaster가 실행 중인 노드 RPC Port ApplicationMaster의 통신 포트 Tracking URL 웹 UI에서 상태 추적 가능 링크 YarnApplicationState 어플리케이션 상태 (예 : SUBMITTED, RUNNING, FINISHED 등) Diagnostic Info 오류 발생 시 메시지 Start Time 어플리케이션 시작 시각 Client Token 보안 설정이 활성화된 경우 인증 토큰 💡 예시 : 클라이언트는 이 정보를 주기적으로 조회해 작업 진행 상태나 실패 여부를 확인하고, 대시보드나 모니터링 시스템에서 시각화할 수 있습니다.
1.3.2. RM ▸ NM : Application Master 실행 요청
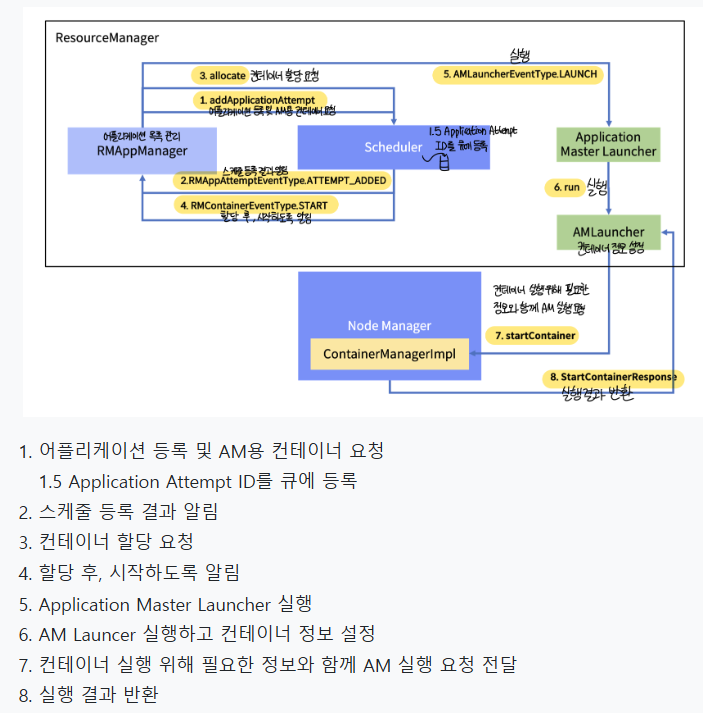
클라이언트가 어플리케이션 제출을 완료하면, 이제 YARN은 클러스터 내부에서 ApplicationMaster를 실행하여 본격적으로 어플리케이션 실행을 시작합니다. 이 과정은 ResourceManager의 내부 구성 요소들과 NodeManager 간의 협업을 통해 이뤄집니다.
-
RMAppManager가 ApplicationMaster 실행을 위한 컨테이너를 요청합니다 ResourceManager의 구성 요소 중 하나인
RMAppManager는 YARN 내부 스케줄러에게 어플리케이션 등록 요청과 함께 ApplicationMaster 실행을 위한 컨테이너 할당을 요청합니다. -
ApplicationAttemptId가 큐에 등록됩니다 YARN은 해당 어플리케이션 실행 시도를 고유하게 식별하기 위해
ApplicationAttemptId를 생성하고, 이를 큐에 등록합니다. 그리고RMAppAttemptEventType.ATTEMPT_ADDED이벤트를 발생시켜 등록이 완료되었음을 알려줍니다.💡 예시 : 하나의 Spark 작업이 실패 후 재시도되는 경우, 새로운 ApplicationAttemptId가 생성되어 큐에 다시 등록됩니다.
-
스케줄러에게 컨테이너 할당을 요청합니다 RMAppManager는 스케줄러에게 ApplicationMaster 실행에 필요한 컨테이너를 할당해달라고 요청합니다.
-
스케줄러가 컨테이너 할당 후 START 이벤트를 발생시킵니다 스케줄러는 적절한 NodeManager에서 사용할 수 있는 리소스를 기반으로 컨테이너를 할당하고, ApplicationMaster 실행을 위한
RMContainerEventType.START이벤트를 발생시킵니다. -
RMAppManager가 ApplicationMasterLauncher를 실행합니다 컨테이너가 할당되면, RMAppManager는
ApplicationMasterLauncher를 통해 실제 ApplicationMaster 실행을 시작합니다. -
ApplicationMasterLauncher가 AMLauncher를 실행합니다
ApplicationMasterLauncher는 내부적으로AMLauncher를 구동하여 ApplicationMaster를 실행합니다. -
AMLauncher가 NodeManager에 ApplicationMaster 실행을 요청합니다 AMLauncher는 컨테이너 실행에 필요한 정보를 담은
ContainerLaunchContext를 준비하고, 이를 NodeManager에게 전달하여 컨테이너 실행을 요청합니다.ContainerLaunchContext에 포함되는 정보 :
항목 설명 ContainerId 컨테이너 고유 식별자 Resource 할당된 메모리 및 CPU 등 리소스 User 해당 컨테이너에 할당된 사용자 Security Tokens 보안이 활성화된 경우 필요한 토큰 LocalResources 실행에 필요한 jar, 바이너리, shared-objects, side files 등 Service Data (선택) 어플리케이션 전용 서비스 데이터 Environment Variables 실행 시 필요한 환경 변수 Launch Command 컨테이너 실행 명령어 Retry Strategy 컨테이너가 실패할 경우 재시도 전략 💡 예시 : Spark의 ApplicationMaster는 내부적으로
spark-submit명령을 launch command로 전달하고, 실행에 필요한spark-assembly.jar등을 local resource로 포함합니다. -
NodeManager가 컨테이너를 실행하고 결과를 반환합니다 NodeManager는 전달받은 컨텍스트를 기반으로 컨테이너를 실행하고, 그 결과를
StartContainersResponse에 담아 AMLauncher에 반환합니다.💡 예시 : 컨테이너가 정상적으로 실행되면, NodeManager는
SUCCESS상태와 함께 컨테이너의 상태 정보를 포함한 응답을 반환합니다.
1.3.3. NM ▸ AM : JVM으로 Application Master 실행
NodeManager는 ResourceManager의 요청에 따라 지정된 컨테이너 안에서 ApplicationMaster를 실행합니다. 이 과정은 실제로 새로운 JVM 프로세스를 생성해서 ApplicationMaster를 구동시키는 방식으로 이루어집니다.
ApplicationMaster를 실행하기 위해 NodeManager는 ContainerLaunchContext라는 실행 컨텍스트 정보를 사용합니다.
이 컨텍스트에는 다음과 같은 실행에 필요한 정보들이 포함되어 있습니다 :
- 컨테이너 ID
- 할당된 리소스 정보 (메모리, CPU 등)
- 컨테이너를 실행할 사용자 정보
- 바이너리나 JAR 파일 등 로컬 리소스
- 환경 변수
- 실행 명령어 (command)
- 보안 토큰 (필요한 경우)
- 실패 시 재시도 전략 등
💡 예시 :
ContainerLaunchContext의 command 필드에는"java -Xmx1024m com.example.MyAppMaster"와 같은 실제 실행 명령어가 설정됩니다.
NodeManager는 이 컨텍스트를 바탕으로 JVM을 생성하고 ApplicationMaster를 구동합니다. ApplicationMaster가 정상적으로 실행되면, 이후 단계에서 ResourceManager에 등록 요청을 하게 됩니다.
1.3.4. AM ▸ RM : 필요한 리소스 요청, NM 목록 반환 및 Application Master 등록
NodeManager가 ApplicationMaster를 성공적으로 실행한 후에는, 해당 ApplicationMaster가 반드시 ResourceManager에 등록되어야 합니다. 이 과정을 통해 ResourceManager는 ApplicationMaster에게 적절한 자원을 할당하거나 상태를 모니터링할 수 있게 됩니다.
등록 과정에 들어가기 전에, 먼저 ApplicationMaster와 ResourceManager가 어떻게 통신하는지 간단히 살펴보겠습니다.
두 컴포넌트는 ApplicationMasterProtocol이라는 인터페이스를 통해 상호작용합니다. YARN은 이 인터페이스를 구현한 기본 클라이언트로 다음 두 가지를 제공합니다.
AMRMClientAMRMClientAsync
필요하다면 사용자가 직접 ApplicationMasterProtocol을 구현하여 커스터마이징할 수도 있습니다.
ApplicationMasterProtocol에서 제공하는 주요 메소드는 아래와 같습니다 :
| 메소드 | 설명 |
|---|---|
registerApplicationMaster(request) |
ApplicationMaster를 ResourceManager에 등록 |
allocate(request) |
자원 요청 및 상태 보고 (heartbeat 포함) |
finishApplicationMaster(request) |
실행 완료 후 종료 처리 요청 |
이제 본격적으로 ApplicationMaster가 어떻게 등록되는지 구체적인 과정을 살펴보겠습니다.
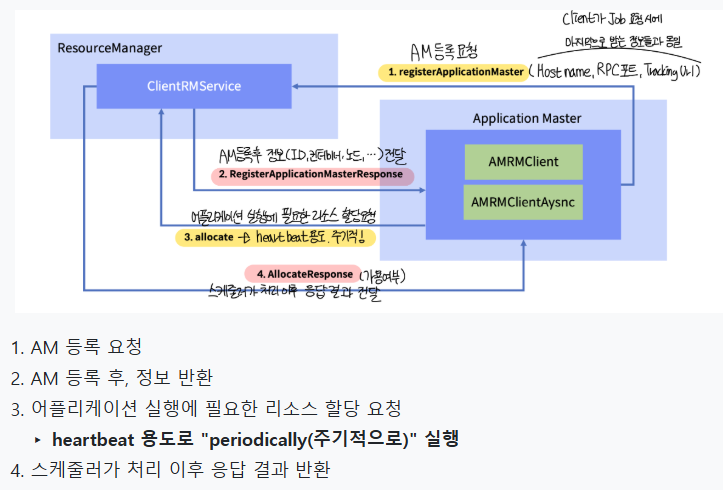
- ApplicationMaster가 ResourceManager에 등록 요청
ApplicationMaster는 registerApplicationMaster() 메소드를 호출하여 ResourceManager에 자신을 등록합니다. 이때 전달되는 RegisterApplicationMasterRequest 안에는 다음 정보가 포함됩니다.
- ApplicationMaster가 실행 중인 호스트 이름
- RPC 포트
- 사용자가 어플리케이션 상태를 확인할 수 있는 Tracking URL
💡 예시 : Spark의 ApplicationMaster는
spark://worker-node1:7077같은 RPC 포트와 Web UI 주소를 등록합니다.
- ResourceManager가 등록 처리 및 응답
ResourceManager의 ApplicationMasterService는 등록 요청을 받은 후, 해당 ApplicationMaster를 내부 목록에 추가합니다. 그리고 RegisterApplicationMasterResponse를 반환합니다. 이 응답은 AllocateResponse 형태로 구성되며 다음 정보를 포함합니다.
- 중복 응답 방지를 위한 Response ID
- AM에게 전달되는 명령어 (e.g., 재시작, 종료 등)
- 새롭게 할당된 컨테이너 목록
- 종료된 컨테이너들의 상태
- 클러스터에서 현재 사용 가능한 리소스 양 (headroom)
- 변경된 노드 상태 목록
- 전체 노드 수
- 반환 요청된 리소스
- (보안 활성화 시) AMRMToken
- 리소스가 증가 또는 감소된 컨테이너 목록
- ApplicationMaster가 allocate 메소드로 리소스를 요청
ApplicationMaster는 이후 주기적으로 allocate() 메소드를 호출하여 다음을 수행합니다.
- 필요한 리소스 요청 (예 : 컨테이너 개수, 위치, 사양 등)
- 어플리케이션의 현재 진행률 보고
- 사용하지 않는 컨테이너 반환
- 실행 중인 컨테이너의 리소스 변경 요청
💡
allocate()메소드는 상태 유지를 위한 heartbeat 역할도 수행합니다. AM은 필요한 컨테이너를 한 번에 못 받아도 이 메소드를 통해 점진적으로 리소스를 받을 수 있습니다.AMRMClientAsync를 사용할 경우 기본 호출 간격은 1초입니다.
-
ResourceManager가 요청을 스케줄러에게 위임
ApplicationMasterService는 받은 allocate 요청을 내부 스케줄러에게 전달합니다. 스케줄러는 요청된 자원이 가용한지 확인하고, 가능할 경우 해당 리소스를 할당합니다. 결과는 다시AllocateResponse에 담겨 ApplicationMaster로 반환됩니다.💡 예시 : 스케줄러는 사용자의 큐, 우선순위, 현재 클러스터 상태 등을 기반으로 자원 할당 여부를 판단합니다.
1.3.5. AM ▸ NM : 컨테이너 실행
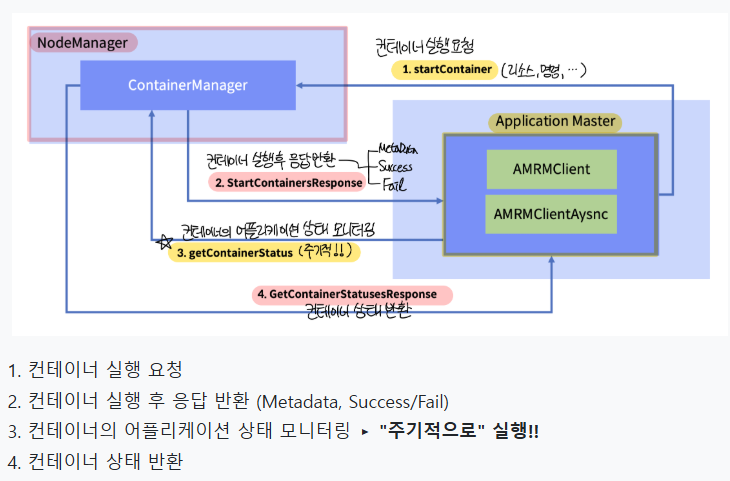
ApplicationMaster는 자신이 할당받은 컨테이너에서 어플리케이션을 실행해야 합니다. 이를 위해 ApplicationMaster는 NodeManager와 상호작용합니다.
-
ApplicationMaster의 클라이언트는 NodeManager에게 컨테이너 실행을 요청합니다. 이때 사용되는
StartContainersRequest에는 다음 정보가 포함되어 있습니다.- 할당된 리소스 (메모리, CPU 등)
- 보안 토큰 (보안이 활성화된 경우)
- 컨테이너를 시작하기 위한 실행 명령어
- 프로세스 환경 변수
- 필요한 바이너리, JAR 파일, 공유 라이브러리 등
-
NodeManager의
ContainerManager는startContainer메소드를 처리합니다.ContainerManager는 ApplicationMaster가 요청한 대로 컨테이너를 실행하고, 실행 결과를StartContainersResponse로 반환합니다.StartContainersResponse는 다음과 같은 정보를 포함합니다.getAllServicesMetaData(): 실행된 서비스의 메타데이터getFailedRequests(): 실패한 컨테이너 실행 요청 목록getSuccessfullyStartedContainers(): 성공적으로 시작된 컨테이너 목록
💡 예시 : ApplicationMaster가 NodeManager에 컨테이너 실행을 요청했을 때, NodeManager가 할당된 메모리 4GB, CPU 2개를 가진 컨테이너를 시작하고, 실행 명령어로
java -jar app.jar를 실행합니다. 실행이 성공하면StartContainersResponse에서 성공적으로 시작된 컨테이너 목록에 해당 컨테이너가 포함되어 클라이언트에 반환됩니다.
1.3.6. NM ▸ Container : Application 실행
사실 위 컨테이너 실행 과정과 Application 실행 과정을 하나로 통합하여 봐도 좋습니다.
-
컨테이너가 성공적으로 실행된 이후, ApplicationMaster는
getContainerStatuses()를 주기적으로 호출하여 각 컨테이너의 어플리케이션 상태를 모니터링합니다. -
NodeManager의
ContainerManager는 ApplicationMaster가 요청한 컨테이너 상태를GetContainerStatusesResponse로 반환합니다. 이 응답에는 컨테이너의 상태 정보가 포함되어 있습니다.
💡 예시 : ApplicationMaster가 주기적으로 컨테이너 상태를 조회할 때, NodeManager는 컨테이너가 현재
RUNNING상태임을 응답하고, 만약 오류가 발생했으면 오류 정보를 포함하여 전달합니다. 이를 통해 ApplicationMaster는 각 컨테이너의 상태를 실시간으로 관리할 수 있습니다.
1.3.7. Application Master 종료
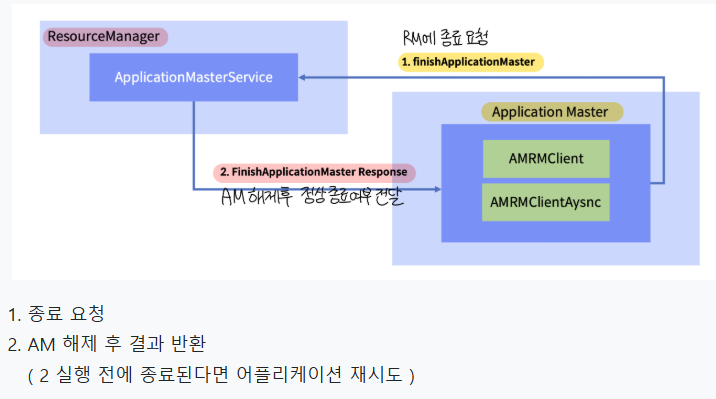
컨테이너에서 실행했던 어플리케이션들이 종료되면, ApplicationMaster도 종료되어야 합니다. ApplicationMaster가 종료되면 하나의 어플리케이션 라이프사이클이 완전히 종료되는 것입니다.
-
ApplicationMaster의 클라이언트는 ResourceManager에게 ApplicationMaster 종료를 요청합니다.
-
ResourceManager의 ApplicationMasterService는 해당 ApplicationMaster를 클러스터에서 해제하고,
FinishApplicationMasterResponse를 반환합니다.FinishApplicationMasterResponse에는getIsUnregistered()라는 boolean 메소드가 있어서, 정상적인 해제와 종료 가능 여부를 알려줍니다.- 만약
getIsUnregistered()가 true가 되기 전에 Application이 먼저 멈춘다면, ResourceManager는 해당 어플리케이션을 재시도합니다.
💡 예시 : 어떤 어플리케이션이 정상적으로 작업을 마치고 종료 신호를 보내면, ResourceManager는 이 요청을 받아 ApplicationMaster를 해제하고,
getIsUnregistered()가 true인 응답을 반환합니다. 반면, 작업이 갑자기 중단되거나 비정상 종료되면, ResourceManager는 재시도를 위해 ApplicationMaster를 다시 실행시킬 수 있습니다.
1.3.8. Auxiliary Service
YARN에서 Auxiliary Service(보조 서비스)는 NodeManager 간에 데이터를 주고받거나 서비스 제어를 가능하게 하는 기능입니다. 특히 하둡 맵리듀스 작업에서, 맵 태스크와 리듀스 태스크 사이의 데이터 전달 과정인 '셔플(Shuffle)'을 원활히 수행하는 데 중요한 역할을 합니다.
맵 태스크는 각 노드의 NodeManager가 관리하는 컨테이너(Container) 내에서 실행됩니다. 맵 태스크가 작업한 중간 결과 데이터는 리듀스 태스크가 실행되는 다른 노드의 컨테이너로 전달되어야 합니다. 그런데, NodeManager는 컨테이너 내 애플리케이션이 종료되면 해당 컨테이너를 즉시 종료합니다. 만약 맵 태스크가 끝나면서 컨테이너가 종료되면, 맵 태스크가 만든 중간 데이터를 저장하거나 리듀스 태스크에 전달할 수 없게 됩니다. 그 결과, 리듀스 태스크가 필요한 데이터를 받지 못해 리듀스 작업을 수행할 수 없게 됩니다.
즉, 맵 태스크가 데이터를 전달하기 전에 컨테이너가 사라지면, 리듀스 작업을 수행할 수 없게 되어 전체 작업 흐름이 멈추게 됩니다. 이런 문제를 해결하기 위해 YARN은 Auxiliary Service를 통해 NodeManager 간에 데이터를 안정적으로 전송할 수 있는 별도의 서비스 채널을 제공합니다. 이를 통해 컨테이너가 종료되더라도 맵에서 리듀스로의 데이터 전달(셔플)이 원활히 이루어질 수 있습니다.
따라서 Auxiliary Service는 맵리듀스 작업의 핵심 단계인 셔플 작업을 성공적으로 수행하기 위한 필수적인 보조 기능입니다.
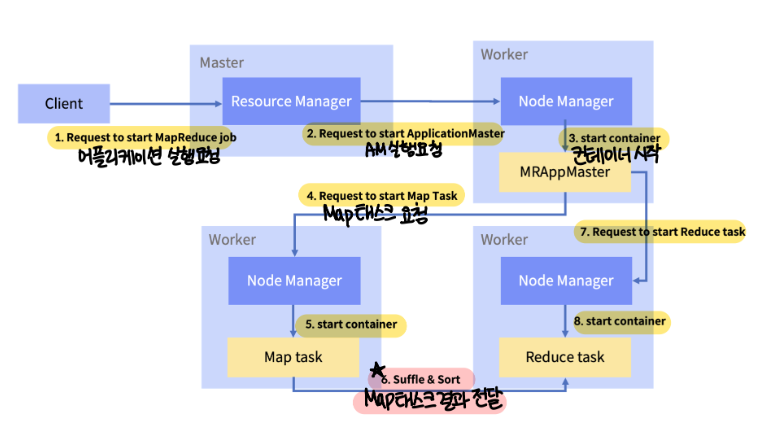
동작 과정은 아래와 같습니다.
-
클라이언트가 ResourceManager에게 어플리케이션 실행을 요청합니다.
-
ResourceManager는 해당 어플리케이션의 ApplicationMaster를 실행합니다.
-
YARN은 맵리듀스 어플리케이션의 ApplicationMaster로
MRAppMaster를 제공합니다.- ResourceManager가 ApplicationMaster 실행을 요청하면 NodeManager가 컨테이너에서
MRAppMaster를 실행합니다.
- ResourceManager가 ApplicationMaster 실행을 요청하면 NodeManager가 컨테이너에서
-
MRAppMaster는 다른 NodeManager에게 맵 태스크 실행을 요청합니다. -
NodeManager는 컨테이너에서 맵 태스크를 실행합니다.
-
맵 태스크가 수행한 결과는 셔플 과정을 통해 리듀스 태스크에 전달됩니다.
- 셔플(Shuffle)을 담당하는 기본 클래스는 하둡의
mapred패키지에 구현된ShuffleHandler입니다.
- 셔플(Shuffle)을 담당하는 기본 클래스는 하둡의
💡 예시 예를 들어, 맵 태스크가 노드 A의 컨테이너에서 실행되고, 리듀스 태스크가 노드 B에서 실행될 때, 노드 A의 NodeManager는 Auxiliary Service를 통해 중간 데이터를 안전하게 노드 B의 NodeManager로 전달합니다. 이 과정에서
ShuffleHandler가 셔플 데이터를 중계하며, 맵과 리듀스 사이 데이터 전달이 끊기지 않도록 보장합니다.
1.3.9. Pluggable Shuffle 및 Pluggable Sort 설정
Pluggable Shuffle 및 Pluggable Sort는 이 Auxiliary Service 위에서 동작하는, 셔플 단계의 데이터 처리 방식을 사용자 정의(customize)할 수 있도록 하는 기능입니다. 즉, 셔플 데이터를 어떻게 수집(ShuffleConsumerPlugin)하고 정렬(MapOutputCollector)할지를 플러그인 형태로 바꿀 수 있습니다.
다시 말해, Auxiliary Service는 셔플 데이터를 전달하는 ‘기반 인프라’이고, Pluggable Shuffle/Sort는 그 위에서 작동하는 ‘동작 방식을 커스터마이징하는 기능’입니다.
Auxiliary Service는 맵리듀스의 셔플과 정렬 동작을 다음 두 가지 방식으로 커스터마이징할 수 있습니다.
-
Job 제출 시 설정
- Job configuration에 인터페이스 구현체(예 :
ShuffleConsumerPlugin,MapOutputCollector)를 포함한 클래스를 지정합니다. - 이 클래스들은 해당 Job 패키지 내에 위치해야 합니다.
- 예를 들어, job-conf.xml 혹은 프로그램 코드 내에서 관련 클래스를 지정하여 특정 셔플 동작을 커스터마이징합니다.
- Job configuration에 인터페이스 구현체(예 :
-
yarn-site.xml 설정
- 클러스터에 배포된 모든 노드의 yarn-site.xml 파일에 auxiliary-services 및 관련 서비스 설정을 추가합니다.
- 이를 통해 클러스터 전체에 커스텀 Auxiliary Service를 적용할 수 있습니다.
- 예를 들어 아래와 같습니다.
<property>
    <name>yarn.app.mapreduce.aux-services</name>
    <value>shuffle</value>
</property>
<property>
    <name>yarn.app.mapreduce.aux-services.shuffle.class</name>
    <value>org.apache.hadoop.mapred.ShuffleHandler</value>
</property>
💡 예시 만약 특정 회사에서 자체 개발한 셔플 최적화 로직을 적용하고 싶다면, Job 제출 시에
ShuffleConsumerPlugin인터페이스를 구현한 클래스를 제공하거나, 클러스터 전반에 적용할 경우yarn-site.xml에 해당aux-service설정을 배포해 셔플 동작을 커스터마이징할 수 있습니다.
참고 해당 내용은 YARN 공식 매뉴얼 자료를 참고하였습니다.
2. YARN 아키텍처 심화
위에서는 YARN 의 흐름에 대해서 알아보았습니다.
그 중 중요한 Resource Manager 와, Node Manager 에 대한 좀 더 심화적인 내용을 몇 가지 공부하여, 정리하고 가고자 합니다.
2.1. Resource Manager 심화
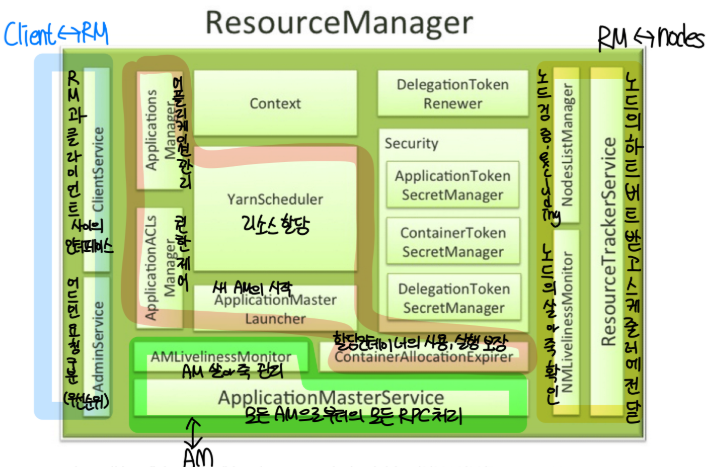
YARN의 ResourceManager는 클러스터 전체의 두뇌 역할을 합니다. 이 컴포넌트는 클러스터의 모든 리소스를 중앙에서 통합적으로 관리하며, 애플리케이션이 실행되는 데 필요한 자원을 적절히 분배하고 조정합니다.
2.1.1. RM ↔ Client 상호작용하는 Component
🔹 ClientService ClientService는 ResourceManager(RM)와 클라이언트 사이의 통신 인터페이스입니다. 클라이언트가 YARN 클러스터에 애플리케이션을 제출하거나, 상태를 조회하거나, 애플리케이션을 중지하는 등의 요청을 보낼 때 이 컴포넌트가 이를 받아 처리합니다.
이 인터페이스는 application submission, termination, queue 정보 조회, 클러스터 통계 조회 등의 기능을 담당합니다.
💡 예시 사용자가 yarn jar MyApp.jar 명령어로 애플리케이션을 제출하면, 해당 요청은 ClientService를 통해 RM에 전달됩니다.
🔹 AdminService 일반 사용자와 관리자의 요청을 구분하기 위해 존재하는 컴포넌트입니다. AdminService를 통해 오는 요청은 보통 시스템 운영자가 클러스터 구성을 변경할 때 사용됩니다.
일반적인 client 요청보다 우선순위가 높게 처리됩니다.
💡 예시 클러스터 운영자가 특정 노드를 클러스터에서 제외하고 싶을 때, AdminService를 통해 node list를 refresh합니다.
2.1.2. RM ↔ NM 상호작용하는 Component
🔹 ResourceTrackerService ResourceTrackerService는 ResourceManager와 각 NodeManager 간의 통신을 담당하며, 각 노드의 상태(예 : 가용 자원, 실행 중인 컨테이너 등)를 주기적으로 수신합니다.
이 컴포넌트는 노드 등록/삭제, 상태 보고(heartbeat) 등을 처리하며, YarnScheduler, NMLivelinessMonitor, NodesListManager와 밀접하게 연동됩니다.
💡 예시 어떤 NodeManager가 새로 시작되면 자신을 RM에 등록하기 위해 ResourceTrackerService에 RPC를 전송합니다.
🔹 NMLivelinessMonitor 이 컴포넌트는 모든 노드의 상태를 생존(live) 또는 죽음(dead) 으로 판단합니다. 각 노드가 일정 시간(기본 10분) 이상 heartbeat를 보내지 않으면 해당 노드를 dead 상태로 간주합니다.
💡 예시 특정 노드가 하드웨어 문제로 정지되어 heartbeat를 보내지 못하면, 이 컴포넌트가 이를 감지하고 RM은 해당 노드를 제외하고 리소스를 스케줄링합니다.
🔹 NodesListManager 이 컴포넌트는 클러스터에 포함된 노드들의 목록을 관리합니다. host inclusion/exclusion 목록을 기반으로 유효한 노드를 판단하고, 관리자가 제외시킨 노드도 지속적으로 모니터링합니다.
💡 예시 운영자가 dfs.exclude 파일에 노드 A를 추가하면, NodesListManager는 이를 감지하여 해당 노드를 클러스터에서 제거합니다.
2.1.3. RM ↔ AM 상호작용하는 Component
🔹 ApplicationMasterService 이 서비스는 모든 AM(ApplicationMaster)으로부터 오는 요청을 처리합니다. 애플리케이션이 실행 중인 동안, 컨테이너 요청, 할당 해제, 등록 및 종료 요청 등을 처리합니다.
💡 예시 ApplicationMaster가 3개의 컨테이너를 요청할 때 이 요청은 ApplicationMasterService를 통해 RM에 전달되고, 이후 YarnScheduler가 해당 요청을 검토해 자원을 할당합니다.
🔹 AMLivelinessMonitor AMLivelinessMonitor는 각 ApplicationMaster의 생존 상태를 주기적으로 모니터링합니다. AM이 heartbeat를 보내지 않으면, RM은 해당 AM을 실패로 간주하고 복구 작업을 수행합니다.
💡 예시 AM이 오작동하거나 JVM 크래시로 인해 죽으면, 이 컴포넌트가 이를 감지하고 RM은 새로운 AM을 재실행할 수 있도록 준비합니다.
2.1.4. RM 핵심 : 스케줄러와 리소스 관리자
🔹 ApplicationsManager ApplicationsManager는 클러스터에 제출된 모든 애플리케이션을 관리합니다. 애플리케이션 실행 정보, 상태 추적, 완료된 애플리케이션 캐시 등을 유지합니다.
💡 예시 yarn application -status 명령어로 애플리케이션 상태를 확인할 수 있는 것은 이 컴포넌트 덕분입니다.
🔹 ApplicationACLsManager Application 단위의 접근 제어(Authorization) 를 담당합니다. 각 애플리케이션마다 접근이 허용된 사용자 목록을 ACL 형태로 관리합니다.
💡 예시 특정 사용자가 다른 사용자의 애플리케이션 상태를 조회하려고 할 때, 이 컴포넌트가 ACL을 확인하여 접근 권한이 있는지를 판단합니다.
🔹 ApplicationMasterLauncher 새로운 애플리케이션이 RM에 제출되면, 이 컴포넌트가 ApplicationMaster 컨테이너를 실행시킵니다. 내부적으로 스레드 풀을 이용하여 비동기적으로 ApplicationMaster를 시작하고 관리합니다.
💡 예시 애플리케이션 제출 후 AM이 실행되지 않는 경우, 이 컴포넌트가 적절한 NodeManager에 AM 컨테이너를 배치하지 못했을 가능성이 있습니다.
🔹 YarnScheduler YARN에서 자원 할당을 실제로 수행하는 핵심 컴포넌트입니다. 각 애플리케이션의 요구사항에 맞춰 메모리, CPU, 디스크, 네트워크 등의 자원을 스케줄링합니다.
💡 예시 ApplicationMaster가 2GB 메모리와 2 vCore가 필요한 컨테이너를 요청하면, YarnScheduler는 현재 가용한 자원을 확인하고 적절한 NodeManager에 컨테이너를 할당합니다.
🔹 ContainerAllocationExpirer 이 컴포넌트는 할당된 컨테이너가 실제로 사용되지 않으면 만료(expire) 시키는 역할을 합니다. AM이 컨테이너를 할당받았지만 사용하지 않을 경우, 해당 컨테이너를 회수합니다.
💡 예시 AM이 테스트 목적으로 컨테이너를 요청한 후 사용하지 않고 그대로 두면, 이 컴포넌트가 일정 시간 이후 이를 회수하여 자원을 낭비하지 않도록 합니다
2.1.5. TokenSecretManagers 보안 컴포넌트
YARN에서는 모든 통신을 인증된 RPC 로 수행합니다. 이를 위해 여러 종류의 토큰 기반 인증 시스템을 제공하며, 각 컴포넌트가 적절한 인증 정보를 통해 서로를 식별합니다.
🔹 ApplicationTokenSecretManager ApplicationMaster가 RM과 통신할 수 있도록 인증 토큰을 발급하고 관리합니다. 애플리케이션별로 권한을 구분하기 위해 사용되며, 유효한 토큰을 가진 AM만이 요청을 보낼 수 있습니다.
💡 예시 악의적인 사용자가 애플리케이션 토큰 없이 RM에 자원 요청을 하면, 이 컴포넌트가 이를 거부합니다.
🔹 ContainerTokenSecretManager AM이 NodeManager에 컨테이너 실행 요청을 보낼 때 필요한 Container Token을 발급하고 검증합니다. 해당 토큰을 통해 컨테이너가 합법적으로 실행되었는지를 확인할 수 있습니다.
💡 예시 RM이 AM에게 컨테이너 실행 정보를 주면서 함께 Container Token을 전달합니다. 이 토큰이 없다면 NodeManager는 해당 요청을 거부합니다.
🔹 RMDelegationTokenSecretManager 클라이언트가 RM과 인증된 통신을 하기 위해 사용하는 Delegation Token을 생성하고 관리합니다. 주로 클라이언트가 장시간 인증 없이 통신을 유지할 수 있도록 돕습니다.
💡 예시 HDFS에서 long-running job이 실행 중일 때, 중간에 재인증 없이 지속적으로 리소스를 요청하려면 delegation token이 필요합니다.
2.2. Node Manager 심화
출처 : YARN 심화 Node Manager
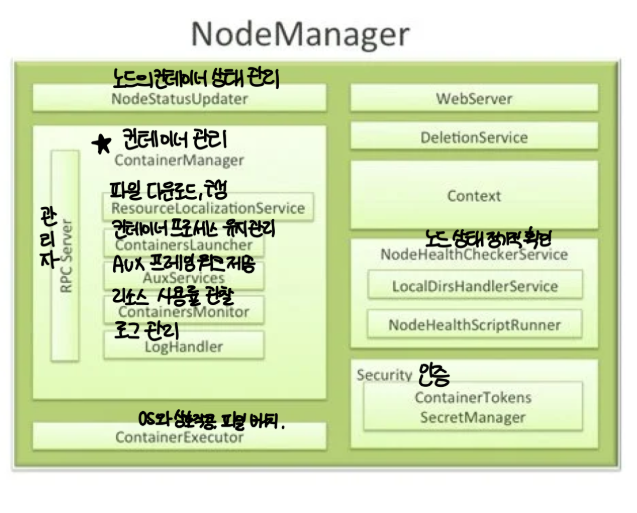
NodeManager는 YARN 클러스터의 각 워커 노드에서 실행되는 컴포넌트로, 컨테이너의 라이프사이클을 관리하고, 로컬 자원을 모니터링하며, 리소스 상태 정보를 ResourceManager(RM) 에게 주기적으로 보고합니다. ( 리소스 매니저는 중앙 서버 1곳에서만 실행되지만, 노드 매니저는 클러스터 내 모든 워커 노드에서 실행됩니다. )
NodeManager는 다음과 같은 핵심 구성 요소로 이루어져 있습니다.
2.2.1 NodeStatusUpdater
NodeStatusUpdater는 NodeManager가 시작될 때 ResourceManager에 자신을 등록하고, 해당 노드에서 사용 가능한 리소스 정보를 전달하는 컴포넌트입니다. 이후 주기적으로 컨테이너 상태, 자원 사용 현황, 노드 상태 등을 RM에 전송합니다. RM은 NodeStatusUpdater를 통해 컨테이너 종료 명령 등을 전달할 수 있습니다.
💡 예시 NodeManager가 "서버-01"에서 시작되면, NodeStatusUpdater가 서버의 메모리 32GB, CPU 16코어 등의 정보를 RM에 전송하고, 이후 해당 노드의 컨테이너 상태를 주기적으로 보고합니다.
2.2.2 ContainerManager
ContainerManager는 NodeManager의 핵심 컴포넌트로, 컨테이너의 생성, 실행, 모니터링, 종료를 담당합니다. 다음의 하위 구성 요소들로 이루어져 있습니다 :
🔹RPC Server ApplicationMaster(AM)의 요청을 수신하여 새로운 컨테이너의 실행을 시작하거나 중지하는 서버입니다. 요청은 인증 절차를 거치며, 로그는 감사용으로 저장됩니다.
💡 예시 AM이 job-1234를 위해 컨테이너 실행 요청을 보내면, RPC Server가 이를 수락하고 해당 작업을 실행합니다.
🔹ResourceLocalizationService 컨테이너 실행에 필요한 파일이나 라이브러리를 다운로드하고, 디스크에 배포하여 컨테이너가 리소스를 안전하게 접근할 수 있도록 구성합니다.
접근 권한 및 사용 제한 정책도 함께 적용됩니다.
💡 예시 Spark 실행 시 필요한 JAR 파일들을 미리 다운받아 컨테이너 디렉토리에 배치하고, 해당 컨테이너만 접근 가능하도록 설정합니다.
🔹ContainersLauncher 컨테이너 실행을 위한 스레드 풀을 관리하며, 컨테이너를 신속하게 시작하고, 종료 요청 시 프로세스를 정리합니다.
💡 예시 RM이 job-5678의 컨테이너를 종료하라고 명령하면, ContainersLauncher는 해당 프로세스를 찾아 종료합니다.
🔹AuxServices (보조 서비스) 특정 프레임워크(Hive, Spark 등)에서 요구하는 추가 기능을 플러그인 방식으로 지원하는 구조입니다. NodeManager 시작 전에 설정해야 하며, 각 응용 프로그램의 컨테이너 시작/종료 시 알림을 받습니다.
💡 예시 ShuffleHandler는 MapReduce의 Reduce 작업을 위한 데이터를 전달하는 보조 서비스로, AM과 연동하여 동작합니다.
🔹ContainersMonitor 실행 중인 각 컨테이너의 메모리, CPU 등의 자원 사용량을 지속적으로 모니터링합니다. 지정된 할당량을 초과할 경우 해당 컨테이너를 종료합니다.
💡 예시 Container-XYZ가 4GB 할당을 받았지만, 6GB를 사용하는 경우 ContainersMonitor는 RM의 정책에 따라 해당 컨테이너를 종료합니다.
🔹LogHandler 컨테이너 실행 중 생성되는 로그를 로컬 디스크에 저장하거나 압축하여 업로드하는 기능을 제공합니다. 로그 핸들링은 플러그인 구조로 되어 있어 교체가 가능합니다.
💡 예시 컨테이너가 출력한 stdout/stderr 로그를 /logs/job123/container456.log 경로에 저장하거나, HDFS에 업로드할 수 있습니다.
2.2.3 ContainerExecutor
ContainerExecutor는 OS와 직접 상호 작용하여, 컨테이너 실행을 위한 디렉토리/파일 배치, 보안 방식으로 프로세스 시작/종료, 실행 후 정리(clean-up) 작업을 수행합니다. 컨테이너의 격리를 보장하기 위해 user-per-container 실행 모델이나 Docker 등과 함께 사용되기도 합니다.
2.2.4 NodeHealthCheckerService
이 서비스는 노드 상태를 확인하기 위한 스크립트를 주기적으로 실행하며, 디스크의 상태를 점검하기 위해 임시 파일을 생성하고 삭제합니다. 상태 변화가 감지되면 NodeStatusUpdater를 통해 RM에 전달됩니다.
💡 예시 /tmp 디렉토리에 파일을 생성해보고, 생성/삭제 속도를 통해 디스크 상태를 판단할 수 있습니다. 디스크 I/O 지연이 크면 노드를 "비정상 상태"로 표시합니다.
2.2.5 Security : ContainerTokenSecretManager
컨테이너 실행 요청이 정상적인 ResourceManager로부터 온 것인지 확인하는 보안 컴포넌트입니다. Token 기반 인증을 통해 위조된 실행 요청을 방지합니다.
💡 예시 악의적인 사용자가 RM을 통하지 않고 직접 NodeManager에 컨테이너 실행 요청을 보내더라도, 유효한 토큰이 없으면 실행이 거부됩니다.
3. YARN scheduler 와 Queue
출처 : YARN Scheduler
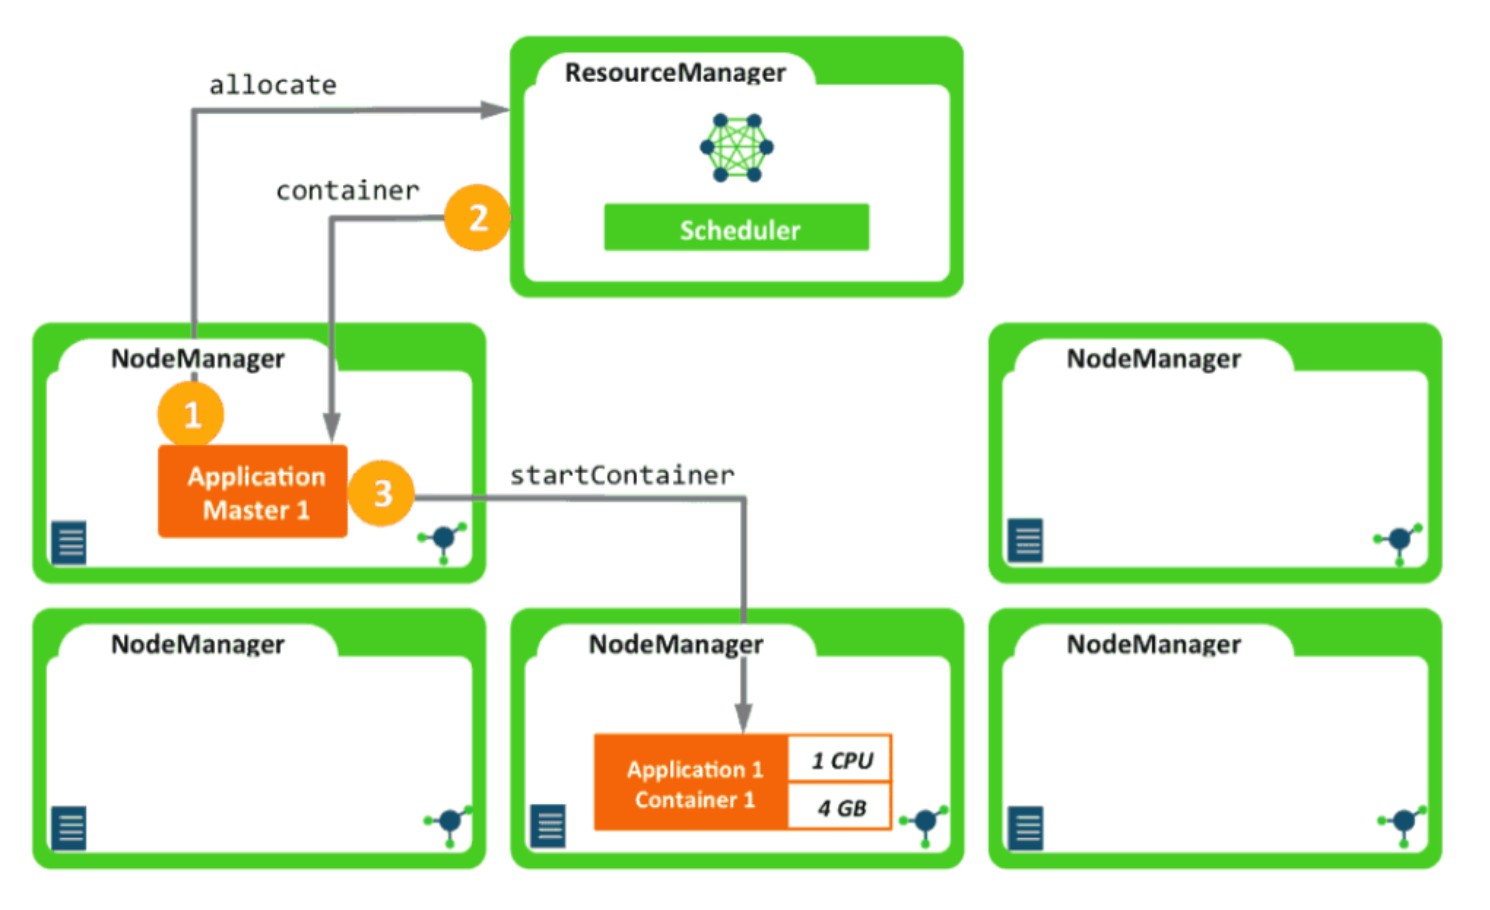
위에서는 애매해서 한 번에 정리하지 못하고, YARN Scheduler 는 이렇게 따로 정리합니다. YARN Scheduler는 클러스터의 리소스를 어떻게, 얼마나 할당할지를 결정하는 리소스 할당 알고리즘입니다. 다양한 설정 값을 통해 클러스터 자원을 효율적으로 활용할 수 있도록 구성할 수 있습니다.
YARN은 기본적으로 Hadoop 플랫폼에서 실행되는 애플리케이션에 리소스를 할당하고 관리하는 역할을 담당합니다. 애플리케이션이 제출되면 먼저 Application Master(AM) 이 생성되고, 이후 아래와 같은 절차가 진행됩니다. 이 과정에서 AM은 ResourceManager(RM) 에게 필요한 리소스를 요청하며, RM은 Scheduler를 통해 적절한 양의 리소스를 어떤 노드에 할당할지 결정합니다.
Scheduler의 종류로는 아래 3가지가 존재합니다. 이 중 Capacity scheduler가 기본 default 값으로 설정되어 있습니다.
3.1. FIFO scheduler
출처 : YARN FIFO scheduler
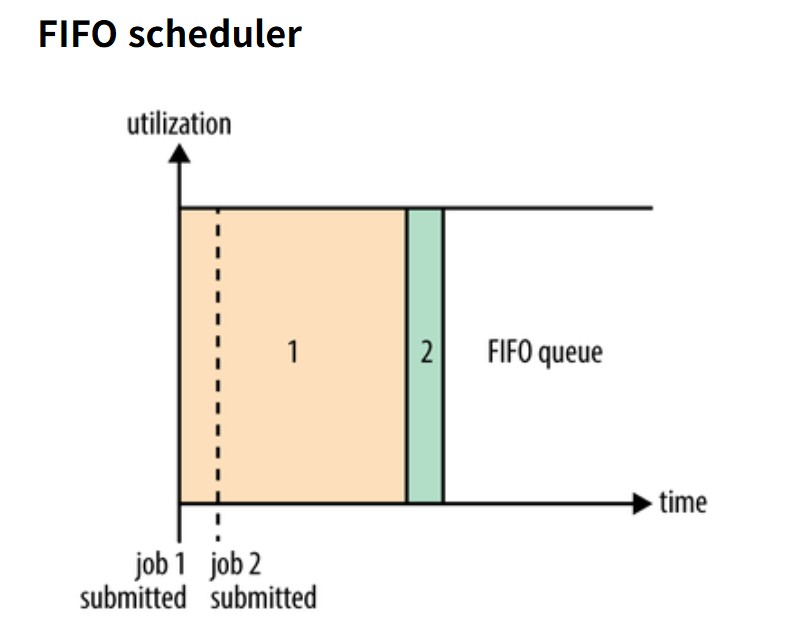
FIFO 스케줄러는 작업이 클러스터에 제출된 순서대로 리소스를 할당합니다. 즉, 가장 먼저 제출된 작업이 가장 먼저 실행되고, 그 작업이 완료되기 전까지는 뒤에 대기 중인 작업들은 실행되지 않습니다. 동작 방식은 매우 단순합니다. 리소스 매니저(ResourceManager)는 작업이 들어온 순서대로 작업 큐에 쌓고, 자원이 충분할 때마다 큐에서 가장 앞에 있는 작업에 리소스를 할당해 실행을 시작합니다.
예를 들어, A 작업이 먼저 제출되어 클러스터의 자원을 모두 사용 중이라면, 그 작업이 완료될 때까지 B 작업은 대기 상태에 있습니다. 이렇게 되면 작업 우선순위 조정이 없고, 긴 작업이 앞에 있을 경우 뒤에 있는 짧은 작업이 긴 시간 기다려야 하는 단점이 있습니다.
3.2. Fair scheduler
출처 : YARN Fair Scheduler
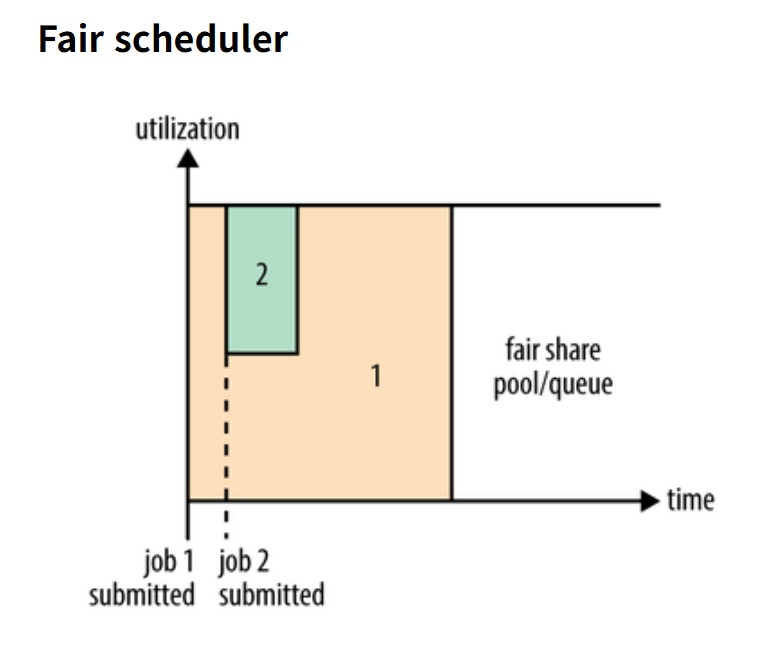
Fair Scheduler는 여러 사용자와 작업들이 클러스터 자원을 공정하게 나누어 쓰도록 설계되었습니다. 작업들은 각각 Pool이라는 자원 그룹에 배정됩니다. 각 Pool은 최소 보장 리소스를 설정할 수 있어, 작업 그룹이나 사용자가 적어도 일정량의 자원을 확보할 수 있도록 보장합니다. 만약 어떤 Pool이 현재 할당받은 자원을 다 사용하지 않으면, 남는 자원을 다른 Pool이 일시적으로 더 쓸 수 있도록 허용합니다.
예를 들어, Pool A와 Pool B가 각각 30%, 70%의 최소 자원을 보장받고 있는데, Pool B가 현재 50%만 사용하고 있다면 Pool A가 최대 50%까지 확장해서 사용할 수 있습니다. Fair Scheduler는 주기적으로 클러스터 내 작업들의 자원 사용량을 체크하며, 자원 배분을 조정합니다. 이 과정에서 자원을 많이 쓴 작업은 잠시 대기시키고, 적게 쓴 작업에 더 많은 자원을 배분해 전체 사용자의 공정성을 유지합니다.
이 스케줄러는 작업이 끝나지 않아도 자원을 다시 재분배할 수 있기 때문에, 긴 작업과 짧은 작업이 혼재된 환경에서 효율적인 자원 활용과 작업 공정성을 보장할 수 있습니다.
3.3. Capacity scheduler
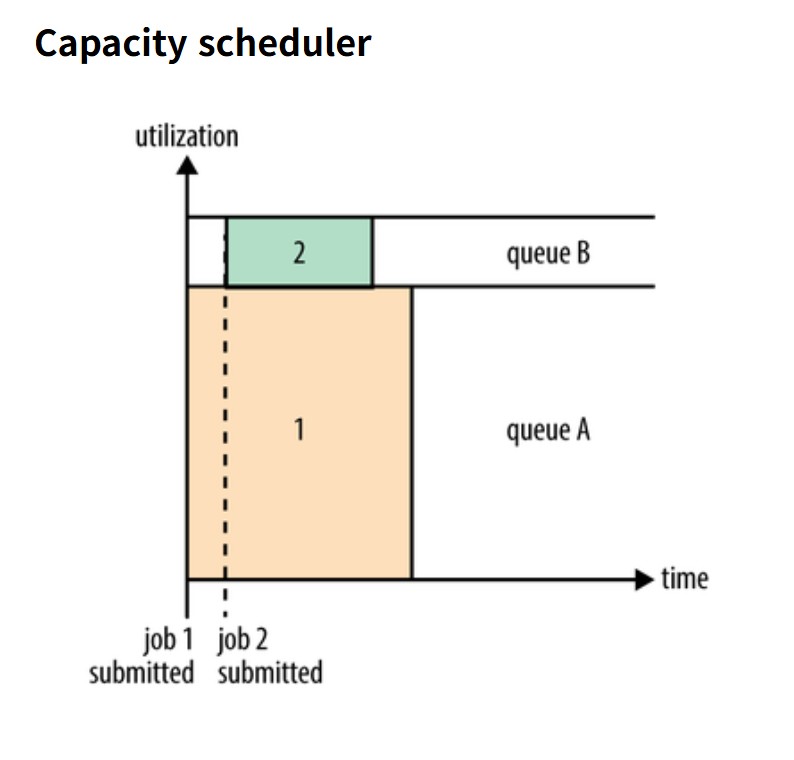
Capacity Scheduler는 YARN의 대표적인 스케줄링 정책 중 하나로, 하나의 클러스터 자원을 여러 사용자나 팀이 공정하고 효율적으로 공유할 수 있도록 설계되었습니다. 이 스케줄러는 기본적으로 Queue(큐) 단위를 통해 클러스터 자원을 분배하며, 각 Queue마다 최소 및 최대 리소스 비율을 설정할 수 있습니다.
Capacity Scheduler는 root 큐를 기준으로 계층적 구조의 Queue를 구성할 수 있으며, 각 Queue는 부모 Queue를 기준으로 최소(min)와 최대(max) 용량(capacity)을 지정할 수 있습니다. Leaf Queue들(가장 하위 큐)은 합쳐서 100%의 min capacity를 갖도록 설정해야 합니다. 또한, Capacity Scheduler는 Queue 간의 리소스 유연성(Elasticity)을 지원합니다.
예를 들어, A 큐의 설정 용량이 20%, B 큐가 80%인 경우, B 큐의 리소스가 사용되지 않는다면 A 큐가 일시적으로 전체 리소스를 사용할 수 있습니다. 이로 인해 리소스 활용률을 극대화할 수 있습니다.
주요 설정 옵션
| Property | 설명 |
|---|---|
yarn.scheduler.capacity.root.queues |
root Queue 하위에 생성할 Queue 목록 |
yarn.scheduler.capacity.root.{Queue 이름}.queues |
특정 Queue의 하위 Queue 목록 |
yarn.scheduler.capacity.root.{Queue 이름}.capacity |
해당 Queue의 최소(min) 리소스 비율 |
yarn.scheduler.capacity.root.{Queue 이름}.maximum-capacity |
해당 Queue의 최대(max) 리소스 비율 |
Minimum User Percentage & User Limit Factor
- 하나의 Queue 내에서 다수 사용자의 리소스 할당 제어를 위한 설정입니다.
minimum-user-limit-percent : 여러 사용자가 동시에 접근 시 각 사용자에게 최소 보장되는 리소스 비율입니다. 예시로 10%로 설정 시, 10명의 사용자가 있을 때 각자는 최소 10%를 보장받습니다.
user-limit-factor : 한 사용자가 사용할 수 있는 최대 리소스의 배수입니다. 계산식은 최대 사용량 = min capacity × user-limit-factor 입니다. 예를들면, min capacity가 10%, user-limit-factor가 3이면 한 사용자가 최대 30%까지 사용 가능.
관련 설정 옵션
| Property | 설명 |
|---|---|
yarn.scheduler.capacity.root.{Queue 이름}.user-limit-factor |
해당 Queue의 사용자 최대 사용 배수 |
yarn.scheduler.capacity.root.{Queue 이름}.minimum-user-limit-percent |
해당 Queue에서 사용자당 최소 보장 비율 |
기타 옵션
| Property | 설명 |
|---|---|
yarn.scheduler.capacity.maximum-am-resource-percent |
전체 클러스터에서 AM이 사용할 수 있는 최대 리소스 비율 |
yarn.scheduler.capacity.{Queue 이름}.maximum-am-resource-percent |
특정 Queue에서 AM이 사용할 수 있는 최대 리소스 비율 |
💡 참고 : AM(Application Master)에 할당되는 리소스가 많을수록, 작업을 처리하는 컨테이너에 할당되는 리소스는 줄어듭니다.
사용자 또는 그룹별 Queue 매핑
- 사용자나 그룹을 특정 Queue에 1:1로 매핑할 수 있습니다.
- 매핑이 많으면 자동 매핑 규칙을 사용할 수 있습니다.
| 설정 방식 | 예시 | 설명 |
|---|---|---|
| 사용자 1:1 매핑 | u:alice:analytics |
alice 사용자를 analytics Queue에 매핑 |
| 그룹 매핑 | g:dev:devqueue |
dev 그룹을 devqueue에 매핑 |
| 자동 매핑 (사용자) | u:%user.%user |
사용자 이름과 동일한 이름의 Queue에 자동 매핑 |
| 자동 매핑 (그룹) | g:%user.%primary_group |
사용자 기본 그룹 이름과 동일한 Queue에 자동 매핑 |
설정 위치 :
yarn.scheduler.capacity.queue-mappings
컴포넌트(엔진)별 Queue 지정 방법
| 컴포넌트 | 설정 방법 |
|---|---|
| MapReduce | 실행 시 -D mapreduce.job.queuename={Queue 이름} 옵션 사용 |
| Spark | spark-submit 시 --queue {Queue 이름} 옵션 사용 |
| Hive | 쿼리 내에서 set {엔진이름}.queue.name={Queue 이름} 명령어 사용 |
Hive는 Tez, MR 등 여러 엔진을 사용할 수 있으므로, 사용하는 엔진 이름을 정확히 명시해야 합니다.
4. YARN TimeLine Service
YARN Timeline Service는 YARN 클러스터에서 실행되는 애플리케이션들의 상태, 이벤트, 그리고 다양한 메타데이터를 수집하고 저장하는 핵심 컴포넌트입니다. 단순한 실행 상태뿐 아니라, 각 태스크(Task)의 상세 실행 내역, 오류 발생 기록, 자원 사용 통계 등 정밀한 데이터를 중앙 저장소에 기록함으로써, 운영자나 개발자가 문제를 쉽게 분석하고 성능을 최적화할 수 있도록 돕습니다.
YARN 환경에서 수십~수천 개의 애플리케이션이 동시에 실행되고, 각 애플리케이션은 수백 개의 컨테이너와 태스크를 포함하는 경우가 많습니다. 이런 상황에서 단순히 ResourceManager의 UI만으로는 실행 내역을 파악하기 어렵습니다. 예를 들어, 어떤 MapReduce 작업이 실패했는지, Spark 애플리케이션에서 어느 컨테이너가 자원 부족으로 종료되었는지, 또는 태스크 수행 시간이 평균보다 비정상적으로 길어진 경우가 어디인지 등을 파악해야 할 때, Timeline Service는 필수적입니다.
YARN Timeline Service는 이러한 요구를 충족시키기 위해 설계된 컴포넌트로, 처음에는 v1 버전으로 단순한 단일 서버 구조에서 시작되었습니다. Timeline Service v1은 모든 이벤트 데이터를 JSON 형태로 수집한 뒤, HDFS에 저장하는 방식을 사용했습니다. 구조가 단순하고 설정이 비교적 쉬웠기 때문에 소규모 또는 테스트 환경에서는 적합했지만, 대규모 클러스터에서는 여러 한계가 드러났습니다.
가장 큰 문제는 확장성 부족과 병목현상이었습니다. 읽기와 쓰기 요청이 모두 하나의 서버 인스턴스로 집중되다 보니, 작업이 몰릴 경우 이벤트 유실, 응답 지연, 시스템 과부하 등의 문제가 빈번하게 발생했습니다. 또한 UI나 REST API를 통해 이벤트를 조회할 때도 성능 저하가 잦았습니다.
이러한 한계를 극복하기 위해 Hadoop 3.0부터 Timeline Service v2 (TSv2)가 도입되었습니다. TSv2는 단순한 리팩토링 수준이 아니라, 아키텍처 전반을 수평 확장 가능한 분산 구조로 재설계한 것이라고 볼 수 있습니다.
출처 : Yarn TimeLine V2
TSv2 아키텍처의 주요 특징은 다음과 같습니다.
-
쓰기와 읽기 역할을 완전히 분리 이벤트 수집기(Collector)는 각 애플리케이션 노드에서 분산 배치되어 데이터를 수집하고 백엔드 스토리지로 전달합니다. 반면 읽기는 Timeline Reader라는 독립 프로세스가 전담하여 REST API 쿼리를 처리합니다. 이 구조는 읽기/쓰기 병렬 처리를 가능하게 하여 시스템 병목을 제거하고 성능을 높입니다.
-
분산 수집기 구조 (Distributed Collector) 각 애플리케이션 마스터(ApplicationMaster)와 동일 노드에 수집기가 동작하며, 이 수집기가 이벤트를 직접 기록합니다. 예를 들어, Spark나 Tez 애플리케이션이 실행되면 해당 노드의 수집기가 컨테이너 실행, 태스크 실패, 자원 요청 등의 이벤트를 직접 받아 기록합니다. 또한 다른 NodeManager도 해당 노드의 수집기로 이벤트를 전송합니다.
-
백엔드 저장소로 HBase 채택 (기본) TSv2는 기본적으로 Apache HBase를 이벤트 데이터 저장소로 사용합니다. HBase는 대용량 데이터 처리와 실시간 쿼리에 강점이 있어, 다수의 애플리케이션 이벤트를 빠르게 저장하고 읽어오는 데 적합합니다.
-
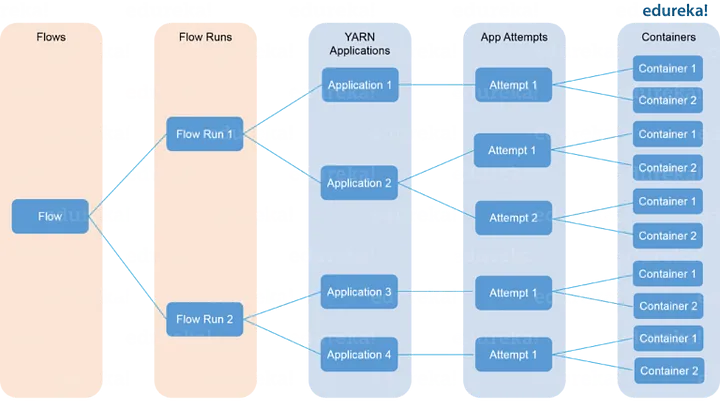
Flow 단위의 데이터 집계 및 분석 기능 TSv2는 단일 애플리케이션이 아닌 논리적 작업 흐름 단위의 이벤트를 집계하는 기능을 지원합니다. 예를 들어, 하나의 BI 분석 워크플로우가 여러 Spark 애플리케이션으로 구성되었다면, 이들을 하나의 "Flow"로 묶어서 추적하고 메트릭을 집계할 수 있습니다. 사용자는 전체 워크플로우의 실행 시간, 자원 사용량, 오류 빈도 등을 통합적으로 확인할 수 있습니다.
실무 예시를 하나 들어보겠습니다. 예를 들어, 하나의 데이터 파이프라인이 다음과 같은 구조로 동작한다고 가정해봅시다. Sqoop을 통해 외부 RDBMS에서 데이터를 추출하고, Spark로 데이터를 변환한 후, 결과를 Hive에 저장합니다. 이 작업은 여러 YARN 애플리케이션으로 분산되어 실행되지만, 사용자 입장에서는 하나의 “업무 흐름(Flow)”으로 인식됩니다.
이때 Timeline Service v2는 각 단계별 자원 사용량, 태스크 실패 횟수 및 오류 메시지, 전체 흐름의 실행 시간과 병목 지점 등을 통합적으로 수집하여 제공합니다. 운영자는 단일 API 호출 또는 UI 대시보드를 통해 이 전체 흐름의 상태를 확인할 수 있으며, 특정 단계에서 오류가 발생하거나 자원 사용이 급증한 부분을 빠르게 진단할 수 있습니다. Timeline Service v2를 사용하려면 yarn-site.xml에 다음과 같은 설정이 필요합니다.
<property>
  <name>yarn.timeline-service.enabled</name>
  <value>true</value>
</property>

<property>
  <name>yarn.timeline-service.version</name>
  <value>2</value>
</property>

<property>
  <name>yarn.timeline-service.storage.type</name>
  <value>hbase</value>
</property>
해당 설정은 Timeline Service를 활성화하고, v2 버전을 사용하며, 저장소로 HBase를 선택하도록 지정합니다.
추가로 HBase 클러스터와 연결이 올바르게 구성되어 있어야 하며, timeline.reader.webapp.address, timeline.collector.bind-host 등 네트워크 관련 속성도 환경에 맞게 설정해야 합니다.
마지막으로, TimeLine Service 2는 보안과 멀티테넌시를 지원합니다. Timeline Service v2는 YARN의 멀티테넌시 환경을 고려하여 사용자별 접근 제어 및 데이터 분리를 지원합니다. 예를 들어, 특정 사용자의 애플리케이션 실행 정보는 다른 사용자가 조회할 수 없도록 ACL이 적용됩니다. 또한 Time To Live 정책을 설정하여 오래된 이벤트 데이터를 자동으로 삭제함으로써, 저장 공간 관리도 효율적으로 수행할 수 있습니다. 정리해보면, Timeline Service는 단순한 로그 수집기가 아닙니다. 애플리케이션의 행동 이력을 시간 축으로 정렬하여 저장하고, 이를 분석 가능한 형태로 제공하는 통합 이벤트 분석 플랫폼이라고 보는 것이 더 정확합니다. 특히 v2는 분산 수집 구조, HBase 저장소, 흐름 기반 집계 기능을 통해 YARN 환경에서의 운영 안정성과 관측 가능성(observability)을 크게 향상시킵니다.
실제 클러스터에서 Timeline Service를 활성화해보고 다양한 애플리케이션들을 실행하며 데이터를 시각화해보면, 장애 분석, 자원 최적화, SLA 준수 여부 판단 등 여러 측면에서 운영 품질을 비약적으로 높일 수 있음을 체감할 수 있게 되었습니다.
결론
오늘은 YARN의 전체적인 구조와 동작 원리에 대한 개요부터 시작해, 애플리케이션이 어떻게 실행되고 자원이 어떻게 스케줄링되는지, 그리고 각 실행 엔진별로 큐를 어떻게 설정하는지까지 전반적인 흐름을 살펴보았습니다.
특히 YARN의 스케줄링 정책인 FIFO Queue와 Fair Queue의 차이점, 그리고 Spark, Hive, MapReduce 등 컴포넌트별로 큐를 지정하는 실제 방법들을 예제와 함께 확인하며, 실무에서 어떻게 응용할 수 있는지 정리해보았습니다.
또한, YARN Timeline Service에 대해서도 기술적인 관점에서 깊이 있게 알아보았는데, 애플리케이션 실행 중 발생하는 이벤트와 메타데이터를 수집하고 저장함으로써 클러스터 내 작업들의 상태를 추적하고 분석할 수 있는 핵심 기능임을 확인할 수 있었습니다. 실패 이력, 자원 사용량, 작업 시간과 같은 운영에 중요한 정보를 한 곳에 통합해 관리할 수 있기 때문에, 클러스터 운영자 입장에서는 반드시 알아야 할 기능 중 하나입니다.
YARN의 기본 개념부터 실무에 필요한 포인트까지 한 번에 정리한 오늘 내용을 바탕으로, 향후 직접 실습해보고 얻은 인사이트도 포스팅할 계획입니다. (이미 실무에서는 사용하고 있지만, 집에서도 처음부터 설치부터 설정, 잡 실행, 모니터링까지 A to Z로 다시 정리해볼 예정입니다.)
긴 글 읽어줘서 고맙습니다. :D