
분산 시스템의 이해와 하둡의 등장 배경

오늘날 데이터는 폭발적으로 증가하고 있으며, 이를 효과적으로 저장하고 처리하는 기술의 중요성도 함께 커지고 있습니다. 이러한 흐름 속에서 주목받은 기술 중 하나가 바로 하둡(Hadoop)입니다. 하둡은 대규모 데이터를 여러 대의 서버에 분산 저장하고 병렬로 처리할 수 있도록 지원하는 오픈소스 프레임워크로, 한동안 빅데이터 처리의 핵심 도구로 널리 활용되어 왔습니다.
최근에는 클라우드 기반의 데이터 처리 환경이 확산되고, Spark나 Flink와 같은 보다 유연하고 고성능의 기술들이 주류로 떠오르면서 하둡의 사용 빈도는 줄어들고 있는 추세입니다. 하지만 그럼에도 불구하고 하둡을 학습하는 일은 여전히 의미가 있습니다. 하둡은 분산 시스템의 구조적 이해를 바탕으로 동작하며, 이러한 개념은 현대의 다양한 데이터 처리 기술에 적용되는 핵심 원리이기 때문입니다. 즉, 하둡을 통해 분산 시스템의 개념을 익히고 데이터 처리의 흐름을 이해하는 것은 이후 다른 기술을 배우는 데에도 큰 도움이 됩니다.
특히 하둡은 단일 서버가 아닌 다수의 서버가 협력하여 작업을 수행하는 분산 시스템 기반 위에서 설계되었습니다. 따라서 하둡을 본격적으로 학습하기 전에 분산 시스템의 기본 개념과 원리를 먼저 익혀두는 것이 매우 중요합니다. 서버 간 데이터 공유, 장애 복구, 일관성 유지와 같은 핵심 개념들을 이해하면 하둡의 내부 동작뿐만 아니라 다양한 빅데이터 기술 전반에 대한 통찰을 얻을 수 있습니다.
이 글에서는 하둡을 왜 여전히 공부할 필요가 있는지, 그리고 그에 앞서 분산 시스템을 먼저 학습해야 하는 이유에 대해 살펴보겠습니다.
1. 분산 시스템 등장 이전의 시대
컴퓨터는 처음 등장한 이후, 오랜 시간 동안 단일 시스템 안에서 모든 연산과 처리를 수행하는 구조로 발전해 왔습니다. 성능 향상을 위해 더 빠른 CPU, 더 많은 메모리, 더 큰 저장 장치가 꾸준히 개발되었으며, 이를 통해 다양한 문제를 해결할 수 있게 되었습니다. 하지만 데이터의 양이 기하급수적으로 증가하고, 실시간 처리의 중요성이 높아지면서 단일 시스템의 한계가 점점 뚜렷하게 드러나기 시작했습니다.
이 장에서는 본격적으로 분산 시스템의 개념을 살펴보기 전에, 분산 시스템이 왜 필요한지를 이해하기 위한 배경으로서 과거의 컴퓨팅 환경은 어떻게 발전해왔는지를 먼저 짚어보고자 합니다. 단일 시스템의 특징과 한계, 그리고 그 한계를 극복하기 위한 기술적 흐름을 살펴보며, 분산 시스템의 필요성이 어떻게 등장하게 되었는지 자연스럽게 연결해보겠습니다.
1.1. 컴퓨터는 어떻게 발전 해왔을까
1.1.1. 1930년대 컴퓨터의 시작
컴퓨터의 시작은 사람이 직접 계산해야 했던 반복적인 작업을 대신해주는 기계를 만드는 것에서 출발했습니다. 지금처럼 키보드나 모니터가 있는 형태는 아니었고, 마우스는커녕 화면조차 존재하지 않았습니다. 초기 컴퓨터는 연산 작업을 자동화하기 위한 전기 기계식 장치에 가까웠습니다.
그 대표적인 예가 1941년에 등장한 Z3 컴퓨터입니다. 독일의 콘라드 추제가 개발한 Z3는 세계 최초의 프로그래머블 컴퓨터로 알려져 있으며, 당시에는 전자식이 아닌 릴레이 기반의 전기 기계식 구조를 가지고 있었습니다. 하나의 문제를 해결하기 위해 기계의 배선을 물리적으로 바꾸거나, 명령을 수동으로 입력해야 했기 때문에 지금과는 비교할 수 없을 만큼 비효율적이었습니다.
이러한 초기 컴퓨터들은 주로 복잡한 계산이 필요한 군사적 작업에 활용되었습니다. 예를 들어, 포탄의 궤적을 계산하는 데 사람의 손으로는 한 시간 이상 걸리는 작업을, 기계는 몇 분 만에 처리할 수 있었습니다. 이는 계산 정확도와 속도 면에서 큰 진보였고, 이후 컴퓨터 기술 발전의 중요한 기반이 되었습니다.
1.1.2. 컴퓨터 구조의 중요한 전환점
1940년대에 들어서면서 컴퓨터의 구조는 중요한 전환점을 맞이하게 됩니다. 이 시기에 등장한 폰 노이만 아키텍처는 컴퓨터 설계의 패러다임을 완전히 바꾸어 놓았으며, 오늘날 대부분의 컴퓨터 구조에 기본이 되는 개념입니다.
1945년에 미국에서 개발된 ENIAC은 세계 최초의 범용 전자식 컴퓨터로, 본격적인 전자 계산기의 시대를 열었습니다. 하지만 ENIAC은 프로그램을 저장할 수 없는 구조였기 때문에, 새로운 작업을 수행하려면 일일이 배선을 변경해야 했습니다. 이는 마치 스마트폰에서 앱을 바꿀 때마다 내부 회로를 새로 납땜해야 하는 것과 같은 매우 번거롭고 비효율적인 방식이었습니다.
이러한 문제를 해결하기 위해 등장한 개념이 바로 '저장 프로그램 방식(stored-program concept)'입니다. 이 개념은 프로그램을 컴퓨터의 기억장치에 저장하고, CPU가 이를 불러와 실행하도록 구성된 구조를 의미합니다. 이로 인해 프로그램의 변경이 훨씬 유연하고 빠르게 이루어질 수 있게 되었으며, 컴퓨터가 지금처럼 다양한 작업을 손쉽게 수행할 수 있는 기반이 마련되었습니다.
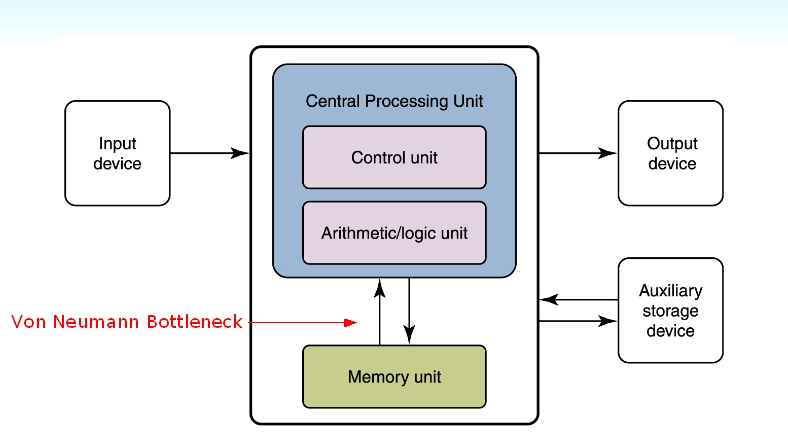
폰 노이만 구조는 프로그램도 데이터처럼 메모리에 저장해 처리하는 방식을 제안하였습니다. 이 구조의 가장 큰 특징은 프로그램과 데이터를 동일한 메모리 공간에 저장함으로써, 컴퓨터가 보다 유연하게 동작할 수 있게 되었다는 점입니다. 이를 통해 복잡한 작업을 손쉽게 수행할 수 있게 되었고, 사용자가 필요할 때마다 프로그램을 바꾸어 실행하는 이른바 ‘재프로그래밍’이 가능해졌습니다.
오늘날 사용되는 거의 모든 컴퓨터는 이 구조를 따르고 있습니다. 기본적으로 중앙처리장치(CPU), 기억장치(메모리), 그리고 입출력 장치로 구성되며, 명령어는 메모리에 저장된 순서대로 하나씩 불러와 실행됩니다. 이러한 처리 방식은 현대 컴퓨터 시스템의 표준적인 동작 원리가 되었고, 다양한 기술의 발전을 이끄는 토대가 되었습니다.
1.1.3. 개인 PC 와 프로그래밍 언어의 대중화
컴퓨터는 점차 연구실과 기업의 전유물에서 벗어나, 일반 가정과 개인의 손에 들어오게 되었습니다. 이러한 변화의 중심에는 마이크로프로세서의 등장과 IBM의 x86 아키텍처 기반 개인용 컴퓨터가 있었습니다. 이 시기는 컴퓨터가 대중화되는 결정적인 전환점이 되었으며, 이후 프로그래밍 언어의 발전에도 큰 영향을 미치게 됩니다.
1981년, IBM이 발표한 IBM PC는 인텔의 8086 마이크로프로세서를 기반으로 만들어졌습니다. 이 구조는 이후 데스크톱 PC의 표준이 되었고, 오늘날에도 여전히 많은 컴퓨터가 x86 아키텍처를 따르고 있습니다. x86 아키텍처는 CPU가 이해하는 명령어 집합 구조를 의미하며, 소프트웨어와 하드웨어 간의 호환성을 높이는 데 기여하였습니다.
이러한 하드웨어 기반 위에서 다양한 프로그래밍 언어가 발전하였습니다. 어셈블리 언어는 기계어보다 사람이 이해하기 쉬운 명령어로 구성되어 있었으며, CPU를 직접 제어할 수 있는 특징이 있었습니다. 이어서 C 언어나 Pascal과 같은 고급 언어들이 등장하면서, 프로그래밍은 더욱 직관적이고 효율적으로 변화해갔습니다. 이러한 언어들은 다양한 운영체제와 시스템에서 활용될 수 있었고, 컴퓨터 활용의 폭을 크게 넓히는 역할을 하였습니다.
Apple II, Commodore 64와 같은 개인용 컴퓨터가 보급되면서, 어린 시절부터 컴퓨터를 접하고 프로그래밍을 배우는 세대도 등장하게 되었습니다. 많은 개발자들이 이 시기에 처음 컴퓨터를 경험하며 프로그래밍에 입문하였고, 이는 현재 IT 산업의 성장에 큰 밑거름이 되었습니다.
💡 x86 아키텍처란? x86 아키텍처는 인텔이 만든 8086 마이크로프로세서에서 시작된 CPU의 명령어 집합 구조(Instruction Set Architecture, ISA)를 이야기함. 쉽게 이야기하면, CPU가 어떤 명령어를 이해하고 처리할 수 있는지를 정의한 일종의 '언어 체계'.
1.1.4. Remote Procedure Call ( RPC ) 의 등장
컴퓨터는 인간보다 훨씬 빠른 속도로 명령어를 처리할 수 있는 기계입니다. 그렇기 때문에, 우리가 원하는 작업을 컴퓨터가 대신 처리해주기를 바란다면, 명확한 명령어만 입력해주는 것으로 충분합니다.
그런데 여기서 한 가지 의문이 생깁니다. "반드시 내 컴퓨터에서만 모든 명령어를 처리해야 할까?"
만약 물리적인 제약을 넘어서, 다른 컴퓨터에서 실행 중인 프로그램도 제 컴퓨터처럼 자유롭게 사용할 수 있다면, 훨씬 더 많은 사람과 시스템이 효율적으로 작업을 수행할 수 있을 것입니다. 이러한 문제의식에서 등장한 개념이 바로 RPC(Remote Procedure Call)입니다.
RPC는 ‘원격 프로시저 호출’이라는 뜻을 가지고 있으며, 말 그대로 다른 컴퓨터에 존재하는 함수(프로시저)를 호출할 수 있도록 하는 기술입니다. 이 기술을 사용하면, 네트워크를 통해 원격에 있는 함수를 마치 제 컴퓨터에 있는 함수처럼 간단하게 호출할 수 있습니다.
// 일반 함수 호출
int result = add(3, 5);

// 실제로는 네트워크를 통해 원격 서버에 있는 'add' 함수를 호출
// 하지만 프로그래머는 로컬 호출처럼 사용
RPC는 이처럼 복잡한 네트워크 통신 과정을 감추고, 프로그래머가 익숙한 함수 호출 형태로 사용할 수 있도록 인터페이스를 추상화합니다. 개발자는 함수가 로컬에 있는지 원격에 있는지 구분하지 않고 코드를 작성할 수 있습니다.
RPC가 본격적으로 실용화된 것은 1980년대입니다. 특히 1984년, Sun Microsystems가 유닉스 환경에서 ONC RPC(Open Network Computing RPC)를 구현하면서 다양한 시스템에 적용되기 시작했습니다. 이 시기에 등장한 대표적인 구조가 바로 클라이언트-서버 아키텍처입니다.
클라이언트(Client) : 요청(Request)을 보내는 측. 서버(Server) : 요청을 받아 응답(Response)을 처리하는 측.
RPC는 이 구조 안에서 클라이언트가 서버의 함수를 호출하고 결과를 받는 방식으로 작동합니다. 이때 통신은 일반적으로 요청-응답(request-response) 패턴을 따릅니다.
1.1.5. 데이터베이스(Database)의 등장
컴퓨터가 단순한 계산을 넘어서 다양한 작업을 처리하게 되면서, 사람들은 더 많은 데이터를 더 빠르게 처리할 수는 없을까요?라는 질문을 던지기 시작했습니다. 특히 네트워크 기술이 발전하여 여러 컴퓨터가 연결되고, 원격으로 프로그램을 호출할 수 있게 되자, 하나의 서버에 데이터를 모아두고 여러 사람이 동시에 접근하여 처리하는 환경이 가능해졌습니다. 이러한 시대적 배경 속에서 등장한 것이 바로 데이터베이스 시스템(Database System)입니다.
1970년대, IBM의 연구원이었던 E.F. Codd는 데이터를 구조화된 형태로 저장하고 관리할 수 있는 관계형 데이터 모델(Relational Model)을 제안합니다. 이 모델은 데이터를 테이블(행과 열)의 형태로 구성하여, 논리적으로 쉽게 관리할 수 있도록 설계되었습니다. 이후 이러한 개념을 바탕으로 발전한 시스템이 바로 관계형 데이터베이스 관리 시스템(RDBMS)입니다.
데이터를 표 형식으로 저장합니다. SQL을 통해 데이터를 검색하고, 삽입하고, 수정하며, 삭제할 수 있습니다. IBM은 이 모델을 바탕으로 1983년, 세계 최초의 상용 관계형 데이터베이스인 IBM DB2를 출시하며 데이터베이스 시장의 문을 열었습니다.
또한, SQL(Structured Query Language)은 데이터를 조작하고 관리하기 위한 언어로, 1986년 ANSI(미국표준협회)에 의해 표준화됩니다. SQL의 표준화는 다양한 데이터베이스 시스템 간의 호환성과 통일성을 높이는 계기가 되었으며, 현재까지도 대부분의 관계형 데이터베이스에서 표준 언어로 사용되고 있습니다.
-- 예: 고객 테이블에서 이름이 'Hadoop' 이라는 고객을 조회
SELECT * FROM customers WHERE name = 'Hadoop';
이후 Oracle, MySQL, PostgreSQL 등 다양한 RDBMS가 등장하면서, 대량의 정형 데이터를 안정적으로 저장하고 처리하는 환경이 구축됩니다.
이 당시 데이터베이스는 하드웨어 자체의 성능을 늘리는 방식(Scale-Up)으로 처리량을 확장했습니다. CPU, 메모리, 디스크 등을 업그레이드하는 식이라고 볼 수 있습니다. 하지만 이 방식은 비용이 많이 들고, 일정 이상으로는 확장이 어렵다는 단점이 극명했습니다.
이후 하둡이라는 분산 시스템을 사용하게 된 계기가 되기도 하였으며, 현재는 샤딩(Sharding) 이라는 기법을 활용하여 Scale-Out 형태로 성능을 늘리고 있습니다.
1.1.6. 3-Tier Architecture 의 등장
초기의 웹 서비스 구조는 매우 단순했습니다. 대부분의 시스템은 모든 기능을 하나의 서버에서 처리하는 모놀리식(Monolithic) 구조를 따랐습니다. 사용자의 요청을 받고, 비즈니스 로직을 처리하고, 데이터를 저장하는 모든 작업을 하나의 서버가 전담했던 것입니다.
이 방식은 소규모 시스템에서는 효율적일 수 있지만, 시간이 지나고 사용자 수가 급증하면서 다음과 같은 한계에 직면하게 됩니다.
✏️ 사용자 수가 증가할수록 처리 성능이 급격히 저하. ✏️ 모든 기능이 한 서버에 집중되어 있어 유지보수가 어려움. ✏️ 전체 시스템의 확장이 어려움. 특정 기능만 확장하는 것이 불가능하고, 전체 서버를 업그레이드해야 함.
이러한 문제를 해결하고자 등장한 것이 바로 3-Tier Architecture(3계층 아키텍처)입니다. 1990년대 중반, 클라이언트-서버 구조가 발전함에 따라 3-Tier Architecture가 도입되었습니다. 이는 시스템을 기능별로 세 개의 계층으로 나누어 설계하는 방식입니다. 각 계층은 독립적으로 운영되며, 서로 명확한 책임을 갖습니다.
▶ 1. Presentation Tier (프레젠테이션 계층) 사용자가 직접 접하는 UI 부분이며, 웹 브라우저, 모바일 앱 등의 형태로 사용자와 상호작용을 합니다.
▶ 2. Application Tier (로직 계층) 사용자의 요청을 처리하고, 비즈니스 로직을 실행하는 핵심 계층입니다.
▶ 3. Data Tier (데이터 계층) 데이터를 실제로 저장하고 관리하는 계층입니다.
이러한 구조를 도입하면 다양한 이점을 얻을 수 있습니다. 우선, 각 계층이 담당하는 역할이 명확히 분리되므로 유지보수가 훨씬 수월해집니다. 예를 들어, UI와 비즈니스 로직, 데이터 저장 영역을 각각 독립적으로 관리할 수 있어 문제 발생 시 빠르게 원인을 파악하고 수정할 수 있습니다.
또한, 시스템 확장성도 크게 향상됩니다. 특정 기능이나 계층에 부하가 몰릴 경우, 해당 부분만 선택적으로 확장하거나 보완하면 되기 때문에 전체 시스템을 재구성하지 않아도 됩니다. 뿐만 아니라, 각 계층은 독립적으로 배포할 수 있기 때문에, 하나의 기능을 수정하거나 교체할 때 다른 계층에 영향을 주지 않고 운영을 계속할 수 있습니다.
마지막으로, RPC(Remote Procedure Call)나 전문적인 데이터베이스 시스템(DBMS)과의 연계가 용이해져 계층 간 통신이 효율적으로 이루어지고, 다양한 외부 시스템과의 통합도 훨씬 수월해집니다. 3-Tier Architecture는 오늘날 대부분의 웹 애플리케이션 아키텍처의 기본이 되었으며, 이후 등장하는 N-Tier Architecture, 마이크로서비스(MSA) 아키텍처의 기반이 되기도 합니다.
1.1.7. Web-WAS-DB 구조의 등장
3-Tier Architecture가 개념적으로 정립된 이후, 이를 실질적으로 웹 환경에서 구현한 구조가 바로 Web-WAS-DB 구조입니다. 이 구조는 각각의 역할을 담당하는 세 가지 계층으로 구성되어 있습니다.
▶ 1. Web Server(웹 서버) 사용자의 요청을 가장 먼저 받아들이는 계층입니다. HTML, CSS, JS, 이미지와 같은 정적인 콘텐츠를 처리하며, 단순한 요청은 웹 서버가 직접 응답을 반환합니다. 대표적인 웹 서버로는 Apache, Nginx 등이 있습니다.
▶ 2. WAS(Web Application Server, 웹 애플리케이션 서버) 비즈니스 로직을 수행하는 계층으로, 로그인, 회원가입, 데이터 조회, 결제 등 복잡한 처리를 담당합니다. 필요에 따라 데이터베이스와 통신하여 데이터를 가져오고, 처리 결과를 사용자에게 전달합니다. 대표적인 예로는 Tomcat, Spring Boot, JBoss 등이 있습니다.
▶ 3. Database(데이터베이스 서버) 데이터 저장과 관리를 담당하는 계층으로, 사용자 정보, 상품 정보, 로그 등 영속적인 데이터를 저장합니다. MySQL, PostgreSQL, Oracle, MongoDB 등의 시스템이 여기에 해당합니다.
실제 웹 서비스에서 발생하는 요청의 90% 이상은 정적인 콘텐츠에 대한 요청입니다. 공지사항, 이미지, 게시글 목록과 같이 변하지 않는 정보를 반복해서 요청하는 경우가 대부분입니다. 이러한 단순 요청조차 WAS와 DB를 거쳐 처리하게 되면 자원이 불필요하게 낭비되고, 응답 속도도 느려질 수 있습니다.
Web-WAS-DB 구조는 이러한 문제를 해결하기 위해 각 계층의 역할을 명확히 분리하고 있습니다. 정적인 요청은 웹 서버에서 빠르게 처리하며, WAS는 로직 처리가 필요한 요청만 담당합니다. DB는 필요한 경우에만 데이터를 조회하거나 저장하는 방식입니다.
또한 자주 요청되는 정적 응답은 캐시(Cache)로 미리 저장해두고, 동일한 요청이 반복될 경우 빠르게 응답할 수 있도록 하여 시스템의 전체 성능을 향상시킬 수 있습니다.
하지만 이 구조도 단점이 존재합니다. 모든 요청이 결국 WAS나 DB 같은 특정 계층을 거치기 때문에, 트래픽이 몰릴 경우 병목 현상이 발생하여 응답 속도가 느려질 수 있습니다. 초기에는 이러한 문제를 Scale-Up 방식, 즉 서버의 하드웨어 성능을 높이는 방법으로 해결하려 했지만, 점차 증가하는 트래픽과 복잡한 서비스 구조에는 한계가 있었습니다.
이러한 한계를 극복하기 위해 시스템은 수평 확장(Scale-Out) 방식으로 발전하게 되었습니다. WAS는 로드 밸런서를 통해 여러 서버에 요청을 분산시키며 MSA 구조로 점차 변화해 갔으며, DB는 데이터를 나누어 저장하는 샤딩(Sharding)이나 하둡과 같은 분산 시스템을 도입하여 성능과 확장성을 확보하게 되었습니다.
1.2. 기존 시스템의 한계점
위에서 설명한 내용처럼 최초의 컴퓨터는 매우 거대하고 복잡한 구조를 가지고 있었으며, 프로그램을 실행하는 과정 또한 번거롭고 어려웠습니다. 이후 컴퓨터 기술의 발전은 이러한 물리적 크기를 줄이고, 프로그램을 보다 쉽게 작성하고 실행할 수 있는 환경을 만드는 방향으로 집중되었습니다.
이러한 발전 과정 속에서 등장한 대표적인 개념이 바로 위에서 설명한 폰 노이만 아키텍처와 x86 기반의 CPU 아키텍처입니다. 이들 개념을 통해 컴퓨터의 구조와 동작 방식이 표준화되었으며, 많은 시스템이 동일한 구조를 바탕으로 동작하게 되었습니다.
컴퓨터 구조가 표준화된 이후에는 하나의 컴퓨터 내부에서 더 빠른 CPU로 교체한다거나, 더 큰 메모리로 교체하는 등, 성능을 향상시키는 방식, 즉 Scale-Up 방식으로 발전이 이루어졌습니다. 하지만 온라인 서비스가 본격적으로 확산되면서 문제가 발생하기 시작했습니다.
서비스 이용자 수가 기하급수적으로 증가하면서, 단일 컴퓨터만으로는 급증하는 트래픽과 데이터 양을 감당할 수 없게 되었습니다. 하드웨어는 시간이 지나면서 꾸준히 발전해왔지만, 그 발전 속도는 선형적이었습니다. 반면 사용자 수, 트래픽, 데이터량은 기하급수적으로 증가하였습니다. 이러한 배경에서 무어의 법칙이라는 개념이 등장하게 되었습니다.
💡 무어의 법칙 : CPU 트랜지스터 수는 약 18~24개월마다 두 배씩 증가 → 그러나 이조차도 오늘날의 요구사항을 감당하기에는 한계가 발생하였음.
이제 문제 해결의 중심은 하드웨어에서 소프트웨어로 넘어갈 수밖에 없게 되었습니다.
기존의 Scale-Up 방식은 더 좋은 하드웨어를 도입함으로써 성능을 높이는 접근이었지만, 이는 비용이 많이 들며 확장성에도 분명한 한계가 존재했습니다. 이에 따라 소프트웨어 개발자들은 보다 유연하고 확장 가능한 방식인 Scale-Out 전략을 고민하게 되었습니다.
Scale-Out은 여러 대의 시스템을 연결해 전체 성능을 높이는 전략입니다. 하지만 이 방식을 구현하려면 반드시 시스템 간 상태를 공유하지 않아야 한다는 중요한 조건이 있었습니다. 상태를 공유하게 되면 자원이 많이 소모되거나, 기술적으로 불필요한 제약이 발생할 수 있기 때문입니다.
단편적으로 살펴보면, 애플리케이션 서버(Application Server)는 로드 밸런서(Load Balancer)를 통해 전처리를 수행하고, 별도의 상태를 가지지 않도록 설계함으로써 Scale-Out 확장이 가능했습니다.
하지만 온라인 서비스의 핵심이라 할 수 있는 데이터베이스(Database)는 대량의 데이터를 공유해야 하므로, 쉽게 Scale-Out을 구현하기 어려웠습니다. 특히 Sharding 기능이 도입되기 이전까지는 데이터베이스 확장성에 큰 제약이 존재하였습니다.
따라서 데이터베이스를 중심으로 여러 대의 서버로 확장하면서도, 상태와 데이터를 효율적으로 공유할 수 있는 구조가 요구되었습니다. 이러한 요구에 따라 분산 시스템의 필요성이 점차 부각되기 시작했습니다.
분산 시스템은 각 서버가 독립적으로 동작하면서도, 필요한 데이터를 공유하고 일관성을 유지할 수 있도록 설계되어야 합니다. 이와 같은 필요를 충족하기 위해 다양한 분산 시스템 기술들이 발전하였으며, 이는 오늘날 대규모 온라인 서비스를 구성하는 데 있어 필수적인 아키텍처로 자리 잡게 되었습니다.
2. 분산 시스템의 등장
2.1. 분산 시스템이란
분산 시스템이란 여러 대의 컴퓨터(노드)가 네트워크를 통해 연결되어, 마치 하나의 시스템처럼 동작하도록 구성된 시스템을 말합니다. 이러한 시스템은 각 노드가 독립적으로 작업을 수행하면서도, 전체적으로는 하나의 통합된 서비스를 제공하도록 설계되어 있습니다.
즉, 단일 시스템의 한계를 극복하고, 확장성과 신뢰성, 고가용성을 확보하기 위해 사용되는 아키텍처입니다. 서버, 저장소, 네트워크 등 다양한 자원이 여러 위치에 분산되어 있음에도 불구하고, 사용자에게는 하나의 일관된 시스템처럼 보이는 것이 분산 시스템의 핵심입니다. 분산 시스템은 현대의 대규모 온라인 서비스, 클라우드 컴퓨팅, 빅데이터 처리 등 다양한 분야에서 필수적인 기반 기술로 활용되고 있습니다.
2.2. 분산 시스템의 기본적인 특징
분산 시스템은 반드시 아래와 같은 특징을 가져야 합니다. 우리가 알고 있는 분산 시스템들이 아래와 같은 특징을 가지고 있는지 고민하면서 보면 좋습니다.
2.2.1. Concurrency
동시성을 의미합니다. 클라이언트의 작업 요청을 여러 대의 분산된 컴퓨터에서 동시에 수행 할 수 있어야 하며, 동시 실행 자원을 늘려서 처리량을 늘릴 수 있다는 강점을 의미합니다.
2.2.2. No Global Clock
시스템의 각 부분이 비동기식으로 동작함을 의미합니다. 즉, 어떤 부분의 상태 때문에 다른곳에서 Lock 이 걸리거나 병목현상이 걸리지 않습니다.
2.2.3.Independent Failure
여러 시스템 중 하나가 다운되더라도 나머지 시스템이 정상적으로 작동하여, 작업을 수행 할 수 있어야 함을 의미합니다. 쉽게 풀어서 이야기하면, 시스템 하나가 문제가 발생했다고 하여, 전체 시스템에 영향이 가서는 안된다는 이야기입니다.
2.3. 분산 시스템 이론
2.3.1 BASE 이론
현대의 대규모 분산 시스템에서는 데이터의 일관성보다는 가용성과 성능이 더 중요해지는 경우가 많습니다. 이러한 요구를 충족하기 위해 등장한 개념이 바로 BASE 원칙입니다. BASE는 전통적인 관계형 데이터베이스에서 사용하는 ACID 원칙과 대비되는 개념으로, 특히 NoSQL 데이터베이스에서 자주 사용되는 설계 철학입니다.
1️⃣ BASE의 요소 BASE는 다음의 세 가지 핵심 요소로 구성되어 있습니다.
▶ Basically Available (기본적인 가용성) 시스템 전체가 완전히 중단되는 일은 없도록 보장합니다. 일부 노드에 장애가 발생하더라도 전체 시스템은 계속 동작하며, 최소한의 기능은 유지됩니다. 이를 위해 데이터 복제를 수행하며, 동일한 데이터를 여러 노드에 분산하여 저장합니다.
▶ Soft State (유연한 상태) 데이터의 상태가 항상 일관적이지 않을 수 있음을 의미합니다. 특정 시점에서 조회한 데이터와 이후 시점의 데이터가 다를 수 있으며, 이에 대한 일관성 유지 책임은 시스템이 아닌 사용자 또는 클라이언트 애플리케이션에 있습니다. 예를 들어, Hadoop에서는 데이터를 Write한 직후 복제가 0.0001초만에 동시에 이루어지지 않기 때문에, 복제가 완료되기 전의 시점에서는 일부 노드에 최신 데이터가 존재하지 않을 수 있습니다.
▶ Eventually Consistent (최종적인 일관성) 모든 노드가 즉시 동일한 데이터를 가지지는 않지만, 시간이 지나면 결국 일관된 상태로 수렴하게 됩니다. 약간의 지연은 있을 수 있으나, 데이터는 결국 저장되고 조회가 가능해집니다. 위의 Hadoop 예시를 이어보면, Write와 동시에 복제가 이루어지지는 않지만, 내부 정책에 따라 복제가 완료되며, 결국 모든 노드가 동일한 데이터를 가지게 됩니다.
2️⃣ BASE의 특징 BASE는 관계형 데이터베이스에서 보장하는 ACID 원칙과는 정반대의 방향을 지향합니다. ACID는 트랜잭션의 원자성, 일관성, 고립성, 지속성을 강조하며, 은행 시스템과 같이 정합성이 중요한 업무에 적합합니다. 반면 BASE는 즉각적인 일관성(immediate consistency)을 포기하고, 대신 높은 가용성과 성능, 확장성을 추구합니다.
결과적으로 BASE는 사용자 경험을 우선시하는 시스템, 예를 들어 SNS, 실시간 광고 시스템, 대규모 로그 분석 플랫폼 등에 적합한 방식입니다.
3️⃣ BASE의 사례 Facebook 광고 플랫폼의 리포트 조회 사례를 통해 BASE 원칙을 이해할 수 있습니다. 사용자가 광고 리포트를 조회하면 다음과 같은 데이터를 확인할 수 있습니다.
💡 서울 지역 노출된 광고 총 10,000 건 그 중, 1,000 건이 타겟팅되었고, 이 중 남성은 100 명
그러나 10분 후 다시 조회하면 결과가 조금 달라질 수 있습니다.
💡 서울 지역 노출된 광고 총 10,000 건 동일 그 중, 1,060 건이 타겟팅되었고, 이 중 남성은 102 명으로 늘어남
이는 데이터가 점진적으로 수렴하고 있다는 사실을 보여줍니다. 즉, 처음에는 완전한 일관성이 없더라도 시간이 지나면 전체 데이터가 정확히 반영된다는 BASE 원칙의 Eventually Consistent를 반영한 예시입니다.
마케터는 처음 조회한 데이터를 기반으로 노출 : 타겟팅 : 남자 = 100 : 10 : 1이라는 성과를 측정하고 전략을 수립합니다. 이후 데이터가 갱신되더라도, 사용자는 이를 바탕으로 전략을 유연하게 조정할 수 있습니다.
2.3.2 CAP 이론
분산 시스템을 설계하다 보면 반드시 고려해야 할 개념이 있습니다. 바로 CAP 정리(CAP Theorem)입니다. 이 이론은 분산 시스템에서 동시에 충족시키기 어려운 세 가지 속성을 정의하며, 실제 시스템 설계 시 무엇을 선택하고 어떤 속성을 포기할지를 결정하는 기준이 됩니다.
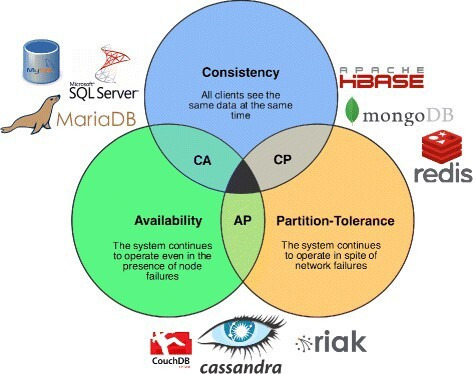
출처 : CAP Image 출처
1️⃣ CAP의 세 가지 요소 CAP은 아래의 세 가지 요소로 구성되어 있습니다.
▶ Consistency (일관성) 모든 노드가 항상 동일한 데이터를 반환해야 한다는 개념입니다. 여러 클라이언트가 동시에 동일한 요청을 하더라도 같은 응답을 받아야 하며, 이는 데이터의 정합성을 유지하는 데 필수적인 속성입니다. 여기서 말하는 일관성은 ACID 원칙에서의 C(Consistency)와는 다릅니다. ACID의 일관성은 트랜잭션의 무결성을 의미하는 반면, CAP의 일관성은 분산된 시스템 내 모든 노드 간의 데이터 동기화를 의미합니다.
▶ Availability (가용성) 시스템의 일부 구성 요소에 장애가 발생하더라도 전체 서비스는 중단되지 않고 응답이 가능해야 한다는 개념입니다. 즉, 사용자가 언제 어떤 요청을 하더라도 시스템은 반드시 응답을 반환해야 합니다.
▶ Partition Tolerance (분할 내성) 노드 간의 네트워크가 단절되더라도 시스템이 계속 작동할 수 있어야 한다는 개념입니다. 분산 시스템에서는 네트워크 장애가 불가피하게 발생하므로, 이를 견딜 수 있는 구조를 갖추는 것이 필수입니다.
❗ CAP 정리의 핵심 : 세 가지 중 두 가지만 선택할 수 있음. 이론적으로 하나의 시스템이 세 가지 속성을 모두 완벽히 충족시키는 것은 불가능 함. 현실적으로는 대부분 Availability를 확보해야 하므로, CA, AP 중에서 선택.
2️⃣ CA 시스템
CA(일관성과 가용성) 시스템은 네트워크에 문제가 없다는 전제 하에, 일관성과 가용성을 모두 만족시키는 시스템입니다.
하지만 이 시스템은 Partition Tolerance, 즉 네트워크 분할 상황에서는 정상적으로 동작하지 않습니다.
이러한 특성 때문에 CA 시스템은 주로 단일 노드 또는 파티션이 발생하지 않는 환경에서 사용됩니다.
즉, CA는 분산시스템에서 선택할 수는 없습니다.
( 전통적인 RDBMS, 단일 노드에서의 MongoDB 등 )
3️⃣ AP 시스템
AP(가용성과 분할 내성) 시스템은 만약, 분산 환경에서 두 노드 간의 네트워크가 중단되었을 때, 데이터가 일관되도록 완벽히 보장할 수는 없을지라도 모든 요청은 결과를 반환해 가용성을 보장하고 시스템은 계속 동작할 수 있게 해야하는 시스템입니다.
모든 노드가 요청에 응답하기 때문에 시스템은 가용성을 보장하게 됩니다. 그리고 동시에 시스템은 계속 동작하므로 Partition Tolerance도 함께 보장할 수 있습니다.
하지만 데이터는 일관되지 않기 때문에 동일한 내용의 요청일지라도 다른 데이터를 가지고 있기에, 응답은 다를 수 있으므로 데이터의 일관성을 항상 보장할 수 없습니다.
( Cassandra, HBase, Druid 등 )
4️⃣ CP 시스템 CP 시스템은 네트워크에 문제가 생겨 노드 간의 연결이 단절되더라도, 데이터의 일관성을 보장하고 시스템이 계속 동작할 수 있도록 설계된 구조입니다. 이러한 시스템은 가용성을 일부 포기하는 대신, 데이터가 항상 정확하게 유지되도록 합니다.
예를 들어, A 노드에서 쓰기 요청을 막아버리는 방식으로 일관성을 유지할 수 있습니다. 이렇게 되면 가용성은 낮아지지만, 일관성과 분할 허용성은 보장됩니다. 네트워크가 복구된 후에는 각 노드 간의 데이터 동기화가 반드시 수행되어야 하며, 이를 통해 전체 시스템의 일관성을 회복하게 됩니다.
MongoDB는 기본적으로 Primary 노드에서 모든 쓰기를 처리하고, 이후 Secondary 노드로 복제합니다. 이를 통해 일관성을 유지할 수 있습니다.
단, 가용성을 높이기 위해 Secondary 노드를 읽기 전용으로 활용하면, 복제 지연으로 인해 일관성이 약해질 수 있습니다
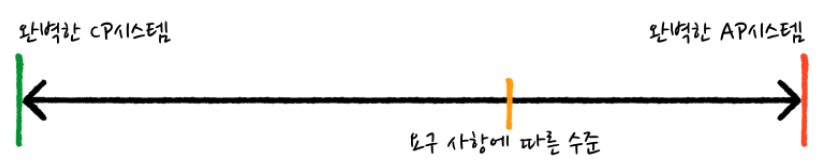
5️⃣ CAP 이론의 한계 CAP 이론은 분산 시스템에서 Consistency(일관성), Availability(가용성), Partition Tolerance(분할 허용성) 중 두 가지만 보장할 수 있다는 이론입니다. 하지만 현실적으로는 완벽한 CP 또는 완벽한 AP 시스템이 존재하기 어렵습니다.
첫 째로, 완벽한 CP 시스템은 이상적일 뿐입니다. 완벽한 일관성을 보장하는 CP 시스템은 하나의 트랜잭션이 모든 노드에 복제된 후에야 완료됩니다. 이러한 방식은 높은 일관성을 보장할 수 있지만, 가용성과 성능을 희생해야 합니다. 만약 일부 노드에 장애가 발생한다면, 트랜잭션은 무조건 실패하게 됩니다. 또한 노드 수가 증가할수록 지연 시간도 길어지게 됩니다. 이처럼 강한 일관성을 추구하다 보면, 오히려 분산 시스템을 사용할 이유가 사라집니다.
둘 째로, 완벽한 AP 시스템 역시 한계가 있습니다. 완벽한 가용성을 보장하는 AP 시스템은 모든 노드가 어떤 상황에서도 응답을 보장해야 합니다. 예를 들어, 하나의 노드가 네트워크 분할로 인해 고립된 상황을 생각해봅시다. 고립된 노드는 다른 노드와 데이터를 동기화할 수 없으므로 일관성이 깨질 수 있습니다. 그럼에도 불구하고 이 노드가 계속해서 응답한다면, 일시적으로는 완벽한 가용성을 갖는 것처럼 보입니다. 하지만 이런 노드에 연결된 사용자는 일관성이 깨진 데이터를 계속 보게 될 수 있으며, 이는 상용 시스템에서는 치명적인 문제가 될 수 있습니다.
즉, 이 안에서 Trade Off 관계를 명확히 이해하고, 균형을 맞춘 설계가 필요합니다. 완벽한 CP 또는 AP는 현실적인 설계가 아닙니다. 네트워크 분할(Partition)은 언제든지 발생할 수 있다는 전제를 가지고, CP와 AP 사이에서 균형점을 찾는 것이 중요합니다. 많은 분산 데이터베이스는 실제로 AP 쪽에 비중을 두고 설계되고 있으며, 시스템 요구사항에 따라 적절한 트레이드오프가 필요합니다.
강한 일관성을 추구할수록 Strong, 약한 일관성을 추구할수록 Weak하다고 표현합니다. 단, 많은 분산형 데이터베이스는 AP 쪽에 더 많은 비중을 둡니다.
출처 : CP 와 AP
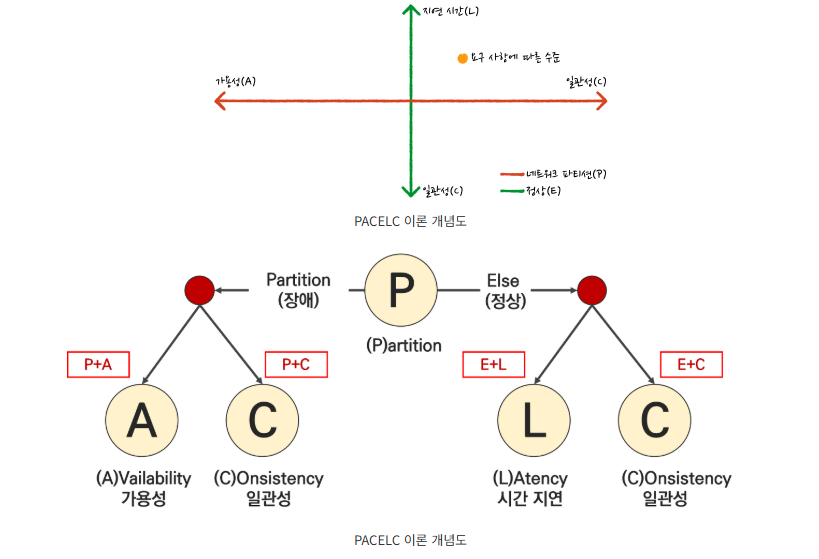
2.3.1 PACELC 이론
출처 : PACELC 이론
CAP 이론의 한계에 따라 실제 운영을 반영한 이론입니다. 분산된 환경에서 장애가 발생한(Partition) 경우, 가용성(Availability)과 일관성(Consistency)을 고려해야하고 정상 상황의 경우(Else), 지연시간(Latency)과 일관성(Consistency)를 고려해야한다는 이론입니다.
좀 풀어서 설명하면, 장애 상황에서는(Partition), 일부 노드에 접근이 불가능한 경우가 발생합니다. 이러한 상황에서는 데이터를 일관되게 반영할 수 없다면, 아예 반영 자체를 실패하게 만들어 일관성을 보장해야 한다(Consistency). 또는, 접근 가능한 노드에만 데이터를 반영하여 가용성을 보장할 수도 있다(Availability). 정상 상황에서는(Else), 모든 노드에 일관성 있게 데이터를 반영하고 지연 시간이 늘어나는 것을 감수하여 일관성을 보장할 수 있다(Consistency). 반대로, 빠르게 응답하기 위해 지연 시간을 줄이고 일관성을 일부 포기하여 낮은 지연 시간을 보장할 수도 있다(Latency).
이 안에서 조합을 하는 것입니다.
| 장애 상황 | 정상 상황 | 설명 |
|---|---|---|
| P + A (장애 상황 + 가용성) | E + L (정상 상황 + 지연 시간) | 장애 상황에서는 가용 노드만 기능을 제공하고, 정상 상황에서는 지연 시간을 최적화하는 것을 우선적으로 고려하는 시스템. |
| P + A (장애 상황 + 가용성) | E + C (정상 상황 + 일관성) | 장애 상황에서는 가용 노드만 기능을 제공하고, 정상 상황에서는 지연 시간이 증가하더라도 일관적인 데이터를 보장하는 시스템. |
| P + C (장애 상황 + 일관성) | E + L (정상 상황 + 지연 시간) | 장애 상황에서는 데이터에 일관성을 보장하고, 정상 상황에서는 지연 시간을 최적화하는 것을 우선적으로 고려하는 시스템. |
| P + C (장애 상황 + 일관성) | E + C (정상 상황 + 일관성) | 장애 상황에서도, 정상 상황에서도 데이터의 일관성을 보장하는 시스템. |
해당 표를 조금 더 풀어서 설명해보겠습니다.
PA/EL 장애상황에서 조금 느려질 수 있지만, 좀 멀리있는 가용 노드만으로도 어떻게든 서비스를 계속 제공합니다. 이 과정에서 일관성은 깨질 수 있습니다. 정상상황에서는 가장 가까운 서버에서 빠른 응답을 받을 수 있도록 합니다. 단, 아직 모든 분산 시스템에 업데이트가 되지 않을 수 있기 때문에 경우에 따라 가장 최신 정보를 가져오지 않을 수 있습니다.
PA/EC 장애상황에서 조금 느려질 수 있지만, 좀 멀리있는 가용 노드만으로도 어떻게든 서비스를 계속 제공합니다. 이 과정에서 일관성은 깨질 수 있습니다. 정상상황에서는 데이터 동기화로 조금 느릴 수 있지만, 일관성있는 데이터를 조회 할 수 있습니다.
PC/EL 장애상황에서는 남은 가용 노드 안에서 일관성을 최대한 유지하고 서비스를 제공합니다. 단, 일관성을 유지할 수 없는 상황이라면 트랜잭션을 거절할 수도 있으며, 장애 서버가 복구 될 때까지 기다려야 할 수도 있습니다. 정상상황에서는 가장 가까운 서버에서 빠른 응답을 받을 수 있도록 합니다. 단, 아직 모든 분산 시스템에 업데이트가 되지 않을 수 있기 때문에 경우에 따라 가장 최신 정보를 가져오지 않을 수 있습니다.
PC/EA 장애상황에서는 남은 가용 노드 안에서 일관성을 최대한 유지하고 서비스를 제공합니다. 단, 일관성을 유지할 수 없는 상황이라면 트랜잭션을 거절할 수도 있으며, 장애 서버가 복구 될 때까지 기다려야 할 수도 있습니다. 정상상황에서는 데이터 동기화로 조금 느릴 수 있지만, 일관성있는 데이터를 조회 할 수 있습니다.
예시를 들면, MongoDB는 PA/EC 시스템입니다. 분산 환경에서 장애가 발생하면 쓰기를 중단하고 읽기만 가능하게 만들기 때문이며, 정상 상황에서는 Secondary 멤버와 Primary 멤버 간의 데이터 일관성을 보장하기 때문입니다.
여기서, 장애가 발생하면 쓰기가 중단되는 것을 조금 더 설명하자면 mongoDB의 automatic failover 때문. 'electionTimeoutMillis' 이라는 설정값만큼 timeout을 적용해, 이 timeout 시간 내에 Primary 노드가 다른 구성원과 소통하지 않으면 클러스터는 가지고 있는 Secondary 노드 중 하나를 Primary 노드로 만듭니다. Secondary 노드 중 하나를 Primary 노드로 만드는 election 과정 중에는 쓰기 작업이 중단됩니다.
또 다른 예시로는 Cassandra나 DynamoDB는 PA/EL 시스템이라는게 있습니다. 장애 상황에서는(P) 정상인 노드에만 데이터를 읽고 쓰고(A), 장애 노드가 복구된다면 그때 데이터를 반영합니다. 또한 정상 상황에서는(E) 빠른 응답을 위해서 모든 노드 전체에 다 데이터를 읽고 쓰지는 않습니다(L).
결국은 요구사항이나, 상황에 따라 Trade-Off 를 명확히 이해하여 기술을 활용하는 것이 좋습니다.
2.4. 분산 시스템 구축 시 고려해야 할 부분
2.4.1. Heterogeneity (이질성)
분산 시스템은 구축함에 있어서 최대한 이질성을 고려해야 합니다. 왜냐하면 서로 다른 시스템에 설치를 할 수 있어야하고, 서로 다른 시스템 사이에 정보와 자원을 공유해야 할 수도 있습니다. 이는 네트워크,OS,하드웨어,프로그래밍 언어 등이 있습니다. 좋은 방법으로는, 하드웨어나 OS 에 관계없이 일관된 개발을 위한 언어인 Java 나 Scala, Go 언어등을 사용하는 것이 좋으며, 필요시에는 원하는 추상화를 이룰 수있는 Middleware 를 사용하는 것도 좋습니다. (CORBA 나 RMI 등)
💡 예시 ✔️ Apache Hadoop Hadoop은 리눅스, Windows, macOS 등 다양한 OS에서 동작할 수 있으며, 다양한 하드웨어 환경에서도 실행 가능합니다. 또한 Java 기반으로 작성되어 있어 플랫폼 독립성이 뛰어나고, 다양한 클러스터 환경에 쉽게 이식 가능합니다.
2.4.2. Openess
시스템을 다양한 방식으로 확장성(extended, 덧붙임), 재구현(reimplemented)할 수 있는지 여부를 의미합니다.
💡 예시 ✔️ 마이크로소프트사에서 plug and play 개념→ Interface만 정해서 공표를 하고 나면 거기에 해당하는 소프트웨어 회사나 하드웨어 회사들이 이런 Interface에 근거를 해서 뭔가를 개발하면 Windows운영체제에서 그대로 돌아간다는 개념
2.4.3. Security
권한이 없다면 공개조차 불가, 허가되지 않은 방식으로 데이터 변경 불가, 권한이 있다면 시스템 접근 가능 분산 시스템은 위와 같은 보안 요구사항을 만족해야 합니다.
💡 예시 ✔️ Kerberos + Hadoop Hadoop 클러스터에 Kerberos 인증을 적용하면, 각 사용자와 서비스는 정해진 권한을 가진 토큰을 통해 접근이 가능하며, 인증되지 않은 사용자는 데이터에 접근할 수 없습니다.
2.4.4. Scalability
분산 시스템은 사용자 수나 시스템 자원의 증가에 따라 성능 저하 없이 확장 가능해야 합니다. 보통 수평 확장(horizontal scaling) 방식을 선호합니다. 서버들을 증가 시키더라도 더 이상 performance가 늘어나지 않는다면, 더 이상의 확장성은 없다고 볼 수 있습니다. 즉, 확장성 좋은 시스템을 설계하자는 의미입니다.
2.4.5. Failure Handling
분산시스템도 어쨌든 시스템이기 때문에 장애나 실패를 피할 수는 없습니다. 이러한 장애/실패에 대한 대응을 (자동화된 방식으로) 할 수 있어야 함을 의미합니다. 고장 감지 ▶ 고장 완화 ▶ 고장 허용 ▶ 고장 복구 ▶ 중복성
이렇게 다섯 단계로 진행됩니다. 예를 들면, 체크섬을 통해 데이터가 손상됐는지 수시로 확인하고, 고장이 발생했다면 해당 작업을 재전송 하거나, 복원하는 방법으로 고장을 완화할 수 있습니다.(RAID) 이후, 다른 노드를 통해 전체 시스템을 유지하면서 고장을 허용하고, Rollback 이나, 다른 방법을 통해 고장한 결험을 복구합니다. 마지막으로 다양한 경로와 복제를 통해 고장 발생 시 대응 할 수 있어야 합니다.
💡 예시 ✔️ Spark의 Stage 재시도 메커니즘 Spark 작업 수행 중 일부 Executor가 실패하더라도, 해당 Task만 재시도하여 전체 Job을 중단시키지 않습니다.
2.4.6. Concurrency
여러 사용자가 동시에 하나의 자원을 공유하는 상황에서 발생하는 문제를 해결해야 합니다.
여러 클라이언트가 동시에 접근해도 자원이 일관된 상태를 유지해야 하며, 병렬 처리를 통해 효율성을 높이고, shared resource는 자신의 상태를 명확히 표현할 수 있어야 합니다. 또한 리소스는 일관성(consistency) 있는 방식으로 동기화(synchronization) 되어야 합니다.
💡 예시 ✔️ ZooKeeper ZooKeeper는 여러 분산 시스템에서 동기화된 설정 관리, 리더 선출, 락(lock) 등을 제공하여 동시성 문제를 해결합니다.
2.4.7. Transparency
사용자가 분산 시스템의 내부 구조나 동작 방식을 인식하지 못하도록 만들어야 합니다. 이를 투명성이라고 하는데, 분산 시스템 이론에는 다양한 종류의 투명성이 존재합니다.
- ✏️ 접근 투명성 : 로컬/원격 자원을 동일한 방식으로 접근합니다.
- ✏️ 위치 투명성 : 자원의 물리적 위치(IP, 위치 등)와 무관하게 접근합니다.
- ✏️ 동시성 투명성 : 여러 프로세스가 공유 자원을 문제 없이 사용할 수 있도록 합니다.
- ✏️ 복제 투명성 : 자원의 복제 유무와 상관없이 동일하게 사용 가능합니다.
- ✏️ 장애 투명성 : 장애 발생 시 사용자/애플리케이션이 이를 인지하지 않도록 처리합니다.
- ✏️ 이동 투명성 : 자원이나 클라이언트의 위치 이동이 시스템 동작에 영향이 없습니다.
- ✏️ 성능 투명성 : 부하에 따라 시스템 재구성이 가능합니다.
- ✏️ 확장 투명성 : 시스템 규모가 확장되어도 구조나 알고리즘 변경 없이 운영이 가능합니다.
💡 예시 ✔️ Cloud Storage (ex : Amazon S3) 사용자는 객체가 어느 리전에 저장되어 있는지 몰라도 되고, 필요 시 언제든지 리소스를 추가할 수 있어 성능/확장/위치 투명성을 모두 제공합니다.
2.5. 분산 시스템 USE CASE 몇 가지
2.5.1. 분산 저장소
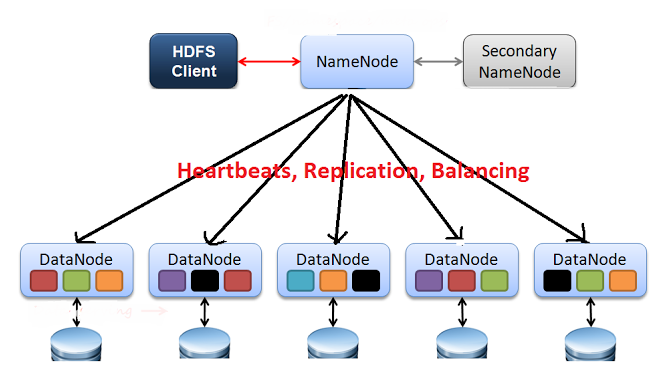
출처 : 하둡 아키텍처
대용량의 분산시스템이 가장 필요한 곳이 저장소입니다. 대량의 데이터를 나누어서 저장하면서도 유실되면 안되고, 언제든지 조회가 가능해야 했습니다. 대표적으로 우리가 앞으로 알아볼 Hadoop 이 있습니다.
2.5.2. Load Balancer
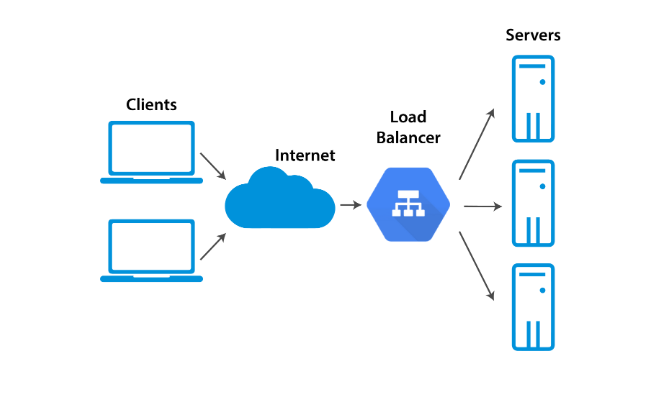
출처 : 로드 밸런서
과거의 로드밸런서는 하나 또는 두 개의 고성능 하드웨어 장비나 스위치로 로드밸런싱을 처리했습니다. 하지만 현대의 로드밸런서는 인스턴스가 수백에서 수천 대까지 연결되므로 하나의 고스펙 하드웨어로 모든 로드밸런싱을 처리할 수 없습니다. 또한, 설정이나 규칙의 변경이 잦고 그 복잡도가 높아졌습니다.
따라서 AWS, Azure와 같은 클라우드 서비스에서 선택하는 로드밸런서는 모두 소프트웨어 로드밸런서입니다. 외부에 노출되는 IP 주소나 DNS 주소는 하나이지만, 내부적으로는 HA(High Availability)를 위해 여러 서버와 스위치로 구성되어 있습니다. 또한, 실시간 설정 반영을 위한 동기화 시스템도 구축되어 있습니다.
2.5.3. 분산 메시지 큐
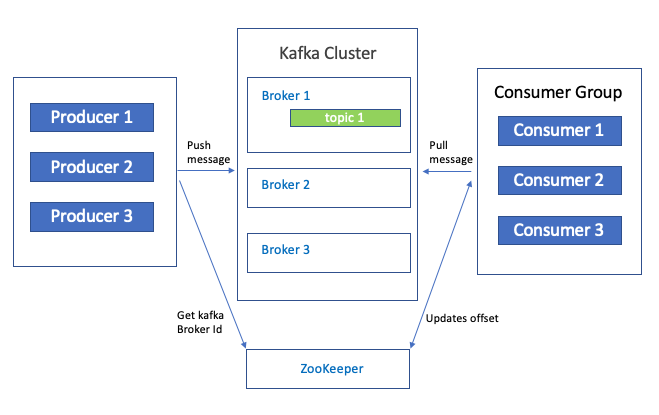
출처 : 분산 메시지 큐 - 카프카
Queue라고 하면 FIFO(First In First Out)가 가능해야 하므로, 순서가 보장되어야 합니다. Queue는 하나만 존재할 수밖에 없습니다. 하지만 하나의 Queue로는 물리적으로 처리량에 한계가 있으므로, 하나의 주제에 대해 여러 개의 Queue를 두어 처리량을 늘릴 수 있는 구조가 만들어졌습니다. 이 구조를 대표하는 예가 Kafka입니다.
Kafka에서는 하나의 Topic(논리적 Queue)이 여러 개의 Partition(물리적 Queue)으로 구성됩니다. 각 Partition별로는 순서를 보장할 수 있지만, 전체 Topic에 대해서는 순서를 보장할 수 없습니다. 만약 전체 Topic의 순서를 보장하려 한다면, 처리량 손해를 감수해야 합니다.
3. 하둡의 등장과 개요
기술의 이해는 History 를 파악하는게 중요하다는 생각이 들었고, 그렇기 때문에 기본 시스템의 역사부터 분산 시스템까지 알아보았습니다.
분산 시스템 의 개념이 이해되었다면, 이제 본격적으로 하둡에 대해서 알아보겠습니다.
출처 : Apache-Hadoop
3.1. 하둡의 등장 배경
온라인 서비스와 데이터 처리 기술이 발전함에 따라, 우리가 다루어야 할 데이터의 양과 종류는 폭발적으로 증가했습니다. 기존에는 주로 정형 데이터를 다뤘기 때문에 RDBMS에 저장하여 관리하는 것이 일반적이었습니다. 하지만 웹 로그, 이미지, 영상 파일과 같은 비정형 데이터가 많아지면서, 기존 RDBMS로 모든 데이터를 저장하고 처리하기에는 여러 한계가 드러났습니다.
우선 비정형 데이터는 크기가 방대하여, RDBMS에 저장하려면 고성능, 고비용의 장비가 필요했습니다. 또한 비정형 데이터의 경우, RDBMS가 제공하는 복잡한 기능들(트랜잭션 관리, 복잡한 쿼리 등)을 굳이 사용할 필요도 없었습니다. 결국, 자주 사용하지 않는 대용량 데이터를 저장하기 위해 RDBMS를 무작정 확장하는 것은 비용 대비 효율이 매우 낮은 선택이 되었습니다.
이러한 문제를 해결하기 위해 등장한 것이 바로 하둡(Hadoop)입니다. 하둡은 값비싼 전용 서버가 아닌, 범용 x86 리눅스 서버(Commodity Server)에서도 설치하고 운용할 수 있습니다. 데이터 양이 늘어나더라도 단순히 서버 노드를 추가하는 것만으로 쉽게 확장할 수 있으며, 이를 위해 별도의 재설치나 복잡한 재구성이 필요하지 않은 점이 큰 장점입니다.
하둡은 데이터의 복제본을 여러 서버에 저장하기 때문에, 서버나 디스크에 장애가 발생하더라도 데이터 복구가 가능합니다. 또한 데이터가 여러 서버에 분산 저장되어 있기 때문에, 데이터 처리를 병렬로 수행할 수 있습니다. 이로 인해 기존 방식보다 훨씬 뛰어난 성능 향상을 기대할 수 있습니다.
실제로, 2008년, 뉴욕타임즈(New York Times)는 약 130년 분량에 해당하는 신문 기사 1,100만 페이지를 디지털화하는 프로젝트를 진행했습니다. 이 작업에는 AWS의 EC2, S3, 그리고 하둡을 활용했습니다. 결과는 놀라웠습니다. 이 방대한 작업을 단 하루 만에 완료했으며, 소요된 비용은 약 200만 원에 불과했습니다. 당시 기존 서버와 일반 병렬 처리 기술로 작업을 수행했을 경우, 무려 14년이 걸렸을 것이라 예상되었습니다.
출처 : 뉴욕타임즈 하둡 사례 이미지
3.2. 하둡이란
하둡을 한 문장으로 정의하면, 하나의 성능 좋은 컴퓨터를 이용하여 데이터를 처리하는 대신 적당한 성능의 컴퓨터 여러 대를 클러스터화하고 큰 크기의 데이터를 클러스터에서 병렬로 동시에 처리하여 처리 속도를 높이는 것을 목적으로 하는 분산처리를 위한 오픈소스 프레임워크 라고 정의 할 수 있습니다. 데이터의 규모가 기가바이트에서 페타바이트에 이르는 대규모 데이터 세트를 효율적으로 저장 및 처리하는 데 사용되며, 하나의 대형 컴퓨터를 사용하여 데이터를 저장 및 처리하는 대신 Hadoop을 사용하면 여러 컴퓨터를 함께 클러스터링하여 대량의 데이터 세트를 병렬로 분석할 수 있습니다.
또한 여러가지 실행 엔진, 프로그래밍 및 데이터 처리 엔진 등, 하둡 생태계 전반을 포함하는 의미로 확장 & 발전 되어왔습니다.
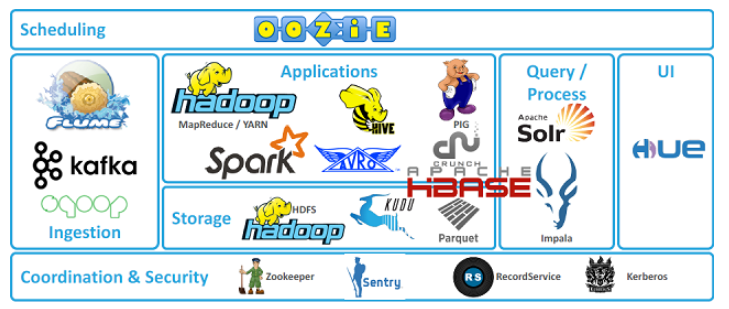
출처 : 하둡 생태계 이미지
다음 포스팅에서 좀 더 자세히 다루겠지만, 하둡의 기본 메커니즘은 데이터가 들어오면, 그 데이터를 쪼개고 분리하여 저장하는 개념입니다. 쪼개서 저장한 데이터가 어느 노드에 위치하였는지를 알 수 있는 메타 데이터 또한 있으며, 해당 데이터를 복제하여 다른 노드에 저장함으로써, Replication 도 보장해줍니다. 이러한 내용을 필두로, 하둡의 주요 특징들을 살펴보면 다음과 같습니다.
✅ 확장성 → 하둡은 페타바이트(PB) 단위의 데이터를 신뢰성 있게 저장하고 처리할 수 있도록 설계되었습니다. 필요에 따라 서버 노드를 추가함으로써 시스템을 수평적으로 확장할 수 있습니다.
✅ 경제성 → 고가의 전용 서버 대신 범용 리눅스 서버(Commodity Server)를 사용하여 데이터와 연산을 분산 처리합니다. 이러한 범용 서버를 수천 대까지 클러스터링하여 운영할 수 있어 초기 투자 비용이 낮고 경제적입니다.
✅ 효율성 → 데이터를 저장한 서버에서 직접 연산을 수행(Data Locality)함으로써, 불필요한 네트워크 전송을 줄이고 빠른 병렬 처리를 가능하게 합니다. 이를 통해 대용량 데이터도 빠르게 처리할 수 있습니다.
✅ 신뢰성 → 하둡은 데이터를 자동으로 여러 복제본으로 저장하며, 서버나 디스크 장애가 발생하더라도 작업을 자동으로 재배치하여 복구할 수 있도록 설계되어 있습니다. 이는 시스템 전체의 높은 신뢰성과 가용성을 보장합니다.
또한 이러한 특징을 유지하기 위하여 하둡은 다음과 같은 네 가지 주요 모듈을 가지고 있습니다.
✅ HDFS → 표준 또는 저사양 하드웨어에서 실행되는 분산 파일 시스템입니다. HDFS 는 높은 내결함성과 대규모 데이터 세트에 대한 저장 및 처리를 담당합니다.
✅ YARN → 클러스터 노드 및 리소스 사용을 관리하고 모니터링합니다. 이를 통해 작업 및 Task 를 관리하고 Scheduling 을 합니다. ( Version 2부터 추가 )
✅ MapReduce → 프로그램에서 데이터에 대한 병렬 계산을 수행하는 데 도움이 되는 프레임워크입니다. Map Task 는 입력 데이터를 가져와 키 값 페어로 계산 할 수 있는 데이터 세트로 변환합니다. Map Task 의 출력은 Reduce Task 를 통하여 출력을 집계하고 원하는 결과를 제공합니다.
✅ Hadoop Common → 모든 모듈에서 사용 할 수 있는 공통 Java 라이브러리를 제공합니다.
해당 모듈들에 대하여서는, 다음 포스팅에서 보다 자세하게 알아 볼 예정입니다.
3.3. 하둡 아키텍처와 Version 별 특징
3.3.1. Hadoop v1.0
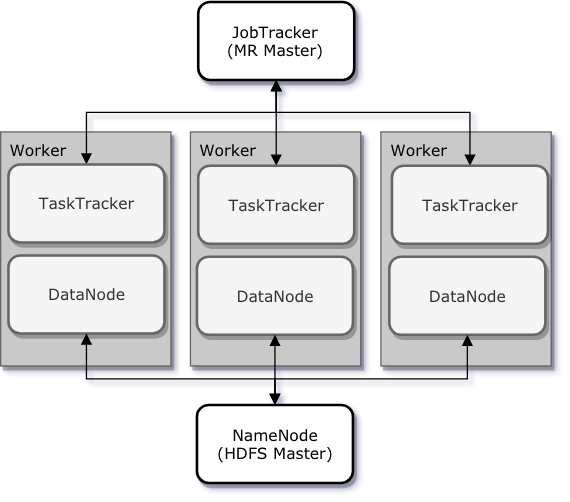
출처 : 하둡 V1 아키텍처
하둡(Hadoop) v1은 2011년에 정식으로 발표된 분산 데이터 처리 프레임워크입니다. 하둡 v1은 대규모 데이터를 효율적으로 저장하고 처리할 수 있도록 분산 저장과 병렬 처리라는 두 가지 핵심 기능을 제공합니다.
먼저, 분산 저장은 하둡의 NameNode와 DataNode가 담당합니다. NameNode는 하둡 파일 시스템(HDFS) 내에서 파일들의 메타데이터를 관리하는 역할을 합니다. 파일이 어떤 블록으로 나뉘어 저장되어 있는지, 각 블록이 어느 DataNode에 위치하는지 등의 정보를 기록하고 유지합니다. 또한, 전체 클러스터에 존재하는 DataNode들의 상태를 주기적으로 점검하고, 이상이 생긴 노드를 감지하여 관리하는 기능도 수행합니다. 반면, DataNode는 실제로 사용자의 데이터가 저장되는 공간으로, 데이터를 블록 단위로 나누어 저장합니다. 이때 데이터는 한 곳에만 저장되지 않고, 여러 노드에 복제되어 저장됩니다. 이러한 블록 복제 덕분에 특정 노드에 장애가 발생하더라도 데이터 유실을 방지할 수 있습니다.
다음으로, 병렬 처리는 JobTracker와 TaskTracker가 담당합니다. JobTracker는 클러스터 전체의 작업(job)들을 관리하는 중앙 컨트롤러 역할을 합니다. 사용자가 작업을 제출하면 JobTracker는 이를 적절히 분할하고, 클러스터 내 자원을 고려하여 작업을 각 TaskTracker에게 할당합니다. 또한, 각 작업의 진행 상황을 모니터링하고, 작업 실패가 발생할 경우 재시도를 조율하는 등 안정적인 처리를 지원합니다. 이러한 구조 덕분에 하둡 v1에서는 최대 약 4,000대에 이르는 노드를 하나의 클러스터에 등록하여 관리할 수 있었습니다.
TaskTracker는 JobTracker로부터 할당받은 작업을 실제로 수행하는 역할을 합니다. 각 TaskTracker는 자신에게 배정된 작업을 처리하고, 결과를 JobTracker에 보고합니다. 만약 작업 도중 오류가 발생하면 이를 즉시 JobTracker에 알리고, 필요 시 작업을 재수행합니다.
이와 같은 구조를 통해 하둡 v1은 대용량 데이터를 안정적으로 저장하고, 동시에 빠르게 처리할 수 있는 기반을 마련하였습니다. 이후 하둡은 이 기본 구조를 발전시켜 더욱 강력한 분산 처리 생태계를 구축하게 됩니다.
3.3.2. Hadoop v2.0
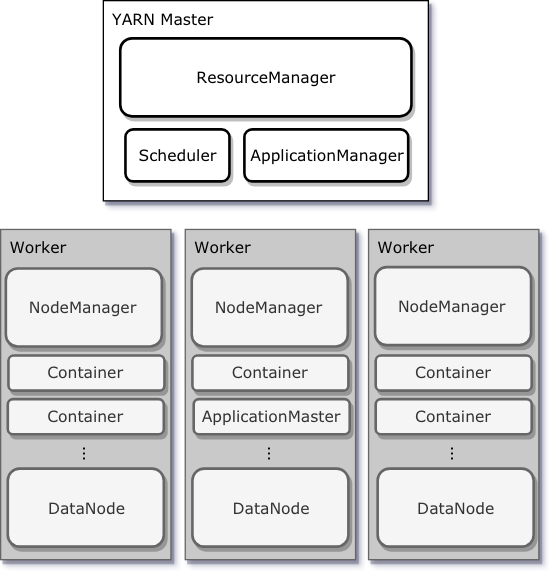
출처 : 하둡 V2 아키텍처
하둡 v1은 대용량 데이터를 분산 저장하고 병렬로 처리하는 강력한 프레임워크였지만, 구조적인 한계로 인해 몇 가지 뚜렷한 단점과 문제점을 가지고 있었습니다. 가장 큰 문제는 JobTracker의 병목현상이었습니다. 하둡 v1에서는 JobTracker가 클러스터의 모든 자원 관리(Resource Management)와 작업 스케줄링(Job Scheduling)을 동시에 처리하였습니다. 이에 따라 클러스터에 등록된 노드 수가 증가할수록 JobTracker에 과부하가 발생하였고, 결국 수 많은 노드들을 안정적으로 관리하는데에 한계가 찾아왔습니다.
또한, JobTracker가 단일 장애 지점(Single Point of Failure)이 되었기 때문에, JobTracker에 문제가 발생하면 클러스터 전체의 작업이 중단되는 심각한 위험이 존재하였습니다. 이 외에도 하둡 v1은 MapReduce 프로그래밍 모델에만 종속되어 있어 다양한 데이터 처리 방식이나 복잡한 애플리케이션 실행이 어려웠습니다. 새로운 워크로드나 다양한 데이터 처리 엔진을 유연하게 수용할 수 있는 구조가 부족하였습니다.
이러한 문제를 해결하기 위해, V2 부터 도입된 것이 YARN 입니다. ( YARN 에 대하여서도, 추후 더 자세하게 다룰 예정입니다. ) 하둡 v2는 기존 하둡 v1의 JobTracker 병목현상을 제거하고 확장성을 크게 향상시키기 위해 YARN(Yet Another Resource Negotiator) 아키텍처를 도입하였습니다. ( 비슷한 이유로 MapReduce 도 YARN 에서 사용하느냐 아니냐로 1.0 과 2.0 기점이 바뀌게 됩니다. )
YARN 아키텍처는 JobTracker의 역할을 세분화하여, 자원 관리와 애플리케이션 관리 기능을 분리하였습니다.
▶ 🍓ResourceManager : 클러스터 전체의 자원을 통합적으로 관리. 작업을 직접 수행하지 않고, 어떤 작업에 얼마만큼의 자원을 할당할지 결정하는 역할 수행.
▶ 🍒NodeManager : 각 노드에서 자원의 사용 현황을 모니터링하고, 실제 컨테이너(Container)를 관리.
▶ 🍎ApplicationMaster : 각 애플리케이션(작업)마다 별도로 생성되어, 애플리케이션의 라이프사이클을 관리. ResourceManager와 통신하여 필요한 자원을 요청하고, 작업 실행을 조율.
▶ 🍏Container : 실제 작업이 수행되는 단위. ResourceManager로부터 자원을 할당받아 생성되며, 작업이 완료되면 컨테이너는 종료되어 자원이 반환 됨.
이러한 구조 덕분에 하둡 v2는 자원 관리와 작업 관리를 분리함으로써 시스템 부하를 효과적으로 분산시킬 수 있게 되었습니다. 결과적으로 클러스터에 등록할 수 있는 노드 수가 대폭 증가하여, 최대 약 10,000대 이상의 노드를 관리할 수 있는 높은 확장성을 확보할 수 있었습니다.
또한 YARN 아키텍처에서는 MapReduce에 한정되지 않고, 다양한 종류의 애플리케이션이 컨테이너를 통해 실행될 수 있도록 지원합니다. 이를 통해 Spark, HBase, Storm 등 다양한 데이터 처리 프레임워크와 컴포넌트를 YARN 클러스터 위에서 효율적으로 실행할 수 있게 되었습니다.
특히, 컨테이너는 작업이 요청될 때만 생성되고, 작업이 끝나면 즉시 종료되기 때문에 클러스터의 자원을 매우 효율적으로 활용할 수 있습니다. 이로써 하둡은 단순한 MapReduce 기반 시스템을 넘어, 다양한 데이터 처리 엔진을 통합하는 범용 데이터 플랫폼으로 발전할 수 있게 되었습니다.
3.3.3. Hadoop v3.0
하둡 V1 에서 V2 로의 진화는, 대량의 작업을 안정적으로 처리하기 위한 YARN 의 도입이 핵심이었다면, V3 로의 진화는 성능 개선과, 여러가지 편의성 그리고 현 생태계에 알맞는 고도화를 목적으로 업데이트 되었습니다. 여기서 등장하는 Erasure Encoding 이나, YARN 타임라인 서비스 등에 대하여서도 역시 다음 포스팅에서 함께 제대로 정리할 예정입니다. 지금은 그저 V3에 추가된 내용에 대한 개요만 보겠습니다.
▶ ① Java Version Upgrade Hadoop 3에서 모든 Hadoop JAR은 Java 8의 런타임 버전을 대상으로 컴파일됩니다. 따라서 여전히 Java 7 이하를 사용하는 사용자는 Hadoop 3으로 작업을 시작할 때 Java 8로 업그레이드해야 합니다.
▶ ② HDFS Erasure Encoding 추후 다시 알아보겠지만, HDFS의 기본 복제 개수는 3개입니다. 하나는 원본 데이터 블록이고, 나머지 두 개는 각각 100%의 스토리지 오버헤드가 필요한 복제본입니다.
결과적으로 총 200%의 스토리지 오버헤드가 발생하며, 네트워크 대역폭과 같은 추가 리소스도 소모합니다. (즉, 1TB 데이터를 저장하는데에 3TB 용량이 필요한겁니다.) 그러나 I/O 활동이 적은 Cold Data 들 또한, 정상적인 작업 중 거의 액세스되지 않음에도 불구하고 여전히 원본 데이터와 동일한 수준의 리소스를 소비합니다.
이레이저 코딩은 이러한 상황을 개선하기 위해 고안되었습니다. 이레이저 코딩은 데이터를 저장할 때 복제본 대신 사용되며, 기존 복제 방식보다 훨씬 적은 스토리지 오버헤드로 동일한 수준의 내결함성을 제공합니다. HDFS에 EC(Erasure Coding)를 통합함으로써 스토리지 효율성을 대폭 향상시키면서도 내결함성을 유지할 수 있습니다.
예를 들어, 6개의 블록을 가진 3x 복제 파일은 18개의 블록 공간을 사용하지만, EC(6 데이터, 3 패리티) 방식을 적용하면 9개의 블록(6 데이터 블록 + 3 패리티 블록)만 사용합니다. 이를 통해 약 50%의 스토리지 오버헤드만 발생하게 됩니다.
다만 이레이저 코딩은 데이터 재구성을 위해 원격 판독 작업이 추가로 필요하므로, 일반적으로 자주 액세스하지 않는 데이터 저장에 주로 사용합니다. 삭제 코딩을 적용하기 전에 사용자는 스토리지, 네트워크, CPU 오버헤드 등 모든 요소를 충분히 고려해야 합니다. 이레이저 코딩을 효과적으로 지원하기 위해 Hadoop은 HDFS 아키텍처를 일부 변경하였습니다. 먼저, 블록 그룹 단위로 동작할 수 있게끔, NameNode 가 확장 되었습니다.
HDFS에 이레이저 코딩(EC)을 적용하면 하나의 파일이 여러 조각(=여러 블록)으로 나뉩니다. 그리고 이 조각들은 "그룹"으로 묶입니다. 이 묶음을 "블록 그룹(Block Group)"이라고 부릅니다. 원래 HDFS에서는 파일을 관리할 때 블록 하나하나를 따로따로 관리했습니다. 그런데 EC를 도입하면서는 하나의 블록 그룹 단위로 관리하려는 것입니다. (즉, 블록 하나하나가 아니라 블록을 묶은 '그룹'을 관리)
그런데 이렇게 하려면 문제가 하나 생깁니다. 블록이 많아지니까, NameNode가 이 블록 하나하나를 기억(메모리 사용)해야 해서 메모리 부담이 커질 수 있습니다.
그래서 "계층적 블록 명명 방식" 이라는 새로운 규칙을 도입합니다. 이 규칙은 블록 그룹의 ID를 알고 있으면, 그 안에 포함된 내부 블록 ID들을 유추할 수 있게 만들어 놓은 것입니다.
덕분에 모든 내부 블록을 하나하나 기억할 필요 없이, 블록 그룹 하나만 기억하면 됩니다. 이렇게 해서 NameNode의 메모리 부담을 줄입니다.
다음은, 클라이언트가 확장되었습니다.
HDFS 클라이언트(파일을 읽고 쓰는 주체)도 EC(이레이저 코딩)를 지원하도록 개선되었습니다. 이제 파일을 읽고 쓸 때, 클라이언트는 "블록 그룹" 단위로 여러 블록을 동시에(병렬로) 다루게 됩니다. (예전에는 블록 하나하나 순서대로 처리했음)
이제 파일을 쓸 때, HDFS는 DFSStripedOutputStream이라는 것을 사용합니다. 이 스트림은 블록 그룹 안의 각 내부 블록을 저장할 DataNode에 각각 스트리머를 만들어서 데이터를 보냅니다. 예를 들어, 6개 데이터 블록, 3개 패리티 블록이라면 총 9개의 스트리머가 관리됩니다. 그리고 이 작업을 조율하는 코디네이터가 있어서 블록 그룹이 다 찼을 때 그룹을 종료하고, 새로운 블록 그룹을 할당하는 등의 일을 관리합니다.
파일을 읽을 때는 DFSStripedInputStream이라는 것을 사용합니다. 클라이언트는 필요한 데이터를 요청하면, 어떤 내부 블록에 그 데이터가 저장돼 있는지 계산하고, 여러 DataNode에 동시에 요청을 날린다(병렬 읽기). 만약 일부 블록에 장애가 생겼다면 패리티 블록을 활용해서 디코딩(복구) 과정을 추가로 실행합니다.
정리하자면, 파일 읽고 쓰는 경로가 블록 그룹 기반으로 병렬화되어 더 빨라졌으며, 쓰기는 각 내부 블록마다 스트리머를 따로 만들어 DataNode에 보내고, 읽기는 필요한 블록을 계산해서 병렬로 가져오고, 장애가 있으면 복구도 지원한다고 할 수 있겠습니다.
다음은, DataNode 가 확장되었습니다.
DataNode는 HDFS에서 데이터를 실제로 저장하는 노드입니다. 이레이저 코딩을 사용하면, 데이터 블록과 패리티 블록이 함께 저장됩니다. 그런데, EC 블록 중 하나가 실패하면, 이 블록을 복구하기 위해 백그라운드에서 추가 작업(ECWorker)을 수행합니다. NameNode는 실패한 EC 블록을 감지하고, 이를 복구할 DataNode를 선택합니다.
이후, 복구 작업이 진행됩니다. 이 작업은 세 가지 단계로 이루어집니다.
첫 번째는 필요한 데이터와 패리티 블록만을 읽어와서 복구 작업을 위한 기초 데이터를 준비하며, 두 번째는 읽어온 데이터를 디코딩합니다. 이 디코딩 과정에서 누락된 데이터와 패리티 블록이 함께 복원됩니다. 마지막 세 번째로 디코딩이 끝난 후, 복구된 데이터 블록이 대상 DataNode로 전송되어 다시 저장됩니다.
마지막으로 ErasureCoding 정책을 확립하였습니다.
ErasureCodingPolicy 클래스에 캡슐화를 함으로써, HDFS 클러스터에서 복제(Replication)와 이레이저 코딩(EC)을 다르게 설정할 수 있습니다. 예를 들어, 파일 A는 복제 방식으로 내결함성을 지원하고, 파일 B는 이레이저 코딩 방식으로 내결함성을 지원할 수 있습니다.
▶ ③ Shell Script 개선
기존에는 Hadoop의 각 스크립트 파일에서 별도로 환경 변수를 설정했었습니다. 예를 들어, hdfs-daemon.sh, yarn-daemon.sh와 같은 스크립트에서 각각 환경 변수를 설정할 수 있었습니다.
만약 환경 변수가 여러 곳에 흩어져 있으면 관리가 매우 번거로웠습니다. 그러나 이제 모든 Hadoop 셸 스크립트가 hadoop-env.sh를 실행하도록 변경되었습니다. 이를 통해 하나의 파일에서 모든 환경 변수를 관리할 수 있습니다.
또한, Hadoop에서 데몬을 시작하고 중지하는 방식이 개선되었습니다. 예를 들어, 기존에는 hdfs-daemon.sh와 같은 개별 스크립트를 사용하여 데몬을 시작하거나 중지해야 했습니다. ( ./sbin/hadoop-daemon.sh start namenode ) 이 명령어들에서 -daemon 옵션을 사용하여 더 일관성 있는 방식으로 데몬을 시작하거나 중지할 수 있도록 변경되었습니다. ( hdfs --daemon start namenode )
그 외에도 ssh, ${HADOOP_CONF_DIR}, 에러메시지 등이 개선되었습니다.
▶ ④ Shaded Client Jars Hadoop 2 버전에서는 hadoop-client라는 라이브러리를 사용하여 Hadoop 애플리케이션이 Hadoop의 종속성을 애플리케이션의 클래스 경로에 추가하도록 했습니다.
이는, 어떤 라이브러리가 다른 라이브러리를 참조할 때, 그 참조된 라이브러리도 애플리케이션에 포함되는 경우를 말합니다. 예를 들어, Hadoop이 사용하는 라이브러리가 다른 버전으로 애플리케이션에 포함되면서, 버전 충돌이 발생할 수 있습니다. Hadoop 3에서는 이러한 문제를 해결하기 위해 hadoop-client-api와 hadoop-client-runtime이라는 새로운 아티팩트를 도입했습니다.
💡 hadoop-client-api 이 아티팩트는 컴파일 범위로 설정되어 있습니다. 즉, 애플리케이션을 컴파일할 때만 필요한 라이브러리를 제공합니다. 예시 : Hadoop 애플리케이션을 작성하는 동안 필요한 클래스와 메서드를 포함하지만, 실제 실행 시에는 사용되지 않습니다.
💡 hadoop-client-runtime 이 아티팩트는 런타임 범위로 설정되어 있습니다. 즉, 애플리케이션이 실행될 때 실제로 필요한 Hadoop의 종속성을 포함합니다.
이 아티팩트는 Hadoop의 모든 종속성을 단일 JAR 파일로 묶어서 제공합니다. 이로 인해 애플리케이션의 클래스 경로로 누출되는 Hadoop의 종속성을 완전히 방지할 수 있습니다. 예시를 하나 들어보면 HBase가 있습니다.
HBase는 Hadoop과 함께 사용되는 시스템인데, Hadoop의 구현 종속성 없이 Hadoop 클러스터와 통신을 할 수 있습니다. 이전에는 HBase가 Hadoop 클러스터와 통신하려면 Hadoop의 종속성을 애플리케이션에 추가해야 했고, 버전 충돌이 발생할 수 있었습니다. Hadoop 3에서는 HBase가 Hadoop의 종속성을 포함하지 않고, 음영 처리된 Hadoop 클라이언트 API를 사용하여 안정적으로 Hadoop 클러스터와 통신할 수 있습니다.
▶ ⑤ Opportunistic Containers 의 지원 Opportunistic Containers 는 YARN에서 리소스가 부족하더라도 실행을 시도하는 컨테이너가 도입되었습니다. 기본적으로 리소스가 부족한 경우 대기 상태로 남아 있다가, 리소스가 할당되면 실행됩니다. 이 컨테이너는 Guaranteed Containers와 비교하여 우선순위가 낮습니다. 즉, 리소스가 부족하면 Guaranteed Containers가 먼저 실행되고, 그 후에 Opportunistic Containers가 실행됩니다. 이러한 컨테이너의 도입은 리소스를 절약할 수 있기 때문에 클러스터 사용률을 높일 수 있습니다. ( 또한, 분산 스케줄링 작업에서도 지원합니다. )
▶ ⑥ MapReduce 최적화 Hadoop 3에서는 MapReduce 작업의 성능 향상을 위해 맵 출력 수집기(map output collector)에 대한 네이티브(Java 외부, 주로 C/C++ 기반) 구현을 추가하였습니다. 이 최적화는 셔플(shuffle) 작업이 많은 경우, 작업 속도를 30% 이상 향상시킬 수 있습니다.
구체적으로, Hadoop 3는 NativeMapOutputCollector라는 네이티브 컴포넌트를 MapTask에 추가하였습니다. 이는 매퍼가 방출하는 (key, value) 쌍을 처리할 때 사용되며, 정렬(sort), 스필(spill), IFile 직렬화 과정을 모두 네이티브 코드로 수행합니다. 이러한 네이티브 최적화는 JNI(Java Native Interface)를 기반으로 구현되어, 자바만으로 처리할 때보다 훨씬 빠른 속도로 중간 데이터를 처리할 수 있습니다.
위에서 이해가 안갈 수 있는 용어를 조금 더 정리하였습니다. 이 부분은 앞으로 Map Reduce 개념을 공부하는데 있어서 중요합니다.
Spill(스필)은 맵 출력 결과가 메모리 버퍼를 초과할 때, 버퍼에 담긴 데이터를 디스크에 임시 파일로 기록하는 과정을 의미합니다. MapReduce 작업은 메모리 용량에 한계가 있기 때문에, 일정 수준 이상으로 데이터가 쌓이면 자동으로 spill 작업을 수행합니다. 스필이 자주 발생하면 디스크 I/O 비용이 증가하여 성능 저하로 이어질 수 있으므로, 이를 최적화하는 것은 매우 중요합니다.
Shuffle(셔플)은 맵 단계에서 생성된 (key, value) 쌍들을 리듀스 작업으로 전달하기 위해 네트워크를 통해 이동시키고, 이를 키 기준으로 정렬하는 과정을 의미합니다. 셔플 과정은 MapReduce 전체 작업 중 가장 비용이 많이 드는 단계 중 하나입니다. 네트워크 전송과 디스크 쓰기·읽기, 정렬 과정이 복잡하게 얽혀 있기 때문에, 이 부분의 최적화가 전체 성능에 큰 영향을 미칩니다.
▶ ⑦ 2개 이상의 NameNode 지원 Hadoop V2에서는 HDFS NameNode HA 아키텍처가 단일 활성 NameNode와, 단일 대기 NameNode로 구성되어 있습니다. 이 아키텍처는 세 개의 JournalNode로 이루어진 쿼럼(quorum)에 편집 로그(edit log)를 복제하여, 하나의 NameNode에 장애가 발생하더라도 서비스를 지속할 수 있도록 설계되었습니다. 그러나 이후 비즈니스 크리티컬 환경에서는 하나 이상의 장애를 견딜 수 있는 더 높은 수준의 내결함성(fault tolerance)이 요구되었습니다.
이에 따라 Hadoop V3에서는 사용자가 여러 개의 대기(standby) NameNode를 실행할 수 있도록 기능을 확장하였습니다.
예를 들어, 3개의 NameNode(1개의 활성(active), 2개의 대기(standby))와 5개의 JournalNode로 클러스터를 구성할 수 있습니다. 이러한 구성에서는 최대 2개의 NameNode 장애를 허용할 수 있어, 시스템의 안정성과 가용성이 크게 향상됩니다.
2개 이상의 NameNode 를 지원할 수 있게 해주는 JournalNode 에 대해서 간단히 개요를 정리하면, HDFS 고가용성 아키텍처에서 NameNode들의 편집 로그(edit log)를 저장하고 동기화하는 역할을 합니다. 활성 NameNode가 파일 시스템 메타데이터를 변경하면, 해당 변경사항을 JournalNode에 복제하여 기록합니다. 대기 NameNode는 이 JournalNode로부터 편집 로그를 읽어 들여 활성 NameNode와 항상 동기화된 상태를 유지합니다. JournalNode는 별도의 저장소 노드로 구성되며, 안정적인 장애 복구를 위해 홀수 개로 설정하는 것이 일반적입니다.
쿼럼(Quorum)은 분산 시스템에서 의사 결정을 내리기 위해 필요한 최소한의 동의 수를 의미합니다. HDFS에서는 JournalNode 집합에서 과반수 이상의 응답을 받아야 변경사항이 정상적으로 기록되었다고 인정합니다. 예를 들어 5개의 JournalNode를 구성할 경우, 3개 이상의 노드가 응답해야 쿼럼이 성립합니다. ( 마치 주키퍼와 같습니다. )
이러한 방식은 일부 노드가 장애를 일으켜도 시스템 전체가 안정적으로 동작할 수 있도록 보장합니다.
▶ ⑧ 기본 포트번호 변경 Hadoop V2에서는 여러 Hadoop 서비스의 기본 포트가 Linux의 임시 포트 범위(32768~61000) 내에 존재했습니다. 클라이언트 프로그램이 특정 포트 번호를 명시하지 않는 경우, 이 임시 포트 범위 내 포트가 사용됩니다. 이로 인해 서비스가 시작할 때 다른 응용 프로그램과 포트 충돌이 발생하여 포트에 바인딩할 수 없는 문제가 종종 발생하였습니다.
이 문제를 해결하기 위해, Hadoop 3에서는 여러 핵심 서비스(NameNode, Secondary NameNode, DataNode 등)의 기본 포트가 임시 포트 범위 바깥으로 이동되었습니다. 이로써 서비스 간 포트 충돌 가능성이 줄어들고 시스템 안정성이 향상되었습니다.
대표적으로 변경된 주요 포트는 다음과 같습니다.
| Daemon | App | Hadoop 2.x Port | Hadoop 3 Port |
|---|---|---|---|
| NameNode | Hadoop HDFS NameNode | 8020 | 9820 |
| Hadoop HDFS NameNode HTTP UI | 50070 | 9870 | |
| Hadoop HDFS NameNode HTTPS UI | 50470 | 9871 | |
| Secondary NN | Secondary NameNode HTTP | 50091 | 9869 |
| Secondary NameNode HTTP UI | 50090 | 9868 | |
| DataNode | Hadoop HDFS DataNode IPC | 50020 | 9867 |
| Hadoop HDFS DataNode | 50010 | 9866 | |
| Hadoop HDFS DataNode HTTP UI | 50075 | 9864 | |
| Hadoop HDFS DataNode HTTPS UI | 50475 | 9865 |
▶ ⑨ 파일 시스템 커넥터 지원 Hadoop은 Microsoft Azure Data Lake 및 Aliyun Object Storage System과의 통합을 지원합니다. 이제 이 두 시스템을 Hadoop 호환 파일 시스템(Hadoop Compatible File System, HCFS)의 대체 저장소로 사용할 수 있습니다. 먼저 Microsoft Azure Data Lake 통합이 추가되었고, 이후에 Aliyun Object Storage System 통합이 추가되었습니다.
▶ ⑩ DataNode 내부 밸런서 기존 HDFS 구조에서 DataNode 는 하나의 DataNode 가 여러 개의 디스크를 관리하였습니다. ( 하나의 서버에 HDD, SDD 등 여러 디스크를 달 수 있음 ) 그러나, 파일을 저장할 때 Hadoop 은 모든 디스크에 균등하게 데이터를 분산시켜 저장합니다. 그래서 디스크마다 데이터가 비슷한 비율로 채워집니다.
이러면, 새 디스크를 추가하거나 기존 디스크를 교체하면 DataNode 내의 디스크 간 데이터 분포 불균형 문제가 발생합니다. 기존의 HDFS Balancer 는 노드 간 데이터 균형만 조정 할 수 있었지, 하나의 DataNode 안에서의 디스크들 사이 균형은 조정할 수 없었습니다. 하지만 하둡 V3에서는 DataNode 내부 디스크 간 데이터 분포 불균형도 조정할 수 있습니다.
이를 위해 새로운 기능인 HDFS 디스크 밸런서(Disk Balancer)가 추가되었으며, 이 디스크 밸런서는 CLI(Command Line Interface) 명령어로 실행할 수 있습니다.
먼저 DataNode 안의 디스크들 사이에 데이터가 고르게 분포되도록 이동시킵니다. 예를 들어, 기존 디스크가 90% 차 있고 새 디스크가 5% 차 있다면, 데이터를 옮겨서 둘 다 비슷하게 50%, 50%로 맞추는 식입니다. 이렇게 하면 I/O 성능이 향상되고, 디스크 과부하 문제를 방지할 수 있습니다.
hdfs diskbalancer -plan <DataNode명> -out <플랜파일>
hdfs diskbalancer -execute <플랜파일>
▶ ⑪ 데몬 및 작업 Heap 관리 재작업 Hadoop 3에서는 데몬의 힙 메모리 관리와 MapReduce 작업에 관련된 설정 방식에 여러 가지 중요한 변경이 적용되었습니다.
먼저 데몬 Heap 크기 설정 방식이 변경되었습니다.
기존에는 HADOOP_HEAPSIZE 환경 변수를 사용하여 힙 크기를 지정했으나, 이제는 이 방식이 더 이상 사용되지 않습니다.
HADOOP_HEAPSIZE_MAX는 JVM의 최대 힙 크기(Xmx)를 지정합니다.
HADOOP_HEAPSIZE_MIN는 JVM의 초기 힙 크기(Xms)를 지정합니다.
이 변수들은 단위(MB, GB 등)를 지원하며, 숫자만 입력할 경우 메가바이트(MB)로 간주합니다.
또한, Hadoop은 이제 호스트 머신의 메모리 크기를 자동으로 감지하여 적절한 힙 크기를 자동으로 설정할 수 있습니다.
그리고, MapReduce 작업 Heap 크기 관리도 기존에 비해 단순화 되었습니다. 이제 작업 구성(mapreduce.map.memory.mb, mapreduce.reduce.memory.mb)과 Java 옵션(-Xmx)을 동시에 설정할 필요가 없습니다. 하나의 설정만으로도 Heap 크기가 자동으로 적용됩니다.
| 항목 | Hadoop 2.x 방식 | Hadoop 3.x 이후 변경점 |
|---|---|---|
| 데몬 힙 크기 설정 방식 | HADOOP_HEAPSIZE 사용 |
HADOOP_HEAPSIZE_MAX, HADOOP_HEAPSIZE_MIN 사용 |
| 메모리 단위 지원 | 숫자만 입력 (MB로 간주) | MB, GB 등의 단위 명시 가능 |
| 자동 메모리 튜닝 | 없음 (수동 설정 필요) | 호스트 메모리 크기에 따라 자동 조정 가능 |
| 작업 힙 설정 방식 | 구성값과 Java 옵션 모두 명시 필요 | 하나만 지정해도 자동 적용됨 |
| 기존 설정 호환성 | 기존 방식 유지 | 기존 구성은 영향을 받지 않고 그대로 작동함 |
▶ ⑫ YARN TimeLine Service V2 YARN Timeline Service는 YARN 클러스터에서 실행되는 애플리케이션들의 상태, 이벤트, 그리고 다양한 메타데이터를 수집하고 저장하는 핵심 컴포넌트입니다. 단순한 실행 상태뿐 아니라, 각 태스크(Task)의 상세 실행 내역, 오류 발생 기록, 자원 사용 통계 등 정밀한 데이터를 중앙 저장소에 기록함으로써, 운영자나 개발자가 문제를 쉽게 분석하고 성능을 최적화할 수 있도록 돕습니다.
YARN 환경에서 수십~수천 개의 애플리케이션이 동시에 실행되고, 각 애플리케이션은 수백 개의 컨테이너와 태스크를 포함하는 경우가 많습니다. 이런 상황에서 단순히 ResourceManager의 UI만으로는 실행 내역을 파악하기 어렵습니다. 예를 들어, 어떤 MapReduce 작업이 실패했는지, Spark 애플리케이션에서 어느 컨테이너가 자원 부족으로 종료되었는지, 또는 태스크 수행 시간이 평균보다 비정상적으로 길어진 경우가 어디인지 등을 파악해야 할 때, Timeline Service는 필수적입니다.
YARN Timeline Service는 이러한 요구를 충족시키기 위해 설계된 컴포넌트로, 처음에는 v1 버전으로 단순한 단일 서버 구조에서 시작되었습니다. Timeline Service v1은 모든 이벤트 데이터를 JSON 형태로 수집한 뒤, HDFS에 저장하는 방식을 사용했습니다. 구조가 단순하고 설정이 비교적 쉬웠기 때문에 소규모 또는 테스트 환경에서는 적합했지만, 대규모 클러스터에서는 여러 한계가 드러났습니다.
가장 큰 문제는 확장성 부족과 병목현상이었습니다. 읽기와 쓰기 요청이 모두 하나의 서버 인스턴스로 집중되다 보니, 작업이 몰릴 경우 이벤트 유실, 응답 지연, 시스템 과부하 등의 문제가 빈번하게 발생했습니다. 또한 UI나 REST API를 통해 이벤트를 조회할 때도 성능 저하가 잦았습니다.
이러한 한계를 극복하기 위해 Hadoop 3.0부터 Timeline Service v2 (TSv2)가 도입되었습니다. TimeLine Service V2 (이하 TSv2) 는 확장성과 신뢰성 향상, 흐름과 집계를 통한 사용성 개선 이라는 두 가지 목표를 가지고 업그레이드 되었습니다.
v.2는 분산 작성기(distributed writer) 아키텍처를 채택하여 데이터 수집과 제공 기능을 분리하였습니다. 데이터 수집은 각 YARN 애플리케이션마다 하나의 수집기(installer collector)를 두어 분산 방식으로 처리하며, 데이터 제공은 REST API를 통해 쿼리를 처리하는 별도의 판독기 인스턴스가 전담합니다.
이러한 구조는 수평적 확장을 가능하게 하며, 읽기/쓰기 부하를 분산시켜 성능 저하 없이 안정적인 운영을 지원합니다. 백업 저장소로는 Apache HBase를 기본 값으로 사용합니다. Apache HBase는 대량의 데이터를 저장하고 처리하는 데 뛰어난 성능을 제공하며, 읽기 및 쓰기 작업에 대해 우수한 응답 시간을 유지하면서도 대규모로 잘 확장되기 때문에 타임라인 서비스 v.2의 저장소로 적합합니다.
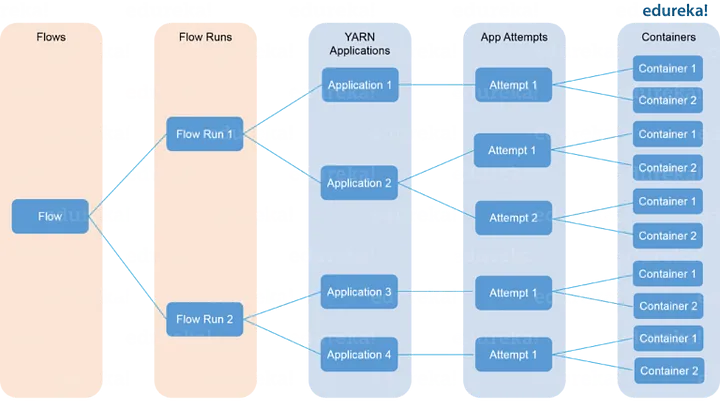
다음, v2 사용성 향상에 대해 이야기하자면, 대부분의 사용자들은 개별 YARN 애플리케이션보다는, 여러 YARN 애플리케이션으로 구성된 하나의 논리적 단위, 즉 "흐름(flow)" 수준의 정보에 더 많은 관심을 가집니다. 실제로 하나의 작업을 완료하기 위해 여러 개의 YARN 애플리케이션이 집합적으로 실행되는 경우가 많습니다. 이에 따라, 타임라인 서비스 v.2는 이러한 흐름 개념을 명시적으로 지원합니다. 사용자는 흐름 단위로 애플리케이션들을 묶어 관리할 수 있으며, 이를 통해 전체 작업의 진행 상황이나 성능을 더 효과적으로 파악할 수 있습니다. 또한, 타임라인 서비스 v.2는 흐름 수준에서 메트릭(metric) 집계를 지원합니다. 이를 통해 개별 애플리케이션 단위가 아닌, 전체 흐름 단위로 리소스 사용량, 처리 시간 등의 메트릭을 통합적으로 확인할 수 있어, 사용자 입장에서 보다 직관적이고 유용한 모니터링이 가능합니다.
출처 : Yarn TimeLine V2
YARN 타임라인 서비스 v.2는 분산 아키텍처 기반으로 설계되어 데이터 수집과 저장, 조회의 효율성과 확장성을 극대화합니다. 이 서비스는 여러 개의 수집기(작성기)를 활용하여 백엔드 스토리지에 데이터를 저장합니다. 이러한 수집기들은 분산되어 있으며, 각 수집기는 전용 애플리케이션 마스터와 함께 동일한 노드에 배치됩니다. 해당 애플리케이션에 대한 모든 데이터는 리소스 관리자(ResourceManager)의 타임라인 수집기를 제외하고, 각 애플리케이션 수준에 배치된 타임라인 수집기로 전송됩니다.
지정된 애플리케이션의 경우, 애플리케이션 마스터는 관련 데이터를 로컬에 배치된 타임라인 수집기로 직접 기록합니다. 또한, 해당 애플리케이션의 컨테이너를 실행 중인 다른 노드의 노드 관리자(NodeManager)들도 애플리케이션 마스터가 위치한 노드의 타임라인 수집기에 데이터를 전달하여 기록합니다. 리소스 관리자는 자체적인 타임라인 수집기를 따로 유지하며, 시스템 전체에 대한 과도한 데이터 기록을 방지하기 위해 YARN의 일반적인 수명 주기 이벤트만 기록합니다.
한편, 타임라인 리더는 수집기와는 분리된 독립된 데몬 프로세스로 동작합니다. 이 리더는 REST API를 통해 클라이언트의 쿼리에 응답하는 역할을 하며, 읽기 요청 처리에 전념합니다. 이러한 구조는 읽기와 쓰기를 완전히 분리함으로써 성능을 최적화하고 시스템의 확장성을 더욱 높입니다.
해당 내용에 대한 자세한 이야기는 추후에 YARN 파트에서 자세히 포스팅 하겠습니다.
결론
이번 포스팅에서는 Hadoop 이 왜 등장하게 되었는지, 그 이전 시스템은 어떻게 발전해 왔고 어떤 문제가 있었는지를 알아보았습니다.
단순히 Hadoop 에 대해 바로 공부하는 것보다, 분산 시스템 그 자체에 대하여 먼저 공부하고 Hadoop 을 공부한다면, Hadoop 등장의 히스토리를 알 수 있고, 그로 인해 더 잘 이해할 수 있게 될 거라고 생각했습니다. 공부한 내용을 토대로 글을 포스팅하였기 때문에, 계속 깊게 더 공부하고 글을 남길 것이며, 해당 글도 계속 다시 읽고 복습 할 예정입니다. 다음 포스팅에서부터는 HDFS, Yarn, MapReduce 등 본격적으로 Hadoop 에 대해 정리할 예정입니다.
긴 글 읽어줘서 고맙습니다. 다음 포스팅에서 봅시다. :D