
Spark Skew Deep Dive ➜ CPU부터 Linux Kernel까지 추적해보기
- Apache Spark
- Data Skew
- Core
사이드 프로젝트로 Spark를 파고들던 중, Skew가 심한 Partition 하나가 전체 Job을 붙잡는 현상이 궁금해졌습니다. 특히 Skew가 커질 때 처리 비용이 실제로 어떻게 달라지는지 직접 확인해보고 싶었습니다.
"Data가 2배 몰리면 정말 2배 느려지는 걸까?"
이 글은 이 질문에서 시작해, 직접 실험하고 예상과 다른 결과가 나올 때마다 원인을 다시 확인해본 과정을 기록한 글입니다.
1. 서론
1.1 문제를 발견하게 된 배경
Spark Job에서 Task 하나가 유난히 오래 끝나지 않는 경험을 해본 사람이 있을 것입니다. Spark UI를 열어보면 200개의 Task 중 199개는 몇 초 만에 끝났는데, 1개만 혼자 몇 분 동안 실행되고 있습니다. 이런 현상이 데이터 분포의 불균형, 즉 Skew 때문에 발생하는 경우가 있습니다. 특정 Key에 Data가 몰리면서 해당 Key가 속한 Partition 하나가 비대해지는 현상입니다.
여기까지는 Spark를 사용해봤거나 Skew를 공부해봤다면 익숙한 이야기일 것입니다. 그런데 저는 여기서 한 단계 더 궁금해졌습니다.
Skew가 2배가 되면 처리 비용도 2배가 되는가?
그렇지 않다면 처리 시간이 갑자기 달라지는 지점은 어디에서 생길까요? 그리고 그 지점을 결정하는 것은 Spark일까요, JVM일까요, 아니면 Linux Kernel일까요? "Skew는 나쁘다"는 이야기는 검색하면 얼마든지 찾을 수 있습니다. 하지만 Skew의 크기가 달라질 때 실제 처리 비용이 어떻게 변하는지를 직접 측정한 자료는 찾기 어려웠습니다. 대부분은 원인을 설명한 뒤 "이렇게 해결하면 됩니다"로 넘어갑니다.
저는 해결책보다 Skew가 커질 때 실제 실행에서 어떤 변화가 생기는지가 궁금했습니다.
1.2 예상했던 원인
실험을 시작하기 전에 결과가 어떻게 나올지 먼저 가설을 세웠습니다.
나중에 실제 결과와 비교하기 위해서였습니다. 돌이켜보면, 이번 프로젝트에서 가장 잘한 일 중 하나였습니다.
당시에는 다음과 같이 예상했습니다.
-
데이터가 많아지면 처리 시간도 비례해서 늘어날 것이다.
- Partition의 데이터가 2배가 되면 처리해야 할 데이터도 2배가 됩니다.
- 따라서 처리 시간 역시 대략 2배 정도 늘어날 것이라고 예상했습니다.
-
메모리가 부족해지면 Spill 때문에 추가 비용이 발생할 것이다.
- Spark는 메모리만으로 데이터를 처리하기 어려워지면 일부 데이터를 디스크에 임시로 저장합니다.
- 이 과정을 Spill이라고 합니다.
- 디스크에 데이터를 쓰고 다시 읽어오는 과정이 추가되므로, Spill이 많아질수록 처리 시간이 늘어날 것이라고 예상했습니다.
-
Linux Kernel의 Writeback이 Task를 막을 것이다.
- Spill이 발생하면 데이터를 디스크에 기록해야 합니다.
- 이때 Linux의 Page Cache에 쌓인 데이터가 실제 디스크로 기록되는 과정이 발생합니다.
- 저는 데이터가 너무 많이 몰리면 Kernel의 Writeback이 병목이 되어, 디스크 쓰기를 기다리느라 Task가 멈추는 구간이 나타날 것이라고 예상했습니다.
-
Executor의 Core를 늘리면 Spill이 더 빨리 발생할 것이다.
- 하나의 Executor에서 동시에 실행할 수 있는 Task가 많아지면, 여러 Task가 메모리를 동시에 사용하게 됩니다.
- 따라서 Task 하나가 사용할 수 있는 메모리가 줄어들고, 각 Task가 더 일찍 메모리 한계에 도달해 Spill이 발생할 것이라고 예상했습니다.
그런데 실제 결과는 이 예상과 상당히 달랐습니다.
1번, 3번은 완전히 틀렸으며, 4번은 결론 자체는 맞았지만 그 이유가 틀렸습니다. 2번만 일부 맞았습니다.
1.3 무엇을 가지고 측정했나
Skew가 커질 때 처리 비용이 어떻게 달라지는지 확인하려면 Skew를 원하는 수준으로 조절할 수 있어야 했습니다. 그래서 먼저 Data Generator 부터 만들었습니다.
💬 데이터
스키마는 두 개의 컬럼으로 단순하게 구성했습니다.
key     : int      -- join / group key
payload : string   -- everything else. this sets the row width
key   payload
----  --------------------------------------------------
   0  a3f1c8...9b2e   (sha2 hashes concatenated, then cut to length)
4821  7d09ee...41ca
   0  b57a20...3f88
- Cold Key는 10,000개이고, 여기에 행을 균등하게 분산시킵니다.
- Hot Key는 0번 하나이고, 여기에 행을 집중시킵니다.
여기서 Hot과 Cold는 Spark의 용어가 아니라 단순히 "바쁜 쪽"과 "한가한 쪽"을 구분하기 위해 사용한 표현 입니다. 행이 몰린 Key가 Hot Key이고, 그 Key가 Hash Partitioning을 통해 들어간 Partition이 Hot Partition입니다. 나머지는 Cold Partition입니다. 캐시나 스토리지에서 트래픽이 특정 구역에 집중되는 것을 Hotspot이라고 부르는 것과 비슷한 비유입니다.
payload는sha2값을 이어 붙여 생성합니다. 충분한 엔트로피를 확보하기 위해서입니다.- Parquet은 무압축으로 저장합니다.
이 두 가지는 실험을 위한 조건입니다. Payload가 반복되는 데이터이거나 Parquet의 압축률이 높아지면, 행의 크기를 늘려도 실제 파일 크기는 예상만큼 늘어나지 않을 수 있습니다. 예를 들어 행 하나에 들어가는 데이터를 2배로 늘렸는데도 압축이 잘되어 전체 파일 크기가 거의 변하지 않는다면, 실제로는 행 폭과 총 Data 크기를 독립적으로 조절하기 어려워집니다.
그러면 뒤에서 진행할 “행의 폭만 바꾸고, 총 Data 크기는 동일하게 유지하는 실험” 에서 한 가지 변수만 바꾼다는 조건이 깨집니다. 따라서 실험에서는 압축률이나 데이터 중복 때문에 파일 크기가 달라지는 요소를 최대한 배제하고, 행 폭과 총 Data 크기를 각각 독립적으로 통제할 수 있는 데이터를 만들어야 합니다.
💬 Skew 만들기
전체 N개의 행 중 비율 f를 Hot Key 하나에 몰아줍니다. Hash Partitioning에서는 같은 Key가 반드시 같은 Partition으로 가기 때문에, Partition이 P개일 때 Hot Partition과 중앙값 Partition의 비율은 다음과 같이 계산할 수 있습니다.
S = ((1-f)N/P + fN) / ((1-f)N/P)
  = 1 + f·P/(1-f)

⇒  f = (S - 1) / (P + S - 1)
예를 들어 Skew 64를 만들려면 f = 0.2395입니다.
전체 행의 약 24%를 하나의 Key에 몰아주는 셈입니다.
확실한 지표가 있으면 좋으니, 실제로 측정했습니다.
| 목표 Skew | 1 | 2 | 4 | 8 | 16 | 32 | 64 |
|---|---|---|---|---|---|---|---|
| 실측 | 1.4 | 1.9 | 3.9 | 7.8 | 15.7 | 31.4 | 63.0 |
💬 Parquet 파일 크기 보정
처음에는 행 수를 단순히 총 바이트 ÷ 행 폭으로 계산했습니다. 너무 당연한 계산이라고 생각했는데, 실제 결과는 이랬습니다.
row width 256B →  7.745 GiB  (target 8 GiB, -3.2%)
row width  64B →  6.773 GiB  (target 8 GiB, -15.4%)   ← 12.8%p apart
문제는 Parquet의 고정 오버헤드였습니다. 길이 접두사, Page와 Column Metadata, Footer 등의 오버헤드는 행 폭에 비례하지 않습니다. 따라서 행이 좁을수록 전체 Data에서 오버헤드가 차지하는 비중이 커집니다.
이걸 모르고 넘어갔다면 "행 폭을 좁혔더니 느려졌다"는 결과가 정말 행 폭 때문인지, 아니면 Data가 15% 적어서 그런 것인지 구분할 수 없었을 것입니다. 뒤에서 나올 중요한 발견 하나가 통째로 무너질 뻔했습니다. 그래서 추정식을 버리고, 작은 샘플을 실제로 작성한 뒤 실제 바이트/행을 측정해서 전체 행 수를 역산하도록 수정했습니다.
샘플 역시 본 Data와 같은 모양으로 만들어야 했습니다. Key를 상수로 두면 Dictionary Encoding이 과하게 적용되고, 파일당 행 수가 달라지면 Footer 비중도 달라집니다. 수정한 뒤 오차는 -0.3~0.0% 수준으로 줄었고, 무엇보다 행 폭에 따라 오차가 달라지지 않았습니다.
이제야 "행 폭만 바꾸고 총 Data 크기는 고정한다" 는 다음 실험의 조건을 제대로 맞출 수 있었습니다.
💬 어떤 연산을 측정할 것인가
제가 측정하려는 것은 Hot Partition 하나가 비싸지는 과정입니다. 그러려면 Hot Partition이 실제로 만들어져야 합니다. 그런데 연산에 따라서는 Partition이 만들어지기도 전에 Data가 이미 줄어들어버립니다. 따라서 아무 연산이나 선택해서는 안 됩니다.
대표적으로 groupBy().count()가 그렇습니다. count는 셔플 전에 각 노드에서 부분적으로 집계할 수 있습니다. Hot Key에 1억 개의 행이 몰려 있어도 셔플을 넘어가는 것은 (Key, 개수) 한 줄뿐입니다.
원본 행이 그대로 몰린 거대한 Hot Partition은 만들어지지 않습니다. sum, max처럼 부분 결과를 합칠 수 있는 연산도 같은 문제를 가집니다. 반면 정렬은 count처럼 각 노드에서 결과를 하나의 값으로 축약할 수 없습니다. 정렬 대상이 되는 행 자체가 Shuffle을 통과한 뒤 각 Partition에서 정렬되어야 합니다.
Hot Key에 몰린 행이 하나도 빠짐없이 셔플을 통과하고, 모두 정렬기를 거치게 됩니다. 제가 보고 싶은 경로가 그대로 나타납니다. 그래서 실험을 다음과 같이 고정했습니다.
spark.read.parquet(...)
  .repartition(200, "key")            # shuffle. the hot key piles into one partition
  .sortWithinPartitions("key", "payload")
  .write.format("noop")               # discard the output, force the computation
repartition(200, "key")가 Hot Partition을 만들고, sortWithinPartitions가 해당 Partition의 모든 행을 정렬기로 통과시킵니다. noop은 결과를 실제로 저장하지 않으면서 연산을 끝까지 실행시키는 Sink입니다. 파일 쓰기 시간을 측정에 섞지 않기 위해 사용했습니다.
💬 측정 환경
| 항목 | 값 |
|---|---|
| 인스턴스 | EC2 m6id.4xlarge 스팟 (Intel Xeon 8375C, 16 vCPU / 61 GB) |
| 저장장치 | 인스턴스 스토어 NVMe (측정마다 Page Cache Drop) |
| Spark | 4.0.1 · JDK 21 · local[N] 단일 노드 |
| Data | 8 GiB · 200 Partition · 결정론적 시드 (2.1의 실무 편은 1 GiB·4 GiB) |
| Executor Memory | 1500m → 실행 메모리 풀 720 MiB |
실행 메모리 풀은 Spark의 Unified Memory Manager에 의해 다음과 같이 계산됩니다.
(1500 MB − 300 MB reserved) × spark.memory.fraction(0.6)
= 720 MiB
이 720 MiB가 이 글에서 계속 등장합니다. 기억해두면 뒤의 실험을 이해하기 편합니다. 또한, 매 측정마다 Page Cache를 비웠습니다. Cache를 비우지 않으면 두 번째 실행부터 파일이 이미 메모리에 올라가 디스크를 읽지 않게 됩니다. 이런 통제가 조용히 실패하는 것이 가장 위험하기 때문에, Cache Drop에 실패하면 해당 실행 자체를 중단하도록 했습니다.
2. 본론
2.1 실험 전에, Skew 에 대하여
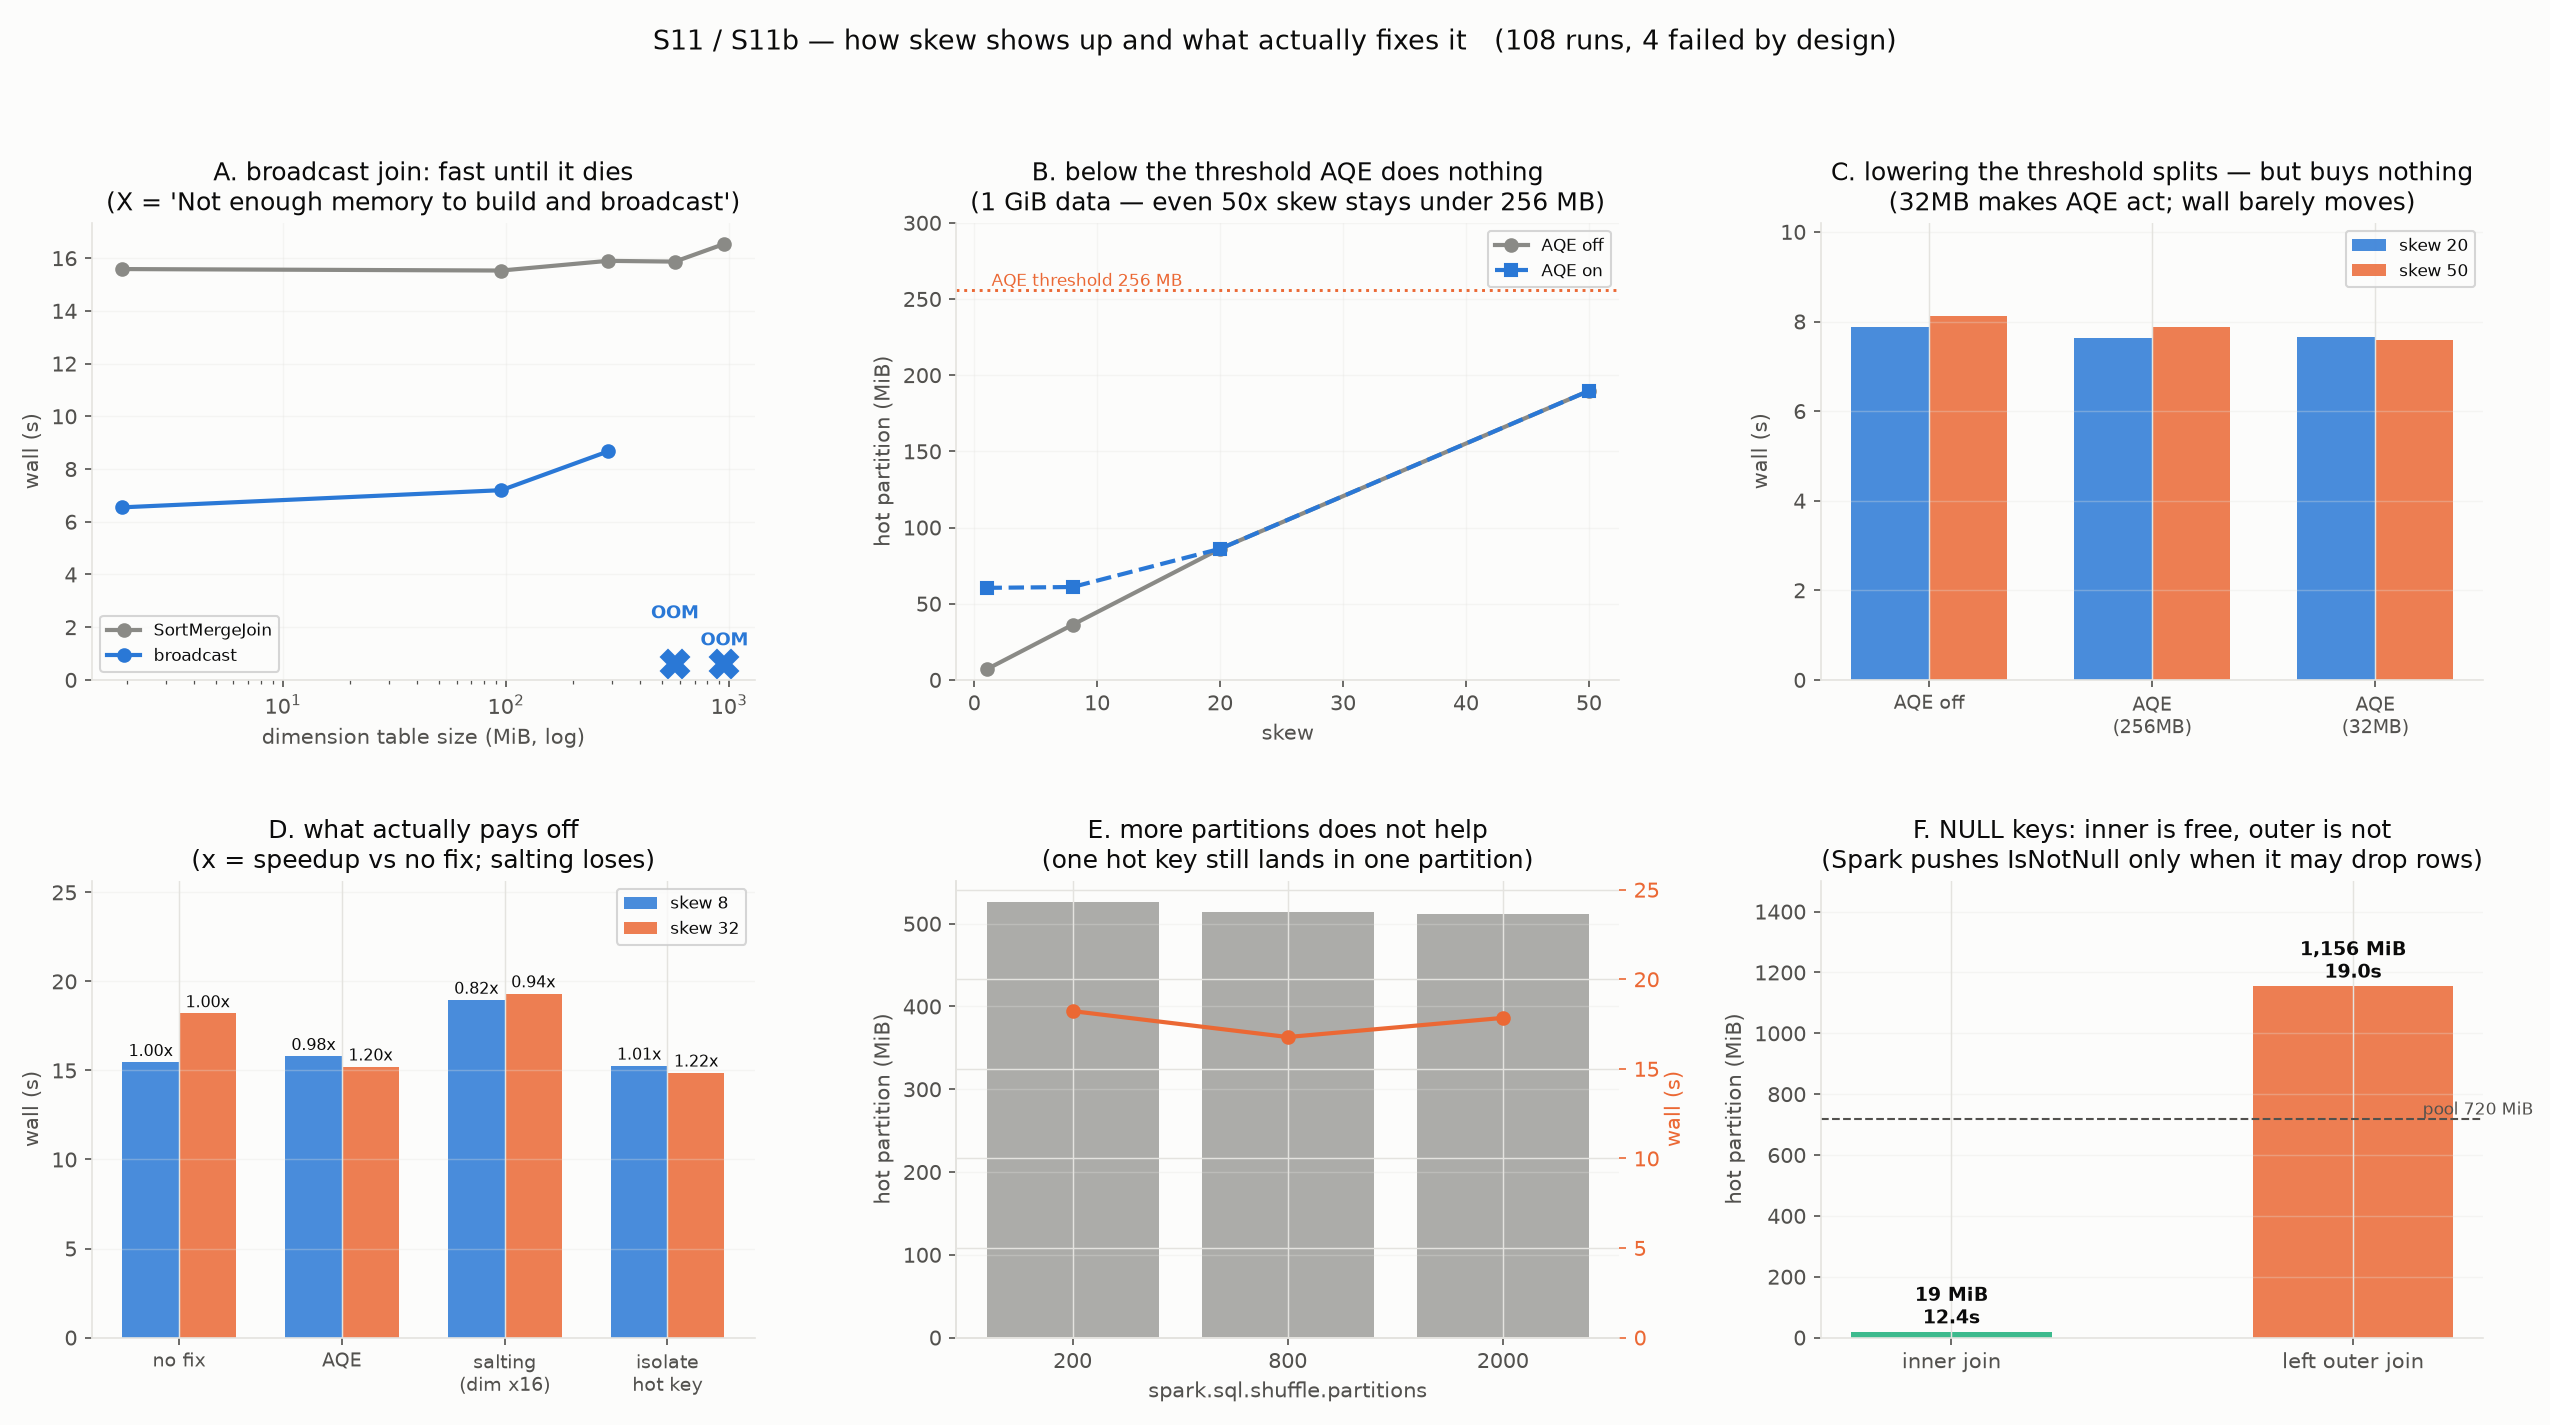
본격적으로 처리 비용을 살펴보기 전에, 먼저 현장에서 Skew를 만났을 때 어떤 처방이 실제로 작동하는지부터 정리하겠습니다. 아래 결과는 모두 직접 측정한 값입니다. 총 108 Run을 사용했습니다.
💬 Skew가 생기는 곳
Join이나 Group By를 수행하려면 같은 Key를 가진 행을 한곳에 모아야 합니다. 그래야 서로 비교하거나 합칠 수 있습니다. Spark는 이를 Key의 Hash값으로 처리합니다.
partition = hash(key) % numPartitions
여기서 두 가지 성질이 따라옵니다.
- 같은 Key는 반드시 같은 Partition으로 갑니다. 정확성을 위해 필요한 성질입니다.
- 따라서 하나의 Key에 행이 몰리면 그 몰림을 나눌 수 없습니다. Hash가 그 Key를 어디로 보내더라도 결국 한 Partition입니다.
Skew가 어려운 이유가 바로 여기에 있습니다. Data가 많다는 것 자체가 문제가 아니라, 더 이상 나눌 수 없는 덩어리가 생긴다는 것이 문제입니다. 현업에서 흔히 볼 수 있는 형태는 다음과 같습니다.
- Join: 특정 고객 ID, 특정 상품 코드,
'UNKNOWN'같은 기본값에 거래가 몰립니다. - Group By: 특정 집계 Key에 원본 행이 몰립니다.
- NULL: NULL도 하나의 값으로 취급되기 때문에 같은 Partition으로 몰릴 수 있습니다. 이 부분은 뒤에서 따로 살펴봅니다.
다음으로는 기본적으로 Skew 를 해결하는 방법을 보겠습니다.
💬 Broadcast Join
작은 쪽 테이블을 모든 노드에 Broadcast하면 Join을 위한 Shuffle 자체를 없앨 수 있습니다. 따라서 한쪽 Partition에 데이터가 몰리는 Skew가 있어도 영향을 크게 받지 않습니다.
문제는 "작은 쪽"이 어디까지인가입니다. Dim Table의 크기를 키워가며 측정했습니다.
| Dim 크기 | Broadcast | SortMergeJoin |
|---|---|---|
| 1.9 MiB | 6.5초 | 15.6초 |
| 95.4 MiB | 7.2초 | 15.5초 |
| 286.1 MiB | 8.7초 | 15.9초 |
| 572.2 MiB | 실패 | 15.9초 |
| 953.7 MiB | 실패 | 16.5초 |
org.apache.spark.SparkException:
  Not enough memory to build and broadcast the table to all worker nodes
286 MiB까지는 약 2.4배 빨랐지만, 그보다 커지자 Job 자체가 실패했습니다. Driver Heap을 1500m로 고정한 환경에서의 결과입니다. 반면 SortMergeJoin은 953 MiB에서도 느려질 뿐, 실행 자체는 유지됩니다.
즉, Broadcast는 성공했을 때는 큰 이득을 얻지만, 한계를 넘으면 단순히 느려지는 것이 아니라 Job 자체가 실패할 수 있습니다.
💬 AQE
Spark 3부터 AQE에는 Skew Join을 자동으로 분할하는 기능이 들어갔습니다. AQE는 모든 Skew를 무조건 쪼개는 것이 아니라, 다음 두 조건을 모두 만족하는 Partition을 Skew로 판단합니다.
size > skewedPartitionThresholdInBytes   // default 256MB
  && size > median * skewedPartitionFactor  // default 5x
쉽게 말하면,
다른 Partition보다 5배 이상 크면서, 동시에 256MB도 넘어야 한다.
는 뜻입니다. 그래서 Data를 1 GiB로 줄이고 Skew를 올려봤습니다.
| Skew | Hot Partition | AQE가 쪼갰나 | 시간 (off / on) |
|---|---|---|---|
| 8 | 36.2 MiB | ✗ | 7.85 / 7.55초 |
| 20 | 86.1 MiB | ✗ | 7.99 / 7.54초 |
| 50 | 189.7 MiB | ✗ | 8.11 / 7.81초 |
Skew가 50배까지 올라갔지만 AQE는 해당 Partition을 쪼개지 않았습니다. Hot Partition이 189.7 MiB로 256MB에 미달했기 때문입니다. 그렇다고 이것을 AQE의 문제라고 보기는 어려웠습니다.
Hot Partition이 189.7 MiB로, 뒤에서 확인할 실행 메모리 한계인 720 MiB보다 충분히 작았기 때문입니다. 임계값을 32MB로 낮춰 AQE가 Partition을 쪼개도록 만들어도 실행 시간은 1.03~1.07배 수준으로 거의 달라지지 않았습니다. 즉, 이번 실험에서 확인한 범위에서는 AQE의 기본 256MB 기준이 실제 성능 문제를 만들지는 않았습니다.
AQE가 실제로 Skew Partition을 분할해서 문제를 완화하는 경우도 있습니다. 다만 이번 글에서는 AQE 자체의 Skew 처리 성능이나 다양한 임계값 튜닝을 깊게 다루지는 않겠습니다. 여기서는 AQE가 "Skew가 있으면 무조건 해결해주는 기능"은 아니며, 명확한 판단 조건에 따라 동작한다는 정도만 확인하고 넘어가겠습니다.
💬 Salting과 Hot Key 분리
Salting은 Hot Key에 임의의 번호를 붙여 여러 Partition으로 나누는 방법입니다. 예를 들어 하나의 Key에 데이터가 몰려 있다면 key_0, key_1, key_2처럼 Salt를 붙여 여러 Partition으로 분산시킬 수 있습니다.
문제는 Join입니다. Salt를 붙인 만큼 반대편 Dim Table도 여러 개로 복제해야 합니다. Hot Key 분리는 조금 다릅니다. 문제가 되는 Key만 따로 떼어 Broadcast Join하고, 나머지 데이터는 기존 방식으로 처리한 뒤 두 결과를 Union합니다. Hot Key에 해당하는 Dim 데이터가 한 행뿐이라면 별도의 대규모 복제가 필요하지 않습니다.
같은 Data를 사용해서 네 가지 방식을 비교했습니다. Data 크기는 4 GiB로 고정했습니다.
| 처방 | Skew 8 | Skew 32 |
|---|---|---|
| 무처리 | 15.46초 | 18.20초 |
| AQE | 15.80초 (0.98×) | 15.21초 (1.20×) |
| Salting (dim ×16) | 18.96초 (0.82×) | 19.32초 (0.94×) |
| Hot Key 분리 | 15.26초 (1.01×) | 14.87초 (1.22×) |
결과는 예상보다 분명했습니다.
Salting은 두 경우 모두 무(無)처리보다 느렸습니다.
Hot Partition은 525.9 MiB에서 50.5 MiB까지 줄었습니다. Skew 자체는 확실하게 완화됐습니다. 그런데 Dim Table을 16배 복제하면서 생긴 비용이 컸습니다. Partition을 잘게 나누는 데는 성공했지만, 그 과정에서 생긴 복제 비용이 성능 이득을 넘어섰습니다.
반면 Hot Key 분리는 Skew 32에서 18.20초 → 14.87초로 줄었습니다. Skew 8에서도 15.46초 → 15.26초로 거의 손해가 없었습니다. 이번 실험에서는 문제가 되는 Key를 알고 있다면 굳이 전체 데이터를 Salting하는 것보다 해당 Key만 따로 처리하는 편이 더 단순했고, 성능도 좋았습니다.
다만 여기서 사용한 Salting은 모든 Key에 Salt를 붙이고 Dim Table 전체를 16배 복제하는 단순한 구현입니다. Hot Key에만 Salt를 적용하는 방식이라면 결과는 달라질 수 있습니다.
💬 Partition 수 증가의 한계
Skew를 만나면 가장 먼저 spark.sql.shuffle.partitions를 늘리는 경우가 많습니다. 직접 재봤습니다.
| Partitions | Hot Partition | 시간 |
|---|---|---|
| 200 | 525.9 MiB | 18.22초 |
| 800 | 513.9 MiB | 16.78초 |
| 2000 | 512.0 MiB | 17.84초 |
Partition 수를 10배로 늘려도 Hot Partition은 고작 2.6% 줄었습니다. 당연한 결과입니다. Key 하나에 몰린 행은 Partition 수를 아무리 늘려도 결국 하나의 Partition에 남습니다.
Hash Partitioning에서는 같은 Key가 같은 Partition으로 가기 때문입니다. 전체 Spill은 462.8 MiB에서 131.2 MiB로 줄었습니다. 하지만 이것은 Hot Partition이 크게 줄어서가 아니라 나머지 Partition들이 작아졌기 때문입니다.
결국 Job을 붙잡고 있던 것은 Hot Task 하나였기 때문에, 전체 실행 시간은 크게 줄지 않았습니다.
💬 NULL Key와 Join 종류
NULL도 같은 Partition으로 몰릴 수 있습니다. 그런데 Join 종류에 따라 결과가 크게 달라졌습니다. Data의 30%를 NULL Key로 만들어 측정했습니다.
| 시간 | Hot Partition | |
|---|---|---|
| Inner Join | 12.42초 | 19.4 MiB |
| Left Outer Join | 18.95초 | 1,155.6 MiB |
약 59배 차이입니다. 이유는 실행 계획에서 그대로 확인할 수 있었습니다.
inner:  PushedFilters: [IsNotNull(key)]
        Filter: isnotnull(key)
        Exchange                    ← the filter sits before the shuffle

outer:  Scan parquet (no filter)
        Exchange                    ← NULLs go straight into the shuffle
Inner Join에서는 NULL Key가 Join 결과에 포함될 수 없기 때문에 Spark가 IsNotNull 조건을 추론할 수 있습니다. 이 조건은 Parquet Scan까지 Pushdown되어 Shuffle이 시작되기 전에 NULL 행을 제거합니다. 반면 Left Outer Join에서는 NULL Key를 가진 행도 결과에 남아야 하기 때문에 같은 최적화를 적용하기 어렵습니다.
따라서 "NULL 때문에 느려졌다"는 설명은 Join 종류를 구분하지 않으면 정확하지 않습니다. Inner Join에서는 NULL이 애초에 Shuffle 전에 제거될 수 있지만, Outer Join이나 Group By에서는 NULL이 실제 데이터로 남아 Skew의 원인이 될 수 있습니다. 여기까지가 기본적으로 "Skew 를 어떻게 막는가" 에 대한 이야기였습니다.
이제부터는 "왜 비싸지는가" 를 보겠습니다.
2.2 처리 비용의 계단형 증가
첫 실험은 로컬 WSL2에서 35 Run으로 시작했습니다. 결과는 예상과 달랐습니다. 처리 비용이 Data 양에 따라 조금씩 증가하는 것이 아니라, 특정 지점에서 한 번에 올라간 뒤 다시 평평해지는 계단 형태로 나타났습니다.
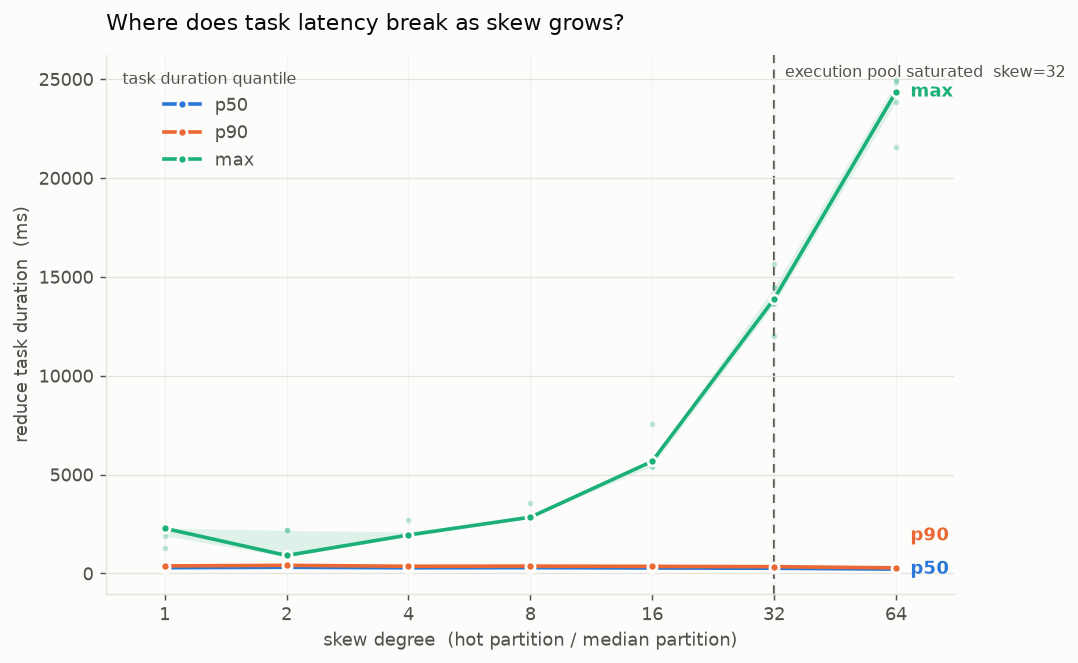
세로축은 MB당 처리 시간입니다. Data 양에 따른 영향을 나눠서 봤기 때문에, 비용이 Data 양에 비례한다면 그래프는 대체로 수평에 가까워야 합니다. 하지만 실제 결과는 그렇지 않았습니다. 두 개의 평탄한 구간이 있었고, 그 사이에서 처리 비용이 한 번 크게 올라갔습니다.
| 구간 | MB당 시간 |
|---|---|
| Skew 8 ~ 16 | 10.2 ms/MB (평탄) |
| Skew 32 ~ 64 | 13.6 ms/MB (평탄) |
| 차이 | +31% |
두 구간의 차이는 13.58 − 10.36 = 3.22 ms/MB였습니다. 5회 반복 측정에서 발생한 흔들림을 나타내는 IQR은 각각 0.56, 0.82였기 때문에, 계단의 크기는 반복 산포보다 약 4~6배 컸습니다. 단순한 측정 오차로 보기에는 차이가 컸습니다.
즉, 같은 1 MB의 Data를 처리하더라도 어느 구간에 있느냐에 따라 처리 비용이 약 31% 달라졌습니다. 더 중요한 것은 이 변화가 서서히 나타난 것이 아니라는 점입니다. 특정 지점까지는 비슷한 비용으로 처리되다가, 어느 순간 비용이 한 단계 올라간 뒤 다시 비슷한 수준으로 유지됐습니다.
처음 예상했던 것은 이런 모습이었습니다.
처리 비용
   │
   │     /
   │    /
   │   /
   │  /
   │_/____________ Data
실제로 관측한 모습은 오히려 이쪽에 가까웠습니다.
처리 비용
   │
   │                ┌────────
   │                │
   │──────────┘
   │
   └────────────────── Data
Partition에 들어오는 데이터가 많아질수록 처리 비용이 비례해서 증가하는 것이 아니라, 특정 조건을 넘는 순간 처리 비용의 수준 자체가 바뀌고 있었습니다.
2.3 실행 메모리 한계와 Spill
처리 시간이 갑자기 달라지는 지점이 어디에서 발생하는지 확인하기 위해 Task 단위 지표를 하나씩 비교했습니다. 가장 눈에 띈 것은 peakExecutionMemory였습니다.
| Skew | 4 | 8 | 16 | 32 | 64 |
|---|---|---|---|---|---|
| Hot Partition 크기 | 142 MB | 283 MB | 547 MB | 1,022 MB | 1,798 MB |
| Peak 실행 메모리 | 176 MB | 184 MB | 544 MB | 712 MB | 712 MB |
| MB당 시간 | 13.64 | 10.05 | 10.36 | 13.58 | 13.55 |
모두 5회 반복의 Median입니다. MB당 시간은 최대 Task 시간 ÷ Hot Partition MB로 계산했습니다.
Skew 32부터 Peak 실행 메모리가 712 MiB 부근에서 더 이상 증가하지 않았습니다. 실행 메모리 풀의 크기가 720 MiB였기 때문에, 실행 메모리 사용이 사실상 상한에 가까워진 것으로 해석할 수 있었습니다.
그리고 처리 시간이 달라지는 지점도 정확히 이 구간에서 나타났습니다.
왜 여기서 달라질까요?
Task가 처리하는 방식이 달라지기 때문입니다.
Partition이 실행 메모리 안에서 처리될 수 있을 때는 Spark가 데이터를 메모리에 유지하면서 정렬을 진행할 수 있습니다. 하지만 필요한 메모리가 풀을 넘어가면 UnsafeExternalSorter가 데이터를 디스크로 Spill하기 시작합니다.
fill → sort and spill to disk → empty → fill again → ...
at the end, read every spilled run back and merge them
메모리가 부족해질 때마다 데이터를 디스크에 쓰고, 마지막에는 여러 개의 Spill Run을 다시 읽어 Merge해야 합니다. 정렬만 한 번 수행하는 것과 달리 디스크 쓰기와 읽기, 여러 Run의 Merge가 추가됩니다. Data가 조금 더 많아진 것이 아니라 처리 경로 자체가 달라지는 것입니다.
그래서 처리 비용도 부드럽게 증가하지 않고, 특정 지점에서 한 번에 올라갑니다. 여기서 중요한 것은 이 전환점이 단순히 Partition의 Data 크기만으로 결정되는 것이 아니라, Task가 사용할 수 있는 실행 메모리의 한계와 함께 나타난다는 점입니다. 그렇다면 이 현상이 특정 머신의 특성인지, Spark의 실행 메모리 관리에서 발생하는 현상인지 확인할 필요가 있었습니다.
그래서 같은 실험을 로컬 WSL2와 EC2에서 각각 실행했습니다.
| 로컬 WSL2 | EC2 m6id.4xlarge | |
|---|---|---|
| MB당 시간 (Skew 16 → 32) | 10.36 → 13.58 | 8.90 → 10.92 |
| 계단 크기 | +31% | +22.7% |
| 계단 위치 | Skew 16 → 32 | Skew 16 → 32 |
| Peak 실행 메모리 (Skew 1·2·4·8·16·32·64) | 72 / 96 / 176 / 184 / 544 / 712 / 712 MiB | 72 / 96 / 176 / 184 / 544 / 712 / 712 MiB |
절대적인 처리 시간도 다르고, 계단의 크기도 달랐습니다. 로컬에서는 +31%, EC2에서는 +22.7%였습니다. 그런데 Peak 실행 메모리는 일곱 개 지점에서 MB 단위까지 동일했습니다. 머신이 달라지면 전체적인 처리 속도와 Spill 비용은 달라지지만, 실행 메모리가 한계에 도달하면서 처리 방식이 바뀌는 지점은 동일하게 나타났습니다.
결국 앞에서 본 계단은 단순히 Data가 많아져서 생긴 것이 아니었습니다. 이번 실험에서는 실행 메모리 한계에 도달하는 지점과 Spill이 시작되는 지점이 함께 나타났고, 그 시점부터 처리 비용이 한 단계 증가했습니다.
2.4 레코드 수와 실행 메모리
다음 질문은 이것이었습니다. 같은 8 GiB의 Data라도 64바이트 행 약 1.3억 개와 1024바이트 행 약 840만 개는 같은 비용이 들까요? 행 폭 3종 × Skew 6단계 × 5회, 총 90 Run을 돌려 비용을 분해했습니다.
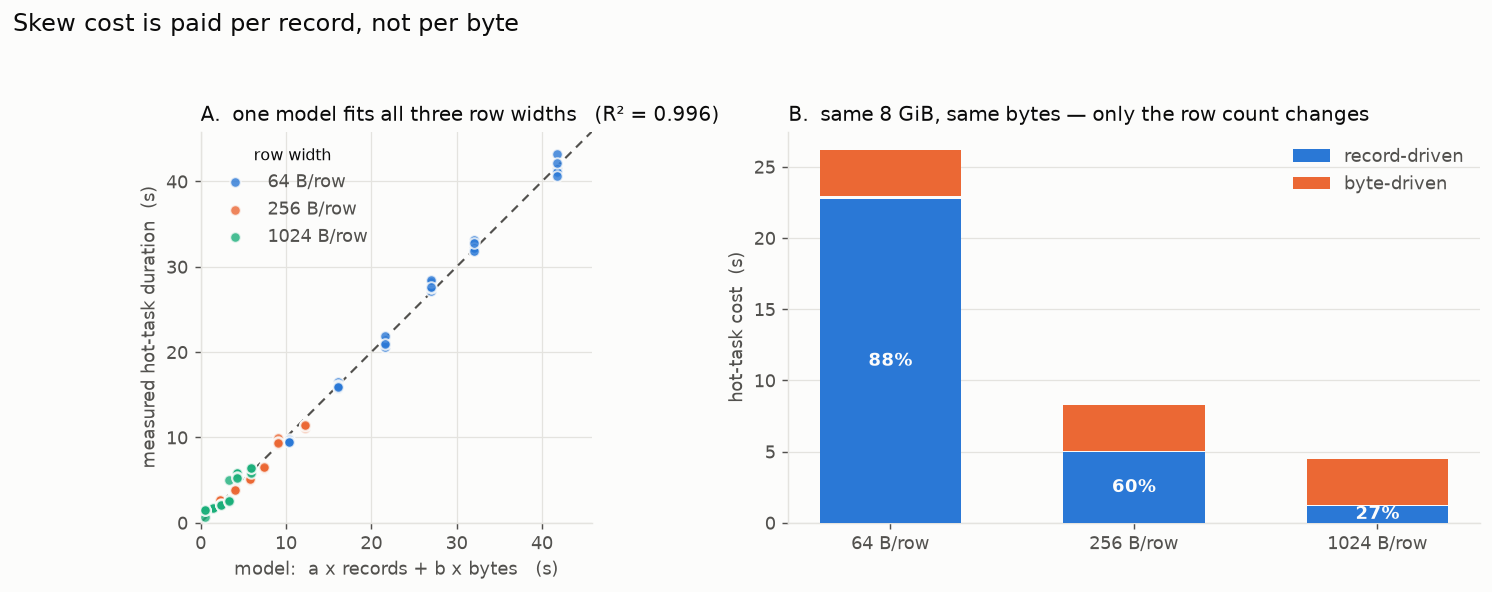
duration_ms = 1741 ns × records + 4.95 ns × bytes − 1602
R² = 0.9958   (n = 90)
계수의 크기를 비교하면, 레코드 수에 따른 비용 계수가 바이트 수에 따른 계수보다 약 350배 정 컸습니다.
| 행 폭 | 비용 중 레코드가 차지하는 비율 |
|---|---|
| 64 B | 88% |
| 256 B | 58% |
| 1024 B | 27% |
좁은 행을 많이 처리할수록 비용의 대부분은 Data의 바이트 수보다 행의 개수에서 발생합니다. 왜 레코드 수가 많을수록 비용이 커질까요? UnsafeInMemorySorter는 행 전체를 정렬하지 않고, 각 행을 가리키는 record pointer 를 별도로 만들어 이를 정렬합니다.
정렬할 때는 실제 행 Data가 아니라 이 주소 정보를 비교하고 재배치합니다.
[row data ]  ...64B... ...64B... ...64B...   ← never moves
[addresses]   16B      16B      16B          ← only this gets sorted
              (pointer + prefix of the sort key)
행 전체를 계속 이동시키는 것보다 훨씬 효율적인 구조입니다. 대신 행 하나마다 고정적인 추가 공간이 필요합니다. 따라서 행이 좁을수록 이 오버헤드가 상대적으로 커집니다.
| 행 폭 | 행 Data 대비 추가되는 양 |
|---|---|
| 64 B | +25% (64B 옆에 16B) |
| 256 B | +6.3% |
| 1024 B | +1.6% |
그래서 실제로도 이런 차이가 나타났습니다.
out of a 720 MiB pool
  1024 B rows : uses up to  712 MiB   (99% of the pool)
    64 B rows : stops at    536 MiB   (74% of the pool)
좁은 행은 실행 메모리 풀의 74% 정도만 사용하고도 한계에 도달했습니다. 행마다 추가되는 주소 정보가 있기 때문에, 같은 바이트 수의 Data라도 행이 많을수록 메모리 사용량이 더 커지는 것으로 해석할 수 있습니다.
다만 여기서 536 MiB라는 값을 내부 할당을 직접 추적해서 증명한 것은 아닙니다. 관측된 결과와 가장 잘 맞는 해석으로 보는 것이 정확합니다.
2.5 AQE의 Skew 판정 기준
소스 코드를 따라가 OptimizeSkewedJoin.scala의 판정 로직을 확인했습니다. 실제 판정은 ShufflePartitionsUtil을 거치며, 핵심적으로 bytesByPartitionId를 사용합니다.
// the test, in short
size > SKEW_JOIN_SKEWED_PARTITION_THRESHOLD        // default 256MB
  && size > median * SKEW_JOIN_SKEWED_PARTITION_FACTOR  // default 5x
판정에 사용하는 값은 모두 바이트입니다. 행 수는 사용하지 않습니다. 코드를 더 따라가 보니, 단순히 "행 수를 안 보는 것"만의 문제도 아니었습니다. AQE가 사용하는 통계 객체 자체가 다음과 같이 구성되어 있습니다.
class MapOutputStatistics(
    val shuffleId: Int,
    val bytesByPartitionId: Array[Long])   // these two, and nothing else
Partition별 행 수라는 값이 애초에 없습니다. 비슷한 이름의 recordsByPartitionId가 있기는 하지만, 이것은 Map Task 단위의 행 수이지 Shuffle 이후 Partition별 행 수가 아닙니다. 따라서 단순히 AQE의 조건에 "행 수"를 하나 추가하는 것으로 끝나는 문제는 아닙니다.
Shuffle 단계부터 Partition별 행 수를 별도로 집계하고, 이를 다음 단계까지 전달하는 과정이 필요합니다. 흥미로운 점은 이 기능을 처음 도입한 SPARK-29544의 설명입니다.
runtime statistics (data size and row count)
설명문에는 행 수가 언급되어 있지만, Spark 4.0.1의 실제 구현에서는 Partition별 행 수를 AQE Skew Join 판정에 사용하지 않습니다. 설계 의도와 실제 구현이 어느 시점에서 달라졌는지는 커밋 히스토리를 끝까지 추적하지 않았기 때문에 여기서는 판단하지 않겠습니다. 다만 2.4에서 확인했듯이 실제 처리 비용을 크게 좌우하는 요소 중 하나가 레코드 수라면, 다음과 같은 Partition도 만들어질 수 있습니다. 바이트로는 평범해 보이지만 행 수만 극단적으로 많은 Partition입니다.
AQE의 기준에서는 특별하지 않지만, 실제 실행 비용은 크게 달라질 수 있습니다. 이를 직접 만들어 확인했습니다. Hot Key에는 좁은 행(64 B)을 많이 넣고, Cold Key에는 넓은 행(2048 B)을 넣어 바이트 크기는 거의 균등하지만 행 수는 최대 64배 차이 나는 Data를 만들었습니다.
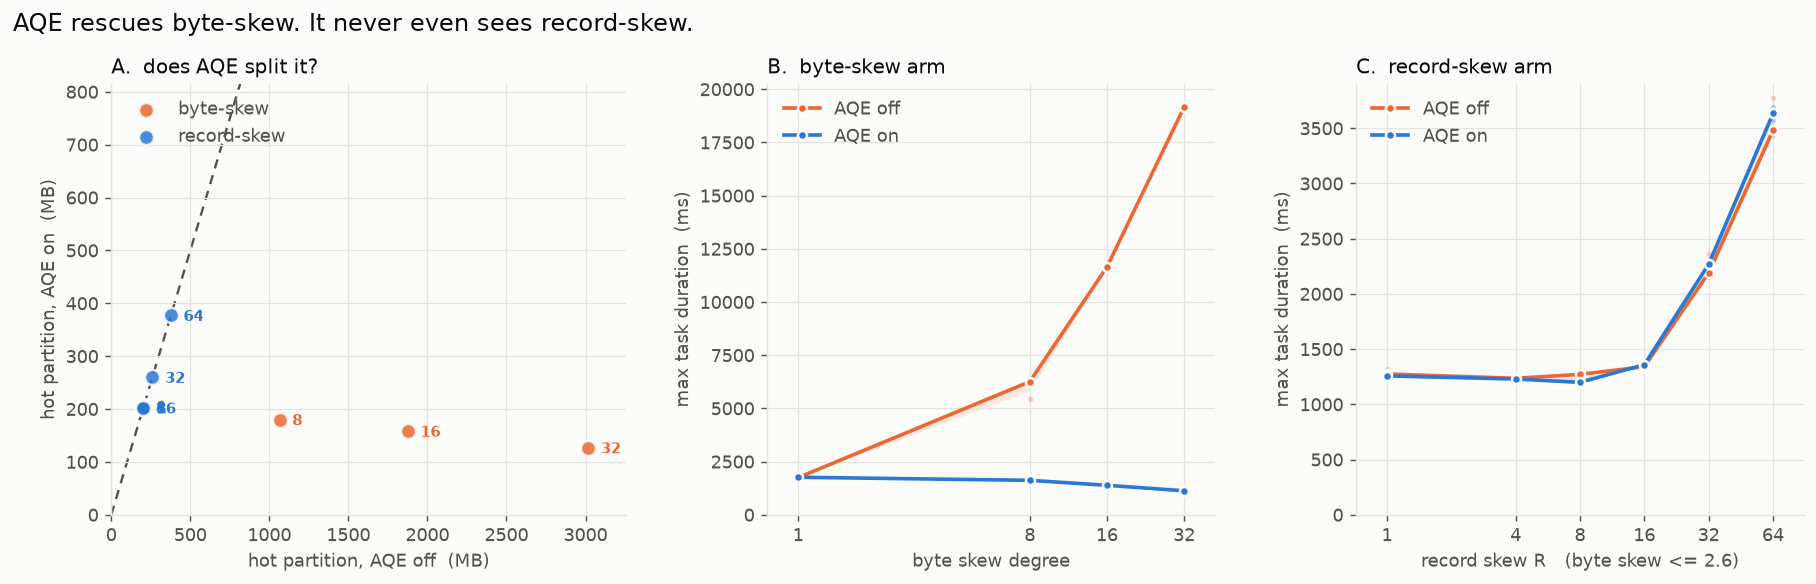
결과는 다음과 같았습니다.
| Data 종류 | AQE 감지 |
|---|---|
| Byte-Skew | 3 / 3 감지 |
| Record-Skew | 0 / 6 감지 |
AQE 자체가 Skew를 처리하지 못하는 것은 아닙니다. Byte-Skew에서는 실제로 잘 작동했습니다. Skew 32에서 최대 Task 시간은 19,164ms에서 1,127ms로 약 17배 감소했습니다. 문제는 AQE가 판정에 사용하는 바이트 크기만으로는 드러나지 않는 형태의 Skew도 존재한다는 것입니다.
그리고 감지되지 않은 쪽의 실제 처리 시간도 더 길었습니다.
byte-skew 8   AQE splits it   6,256ms → 1,618ms   (3.9x faster)
record R=64   AQE leaves it   3,481ms → 3,634ms   (no change)
AQE가 분할한 Partition은 1,618ms였지만, 감지하지 못한 Partition은 3,634ms가 걸렸습니다. 약 2.2배 차이입니다. 즉, AQE는 바이트 기준의 Skew에는 대응할 수 있지만, 바이트 크기는 비슷하면서 레코드 수 때문에 처리 비용이 커지는 Skew는 현재 판정 기준으로 잡아내지 못한다고 볼 수 있습니다.
2.6 Kernel Writeback과 디스크 I/O
1.2에서 세 번째로 세웠던 가설은 Kernel Writeback이 Task를 막을 것이라는 것이었습니다. 실험 계획의 상당 부분이 이 가설에 걸려 있었습니다. Linux 설정 vm.dirty_ratio를 20%에서 2%로 낮췄습니다. Kernel이 훨씬 이른 시점부터 Dirty Page를 디스크로 밀어내도록 만든 것입니다.
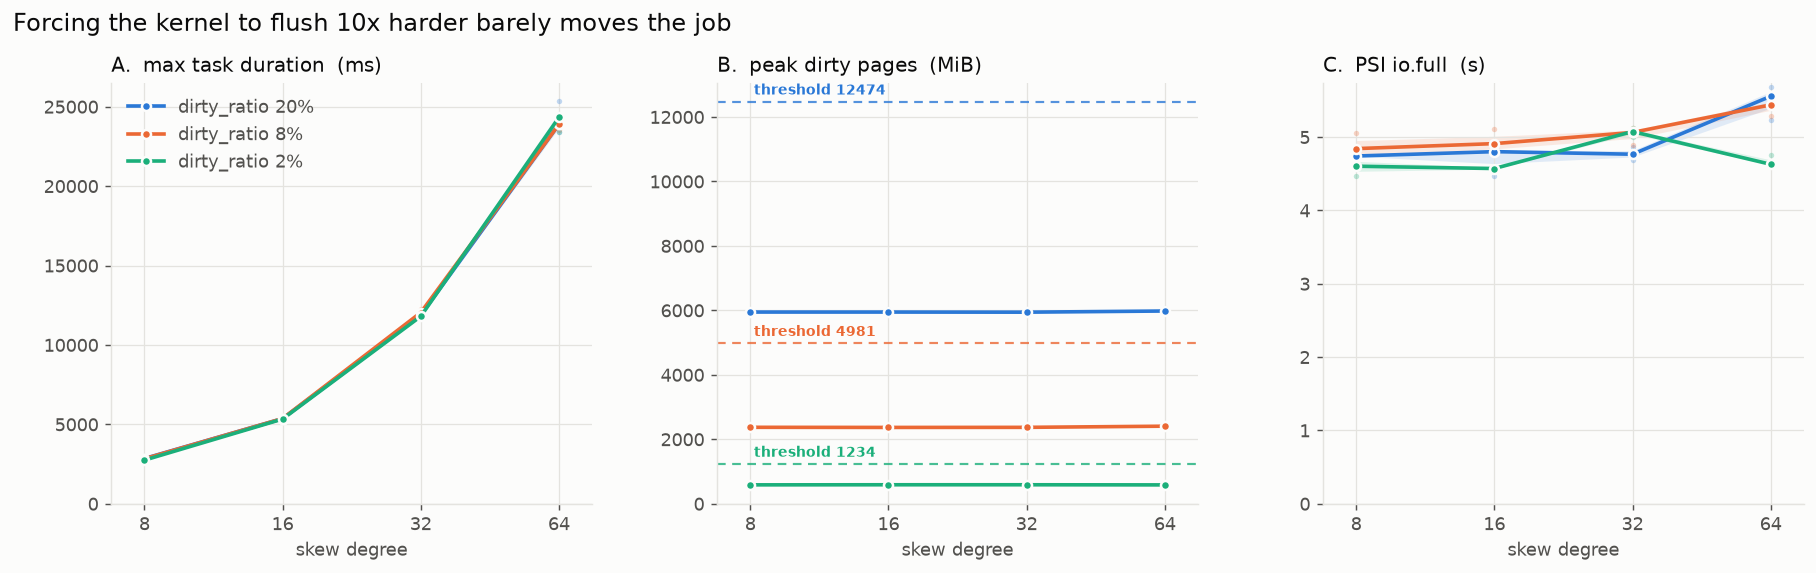
설정 변경 자체는 확실하게 작동했습니다. Cache에 쌓이는 Dirty Data는 5,952 MiB에서 587 MiB로 약 10분의 1이 됐습니다. 그런데 Job 시간은 변하지 않았습니다. 전체 구간에서 ±3.6% 이내였고, 반복 측정에서 나타나는 편차 수준이었습니다.
이유는 단순했습니다. Kernel이 Task를 막을 만큼 Writeback이 밀리는 상황 자체가 발생하지 않았던 것입니다.
Spark가 디스크에 쓰는 속도는 초당 약 75 MB였고, 이 NVMe는 초당 약 675 MB를 처리할 수 있었습니다. 디스크가 Spark의 쓰기 속도를 충분히 따라갈 수 있는 상황이었습니다. 따라서 dirty_ratio를 20%에서 2%로 낮춰 Writeback을 더 일찍 시작하게 만들어도, 디스크가 충분히 빠르면 Writeback이 Task의 병목이 되지는 않았습니다.
만약, 이 실험을 하지 않았다면 "아마 Kernel이 뭔가 하고 있을 것"이라는 막연한 의심이 계속 남았을 것입니다.
2.7 실행 메모리 할당과 Core 수
1.2에서 세웠던 네 번째 가설입니다.
Executor당 Core를 늘리면 Task 하나가 사용할 수 있는 메모리가 1/N로 줄어들기 때문에, 같은 Skew에서도 더 일찍 Spill이 발생한다.
Core를 1, 2, 4, 6으로 바꿔가며 총 48회 측정했습니다. 메모리와 Data는 고정했습니다.
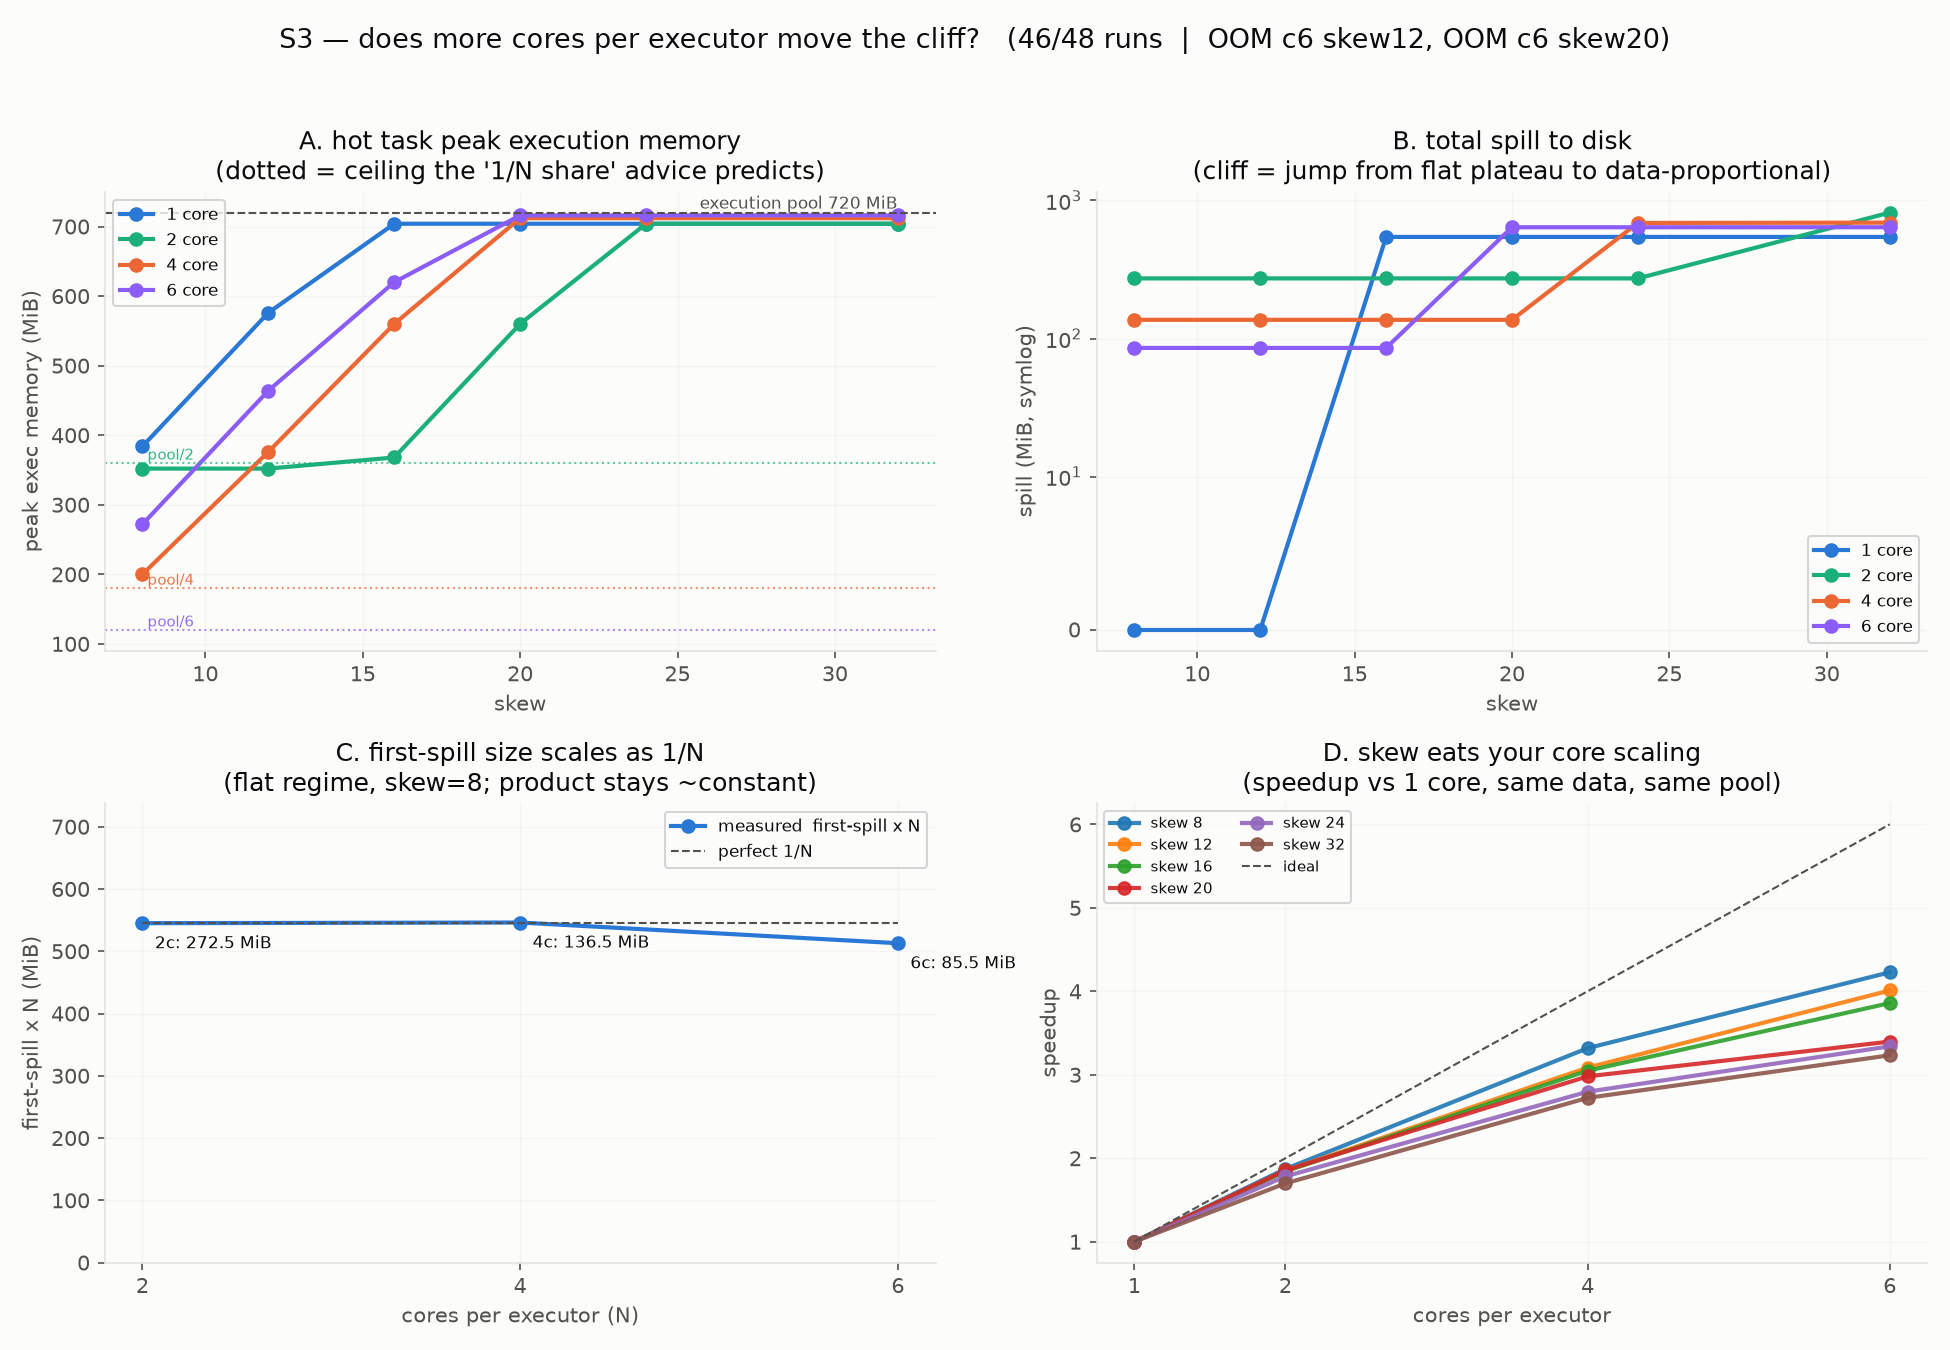
그런데 실제 메모리 사용량은 예상과 달랐습니다.
| Core 수 | 조언의 예측 | 실측 |
|---|---|---|
| 1 | 720 MB | 704 MB |
| 2 | 360 MB | 704 MB |
| 4 | 180 MB | 712 MB |
| 6 | 120 MB | 716 MB |
Core를 6개 줘도 Task 하나는 716 MB까지 사용할 수 있었습니다. 왜 그럴까요? Partition이 200개이고 그중 큰 Partition은 하나뿐이었습니다. 나머지 199개 Task는 빠르게 끝나면서 사용하던 실행 메모리를 반환합니다.
따라서 Spark가 실행을 시작할 때부터 Task마다 메모리를 1/N씩 고정해서 나누는 구조는 아닙니다. Spark의 1/2N ~ 1/N은 Task가 실행 메모리를 확보할 때의 보장 하한이지, Task 하나가 사용할 수 있는 메모리의 절대적인 상한이 아닙니다. 그런데 Spill이 발생하는 시점은 실제로 달라졌습니다.
| Core 수 | 2 | 4 | 6 |
|---|---|---|---|
| Cliff가 오는 Skew | 32 | 24 | 20 |
Core가 많아질수록 더 낮은 Skew에서 성능이 꺾였습니다. 첫 Spill이 발생할 때 Hot Task가 실제로 사용한 메모리를 확인해보니 다음과 같았습니다.
core 1 → 544 MB
core 2 → 272 MB   (1/2 of 544)
core 4 → 136 MB   (1/4 of 544)
core 6 →  85 MB   (1/6 of 544)
첫 Spill 시점의 메모리는 정확히 1/N으로 줄었습니다.
Raw Byte를 확인했을 때도 24개 측정 중 21개가 반복 실행 사이에서 바이트 단위로 동일했습니다. 첫 Spill이 발생하면 해당 Task가 사용하던 메모리가 비워지고, 이후에는 다른 Task가 반환한 메모리까지 사용할 수 있습니다. 그래서 최종 Peak 실행 메모리는 Core 수와 관계없이 약 716 MB까지 올라갈 수 있었습니다.
결국 흔히 하는 설명은 결론은 맞았지만 이유가 달랐습니다. Core 수가 많아지면 Task가 사용할 수 있는 최종 메모리가 단순히 1/N로 고정되는 것이 아니라, 처음으로 메모리를 확보하지 못하는 시점이 앞당겨집니다. Core가 많을수록 첫 Spill이 일찍 발생하고, 그 결과 더 낮은 Skew에서도 Spill 기반 처리로 넘어가게 됩니다.
다만 첫 Spill이 실행 메모리 풀의 75.7% 수준에서 발생한 이유까지는 이번 실험에서 설명하지 못했습니다. 1/N으로 줄어드는 현상은 확인했지만, 그 계수 자체는 미해결로 남겼습니다. 두 가지 관측도 있었습니다.
- Core 6에서만 OOM이 2번 발생했습니다. 실행 메모리 풀은 720 MB를 유지했지만 Heap이 부족해졌습니다. 실행 메모리 풀이 관리하지 않는 Buffer 등이 Core 수에 따라 증가했을 가능성이 있지만,
n=2이므로 여기서는 원인을 확정하지 않고 관측으로만 남겼습니다. - Core를 늘리는 것만으로 Skew가 사라지지는 않았습니다. Core 6에서의 속도 향상은 Skew 8에서 4.23배, Skew 32에서 3.23배였지만, 여전히 약 24%의 비용은 남았습니다.
2.8 연산별 Spill 경로
지금까지의 결과는 대부분 정렬 작업에서 나왔습니다. Join은 AQE 실험에서만 사용했고, 집계는 별도로 검증하지 않았습니다. 그런데 지금까지 확인한 핵심은 정렬 자체가 아니라, 실행 메모리를 사용하다가 한계를 넘으면 Spill 기반 처리로 전환된다
는 것이었습니다. 그렇다면 이 현상이 다른 연산에서도 나타나는지 확인할 필요가 있었습니다. 그래서 Sort, Join, Count를 대상으로 99 Run을 추가로 측정했습니다.
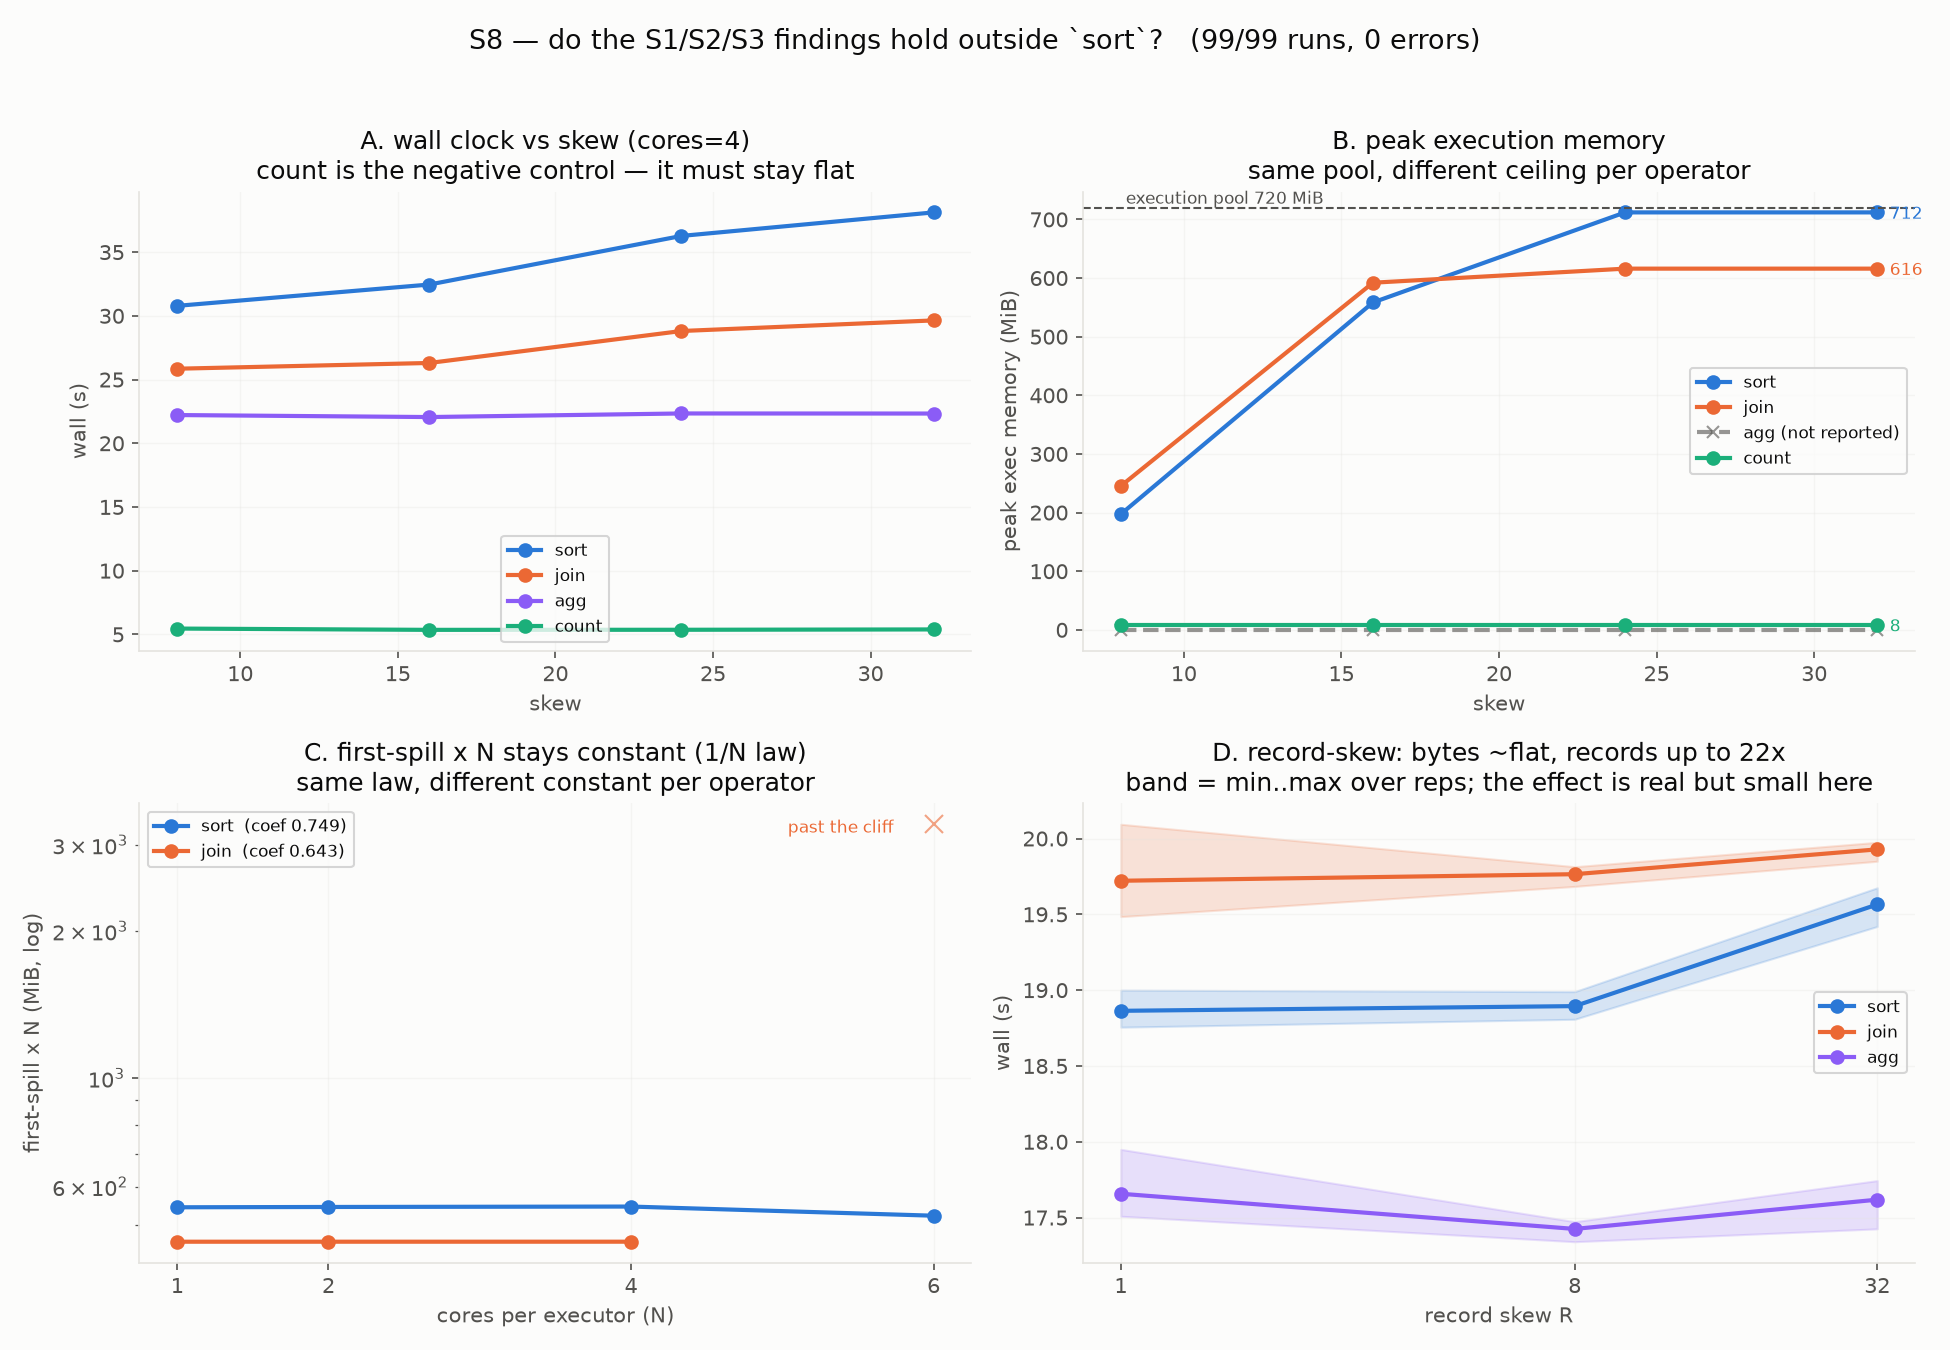
특히 count가 중요했습니다. count는 Shuffle 전에 각 노드에서 부분 집계가 가능하기 때문에, 큰 Hot Partition 자체가 만들어지지 않아야 합니다. 만약 count까지 Skew에 따라 느려진다면 지금까지의 설명을 다시 봐야 합니다.
| 작업 | Skew 8 → 32 시간 | 메모리 최대 |
|---|---|---|
| Sort | 30.8 → 38.1초 | 197 → 712 MB |
| Join | 25.9 → 29.6초 | 245 → 616 MB |
| Count | 5.5 → 5.4초 | 8 → 8 MB |
count는 사실상 평평했습니다. 예상대로 Shuffle 전에 Data가 부분적으로 집계되면서 큰 Hot Partition이 만들어지지 않았고, 지금까지의 설명과도 맞았습니다. Join은 Sort와 마찬가지로 Skew가 커지면서 처리 시간이 증가했고, 메모리 사용량도 특정 지점에서 멈췄습니다.
다만 메모리 천장은 달랐습니다. Sort는 712 MB, Join은 616 MB에서 멈췄습니다. 각각 6회씩 측정했을 때 소수점까지 동일했습니다. SortMergeJoin은 한 Task 안에서 양쪽 Data를 각각 정렬하기 때문에 Sort와 다른 메모리 사용 패턴이 나타난 것으로 해석할 수 있습니다. 다만 내부 할당을 직접 추적한 것은 아니므로, 여기서는 가장 정합적인 해석으로만 남겼습니다.
첫 Spill 시점에서도 같은 패턴이 나타났습니다.
sort first spills at 75.7% of the pool
join first spills at 64.3%

join's first spill × core count = 462.8 MB
(1·2·4 core alike, spread 0.0%)
즉,
법칙은 옮겨가지만 숫자는 그대로 옮겨가지 않습니다.
Sort에서 측정한 실행 메모리 풀의 75.7%라는 값은 Sort의 결과입니다. 다른 연산에서도 Spill이 발생할 수 있지만, 동일한 비율을 그대로 적용할 수는 없습니다.
💬 집계 연산의 한계
collect_list도 확인했습니다. 처음에는 시간이 22.2초에서 22.3초로 거의 변하지 않아 집계는 Skew에 강하다고 해석할 뻔했습니다. 그런데 실험 조건에 문제가 있었습니다.
collect_list(substring(payload, 1, 8))
Payload를 8바이트로 잘라버리면서 Shuffle Data가 원래 크기의 32분의 1로 줄어들었습니다. 원래 1,054 MB가 되어야 할 Hot Partition이 52 MB밖에 되지 않았고, 실행 메모리 한계에도 도달하지 않았습니다. 조건을 수정해 다시 실험하자 이번에는 다른 문제가 나타났습니다.
문제의 Key 하나에 약 460만 행이 몰리면서 collect_list의 결과 한 칸 자체가 약 1.15 GB짜리 배열이 되었습니다. 이 경우에는 실행 메모리 한계를 넘어서 Spill이 발생한 것인지, 결과 객체 자체가 Heap보다 커서 실패한 것인지 구분하기 어려웠습니다. 그래서 row_number Window로 실험을 바꿨습니다.
row_number() over (partition by key order by payload)
현장에서 Skew와 함께 자주 등장하는 Key별 중복 제거와 Top-N 패턴을 대표하는 연산입니다.
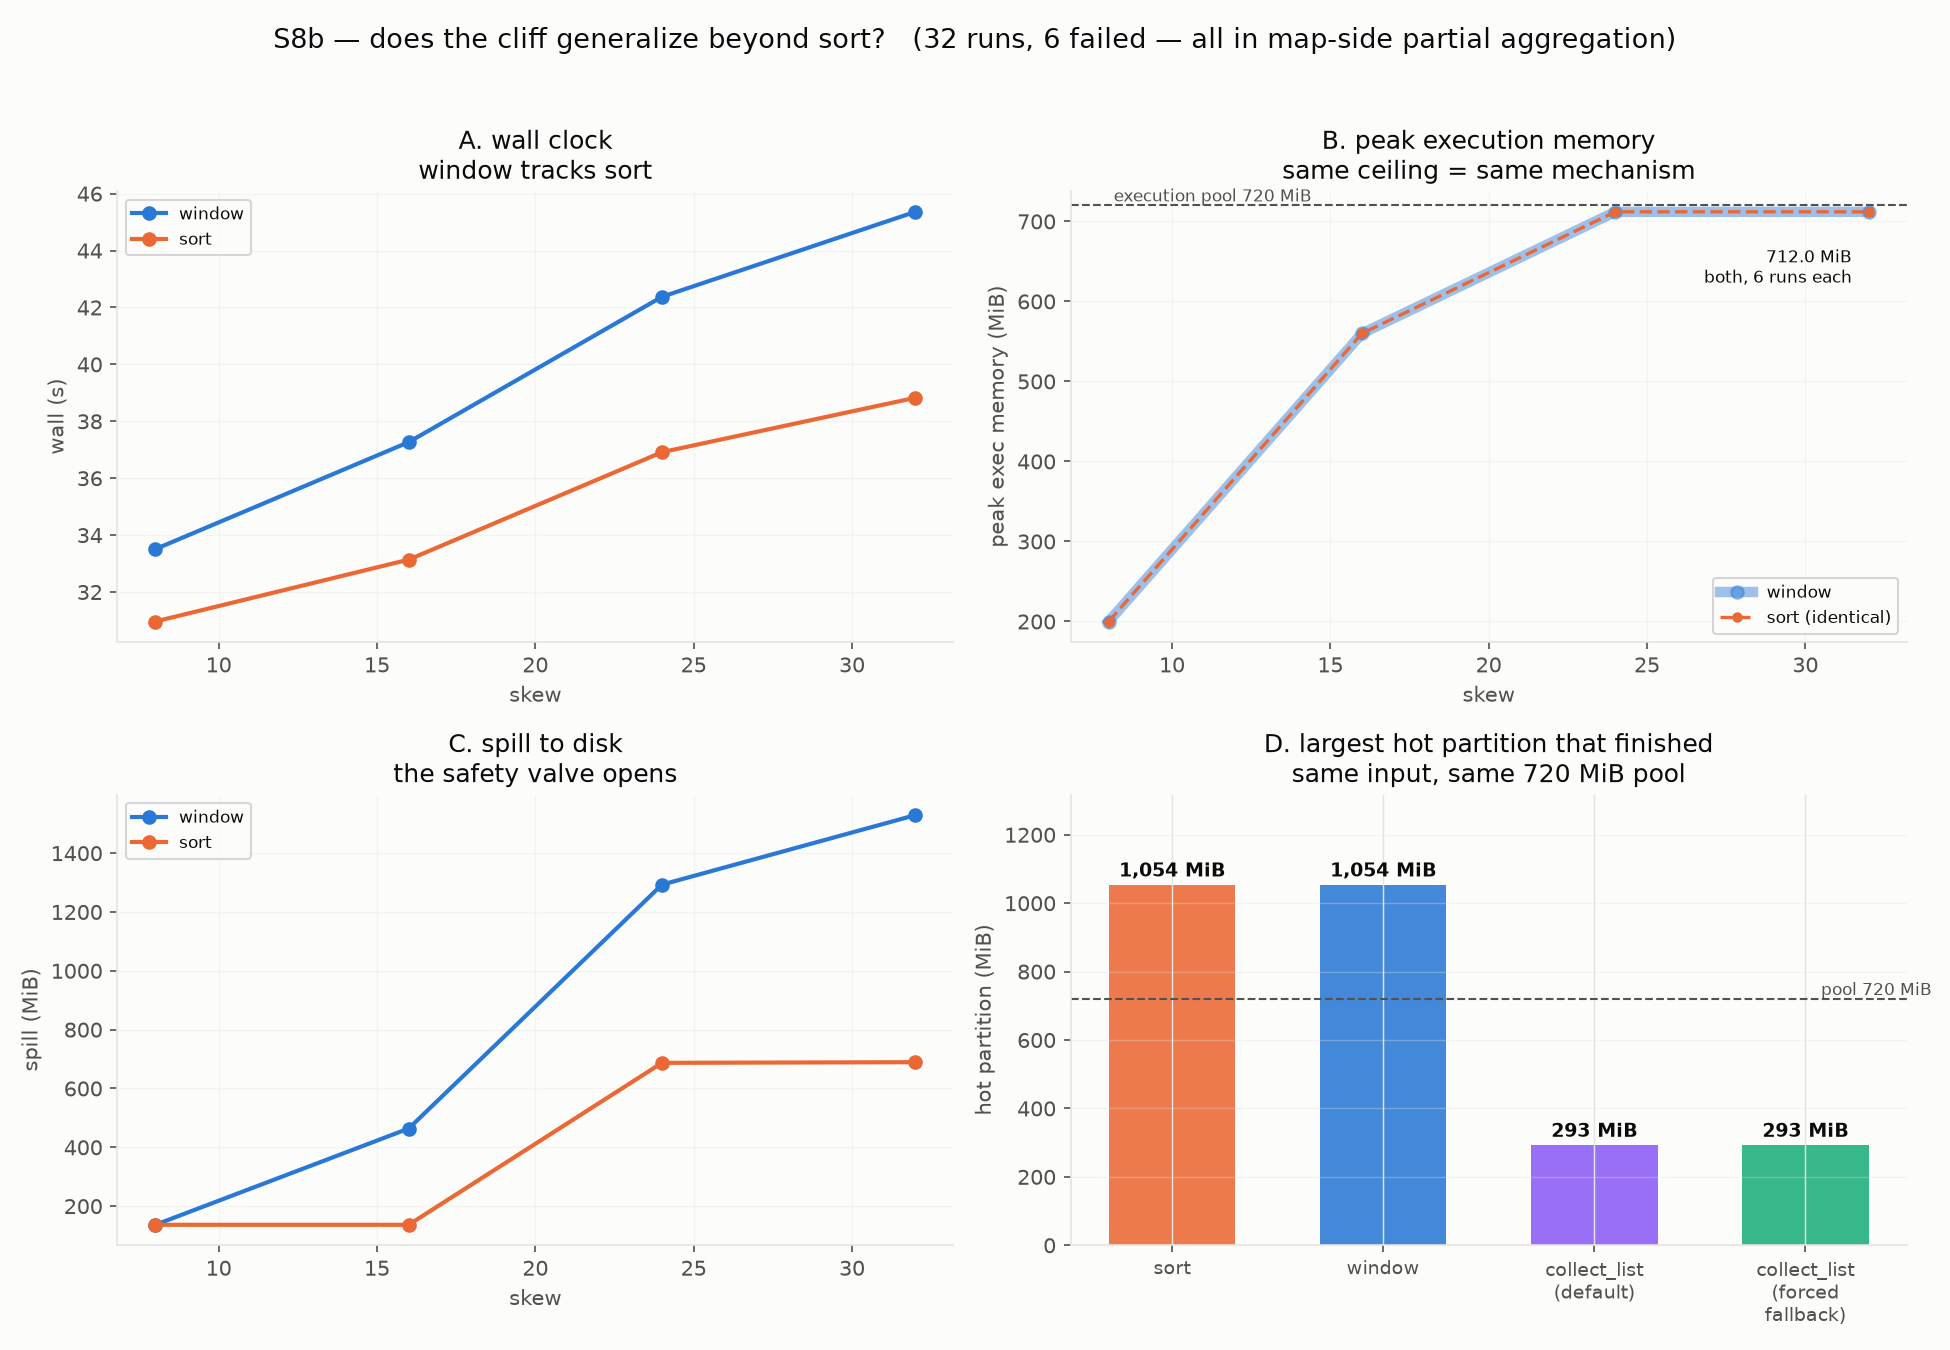
| Skew | 8 | 16 | 24 | 32 |
|---|---|---|---|---|
| Window 메모리 최대 | 200.0 | 560.0 | 712.0 | 712.0 |
| Sort 메모리 최대 | 200.0 | 560.0 | 712.0 | 712.0 |
각각 6회씩, 총 12 Run에서 모두 712.0 MB가 나왔습니다. 이 환경에서는 메모리 천장이 단순히 연산의 이름으로 결정되는 것이 아니라, 어떤 메모리 관리 경로를 사용하는지에 따라 결정되는 것으로 볼 수 있습니다. 다만 Spill 양은 달랐습니다.
Skew 32에서 Window는 1,529 MB, Sort는 689 MB로 약 2.2배 차이가 났습니다. Spill이 시작되는 지점도 달랐습니다.
Window → Skew 16
Sort   → Skew 24
같은 Data와 같은 메모리 조건에서 끝까지 처리할 수 있었던 가장 큰 Partition 크기도 비교했습니다.
sort          1,054 MB
window        1,054 MB
collect_list    293 MB   ← stops here
Sort와 Window는 Spill을 통해 1 GB가 넘는 Partition도 처리할 수 있었습니다. 반면 collect_list는 293 MB까지는 처리했지만 565 MB에서는 실패했습니다. 이 차이는 결과를 만드는 방식에서 나옵니다.
Sort와 Window처럼 중간 Data를 Spill할 수 있는 연산은 메모리가 부족해도 디스크를 이용해 계속 처리할 수 있습니다. 반면 collect_list처럼 최종 결과 객체 자체를 하나의 큰 객체로 만들어야 하는 연산은 같은 방식으로 Spill해서 버티기 어렵습니다. 따라서 "Skew가 있으면 Spill이 발생한다" 고 일반화하는 것도 부족합니다.
어떤 연산인지보다 먼저, 그 연산이 메모리가 부족해졌을 때 Spill로 처리 경로를 전환할 수 있는지
를 확인해야 합니다.
3. 결론
이번 실험에서 확인한 내용은 크게 세 가지였습니다.
- Skew가 커진다고 비용이 비례해서 늘어나는 건 아니고, 실행 메모리 한계를 넘는 순간 Spill이 발생하면서 비용이 계단처럼 증가했습니다.
- 그 비용을 결정하는 건 단순한 Partition 크기만이 아니라 레코드 수와 연산 방식이었고, 그래서 현재 AQE의 Skew Join 판정 기준으로는 감지하기 어려운 Record-Skew도 있었습니다.
- 결국 Skew를 해결할 때는 무작정 Partition·Core·AQE를 조정하기보다, 어떤 연산에서 무엇이 메모리를 채우고 언제 Spill로 넘어가는지부터 확인해야 합니다.
이 결론을 내기 위한, 처음 질문은 단순했습니다.
"Skew가 2배가 되면 처리 비용도 2배가 되는가?"
실험 결과는 그렇지 않았습니다. Skew가 커진다고 처리 시간이 같은 비율로 계속 증가하는 것이 아니라, 특정 지점에서 처리 방식이 바뀌면서 비용이 한 번에 증가했습니다. 이번 실험에서 그 지점은 실행 메모리 풀이 차는 순간이었습니다.
Partition이 실행 메모리 풀 안에서 처리될 때는 메모리 내 정렬이 가능했지만, 한계를 넘으면 Spill과 Merge가 필요한 외부 정렬 경로로 넘어갔습니다. 그 결과 Skew 16에서 32로 넘어가는 구간에서 MB당 비용이 31% 증가했습니다.
이 전환 지점은 머신이 달라져도 동일했습니다. 로컬 WSL2와 EC2 모두 Peak 실행 메모리가 712 MiB에서 멈췄습니다. 처리 속도와 디스크 성능은 달라도, 실행 메모리 한계에 도달하는 지점은 같았습니다.
그리고 그 메모리를 채우는 데에는 단순한 데이터 크기보다 레코드 수가 더 큰 영향을 줬습니다. 회귀식의 계수를 비교하면 레코드 수 항의 계수가 바이트 수 항보다 약 352배 컸습니다. 그리고 64B의 행에서는 전체 비용의 88% 가 레코드에서 발생했습니다. 같은 크기의 데이터를 처리하더라도 행이 작고 많아지면 실행 메모리와 정렬 비용이 크게 달라질 수 있다는 의미입니다.
이 특성은 AQE에서도 차이를 만들었습니다. AQE의 Skew Join 판정은 Partition의 Byte 크기를 기준으로 하기 때문에, 바이트 크기는 크지 않지만 레코드 수가 많은 Record-Skew는 감지하지 못했습니다. 실험에서는 Record-Skew 6개 모두 AQE가 감지하지 못했고, 방치된 Partition은 AQE가 분할한 Partition보다 2.2배 느렸습니다.
처음 예상했던 Kernel Writeback은 핵심 원인이 아니었습니다. Dirty Data를 10분의 1 수준으로 줄여도 Job 시간은 ±3.6% 안에서 움직였습니다. 디스크도 마찬가지였습니다. 빠른 NVMe에서는 병목이 아니었지만, 쓰기 대역폭을 50 MB/s까지 제한하자 처리 시간이 5.4배 증가했습니다. 결국 디스크 자체보다 실제 Spill이 발생했을 때 저장장치가 얼마나 빠르게 이를 처리할 수 있는지가 중요했습니다.
Core 수에 대한 예상도 일부 수정할 필요가 있었습니다. Core를 늘리면 Task의 최대 메모리가 단순히 1/N로 줄어드는 것이 아니라, Task가 처음 Spill을 시작하는 시점이 달라졌습니다. 그래서 Core 수를 조정할 때도 단순히 "Core가 많으면 Task당 메모리가 줄어든다"고 보기보다, 실제 실행 메모리 할당과 Spill 발생 시점을 함께 확인해야 했습니다.
Skew를 줄이기 위한 방법도 마찬가지였습니다. Partition 수를 늘려도 같은 Hot Key는 같은 Partition에 남을 수 있고, 단순한 Salting은 Hot Partition을 분산시키는 대신 반대편 Data를 복제해야 합니다. Broadcast Join 역시 대상 Data가 커지면 성능 문제가 아니라 Broadcast 자체가 실패할 수 있습니다. AQE의 임계값을 낮추는 것도 Partition을 쪼개는 것만으로 실제 처리 비용이 줄어드는 것은 아니었습니다.
결국 이번 실험에서 가장 중요했던 것은 "Skew가 크면 느리다"는 사실을 확인하는 것이 아니었습니다. 어느 지점에서 처리 경로가 바뀌는지, 그때 무엇이 메모리를 차지하는지, 그리고 그 비용을 AQE나 다른 튜닝 방법이 실제로 줄여줄 수 있는지를 확인하는 것이었습니다. Spark의 성능 문제를 볼 때도 결국 같은 순서로 접근할 수 있습니다. Partition 크기 → 레코드 수 → 실행 메모리 → Spill → 실제 I/O
단순히 Skew의 크기만 보는 것보다, 어떤 자원이 한계에 도달하면서 처리 경로가 바뀌었는지를 먼저 확인하는 것이 이번 실험에서 얻은 가장 큰 결론이었습니다. 알게 된 사실을 표로 정리하면 다음과 같습니다.
| 상황 | 확인할 것 |
|---|---|
| Skew가 커지는데 어느 순간부터 급격히 느려집니다 | 실행 메모리 풀이 한계에 도달했는지 확인합니다. Spill 양만으로는 메모리 부족 시점을 바로 판단하기 어려울 수 있습니다. |
| 느린 Task 하나가 전체 Job을 붙잡고 있습니다 | Hot Partition의 크기뿐 아니라 행 수와 행당 처리 비용도 함께 확인합니다. |
| AQE를 켰는데도 느린 Task가 남습니다 | 해당 Partition의 행 수를 확인합니다. AQE의 Skew Join 판정은 Partition의 Byte 크기를 기준으로 합니다. |
| 작은 크기의 데이터를 처리하는데도 실행 메모리를 많이 사용합니다 | 행이 좁을수록 행당 고정 오버헤드의 비중이 커질 수 있습니다. 레코드 수와 실행 메모리 사용량을 함께 봅니다. |
| Spill이 많이 발생해서 디스크가 병목이라고 생각됩니다 | 실제 디스크 쓰기 속도와 Job 시간을 비교합니다. 빠른 NVMe에서는 Writeback이나 디스크 I/O가 병목이 아닐 수도 있습니다. |
| Partition 수를 크게 늘렸는데도 Hot Partition이 줄지 않습니다 | 같은 Key가 같은 Partition으로 해시되기 때문에, Hot Key 자체가 원인이라면 Partition 수 증가만으로 해결되지 않을 수 있습니다. |
| Salting으로 Skew를 분산하려고 합니다 | Hot Key가 분산되는 만큼 반대편 데이터를 복제해야 하므로, 복제 비용이 Skew 완화 효과를 상쇄하는지 확인합니다. |
| Broadcast Join으로 Skew를 피하려고 합니다 | Broadcast 대상의 크기와 Driver/Executor 메모리 한계를 먼저 확인합니다. 일정 크기를 넘으면 성능 문제가 아니라 Broadcast 자체가 실패할 수 있습니다. |
| NULL이 많아서 Join이 느리다고 생각됩니다 | 먼저 Join 종류를 확인합니다. Inner Join은 NULL을 셔플 전에 제거할 수 있지만, Outer Join은 NULL 행을 보존해야 합니다. |
| AQE 임계값을 낮추려고 합니다 | Partition을 쪼개더라도 실행 메모리 한계에 도달하지 않는다면 실제 처리 시간은 거의 줄지 않을 수 있습니다. |
| Core 수를 줄이거나 늘려 성능을 조정하려고 합니다 | Core 수 자체보다 Task당 사용할 수 있는 실행 메모리와 첫 Spill 발생 시점이 어떻게 바뀌는지 확인합니다. |
| Window나 집계에서 특정 Key에 데이터가 몰립니다 | row_number 같은 Window는 큰 Partition의 Sort에서 Spill이 발생할 수 있고, collect_list처럼 결과 자체를 메모리에 만들어야 하는 연산은 Spill만으로 해결되지 않을 수 있습니다. |
4. 측정 환경
4.1. 하드웨어
| 항목 | 값 |
|---|---|
| 인스턴스 | EC2 m6id.4xlarge 스팟 · ap-northeast-2 |
| AMI | ami-086a43496cb46286c (Ubuntu 24.04) Pin 고정 |
| CPU | Intel Xeon Platinum 8375C @ 2.90GHz |
| Core 구성 | 물리 8 Core × 2 Thread = 16 vCPU (Hyper-Threading 활성화) |
| 메모리 | 61 GB |
| Data 디스크 | 인스턴스 스토어 NVMe 884.8 GB → /data |
| Root | EBS 60 GB → / (결과만 저장) |
| CPU 주파수 거버너 | 없음 (no cpufreq). Nitro라 Guest에서 조절 불가 |
| PMU | 사용 불가. perf stat -e cycles → No supported events found |
4.2. 소프트웨어
| 항목 | 값 |
|---|---|
| OS | Ubuntu 24.04 |
| JDK | OpenJDK 21.0.12 (2026-07-21) |
| PySpark | 4.0.1 Pin 고정 |
| cgroup | v2 (cgroup2fs). S6의 io.max 실험에 필요 |
vm.dirty_ratio |
20 (기본값) |
vm.dirty_background_ratio |
10 (기본값) |
4.3. Spark 설정, 전 실험 고정
실험 변수가 아닌 설정은 모두 고정했습니다.
spark.memory.fraction                 0.6      -> the 720 MiB execution pool comes from here
spark.memory.storageFraction          0.5
spark.sql.shuffle.partitions          200
spark.sql.autoBroadcastJoinThreshold  -1       -> force SortMergeJoin
                                                 (bypassed with a hint only in the broadcast run)
spark.eventLog.enabled                true
spark.eventLog.compress               false    -> keep parsing free of extra dependencies
spark.eventLog.rolling.enabled        false
spark.ui.enabled                      false
spark.ui.showConsoleProgress          false    -> the progress bar's CR overwrites the log
spark.driver.maxResultSize            1g
--driver-memory                       1500m    -> local mode, so this is the executor heap
spark.io.compression.codec과 spark.shuffle.compress는 S6에서만 변수로 사용했고, 나머지 실험에서는 LZ4 기본값을 유지했습니다.
4.4. Data
| 항목 | 값 |
|---|---|
| 크기 | 8 GiB (2.1 실무 편만 1 GiB·4 GiB) |
| 포맷 | Parquet, 무압축. 압축이 걸리면 "총 바이트 고정" 통제가 깨집니다 |
| 스키마 | key: int, payload: string |
| Cold Key | 10,000개 |
| Hot Key | 1개 (key = 0) |
| 행 폭 | 64 / 256 / 1024 / 2048 B (실험별) |
| 시드 | 고정. 같은 인자라면 같은 Data가 생성됩니다 |
4.5. 측정 방법
| 항목 | 값 |
|---|---|
| 반복 | 실험별 2~5회. rep을 바깥 루프에 둬 시간 순서 효과가 변수와 교락되지 않도록 함 |
| 집계 | Median + IQR. 평균은 사용하지 않음 |
| Cache 통제 | Run마다 Page Cache Drop. 실패하면 해당 Run 중단 |
| Kernel 샘플링 | 0.25초 간격으로 /proc/meminfo(Dirty/Writeback), /proc/vmstat(nr_dirty, pgpgout), /proc/pressure/{io,memory,cpu}(PSI), /proc/stat |
| Spark 지표 | 이벤트 로그 직접 파싱. Task 단위 원자료 전체 보관 |
| 총 Run 수 | 742 (Smoke·Diag 제외 시 739) |
| 총 비용 | 약 $6.5 |
5. 참고문헌
Apache Spark 소스 코드
OptimizeSkewedJoin.scala: AQE의 Skew Join 판정 기준과 분할 로직 (2.5)MapOutputStatistics.scala: AQE에 전달되는 Shuffle 통계와bytesByPartitionId(2.5)UnsafeExternalSorter.java: 실행 메모리가 부족할 때 Spill을 수행하는 외부 정렬 구조 (2.3)UnsafeInMemorySorter.java: 정렬 과정에서 사용하는 Record Pointer와 메모리 구조 (2.4)ExecutionMemoryPool.scala: Task 간 실행 메모리 할당 및 공유 구조 (2.7)- [SPARK-29544] Optimize skewed join at runtime with new Adaptive Execution : AQE Skew Join 관련 JIRA. 설명문에서 runtime statistics로
data size and row count를 언급 (2.5) - [SPARK-31864] Adjust AQE skew join trigger condition : AQE Skew Join의 Trigger Condition 조정 관련 이슈
- [SPARK-20801] Store accurate size of blocks in MapStatus when it's above threshold :
MapStatus에서 Shuffle Block 크기를 다루는 방식과 크기 근사 관련 이슈 - [Spark 4.0.1] Performance Tuning: Adaptive Query Execution : AQE와 Skew Join,
256MB임계값 및5배기준 (2.1, 2.5) - [Spark 4.0.1] Tuning Spark: Memory Management :
spark.memory.fraction과 Spark 통합 메모리 관리 (2.3, 부록 A) - [Linux Kernel]
vmsysctl :dirty_ratio,dirty_background_ratio및 Dirty Page 관리 (2.6) - [Linux Kernel] Control Group v2 :
io.max,io.stat을 이용한 I/O 제어 및 통계 (2.6) - [Linux Kernel] PSI :
/proc/pressure/*를 통한 CPU·Memory·I/O Pressure 측정 (부록 A) - K. Ousterhout et al., Making Sense of Performance in Data Analytics Frameworks, NSDI '15 : 데이터 분석 프레임워크에서 디스크 I/O와 성능의 관계를 분석한 연구 (2.6)
- Skew Mitigation for Facebook's Petabyte-scale Joins : 대규모 Join 환경에서 Skew를 다루는 실무 사례 (2.1)
- [SPARK-48290] AQE not working when joining dataframes with more than 2000 partitions : 2,000개 이상의 Partition에서 AQE 동작과 관련된 이슈. 본문의 Record-Skew와는 별개의 문제입니다.