
Iceberg V3 Deletion Vector 최적화와 Upstream 기여
- Apache Iceberg
- Apache Spark
Iceberg V3 deletion vector의 읽기 비용을 파고들다 병목을 하나 찾았고, 이를 패치로 만들어 Apache Iceberg에 올렸습니다. 이 글에서는 패치를 올린 뒤 머지되기까지의 과정을 기록합니다. 병목을 어떻게 찾았는지는 본편에서 다뤘습니다.
1. 앞선 이야기
이 글은 본편에서 이어집니다. 패치가 무엇을 바꾸는지 이해하는 데 필요한 내용만 먼저 짚겠습니다. Iceberg V3는 삭제된 행을 deletion vector로 표시합니다. 데이터 파일 하나에 DV 하나가 붙고, 그 안은 Roaring Bitmap입니다. Roaring은 위치 공간을 65,536개짜리 청크로 나눠 밀도에 따라 컨테이너를 선택하는데, 청크 안의 삭제가 4,096개 이하면 array, 그보다 많으면 bitmap을 사용합니다.
4,096 / 65,536 = 0.0625 = 6.25%
Spark 벡터화 리더는 배치를 읽으면서 행마다 PositionDeleteIndex.isDeleted(pos)를 호출합니다. 5,000행을 읽으면 5,000번 호출하는 방식입니다. 문제는 배치의 position이 무작위가 아니라 연속된 오름차순 구간이라는 점입니다. 결국 같은 컨테이너를 찾는 이진 탐색을 행마다 반복하고 있었습니다.
프로파일을 확인해보니 좁은 스캔에서는 이 delete check가 스캔 CPU의 40% 를 차지했습니다. 더 흥미로운 점은 비용이 삭제율에 따라 단순하게 증가하지 않았다는 것입니다. array에서 bitmap으로 넘어가는 6.25% 바로 아래가 가장 비쌌고, 삭제율을 더 높이면 오히려 비용이 줄었습니다.
그래서 제안한 변경은 간단했습니다.
before : isDeleted(pos) per row
after  : forEachInRange(start, end)
PositionDeleteIndex에 구간 순회 메서드를 추가하고, ColumnarBatchUtil이 이 경로를 사용하도록 변경했습니다. 마이크로벤치에서는 56~150배, Spark 실측 delete-check CPU에서는 2.6~9.3배의 개선을 확인했습니다.
측정 환경과 편차, 왜 6.25%가 변곡점이 되는지는 본편에 자세히 정리했습니다. 여기서부터는 이 패치를 커뮤니티에 올린 뒤 실제 코드로 반영되기까지의 과정입니다.
2. 업스트림
2.1 Issue와 PR
먼저 측정 결과를 apache/iceberg#18026에 정리했습니다. 단순히 어디가 빨라지는지만 적지 않고, 어떤 조건에서 효과가 나타나는지와 어떤 조건에서는 이 수치가 성립하지 않는지까지 함께 기록했습니다.
단일 JVM 조건이라는 점, 노이즈 바닥이 9.7%였다는 점, 재측정 후 철회한 숫자가 두 개였다는 점, 아직 측정하지 않은 조건까지 명시했습니다. 성능 개선을 주장하려면 잘 나온 숫자뿐 아니라 그 숫자를 어디까지 믿을 수 있는지도 함께 적어야 한다고 생각했기 때문입니다.
기존 논의도 먼저 확인했습니다. ColumnarBatchUtil을 다루는 이슈가 두 개 있었지만 javadoc과 단위 테스트에 관한 내용이었고, 행 단위 조회 비용이나 Roaring 구간 API에 대한 논의는 저장소에서 찾지 못했습니다.
패치는 spark/v4.2 한 곳만 수정했습니다. diff를 검토 가능한 크기로 유지하기 위해서였습니다. ColumnarBatchUtil은 v3.5, v4.0, v4.1에서도 바이트 단위로 동일했기 때문에, 방향이 확정되면 후속 PR에서 백포팅하기로 했습니다.
호환성 측면에서도 기존 동작을 깨지 않도록 했습니다. default 구현이 기존 동작을 그대로 유지하므로 소스·바이너리 호환이 가능하고, 외부 구현체가 별도로 수정할 필요도 없습니다. 포맷이나 명세 변경도 없습니다.
새 API에 대한 테스트 파일도 추가했고, Spark 4.2 / Scala 2.13 기준으로 빌드와 코드 포맷 검사를 통과시켰습니다. 이후 PR #18027로 올렸고 CI 과정도 모두 통과했습니다.
PR을 올린 뒤 Slack #dev에 리뷰를 요청했습니다. 여기서 커미터 한 명이 공개 인터페이스에 메서드를 추가하는 변경인 만큼 dev 메일링 리스트에서도 논의해보는 것이 좋겠다고 제안했습니다. 그래서 [DISCUSS] 스레드로 가져갔습니다.
이때부터 단순한 코드 리뷰를 넘어, API를 어떻게 설계할 것인지와 이 변경이 실제로 어떤 상황에서 의미가 있는지를 설명하는 과정이 시작됐습니다.
2.2 메일링 리스트
PR을 올린 후 평소 도움을 받고 있던 Iceberg Slack의 Dev 채널에 리뷰를 요청했습니다.
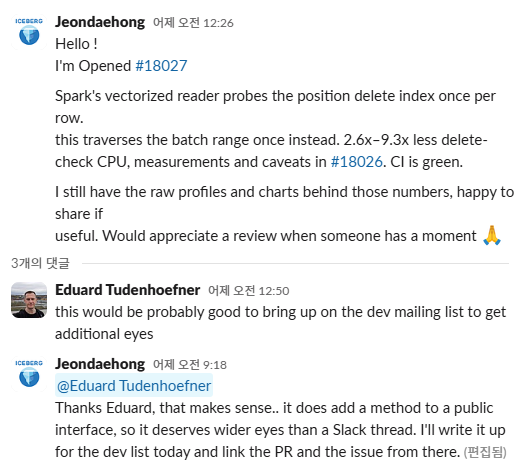
메인테이너인 Eduard Tudenhoefner 님은 좋은 안건인 것 같다며 메일링 리스트에 올려 더 많은 사람과 논의해보자는 의견을 주셨습니다.
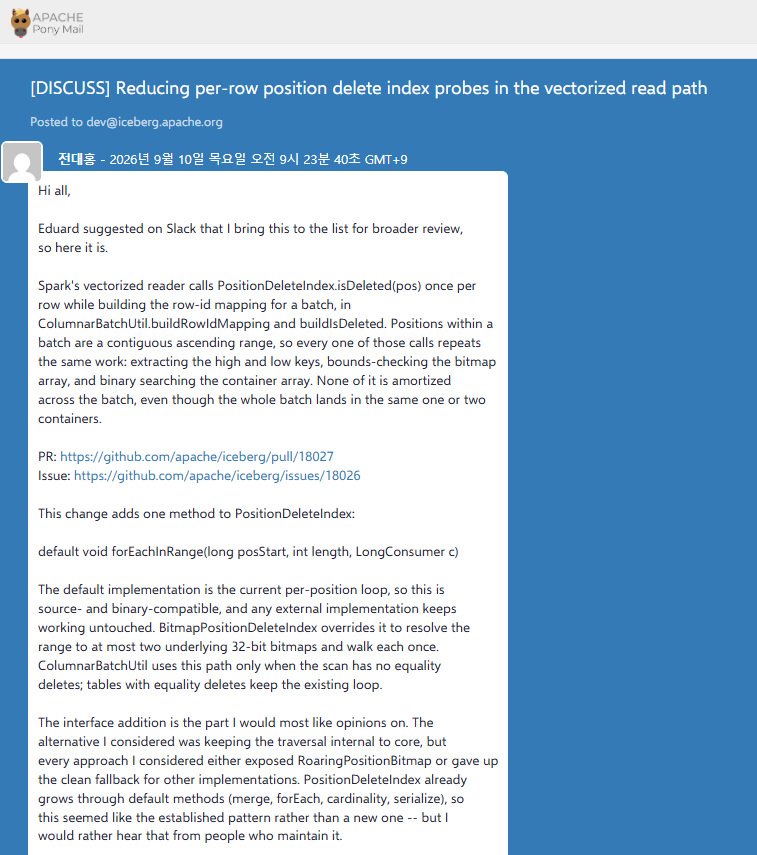
안내받은 대로 메일링 리스트에 내용을 공유하고 토의를 요청했습니다. 이후, 메일을 본 메인테이너 Péter Váry(pvary) 님이 답을 주셨습니다. 제 설명을 LLM에 넣어 요약해봤다며 그 결과를 다시 물어왔습니다.
So if your query is:
- Narrow projection
- Scan-heavy
- DV-heavy
- Little aggregation/filtering

then you might actually see 13-19% faster queries.
즉, 제가 앞서 설명한 실험 결과를 “컬럼을 적게 읽고, 스캔 비용이 크며, Deletion Vector의 영향이 크고, 집계나 필터링이 적은 쿼리라면 13~19% 정도 빨라질 수 있다”는 의미로 요약한 것입니다. 그리고 이 요약이 맞는지 확인하면서 다음과 같이 물었습니다.
Is this accurate? You might want to highlight in which use-case your PR helps
13~19%라는 수치 자체는 맞았습니다. 5컬럼 이하의 정수 투영에서 측정한 값이고, 1컬럼만 스캔하는 쿼리는 전용 인스턴스에서 최대 29%까지 개선됐습니다. 반면 10컬럼을 넘어가면 개선폭이 중앙값 9.7% 수준의 노이즈 범위에 들어왔기 때문에, 별도의 성능 개선을 주장하지 않았습니다.
다만 DV-heavy라는 표현 때문에 메인테이너분께 혼동을 주게 되었습니다.
| 삭제율 | 컨테이너 | 패치 전 | 패치 후 | 개선 |
|---|---|---|---|---|
| 0.5% | array | 674 | 79 | 8.56배 |
| 6.1% | array | 873 | 94 | 9.28배 |
| 7.0% | bitmap | 420 | 113 | 3.73배 |
| 8.0% | bitmap | 499 | 142 | 3.51배 |
| 50% | bitmap | 584 | 225 | 2.60배 |
해당 결과를 보면 6.1%에서 개선폭이 가장 크고, 6.25%를 넘어가면서 오히려 줄어듭니다. 이유는 Iceberg의 Roaring Bitmap이 삭제 위치를 저장하는 방식이 삭제율에 따라 array에서 bitmap으로 바뀌기 때문입니다. 이 기준이 6.25% 입니다.
array에서는 삭제된 위치를 찾기 위해 이진 탐색이 필요합니다. 이번 패치는 행마다 이 탐색을 반복하는 대신, 연속된 범위를 한 번에 순회하도록 바꿉니다. 따라서 array 구간에서는 패치가 없애는 비용이 큽니다.
반면 6.25%를 넘어 bitmap으로 바뀌면 삭제 여부를 확인하는 방식이 비트 하나를 확인하는 상수 시간 연산으로 바뀝니다. 이미 조회 자체가 저렴하기 때문에, 패치가 제거할 수 있는 비용도 자연스럽게 줄어듭니다. 그래서 6.1%가 가장 높은 개선폭을 보인 것은 삭제가 많아서가 아니라, array와 bitmap이 바뀌기 직전이었기 때문입니다.
50%에서는 또 다른 이유로 개선폭이 더 줄어듭니다. 삭제된 행이 절반이면 살아 있는 행 사이의 빈 구간도 줄어듭니다. 이번 패치는 삭제된 위치 사이의 구간을 한 번에 처리하면서 이득을 얻는데, 건너뛸 구간 자체가 짧아지면 이 장점도 작아집니다. 결국 남는 이득은 행마다 삭제 인덱스를 다시 조회하지 않는 비용 정도입니다.
그래서 리뷰 과정에서 DV-heavy라는 표현을 그대로 두지 않고, 다음처럼 수정했습니다.
DV-heavyis not monotonic. More deletes is not more benefit.
그리고 PR 설명도 "어떤 경우에 이 패치가 효과적인가"를 먼저 보여주는 구조로 다시 작성했습니다. 여기서 한 가지를 배웠습니다. 본문에는 이미 개선폭이 비단조적으로 변한다는 내용이 있었지만, 요약에서는 DV-heavy라는 표현 하나 때문에 "삭제가 많을수록 좋다"는 의미로 읽힐 수 있었습니다. 측정 결과에 단순한 단조 관계가 없다면, 그 사실을 요약 단계부터 명확하게 드러내야 합니다.
실제 사용 사례를 생각해보면, 삭제가 드문드문 발생하면서 array 컨테이너를 사용하는 구간이 이번 패치의 핵심 대상입니다. 이번 측정에서는 특히 6.25% 직전의 array 구간에서 패치 전 비용이 가장 높았고, 동시에 개선폭도 가장 크게 나타났습니다.
실제로 CDC 성격의 워크로드에서는 삭제가 드문드문 발생하면서 청크당 6.25% 바로 아래에 위치하는 경우가 있습니다. 이번 측정에서는 바로 이 구간에서 비용이 가장 컸고, 동시에 패치의 개선폭도 가장 컸습니다. 그래서 답글에는 이렇게 적었습니다.
DV-heavyis not monotonic. More deletes is not more benefit.
그리고 PR 설명도 어떤 경우에 도움이 되는지부터 먼저 보여주는 구조로 다시 작성했습니다. 메일링 리스트의 TL;DR 역시 같은 방식으로 고쳤습니다.
2.3 JMH 벤치마크
리뷰에서는 실제 성능 개선을 저장소 안에서도 확인할 수 있도록 JMH 테스트를 추가해달라는 요청이 있었습니다.
Could you please add JMH test to show the gains?
JMH 측정을 했던 기억이 있어, 레포를 좀 살펴보니 core/src/jmh에 벤치마크 코드가 이미 있었고, 결과 파일을 커밋하지 않았기 때문에 메인테이너에게 전달되지는 않았던 거였습니다.
JMH bench files           199
committed result files      0
.gitignore:42   */benchmark/*
그래서 PositionDeleteIndexBenchmark를 추가했습니다. 500만 개의 position을 5,000개씩 읽고, 벡터화 리더가 실제로 읽는 방식에 맞춰 array와 bitmap 경계 양쪽의 밀도를 측정했습니다.
설정은 인접한 RoaringPositionBitmapBenchmark를 기준으로 맞췄습니다. @Fork(1), SingleShotTime, 5분 타임아웃과 Javadoc에 적힌 실행 방법까지 같은 형태로 구성했습니다. 기존에 개인적으로 사용하던 DvBatchBench는 @Fork(3)과 AverageTime을 사용하고 있었기 때문에, 이번에는 저장소의 기존 벤치마크 형식을 따랐습니다.
실행 결과는 다음과 같습니다.
Benchmark                        (density)  Mode  Cnt    Score    Error  Units
probePerPosition                       0.5    ss    5   82.893 ± 13.257  ms/op
probePerPosition                       6.1    ss    5  111.101 ± 43.291  ms/op
probePerPosition                      12.0    ss    5   68.924 ± 18.444  ms/op
traverseRange                          0.5    ss    5    0.369 ±  0.378  ms/op
traverseRange                          6.1    ss    5    1.304 ±  0.891  ms/op
traverseRange                         12.0    ss    5    2.456 ±  1.660  ms/op
| 밀도 | 컨테이너 | 행마다 조회 | 구간 순회 |
|---|---|---|---|
| 0.5% | array | 82.9 ± 13.3 | 0.37 ± 0.38 |
| 6.1% | array | 111.1 ± 43.3 | 1.30 ± 0.89 |
| 12.0% | bitmap | 68.9 ± 18.4 | 2.46 ± 1.66 |
여기서는 개선 배수를 따로 계산하지 않았습니다. traverseRange의 측정값은 오차 범위가 매우 크기 때문입니다. 예를 들어 0.37 ± 0.38 ms는 오차가 측정값 자체와 비슷한 수준이라, 여기서 특정 배수를 계산해 성능이 몇 배 좋아졌다고 주장하는 것은 적절하지 않습니다.
따라서 이 벤치마크에서는 두 자릿수 수준의 차이가 확인됐다는 정도로만 표현했습니다. 앞선 실험에서 적용했던 것처럼, 측정값의 범위가 충분히 분리되지 않으면 구체적인 성능 개선폭을 주장하지 않는 원칙을 그대로 적용했습니다.
그리고 이 결과에서도 앞서 Spark 프로파일에서 확인했던 비단조적인 성능 곡선이 다시 나타났습니다. array를 사용하는 6.1%에서 probePerPosition 비용이 가장 높고, bitmap으로 전환되는 12.0%에서는 오히려 비용이 낮아집니다. 즉, 앞선 Spark 실측에서 우연히 나타난 현상이 아니라, 더 단순한 JMH 환경에서도 같은 경향을 확인할 수 있었습니다.
같은 패치인데 왜 성능 수치가 다를까?
여기서 성능 수치를 비교할 때 주의할 점이 있습니다. 같은 패치를 측정하더라도 어디까지를 측정 범위에 포함하느냐에 따라 개선 배수는 크게 달라집니다.
| 측정 | 측정 범위 | 개선폭 |
|---|---|---|
| 새 JMH | 파일 전체, 약 77개 청크 | 두 자릿수 수준 |
| 앞선 마이크로벤치 | 청크 하나, 컨테이너 타입별 조회 비용 | 5~144배 |
| Spark 실측 | 실제 스캔에서 발생하는 delete-check CPU | 2.6~9.3배 |
이 차이를 이해하려면 isDeleted가 실제로 무엇을 하는지 볼 필요가 있습니다. isDeleted 한 번의 조회는 크게 두 단계로 나뉩니다. 먼저 어느 32비트 비트맵에 해당 위치가 들어 있는지 찾고, 그다음 해당 컨테이너 안에서 실제 위치를 확인합니다.
앞선 마이크로벤치는 청크 하나만 만들어 측정했기 때문에 첫 번째 비용이 사실상 고정되어 있었습니다. 따라서 array에서는 이진 탐색을 수행하는 비용과 이를 반복하는 비용이 상대적으로 크게 드러났고, 컨테이너 타입에 따른 차이도 크게 나타났습니다.
반면 이번 JMH는 500만 개의 position을 여러 비트맵에 걸쳐 처리합니다. 따라서 어느 비트맵을 찾아갈지 결정하는 비용까지 포함됩니다. 구간 순회 방식에서는 이 비용을 매 행마다 반복하지 않습니다. 하나의 범위를 순회할 때 필요한 비트맵 탐색을 배치 단위로 한 번만 수행하고, 그 안의 position들을 연속해서 처리할 수 있습니다.
결국 세 실험에서 숫자가 다른 것은 패치의 성능이 측정할 때마다 달라졌기 때문이 아니라, 각 벤치마크가 측정한 범위가 서로 다르기 때문입니다. 마이크로벤치는 가장 작은 단위의 비용 차이를 크게 보여주고, JMH는 여러 청크를 포함한 조금 더 넓은 범위를 보여줍니다. 그리고 Spark 실측은 실제 파일을 읽고 데이터를 처리하는 전체 실행 과정에서 delete-check가 차지하는 비용을 측정합니다.
따라서 이 세 숫자를 하나의 성능 지표처럼 비교하면 안 됩니다. 패치 자체의 미세한 비용 차이를 보여주는 값과 실제 Spark 스캔에서 얻는 개선폭은 서로 다른 의미를 갖습니다. 실제 Spark 실행에서 확인한 개선폭은 여전히 2.6~9.3배이며, 이 값을 실제 실행 환경에서의 성능 개선 근거로 사용했습니다.
2.4 커뮤니티 싱크
커뮤니티 싱크 정식 안건 채택
Iceberg는 3주마다 Community Sync라는 공개 회의를 엽니다. 메인테이너와 기여자들이 모여 진행 중인 제안을 하나씩 확인하는 자리입니다. 이번 PR도 안건으로 올라갔습니다.
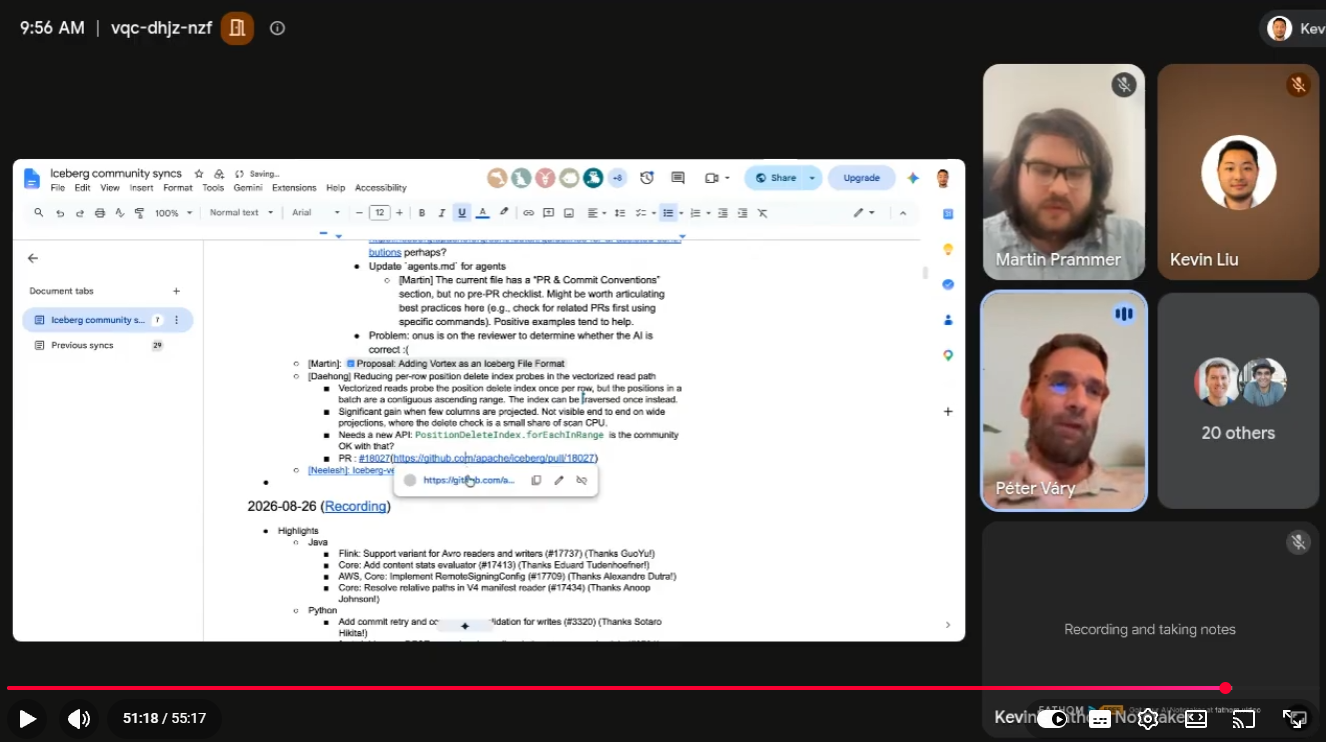
회의는 55분 동안 진행됐고 제 안건도 이 안에서 다뤄졌습니다. 한국 시간으로는 자정을 넘은 시간이어서 직접 참석하지 못했고, pvary 님이 대신 설명해 주셨습니다.
벡터화 읽기의 delete 적용을 최적화할 방법을 찾았습니다. 질문은 position index에 새 API를 추가해도 되느냐입니다. 전체가 아니라 주어진 구간에만 consumer를 적용하는 API입니다. 구현했고 결과도 꽤 좋습니다.
기술적인 방향에는 문제가 없었습니다. "추가에 이견 있는 분?"이라는 질문에도 아무도 반대하지 않아 새 API는 승인됐고, nastra 님이 그 주에 리뷰하겠다고 했습니다. 그런데 이어서 예상하지 못한 이야기가 나왔습니다.
다만 그의 PR은 너무 길고 복잡합니다. 아이디어는 타당한데 그 주변 것들 때문에 리뷰가 매우 어려웠습니다. 아이디어도 좋고 구현도 좋은데, 다 헤치고 보석을 찾는 데 시간이 꽤 걸렸습니다.
저는 측정 조건과 반증, 성립하지 않는 경우까지 빠짐없이 적어두는 것이 좋은 설명이라고 생각했습니다. 하지만 받는 입장에서는 그 정보가 리뷰를 가로막는 벽이 될 수도 있었습니다.
길게 쓰는 것과 전달되게 쓰는 것은 다른 일입니다.
내용을 빠짐없이 적는 것만으로 제 역할이 끝나는 것이 아니라, 읽는 사람이 핵심을 빠르게 찾을 수 있도록 만드는 것까지 작성자의 역할이라는 것을 배웠습니다.
nastra 님의 리뷰
회의에서 이야기한 대로 nastra 님이 리뷰를 주셨습니다. 첫 번째는 인터페이스 javadoc에 있던 성능 관련 조언을 제거하는 것이었습니다.
not sure if that's helpful, maybe just remove this
-   * <p>Callers that test a contiguous range of positions should prefer this method over calling
-   * {@link #isDeleted(long)} once per position.
-   *
인터페이스 주석은 무엇을 보장하는지를 설명하는 자리이지, 어떤 구현이 더 빠른지를 설명하는 자리는 아닙니다. 앞선 리뷰에서 pvary 님에게 "No impl details in the javadoc"이라는 지적을 받고도 남겨둔 부분이었습니다. 두 번째는 파라미터 이름을 구간이 명확하게 드러나도록 바꾸는 것이었습니다.
we use similar naming in RoaringPositionBitmap.setRange(..), so I think being explicit about the ranges is helpful. Please also update the implementing methods
-  default void forEachInRange(long posStart, long posEnd, LongConsumer consumer) {
+  default void forEachInRange(
+      long posStartInclusive, long posEndExclusive, LongConsumer consumer) {
1차 리뷰에서 setRange를 기준으로 예외 문구와 빈 구간 처리를 가져왔으면서 파라미터 이름만 짧은 형태로 남겨둔 부분이었습니다. @param, @throws와 구현체까지 함께 수정했습니다.
| 파일 | 역할 |
|---|---|
PositionDeleteIndex |
default 구현 |
BitmapPositionDeleteIndex |
구현체 |
EmptyPositionDeleteIndex |
구현체 |
RoaringPositionBitmap |
내부 구현 |
세 번째는 끝이 시작보다 작은 경우에 대한 테스트였습니다.
we also need tests where end < start
확인해보니 비트맵 레벨에는 해당 테스트가 있었지만 인덱스 레벨에는 없었습니다. 인덱스 표면에서는 default 구현, BitmapPositionDeleteIndex, EmptyPositionDeleteIndex 세 곳에서 각각 구간을 검증하고 있었습니다.
그래서 세 구현이 실제로 각각 테스트되는지 확인했습니다. 각 구현의 Preconditions를 하나씩 무력화했을 때 테스트가 실패하는지 확인하는 방식입니다. 세 곳 모두 실패해야 세 구현을 실제로 검증하고 있는 것입니다.
2.6 Merge 와 Backporting
Merge
2026년 9월 21일, pvary 님이 PR을 머지했습니다.
nastra 님과 pvary 님 두 분의 승인을 받았고, core와 spark 라벨이 붙었습니다. 댓글 82건과 CI 체크 42개를 거쳐 이슈 #18026도 함께 닫혔습니다.
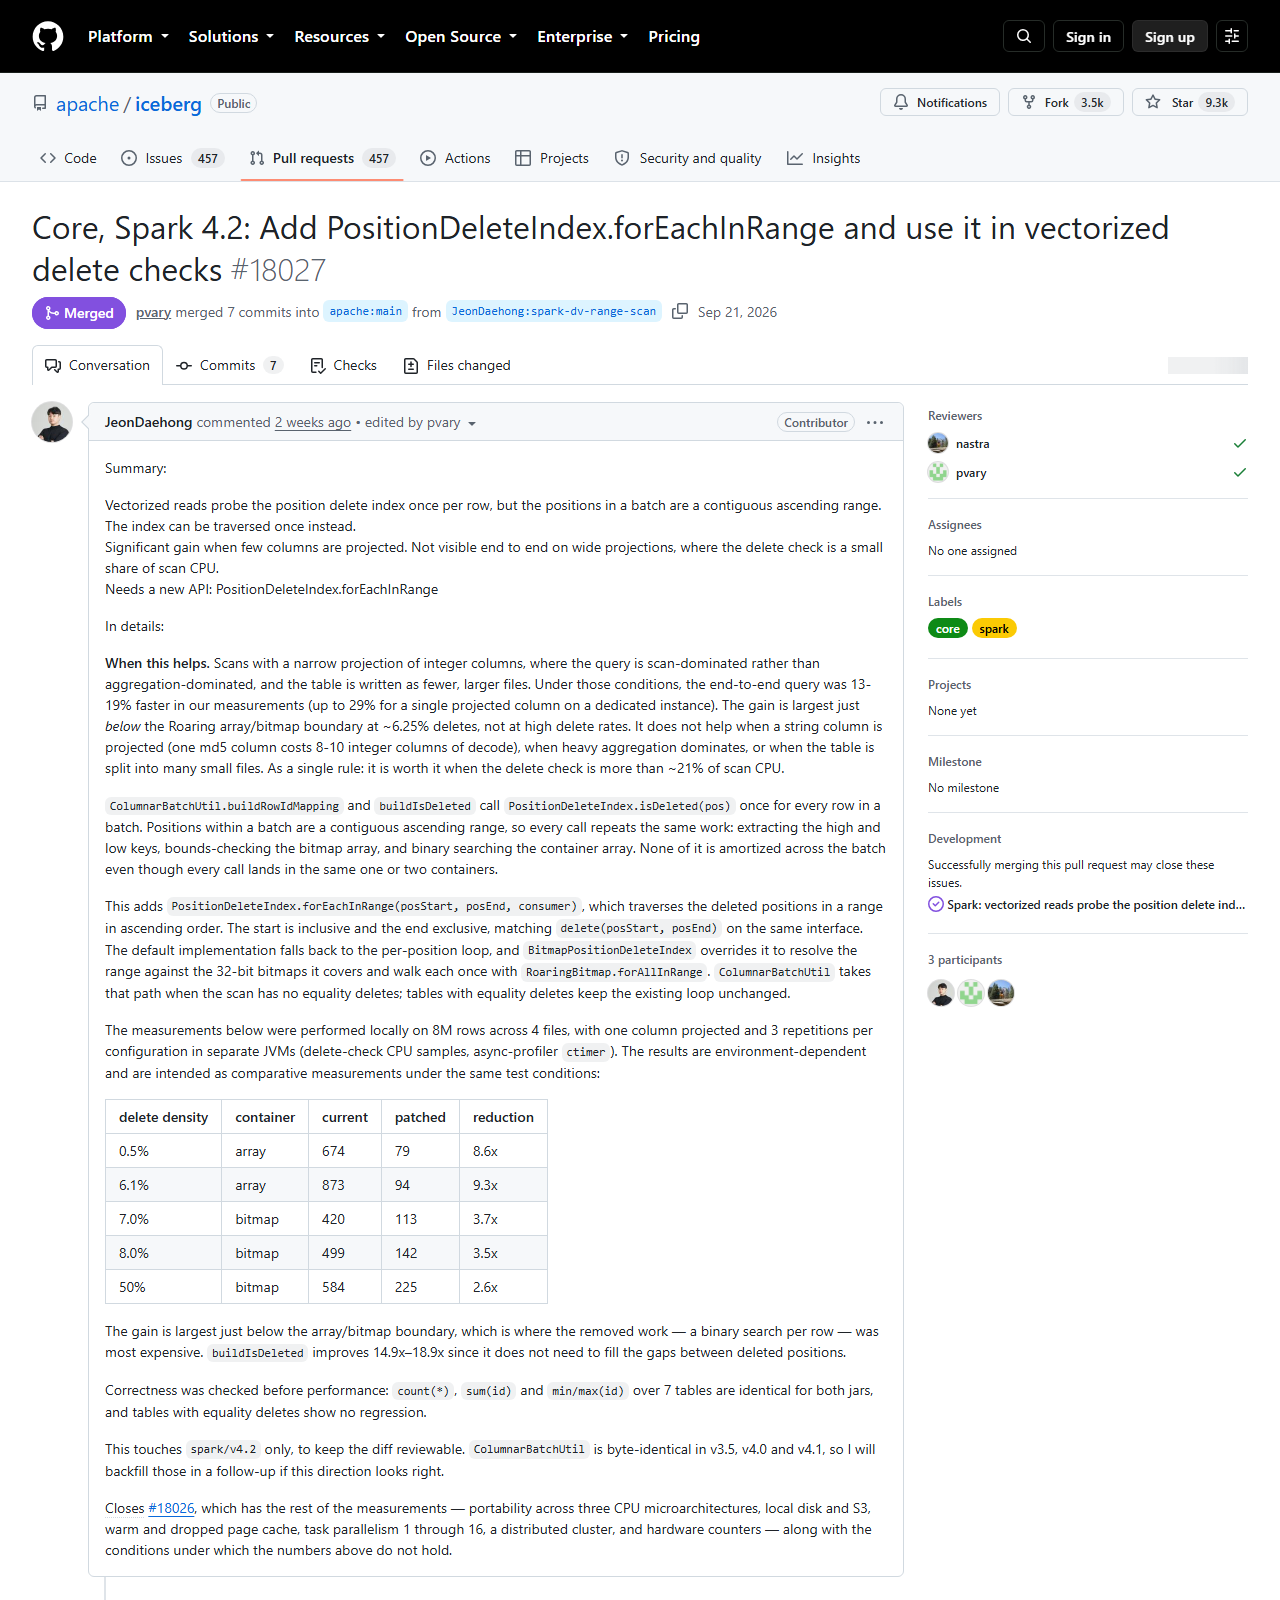
최종 PR 설명도 처음과 달라졌습니다. 받았던 지적 사항을 반영하고, 최대한 전달하고자 하는 문장만 전달하고자 내용을 수정하였습니다.
Backporting
2026년 9월 23일, 백포팅도 머지됐습니다. PR #18207입니다.
ColumnarBatchUtil은 v3.5, v4.0, v4.1, v4.2에서 바이트 단위로 동일합니다. 그래서 백포팅이라기보다는 같은 파일을 세 버전에 추가로 반영하는 작업에 가까웠습니다. 핵심 API인 PositionDeleteIndex.forEachInRange는 core에 있고 이미 main에 들어가 있었기 때문에 버전별로 다시 수정할 필요는 없었습니다.
실제로 들어간 코드
버전별로 변경된 부분은 buildRowIdMapping과 buildIsDeleted 앞에 분기를 하나씩 추가한 것입니다.
if (!deletes.hasEqDeletes()) {
  // positions in a batch form a contiguous ascending range, so the index can be traversed once
  // for the whole range instead of being probed once per row
  return deletedPositions == null
      ? null
      : buildRowIdMapping(deletedPositions, deletes, rowStartPosInBatch, batchSize);
}
equality delete가 없을 때만 새 경로를 사용하고, 그렇지 않으면 기존 행 단위 루프를 그대로 사용합니다. 새 경로에서 핵심이 되는 것은 LongConsumer입니다.
@Override
public void accept(long pos) {
  int deletedRowId = (int) (pos - rowStartPosInBatch);
  for (int rowId = nextRowId; rowId < deletedRowId; rowId++) {
    rowIdMapping[liveRowId] = rowId;
    liveRowId++;
  }

  deletes.incrementDeleteCount();
  this.nextRowId = deletedRowId + 1;
}
기존에는 배치의 모든 행을 돌면서 행마다 "이 행이 삭제됐는가?"를 확인했습니다. 이제는 삭제된 position만 오름차순으로 받고, 직전 삭제 위치와 현재 삭제 위치 사이의 빈 공간을 살아 있는 행으로 채웁니다. 마지막 삭제 위치 뒤에 남는 행은 순회가 끝난 뒤 appendRemainingLiveRows()가 처리합니다.
결국 새 경로의 비용은 배치 크기보다는 삭제 개수에 더 직접적으로 비례합니다. 앞서 삭제율 50%에서 개선폭이 작았던 이유도 여기에서 확인할 수 있습니다. 삭제가 절반이면 채워야 할 빈 공간이 거의 없기 때문에, 구간 순회의 장점이 줄어듭니다.
buildIsDeleted는 더 단순합니다. 빈 공간을 채울 필요가 없기 때문에 전달받은 position에 표시만 하면 됩니다.
@Override
public void accept(long pos) {
  isDeleted[(int) (pos - rowStartPosInBatch)] = true;
  deletes.incrementDeleteCount();
}
로컬에서는 Spark 4.1 기준으로 테스트 17개를 돌려 확인했습니다. 이로써 Iceberg가 유지하는 Spark 네 버전에서 동일한 읽기 경로를 사용하게 됐습니다. 처음 PR이 머지된 지 이틀 뒤였습니다.
3. 결론
결과적으로 forEachInRange를 추가한 최적화는 2026년 9월 21일 Apache Iceberg에 머지되었고, 이후 Spark 3.5, 4.0, 4.1에도 백포팅되었습니다. 실제 Spark 스캔에서는 delete-check CPU가 2.6~9.3배 감소했고, 좁은 정수 컬럼 스캔에서는 전체 쿼리 기준 13~19% 수준의 개선을 확인했습니다.
이번 기여에서 가장 크게 배운 것은 코드 자체보다 그 코드가 기대고 있는 전제와 근거를 확인하는 과정이 중요하다는 것입니다. int에서 long으로 시그니처를 바꾸는 과정에서 기존 코드의 숨은 전제를 발견했고, 리뷰 과정에서는 구현뿐 아니라 성능 결과와 사용 조건을 얼마나 명확하게 설명하느냐도 중요하다는 것을 경험했습니다.
특히 이번에는 측정 결과를 정확하게 설명하는 것과, 다른 사람이 그 결과를 빠르게 이해할 수 있도록 설명하는 것은 별개의 문제라는 것을 배웠습니다. 앞으로도 Upstream 기여에서는 코드를 수정하는 데서 끝내지 않고, 왜 필요한지, 언제 효과가 있는지, 어떤 경우에는 효과가 없는지까지 명확하게 전달하는 것을 함께 신경 쓰려고 합니다.
4. 참고
- 본편 : Iceberg V3 Deletion Vector 성능 해부 및 CPU 레벨 최적화
- 이슈 : apache/iceberg#18026
- PR : apache/iceberg#18027
- 백포팅 PR : apache/iceberg#18207