
Iceberg V3 Deletion Vector 성능 해부 및 CPU 레벨 최적화
- Apache Iceberg
- Apache Spark
- Core
Iceberg V3를 파고들던 중 Deletion Vector의 성능에 의문이 생겼습니다. 이 글은 그 의문에서 시작해 직접 성능을 측정하고, 예상이 틀릴 때마다 가설을 수정하면서 결국 병목을 찾아 최적화한 과정을 기록한 글입니다.
↳ 관련 Issue & PR
   **→ Issue :** [#18026](https://github.com/apache/iceberg/issues/18026)
   **→ PR :** [#18027](https://github.com/apache/iceberg/pull/18027)
   **→ 백포팅 PR :** [#18207](https://github.com/apache/iceberg/pull/18207)
↳ 이어지는 글 : Iceberg V3 Deletion Vector 최적화와 Upstream 기여
1. 서론
Merge-on-read 테이블에서 행을 삭제할 때 Iceberg는 데이터 파일 자체를 다시 쓰지 않습니다. 대신 별도의 구조에 "이 파일의 몇 번째 행이 삭제되었는가" 를 기록합니다. 데이터 파일을 직접 수정하지 않는 대신, 읽는 과정에서 삭제된 행을 걸러내는 비용을 부담하는 방식입니다.
Iceberg V3에서는 이 역할을 Deletion Vector(이하 DV)가 담당합니다. DV는 파일 하나에 대한 삭제된 행의 위치를 비트맵으로 기록합니다. 데이터 파일을 읽을 때는 각 행의 위치에 대해 isDeleted(position)을 호출해 삭제 여부를 확인하고, 삭제되지 않은 행만 다음 단계로 넘깁니다.
isDeleted(position)은 Iceberg의 PositionDeleteIndex에 정의된 메서드입니다. 여기서 position은 데이터 파일 안에서의 행 위치를 의미합니다. Iceberg를 활용해 개인 사이드 프로젝트를 진행하던 중, 여기서 한 가지 의문이 생겼습니다.
💡
isDeleted(position)확인 비용은 실제로 얼마나 될까? 그리고 그 비용을 결정하는 요인은 무엇일까?
처음에는 단순히 삭제된 행을 빠르게 찾아내기 위한 자료구조 정도로 생각했습니다. 하지만 실제 성능을 측정해보니 예상과 다른 결과가 나타났습니다. 그 원인을 따라가면서 DV 내부 구현뿐만 아니라 Spark의 벡터화된 읽기 경로와 CPU 수준의 동작까지 확인하게 됐습니다.
측정을 시작하기 전에 두 가지 가설을 먼저 세웠습니다. 첫 번째 가설은 삭제율이 높을수록 읽기 비용도 증가한다는 것이었습니다.
삭제된 행이 많아지면 비트맵도 커지고, 삭제 여부를 확인해야 하는 위치도 많아지기 때문에 자연스러운 예상이었습니다. 두 번째 가설은 Roaring Bitmap의 컨테이너 타입이 비용을 결정한다는 것이었습니다.
정렬된 배열은 이진 탐색을 수행하므로 분기 예측 실패가 많을 것이고, 비트맵은 상수 시간에 조회할 수 있으므로 더 저렴할 것이라고 생각했습니다. 두 가설 모두 충분한 설명이 되지 않았습니다. 첫 번째 가설은 성능 그래프를 그려보니 바로 깨졌고, 두 번째 가설은 하드웨어 카운터와 실제 읽기 경로를 따라가면서 수정하게 됐습니다.
이 글에서는 이 가설들이 어떻게 바뀌었는지, 그리고 그 과정에서 실제 병목을 어떻게 찾아갔는지를 따라가 보겠습니다.
2. Iceberg V3 Deletion Vector
본격적인 성능 분석에 앞서 Iceberg V3에서 행 삭제가 어떻게 처리되는지 간단히 살펴보겠습니다. 이 글의 목적은 Iceberg의 삭제 방식을 자세히 설명하는 것이 아니라 Deletion Vector의 성능이 어디에서 발생하는지 추적하는 것이므로, 필요한 부분만 다룹니다.
2.1 Row-level Delete
💬 Copy-on-write와 Merge-on-read
테이블 포맷에서 행을 삭제하는 방법은 크게 두 가지입니다.
| 방식 | 쓰기 | 읽기 |
|---|---|---|
| Copy-on-write | 데이터 파일을 다시 작성 | 읽기 비용이 낮음 |
| Merge-on-read | 삭제 정보를 별도로 기록 | 읽을 때 삭제 여부 확인 필요 |
이 글에서 관심을 갖는 부분은 Merge-on-read에서 발생하는 읽기 비용입니다.
💬 Position Delete와 Equality Delete
Iceberg V2에서는 삭제된 행을 표현하는 방법으로 크게 두 가지를 사용했습니다.
| 방식 | 삭제 대상 | 읽을 때 |
|---|---|---|
| Position Delete | 파일 + 행 위치 | 위치를 비교 |
| Equality Delete | 컬럼 값 | 실제 값을 읽고 비교 |
Position Delete는 삭제된 위치를 행마다 기록합니다. 삭제가 많아지면 삭제 파일 자체가 커지고, 읽을 때 여러 삭제 정보를 정렬하고 병합하는 비용도 함께 증가할 수 있습니다. Equality Delete는 특정 컬럼 값을 기준으로 삭제 여부를 판단합니다. 따라서 실제 컬럼 값을 읽고 삭제 조건과 비교해야 합니다.
💬 Deletion Vector (DV)
V3의 Deletion Vector는 Position Delete에서 행마다 기록하던 위치 목록을 하나의 비트맵으로 표현합니다.
data-file-a.parquet
        │
        └── deletion vector
                └── bitmap of deleted row positions
파일 하나에는 DV가 최대 하나만 존재합니다. 따라서 파일을 읽을 때 여러 삭제 파일을 각각 찾아 병합하는 대신, 해당 파일에 연결된 하나의 비트맵을 확인하면 됩니다. Equality Delete는 V3에서도 그대로 존재합니다.
컬럼 값을 기준으로 삭제하는 경우에는 행의 위치만으로 삭제 여부를 판단할 수 없기 때문입니다.
2.2 Roaring Bitmap
DV의 비트맵 구현에는 Roaring Bitmap이 사용됩니다. 이름만 보면 거대한 비트 배열 하나를 사용하는 것처럼 보이지만 실제 구조는 조금 다릅니다. 32비트 값 공간을 상위 16비트를 기준으로 나눠 Chunk를 만들고, 각 청크 안의 삭제 위치를 Container에 저장합니다.
청크의 밀도에 따라 서로 다른 컨테이너를 선택합니다. 청크 하나가 담당하는 범위는 다음과 같습니다.
2^16 = 65,536
대표적인 컨테이너는 다음과 같습니다.
| 컨테이너 | 저장 방식 | 조회 방식 |
|---|---|---|
array |
정렬된 16비트 배열 | 이진 탐색 |
bitmap |
8KB 고정 비트 배열 | 비트 테스트 |
run |
연속 구간을 (시작, 길이)로 압축 |
구간 이진 탐색 |
여기서 중요한 것은 컨테이너가 전환되는 기준입니다. 청크에 들어 있는 원소가 4,096개 이하이면 array, 4,097개부터는 bitmap을 사용합니다.
4,096 / 65,536
= 0.0625
= 6.25%
즉, 청크 하나에서 삭제율이 6.25%를 넘는 순간 array에서 bitmap으로 전환됩니다. 직접 만든 파서로 실제 Iceberg가 생성한 DV를 확인해도 같은 기준이 나타났습니다. 4,096개는 array, 4,097개는 bitmap이었습니다.
또한 삭제가 전혀 없는 청크에는 컨테이너 자체가 존재하지 않습니다. 이 특성이 이후 실험에서 중요한 단서가 됩니다.
2.3 DV 읽기 경로
지금까지 살펴본 내용을 실제 읽기 경로 위에 올려보겠습니다.
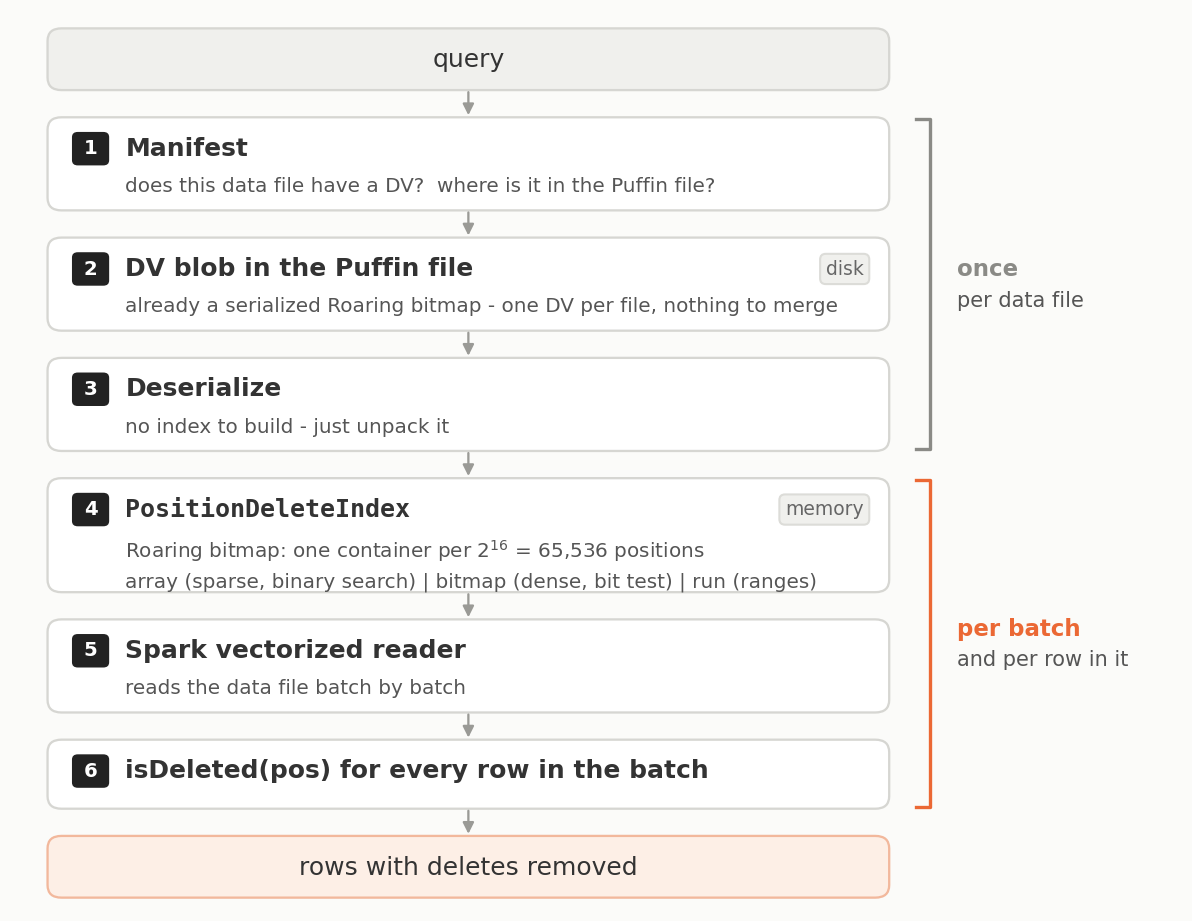
②에서 별도의 병합 단계가 없다는 점이 중요합니다.
파일 하나에 DV도 하나뿐이므로 여러 삭제 파일을 모아 정렬할 필요가 없습니다. blob 자체가 이미 비트맵이므로 읽은 뒤 인덱스로 펼치기만 하면 됩니다. 그런데 이 글에서 더 중요한 것은 오른쪽 부분입니다.
①~③은 데이터 파일당 한 번 수행됩니다.
반면 ④~⑥은 배치마다, 그리고 배치 안의 행마다 반복됩니다. DV를 도입하면서 위쪽의 비용은 줄었습니다. 하지만 아래쪽의 비용은 그대로 남아 있습니다. 이 글에서 집중할 부분도 바로 여기입니다.
3. 성능 특성
3.1 삭제율에 따른 성능 변화
8,000,000 (8백만) 행 테이블에서 삭제율만 바꿔가며 프로파일을 측정했습니다. 예상과 달리 결과는 단순한 우상향 곡선이 아니었습니다.
| 삭제율 | DV 체크 샘플 |
|---|---|
| 0.50% | 599 (576~633) |
| 5.00% | 746 (700~798) |
| 6.10% | 872 (838~909) |
| 6.25% | 654 (617~702) |
| 7.00% | 394 (381~406) |
| 12.00% | 422 (410~447) |
| 50.00% | 496 (454~529) |
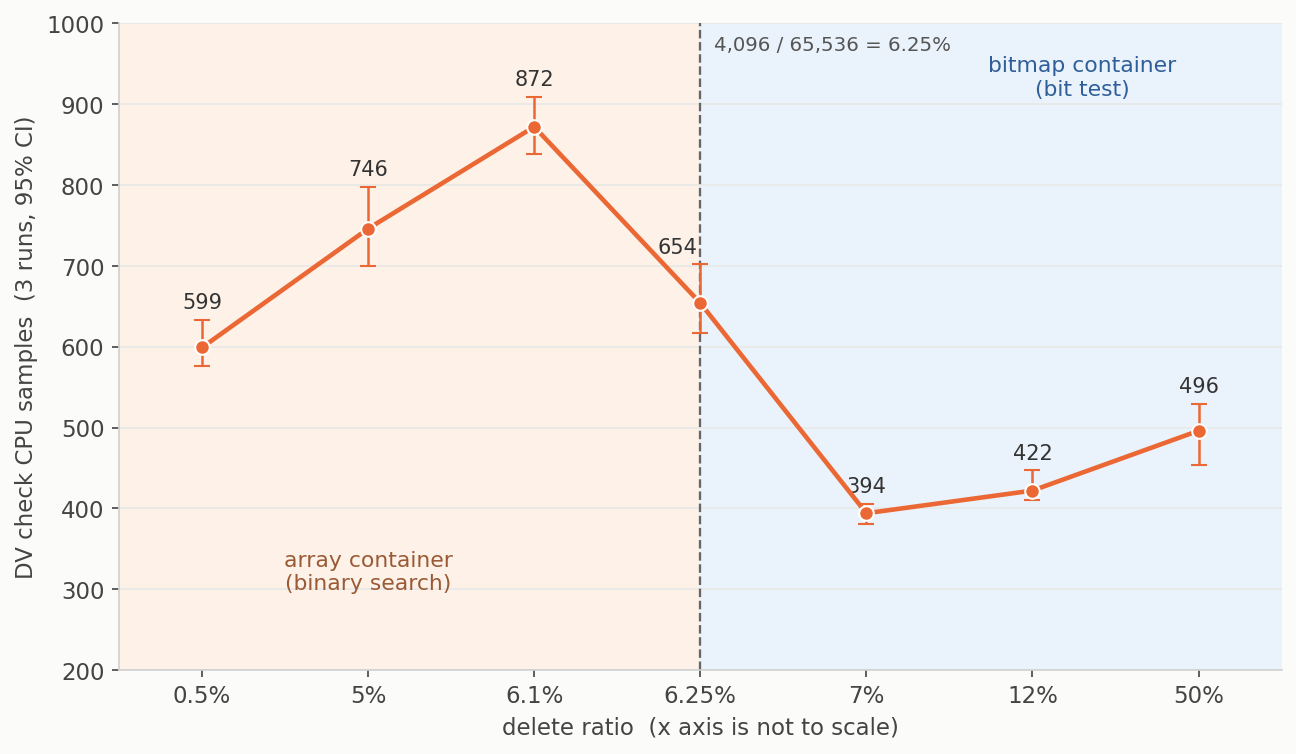
삭제율 6.1%가 7%보다 2.22배 더 비쌌습니다.
더 적게 삭제했는데 오히려 더 많은 CPU를 사용했습니다. 특히 6.4~7% 근처에서는 비용이 유난히 낮아지는 구간이 나타났습니다. 첫 번째 가설이 여기서 깨졌습니다.
3.2 6.25% 컨테이너 경계
성능이 급격하게 변한 구간은 Roaring Bitmap의 컨테이너 전환점과 정확히 겹쳤습니다. 청크 내 삭제 위치의 비율이 6.25%를 넘으면 컨테이너가 array에서 bitmap으로 전환됩니다. 이와 함께 삭제 위치를 조회하는 방식도 이진 탐색에서 비트 테스트로 변경됩니다.
경계 바로 아래인 d=6.1%에서 비용이 높은 이유도 여기서 설명할 수 있습니다. 이 구간에서는 array 컨테이너의 카디널리티가 최대치인 4,096에 가까워지면서 이진 탐색의 탐색 범위가 가장 커집니다. 반면 삭제 비율이 조금만 더 증가하면 컨테이너가 bitmap으로 전환되고, 조회 방식이 비트 테스트로 바뀌면서 조회 비용이 급격하게 감소합니다.
전환은 정확히 하나의 삭제 비율에서 일어나는 것이 아니라 청크별 카디널리티 차이 때문에 약 0.30%p의 구간에 걸쳐 나타났습니다.
3.3 삭제 위치 분포
여기까지만 보면 컨테이너 타입이 DV 체크 비용을 결정한다고 생각하기 쉽습니다. 그래서 이번에는 삭제율을 0.5%로 고정한 상태에서 삭제 위치의 분포를 변경했습니다. 삭제율과 삭제된 행 수가 동일한데도 최대 3.53배의 성능 차이가 발생했습니다.
처음에는 run 컨테이너가 원인이라고 생각했습니다. 하지만 컨테이너 타입을 동일하게 유지한 상태에서 삭제가 존재하는 청크의 수만 줄여도 2.22배의 차이가 발생했습니다. 따라서 run 컨테이너만으로는 이 차이를 설명할 수 없었습니다.
결국 DV 체크 비용은 하나의 변수로 결정되지 않았습니다.
삭제율
   │
청크 내부 밀도
   │
삭제 위치의 분포
   │
컨테이너 타입
   ↓
DV 체크 비용
이 시점까지는 DV 체크 비용이 여러 변수의 복합적인 영향을 받는다고 생각했습니다. 하지만 실제 읽기 경로를 따라가면서 다른 가능성을 확인할 수 있었습니다.
4. 병목 분석
4.1 컨테이너별 조회 비용
먼저 자료구조 자체의 비용부터 분리해서 측정했습니다. 컨테이너 타입별로 행 하나의 삭제 여부 확인 비용을 마이크로벤치로 측정했더니 약 4배의 차이가 나타났습니다. array가 가장 비쌌고 bitmap이 가장 저렴했습니다.
그렇다면 Iceberg의 래퍼가 추가하는 비용은 얼마나 될까요? BitmapPositionDeleteIndex가 RoaringBitmap을 직접 호출하는 경우와 비교해보니 1.1~2.8배의 차이가 나타났습니다. 즉, 래퍼 자체도 비용을 추가하고 있었습니다.
하지만 이것만으로는 앞서 관찰한 2.22배의 차이를 충분히 설명하기 어려웠습니다.
4.2 Spark 프로파일 분석
마이크로벤치에서 4배 차이가 난다고 해도 실제 쿼리에서 DV 체크가 전체 CPU의 1%만 차지한다면 최적화할 이유는 크지 않습니다. 그래서 실제 Spark 쿼리를 async-profiler로 프로파일링했습니다. 결과는 예상보다 컸습니다. 좁은 스캔에서는 DV 체크가 스캔 CPU의 40% 이상을 차지했습니다.
프로파일에서는 컨테이너 타입이 바뀌면 실제 쿼리 경로의 함수 비용도 달라지는 것을 확인할 수 있었습니다. 즉, 마이크로벤치에서 관찰한 컨테이너별 차이가 실제 Spark 읽기 경로에서도 나타나고 있었습니다. 다만 이 비중은 읽는 컬럼 수와 쿼리 형태에 따라 달라집니다.
컬럼 수가 늘어나면 Parquet 디코딩과 같은 다른 비용이 커지기 때문입니다.
4.3 Spark Vectorized Reader
다음으로 Spark가 이 비트맵을 실제로 어떻게 조회하는지 확인했습니다. 핵심은 ColumnarBatchUtil이었습니다. Spark의 벡터화된 리더는 하나의 배치를 처리하면서 살아남은 행의 번호를 다시 매기기 위해 다음과 같은 작업을 수행합니다.
for (int rowId = 0; rowId < batchSize; rowId++) {
  long pos = rowStartPosInBatch + rowId;
  if (!deletedPositions.isDeleted(pos)) {
    rowIdMapping[live++] = rowId;
  }
}
_deleted 같은 메타데이터 컬럼을 투영하는 경로에는 buildIsDeleted가 따로 있지만 구조는 같습니다.
행마다 한 번씩 isDeleted(pos)를 호출합니다.
4.4 isDeleted() 호출 구조
Iceberg의 기본 배치 크기는 5,000행입니다. 따라서 배치 하나를 처리할 때 최대 5,000번의 삭제 여부 조회가 발생합니다. 그런데 isDeleted(pos) 한 번은 단순한 배열 조회가 아닙니다. Roaring Bitmap에서는 대략 다음과 같은 과정을 거칩니다.
pos
 └→ 상위 / 하위 키 분리
     └→ bitmap 배열 범위 확인
         └→ 컨테이너 배열 이진 탐색
             └→ 컨테이너 내부에서 존재 여부 확인
문제는 한 번 찾은 컨테이너 정보를 다음 행에서 재사용하지 못한다는 것입니다. 배치 전체가 동일한 컨테이너 하나에 걸쳐 있더라도 앞의 탐색 과정이 5,000번 반복됩니다. 이제 앞에서 관찰했던 현상들이 연결됩니다.
삭제된 위치가 여러 청크에 흩어지면 컨테이너 배열이 길어지고, 매 행마다 수행하는 탐색도 복잡해집니다. 반대로 삭제 위치가 일부 청크에 집중되면 탐색해야 할 범위가 줄어듭니다. 따라서 3.53배의 차이와 2.22배의 차이도 결국 행마다 반복되는 탐색 비용으로 설명할 수 있었습니다.
컨테이너 타입이 비용에 영향을 주는 것은 맞습니다. 하지만 더 중요한 문제는 컨테이너를 찾는 탐색 자체를 매 행마다 반복하고 있다는 것이었습니다.
5. Range Traversal
5.1 연속적인 Position 구간
여기서 중요한 사실이 하나 있습니다. pos는 무작위로 들어오는 값이 아닙니다. 배치가 읽는 위치는 이미 연속적으로 증가합니다.
isDeleted(100)
isDeleted(101)
isDeleted(102)
...
isDeleted(5099)
즉, 리더는 이미 이번 배치가
[100, 5100)
이라는 연속된 position 구간을 처리한다는 사실을 알고 있습니다. 하지만 이 정보가 PositionDeleteIndex까지 전달되지 않고 있었습니다.
5.2 Row-by-row 조회
현재 구조에서는 다음과 같이 동작합니다.
100  → 컨테이너 탐색 → 삭제 여부 확인
101  → 컨테이너 탐색 → 삭제 여부 확인
102  → 컨테이너 탐색 → 삭제 여부 확인
...
5099 → 컨테이너 탐색 → 삭제 여부 확인
상위 키와 하위 키 분리, 배열 범위 확인, 컨테이너 이진 탐색이 배치 내내 반복됩니다. 성능 문제라고 하면 분기 예측 실패나 캐시 미스를 먼저 떠올리기 쉽습니다. 하지만 여기서는 그보다 앞선 문제가 있었습니다.
한 번 찾아도 되는 것을 5,000번 다시 찾고 있었습니다.
5.3 Range-based Traversal
핵심은 DV에 저장된 위치가 정렬되어 있다는 사실이 아닙니다. 리더가 처리하는 position이 연속된 구간이라는 점입니다. 따라서 다음과 같이 하나씩 조회하는 대신,
isDeleted(100)
isDeleted(101)
isDeleted(102)
...
isDeleted(5099)
연속된 구간 자체를 인덱스에 전달할 수 있습니다.
[100, 5100)
그러면 인덱스는 컨테이너를 한 번 찾은 뒤 해당 구간을 이어서 순회할 수 있습니다. 더 중요한 것은 이 기능을 위해 새로운 자료구조를 만들 필요가 없었다는 점입니다. Roaring Bitmap에는 이미 범위 순회를 위한 API가 존재했습니다.
5.4 마이크로벤치 결과
패치를 적용하기 전에 두 방식을 분리해 비교했습니다.
- Row-by-row : 각 position마다
isDeleted()호출 - Range traversal : 연속된 position 구간을 한 번에 순회
컨테이너 종류와 삭제 위치의 분포에 따라 56~150배의 차이가 나타났습니다. 특히 run 컨테이너에서도 큰 차이가 나타났습니다. 이 결과는 앞에서 관찰한 현상과도 잘 맞았습니다. isDeleted() 하나의 비용만 줄이는 것이 아니라, 같은 탐색을 행마다 반복하는 구조 자체를 제거하는 것이 더 큰 효과를 만들어냈습니다.
6. 최적화 구현
6.1 PositionDeleteIndex.forEachInRange
변경의 핵심은 배치가 이미 알고 있는 연속적인 position 구간을 인덱스에 그대로 전달하는 것입니다. PositionDeleteIndex에 구간 순회 메서드를 추가했습니다.
default void forEachInRange(long posStart, int length, LongConsumer consumer)
default 구현은 기존의 행 단위 루프를 그대로 수행합니다. 따라서 이 인터페이스를 구현한 다른 코드는 수정하지 않아도 기존 방식으로 동작합니다. 실제로 최적화가 필요한 구현체만 이 메서드를 재정의하면 됩니다.
PositionDeleteIndex
   ├── BitmapPositionDeleteIndex
   │      └── 좁혀진 bitmap 범위를 순회
   │
   ├── EmptyPositionDeleteIndex
   │      └── 아무 작업도 하지 않음
   │
   └── 기타 구현
          └── default 구현으로 기존 동작 유지
위 코드는 처음 제출한 형태입니다.
리뷰 과정에서
(posStart, posEnd)형태로 변경됐고, 그 과정에서 "최대 2개"라는 전제도 사라졌습니다.이 과정은 Iceberg V3 Deletion Vector 최적화와 Upstream 기여에서 별도로 다룹니다.
PositionDeleteIndex는 이미 merge, forEach, cardinality, serialize 등을 default 메서드로 확장해 온 인터페이스입니다. 이번 변경도 같은 방향으로 설계했습니다.
6.2 순회 방식 비교
Roaring Bitmap에는 범위를 순회하는 여러 방법이 있습니다. 그래서 실제로 여러 구현을 비교했습니다.
| 구현 | 0.5% | 5% | 12% |
|---|---|---|---|
현재 방식 (isDeleted) |
64.99 | 80.22 | 19.76 |
forAllInRange + RelativeRangeConsumer |
0.49 | 1.91 | 3.07 |
forEachInRange + 빈틈 채우기 |
0.45 | 1.87 | 4.16 |
BatchIterator |
0.63 | 2.79 | 5.92 |
단위는 µs이며, 낮을수록 좋습니다. run 컨테이너는 배치가 통째로 삭제되는 퇴화 조건에서 인용하기 어려운 숫자가 나와 비교에서 제외했습니다. BatchIterator는 삭제된 위치를 버퍼로 반환하기 때문에 매핑을 만들기 위한 두 번째 패스가 필요합니다.
반면 forEachInRange는 순회하면서 바로 매핑에 기록할 수 있습니다. forAllInRange는 삭제가 없는 구간을 O(1)로 건너뛸 수 있어 일부 조건에서 더 빨랐습니다. 그럼에도 최종적으로 선택한 것은 forEachInRange였습니다.
RelativeRangeConsumer는 존재하지 않는 위치까지 통보하고 벌크 콜백도 추가로 제공해야 하기 때문에 PositionDeleteIndex의 공개 인터페이스에 노출하기에는 표면적이 넓습니다. 반면 forEachInRange는 더 작은 인터페이스로 핵심적인 성능 이점을 대부분 유지할 수 있었습니다. 결국 0.45µs와 0.49µs의 차이를 위해 공개 인터페이스를 더 복잡하게 만들 이유는 없었습니다.
6.3 buildRowIdMapping
ColumnarBatchUtil의 buildRowIdMapping은 삭제되지 않은 행의 번호를 앞에서부터 다시 채우는 역할을 합니다. 기존에는 행마다 isDeleted()를 호출하면서 컨테이너를 다시 탐색했습니다. 이제는 배치가 처리하는 position 구간을 한 번에 전달합니다.
따라서 컨테이너를 찾기 위한 앞단의 탐색이 행 단위에서 배치 단위로 줄어듭니다.
6.4 buildIsDeleted
_deleted를 투영하는 buildIsDeleted 경로는 더 단순합니다. 살아남은 행의 번호를 앞으로 당길 필요 없이 주어진 구간을 순회하면서 삭제된 위치만 표시하면 됩니다. 따라서 rowIdMapping을 다시 만드는 비용이 없고, 개선폭도 더 크게 나타났습니다.
6.5 Equality Delete 경로
이번 패치는 삭제 경로 전체를 변경하지 않습니다. DV와 Position Delete만 구간 순회로 전환하고, Equality Delete는 기존 행 단위 평가를 유지합니다.
DV / Position Delete
    → Range traversal

Equality Delete
    → 기존 행 단위 평가
Position Delete는 행의 위치만 알면 삭제 여부를 판단할 수 있으므로 연속된 구간을 한 번에 순회할 수 있습니다. 반면 Equality Delete는 실제 행의 값을 읽고 삭제 조건과 비교해야 합니다. 단순히 position 구간을 알고 있다고 해서 이 과정을 건너뛸 수는 없습니다.
Equality Delete가 있는 테이블에서도 회귀가 발생하지 않는지 별도로 확인했습니다.
7. 성능 검증
7.1 전체 결과
먼저 주요 결과를 정리해보겠습니다. 단일 JVM, 1컬럼 투영 기준입니다.
| 삭제율 | 컨테이너 | 현재 | 패치본 | 개선 |
|---|---|---|---|---|
| 0.5% | array | 674 | 79 | 8.56배 |
| 6.1% | array | 873 | 94 | 9.28배 |
| 7.0% | bitmap | 420 | 113 | 3.73배 |
| 8.0% | bitmap | 499 | 142 | 3.51배 |
| 50% | bitmap | 584 | 225 | 2.60배 |
| 0.5% 정렬 | run | 185 | 61 | 3.05배 |
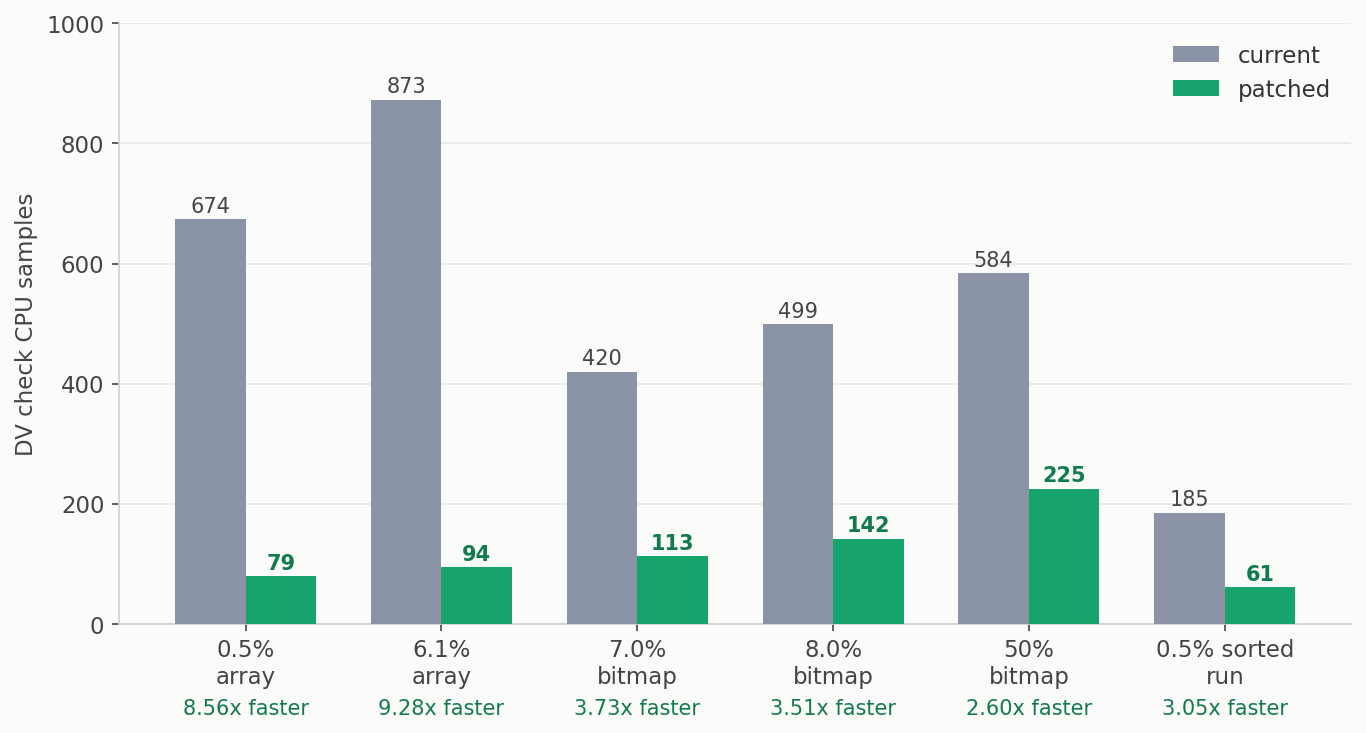
특히 앞에서 가장 비쌌던 6.1% 구간이 873에서 94로 감소했습니다. 9.28배의 개선입니다. _deleted 투영 경로에서는 개선폭이 14.9~18.9배로 더 컸습니다. 살아남은 행을 다시 앞으로 당기는 rowIdMapping 작업이 필요하지 않기 때문입니다.
배치 크기를 1,000~20,000행으로 변경했을 때도 개선 방향은 그대로 유지됐습니다.
7.2 실제 쿼리 효과
패치했을 때 실제 쿼리 시간이 얼마나 줄어드는지도 측정했습니다.
| 쿼리 | 패치 전 DV 체크 비중 | 패치 후 쿼리 시간 |
|---|---|---|
| 스캔만, 1컬럼 | 19.7% | −29.3% |
| 집계-소 | 10.5% | −10.8% |
| 집계-대 | 3.4% | −3.7% |
| 3노드 클러스터 | 42% (스캔 서브트리 기준) | −9.5% |
집계가 무거워질수록 DV 체크가 전체 쿼리에서 차지하는 비중은 작아집니다. 반면 스캔 서브트리 안에서 줄어드는 작업 자체는 크게 달라지지 않습니다. 즉, 최적화 대상의 비용과 전체 쿼리의 비용은 구분해서 봐야 합니다.
7.3 투영 폭과 손익분기점
DV 체크는 행마다 한 번 발생하기 때문에 읽는 컬럼 수와 직접적인 관계가 없습니다. 컬럼을 늘리면 Parquet 디코딩 비용이 증가하면서 DV 체크가 차지하는 상대적인 비중이 줄어듭니다.
| 읽는 컬럼 | 스캔 CPU에서 DV 체크 비중 |
|---|---|
| 1컬럼 | 53.2% |
| 3컬럼 | 24% |
| 5컬럼 | 16% |
| 20컬럼 | 3.75% |
정수 컬럼 10개에서는 DV 비중이 21.6%였지만, 문자열 컬럼 3개에서는 10.6%였습니다. 따라서 중요한 축은 단순한 컬럼 수가 아니라 디코딩 비용입니다. 실제 쿼리 시간도 함께 측정했습니다.
| 읽는 컬럼 | d=0.5% |
d=6.1% |
d=7.0% |
|---|---|---|---|
| 3컬럼 | −18.5% | −13.5% | −15.6% |
| 5컬럼 | −13.2% | −15.2% | −6.7% |
| 10컬럼 | −2.3% | −6.7% | +4.7% |
| 20컬럼 | −8.4% | +3.5% | +4.9% |
3컬럼과 5컬럼에서는 13~19% 수준의 쿼리 시간 단축이 나타났습니다. 반면 10컬럼부터는 결과의 방향이 섞이기 시작했습니다. 손익분기는 대략 7컬럼 부근이었습니다. 이는 PR에서 사용한
"DV 체크가 스캔 CPU의 약 21%를 넘으면 최적화 효과가 의미 있게 나타난다."
는 기준과 같은 현상을 다른 관점에서 표현한 것입니다. 정리하면 다음과 같습니다.
좁은 쿼리에서는 13~19%의 쿼리 시간 단축이 나타났지만, 컬럼 수가 많아질수록 전체 쿼리에서는 효과가 작아졌습니다.
8. 환경별 검증
8.1 실행 환경별 성능
이 현상이 특정 환경에서만 나타나는지 확인하기 위해 CPU, 스토리지, 병렬도, 파일 수와 실행 환경을 변경했습니다. 단일 JVM 환경에서 DV 체크가 스캔 CPU에서 차지하는 비중은 CPU 종류에 따라 대체로 43~58% 범위였습니다. 분산 클러스터에서도 42% 수준으로 나타났습니다.
파일 수에 따른 차이도 확인했습니다. 파일 수를 4개에서 488개로 늘리자 DV 비중이 60.7% → 49.7% 로 감소했습니다. 이는 DV 자체의 처리 비용이 감소한 것이 아니라, 파일마다 발생하는 DV 로드 고정비가 전체 CPU에서 차지하는 비중이 달라진 결과였습니다.
반면 콜드 캐시나 S3에서는 예상과 달리 DV 비중이 크게 낮아지지 않았습니다. ctimer는 CPU 시간을 측정하기 때문에 I/O 대기 시간은 분모에 포함되지 않으며, S3 클라이언트가 사용하는 CPU 역시 약 1%p에 불과했습니다. 환경을 바꾼 뒤에도 forEachInRange 적용에 따른 개선은 일관되게 나타났습니다.
| 환경 | DV 체크 비중 (0.5% / 6.1% / 7.0%) | 개선 배율 |
|---|---|---|
| 로컬 WSL2 (Zen 3) | 43.2% / 49.4% / 33.4% | 3.7 ~ 9.3배 |
EC2 m7i (Sapphire Rapids) |
49.3% / 56.2% / 39.3% | 5.2 ~ 16.8배 |
EC2 m7g (Graviton3) |
48.4% / 54.3% / 35.6% | 5.0 ~ 17.9배 |
| 3노드 클러스터 | 42% | 5.07 ~ 5.30배 |
클라우드 인스턴스에서도 동일한 패치가 적용됐고, DV 체크 비용 감소와 전체적인 성능 개선이 재현됐습니다. 다만 개선폭의 절대값은 환경에 따라 달랐습니다. 예를 들어 m7g에서는 938이 82로 감소해 약 11.4배의 개선이 나타났습니다.
반복 측정 편차는 로컬 WSL2에서 중앙값 27.2%, m7i에서 12.7%, m7g에서 7.0% 였습니다. 따라서 특정 CPU에서의 절대적인 개선폭을 일반화하기보다는, 서로 다른 CPU와 실행 환경에서도 동일한 병목과 최적화 효과가 반복해서 관찰됐다는 점에 의미를 두었습니다.
9. End-to-End 성능
9.1 클러스터 환경
분산 클러스터에서는 DV 비중이 42%로 낮아졌고 개선폭도 5.07~5.30배로 작아졌습니다. 익스큐터 시작, 태스크 직렬화, S3 읽기 등 DV 최적화와 관계없는 작업이 함께 포함되기 때문입니다. 패치가 줄일 수 없는 작업이 분모에 같이 들어가므로 DV 비중과 개선폭이 작아집니다.
그럼에도 이 환경에서 처음으로 쿼리 전체 시간이 9.5% 감소하는 것을 확인했습니다. 즉, DV 최적화가 실제 분산 환경의 벽시계 시간에도 영향을 줄 수 있음을 확인했습니다.
9.2 프로파일 비중과 실제 실행 시간
최악의 지점이었던 d=6.1%에서 DV 체크가 스캔 CPU에서 차지하는 비중은 49.4% → 9.6% 로 감소했습니다. 하지만 이 숫자를 그대로 쿼리 시간의 개선폭으로 읽으면 안 됩니다. 프로파일러의 샘플 비중이기 때문입니다.
같은 데이터에서 실제 실행 시간을 비교하면 최적화 효과는 이보다 작게 나타납니다. 즉,
프로파일러에서 50% 줄었다고 해서 쿼리가 50% 빨라지는 것은 아닙니다.
그래서 이 글에서는 벽시계 성능을 이야기할 때 항상 실제 실행 시간 측정값을 별도로 사용했습니다. 좁은 쿼리에서는 13~19% 수준의 실행 시간 단축이 확인됐지만, 집계가 무거워지거나 읽는 컬럼이 많아지면 DV가 전체 쿼리에서 차지하는 비중이 작아지면서 효과도 함께 줄어들었습니다. 특히 20컬럼을 읽는 경우 DV 체크 자체는 여전히 크게 줄었지만, 전체 스캔 CPU에서 차지하는 비중은 약 4.8% 에 불과했습니다.
따라서 최적화된 코드의 비용 감소와 전체 쿼리 성능은 별도로 측정해야 합니다.
10. Sorting과 Clustering
패치와 별개로 삭제 키를 기준으로 데이터를 정렬해서 쓰는 방법도 실험했습니다. 삭제가 소수의 청크에 집중되면서 DV 체크 비용이 2.80배 감소했습니다. 패치까지 함께 적용하면 12.39배 감소했습니다. 정리하면 다음과 같습니다.
- 정렬만 : 2.80배
- 패치만 : 7.8배
- 정렬 + 패치 : 12.39배
즉, 두 최적화는 서로 대체 관계가 아니었습니다. 정렬이 효과적인 이유도 처음 생각과 달랐습니다. run 컨테이너가 만들어져서가 아니라 삭제가 존재하는 청크 자체가 줄어들기 때문이었습니다. 삭제가 전혀 없는 청크에는 컨테이너가 존재하지 않으므로, 삭제를 특정 키 범위에 몰아놓으면 탐색해야 할 컨테이너가 줄어듭니다.
다만 정렬에는 쓰기 비용이 추가됩니다. 실험에서는 파일 크기가 2.6% 증가했고, 쓰기 비용은 63% 증가했습니다. 따라서 이 방법은 모든 워크로드에 적용할 수 있는 일반적인 최적화라기보다, 읽기가 쓰기보다 훨씬 많은 환경에서 고려할 수 있는 별도의 최적화에 가깝습니다.
11. Correctness 검증
성능보다 먼저 확인한 것은 기존 구현과 결과가 동일한가였습니다. 두 jar로 동일한 테이블 7개를 읽고 다음 값을 비교했습니다.
count(*)
sum(id)
min(id) / max(id)
모두 일치했습니다. Iceberg 자체 테스트도 통과했고, 새 API에 대해서는 경계 조건을 별도로 테스트했습니다.
- 빈 인덱스
- 길이 0과 음수
- 시작 위치 포함 / 끝 위치 제외
- 오름차순 보장
- 65,536 청크 경계
2^32키 경계- 할당되지 않은 키
run컨테이너- 무작위 구간을 기존 행 단위 방식과 대조
특히 마지막 테스트가 중요했습니다. 같은 구간을 기존 isDeleted() 방식으로 하나씩 확인한 결과와 forEachInRange()의 결과가 동일한지 직접 비교했습니다.
성능이 좋아졌다는 것보다 먼저 확인해야 할 것은 기존 구현과 같은 결과를 내는가였습니다.
12. 결론
12.1 병목의 구조
처음에는 문제를 단순하게 정의했습니다.
"DV가 느립니다."
하지만 측정을 끝낸 뒤에는 문제를 훨씬 정확하게 표현할 수 있었습니다.
Iceberg V3
    ↓
Deletion Vector
    ↓
Roaring Bitmap
    ↓
청크와 컨테이너
    ↓
Spark ColumnarBatch의 연속적인 position
    ↓
행마다 isDeleted()
    ↓
같은 컨테이너를 반복 탐색
    ↓
CPU 증가
핵심은 DV 자체가 느린 것이 아니었습니다. 리더는 이미 "이번 배치는 position 100번부터 5,099번까지 처리한다" 는 정보를 알고 있었습니다. 하지만 이 정보를 인덱스에 전달하지 않고 각 행을 독립적으로 조회하고 있었습니다.
컨테이너 타입은 비용에 영향을 줬습니다. 삭제율, 청크 밀도, 삭제 위치의 분포에 따라 비용이 달라진 것도 사실입니다. 하지만 이 모든 현상의 중심에는 행마다 반복되는 컨테이너 탐색이 있었습니다.
12.2 CPU 수준의 원인 분석
처음에는 array 컨테이너의 이진 탐색 때문에 분기 예측 실패가 주요 원인일 것이라고 생각했습니다. 하지만 하드웨어 카운터를 측정해보니 분기 실패는 컨테이너 비용 차이의 1.4%만 설명했습니다. 실제 쿼리 경로에서는 0.2% 에 불과했습니다.
비용 차이의 대부분은 명령어 수에서 발생했습니다. 즉, array가 비싼 이유를 단순히 "분기 예측 실패가 많아서"라고 설명할 수 없었습니다. 다만 삭제율이 높은 d=8% → 50% 구간에서는 분기 실패가 약 40% 증가했고, 이 경우 분기 예측이 비용 증가의 일부를 설명했습니다.
하지만 이것도 전체 증가분의 28.5% 수준이었습니다. 결국 CPU 수준의 분석에서도 처음의 가설 하나로 전체 현상을 설명할 수 없었습니다. 그리고 이 과정에서 중요한 것은 특정 CPU 카운터 하나를 찾는 것이 아니라, 프로파일러와 하드웨어 카운터를 이용해 가설을 하나씩 제거하는 것이었습니다.
13. 실험에서 얻은 것
13.1 자료구조보다 접근 방식
이번 문제에서는 Roaring Bitmap 자체를 수정할 필요가 없었습니다. 핵심은 호출 횟수를 줄이는 것이었습니다.
N번 호출
    ↓
1번 구간 순회
성능 문제를 보면 더 빠른 자료구조나 SIMD부터 떠올리기 쉽습니다. 하지만 이번에는 자료구조보다 이미 가지고 있는 정보를 활용하지 않는 접근 방식이 문제였습니다.
13.2 자료구조의 임계값과 실제 성능
4096 / 65536 = 6.25%라는 자료구조 내부의 상수가 실제 쿼리 프로파일에서도 그대로 나타났습니다. 특히 경계 바로 아래 구간이 가장 비쌌습니다. 삭제율을 조금 높이면 오히려 비용이 감소했습니다. 자료구조 내부의 임계값이 실제 워크로드의 성능 특성으로 그대로 나타날 수 있다는 것을 확인한 셈입니다.
13.3 비율의 분모
"DV 체크가 CPU의 절반을 차지한다."
이 표현만으로는 충분하지 않습니다. 해당 수치는 좁은 투영과 특정 실행 환경에서의 결과입니다. 20컬럼을 읽으면 같은 비용이라도 DV 체크의 비중은 3.75%로 내려갑니다. 정수 컬럼 10개에서는 21.6%였지만 문자열 컬럼 3개에서는 10.6%였습니다.
결국 성능 지표를 해석할 때는 숫자 자체보다 분자와 분모가 어떤 범위와 조건을 의미하는지가 중요했습니다. 이번 실험에서 확인한 손익분기도 같은 맥락입니다. DV 체크가 스캔 CPU의 약 21%를 넘는 경우부터 전체 쿼리에서도 최적화 효과가 의미 있게 나타났습니다.
즉, 특정 최적화가 효과적인지를 판단하려면 먼저 그 코드가 전체 작업에서 얼마나 큰 비중을 차지하는지 확인해야 합니다.
14. 마무리
이번 실험은 처음부터 정답을 알고 진행한 최적화 작업이 아니었습니다. 처음에는 삭제율이 높아지면 비용도 증가할 것이라고 생각했습니다. 그다음에는 Roaring Bitmap의 컨테이너 타입이 비용을 결정할 것이라고 생각했습니다.
하지만 실제 측정에서는 둘 다 충분한 설명이 되지 않았습니다. 프로파일러와 하드웨어 카운터를 따라가면서 결국 발견한 것은 더 단순했습니다. 이미 연속적인 position을 처리하고 있는데, 행마다 같은 컨테이너를 다시 찾고 있었습니다.
그래서 해결책도 새로운 자료구조가 아니었습니다.
isDeleted(pos)
isDeleted(pos + 1)
isDeleted(pos + 2)
...
를
forEachInRange(start, end)
로 바꾸는 것이었습니다. 마이크로벤치에서는 56~150배, 실제 Spark 환경에서는 최악의 6.1% 구간에서 9.28배, 좁은 쿼리에서는 전체 실행 시간이 13~19% 감소했습니다. 반면 읽는 컬럼이 많아지거나 집계가 무거워지면 DV 자체가 아무리 빨라져도 전체 쿼리 시간에서는 효과가 작아졌습니다.
이 차이가 이번 실험에서 가장 중요했던 부분입니다.
자료구조의 성능과 쿼리의 성능은 같은 것이 아닙니다.
어떤 코드가 느린지 찾는 것과, 그 코드를 최적화했을 때 실제 사용자에게 보이는 성능이 얼마나 좋아지는지를 확인하는 것은 별개의 문제였습니다. 그리고 이 변경을 Apache Iceberg에 실제로 올리는 과정은 또 다른 이야기였습니다. Slack과 메일링 리스트를 거쳐 커뮤니티 논의를 진행하고, 리뷰를 반영하고, API를 수정하고, PR을 머지한 뒤 나머지 Spark 버전으로 백포팅하기까지의 과정은 별도의 글에 정리했습니다.
제안한 변경은 리뷰를 거쳐 Iceberg가 유지하는 Spark 네 버전 모두에 반영됐습니다.
부록. 측정 조건
모든 주요 성능 수치는 설정당 3회 이상 반복 측정한 중앙값입니다. 반복 측정에서 관찰된 실행 시간 편차의 중앙값은 9.7%였습니다.
- CPU: Ryzen 5 5600X (Zen 3)
- 환경: WSL2
- Spark: 4.0
local[4] - JDK: 17
- 스토리지: 로컬 NVMe, 웜 캐시
- 테이블: 825MB, 800만 행
- 배치 크기: Iceberg 기본값 5,000
- 기본 투영: 1컬럼 좁은 투영
- 클라우드 환경:
m7i.xlarge(Sapphire Rapids),m7g.xlarge(Graviton3) - 분산 환경: 3노드 Spark standalone
- 벤치마크 JDK: 21
- Spark 측정 JDK: 17
벤치마크와 Spark 측정은 서로 다른 실험 축이므로 JDK 버전 차이를 성능 차이의 원인으로 해석하지 않았습니다.
참고문헌
명세와 구현
- Apache Iceberg Table Spec : Deletion Vectors
- Apache Iceberg Puffin Spec
org.apache.iceberg.deletes.RoaringPositionBitmap(Icebergcore)org.apache.iceberg.deletes.PositionDeleteIndex·BitmapPositionDeleteIndex(Icebergcore)org.apache.iceberg.spark.data.vectorized.ColumnarBatchUtil(Icebergspark)- RoaringBitmap (Java)
- Chambi, Lemire, Kaser, Godin, Better bitmap performance with Roaring bitmaps (2016)
- Issue : apache/iceberg#18026
- PR : https://github.com/apache/iceberg/pull/18027
- 백포팅 PR : https://github.com/apache/iceberg/pull/18207
- 업스트림 기여 과정 : Iceberg V3 Deletion Vector 최적화와 Upstream 기여
측정 도구
- async-profiler :
ctimer·cycles·instructions·branch-misses·cache-misses - JMH