
Jev는 과연 Airflow 장애 대응에 쓸 만할까?
- Jev
- AI
- Apache Airflow
요즘 판정 모델 Jev 이야기가 부쩍 자주 들립니다. 긴 글을 생성하는 LLM과 달리, 정해진 형식의 판정(보기 선택, 점수, 예/아니오 등)을 수행하는 모델이라 사람이 직접 하던 판단을 자동화 파이프라인에 넣기 좋다는 이야기가 많습니다.
그래서 저도 한 가지 궁금증이 생겼습니다. 데이터 엔지니어에게 판정 모델 Jev는 실제 실무에서 유용한 도구일까? 이 궁금증을 확인하기 위해 Airflow에서 실제 장애 30가지를 직접 발생시키고, Jev와 기존 DB 기반 판정 방식을 비교하는 실험을 진행했습니다.
이 글에서는 그 실험 과정과 결과를 공유합니다.
Test 환경
- Airflow 3.3.2
- Spark 3.5.5
- Iceberg 1.11.0
- PostgreSQL 16
- EC2 t3.xlarge
Test 규모
- 장애 30종류
- 총 518건
Test 비용
- Jev 판정 약 $0.15
- 서버 약 $2.2
1. 새벽마다 반복되는 '재시도 버튼 누르기'
데이터 파이프라인을 운영하다 보면 비슷한 일이 반복됩니다. 새벽에 Spark 작업이 실패했다는 알림이 오면 일어나서 로그를 열고, 한참 스크롤을 내린 뒤 재시도를 누릅니다. 성공합니다. 다시 잡니다. 이런 일이 생기는 이유는 재시도만으로 해결되는 장애가 생각보다 많기 때문입니다.
예를 들어 서버가 회수되면서 작업이 함께 종료되거나, 앞 단계가 조금 늦어 아직 읽으려는 파일이 생성되지 않았거나, 두 작업이 같은 테이블에 동시에 쓰면서 충돌하는 경우가 있습니다. 이런 장애는 작업 자체에 문제가 있는 것이 아니라 상황이 일시적으로 꼬였을 뿐이라 다시 실행하면 정상적으로 끝날 수 있습니다.
그렇다면 이런 장애는 자동으로 재시도하면 되지 않을까요?
문제는 모든 장애를 재시도해도 되는 것은 아니라는 점입니다. 잘못된 데이터, 코드 오류, 스키마 변경처럼 다시 실행해도 해결되지 않는 장애까지 무작정 재시도하면 불필요한 작업이 반복되고, 오히려 장애를 키울 수도 있습니다.
결국 필요한 것은 단순한 자동 재시도가 아닙니다. 로그를 보고, 이 장애가 '다시 실행하면 해결될 가능성이 있는 장애인지' 판단하는 과정이 필요합니다. 1.1에서 그 예시를 하나 보겠습니다.
1.1. 가장 골치 아픈 exit 137
Airflow 운영을 하다 보면 보이는 대표적인 사례가 exit 137입니다. 같은 137이라는 종료 코드가 완전히 다른 상황에서 발생할 수 있기 때문입니다.
| 실제로 일어난 일 | 로그 | 해야 할 일 |
|---|---|---|
| 메모리를 너무 많이 사용해 커널이 프로세스를 종료 | exit 137 |
설정이나 작업을 수정해야 함 |
| 서버가 회수되면서 프로세스가 종료 | exit 137 |
다시 실행하면 됨 |
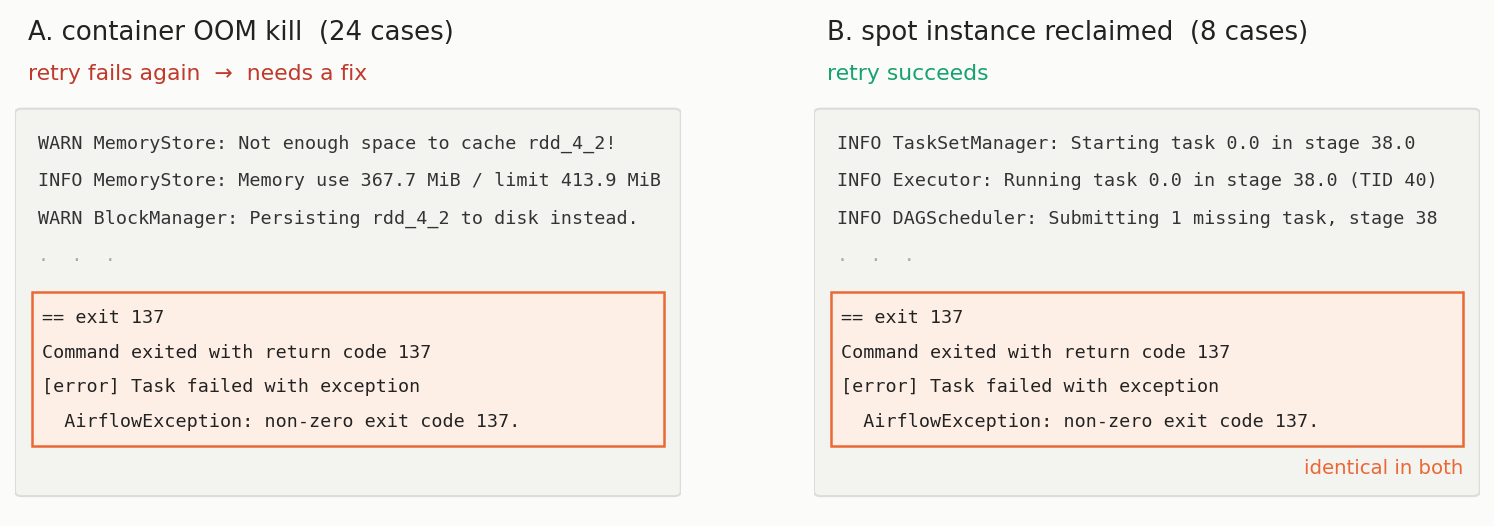
현재 사용하는 자동 분류 방식은 로그에서 특정 문자열을 찾는 규칙입니다. 137이 있으면 메모리 문제로 판단하는 식입니다. 그러면 두 상황 중 하나는 반드시 잘못 판단하게 됩니다. 종료 코드 자체가 같기 때문에, 정규식을 아무리 정교하게 만들어도 이 정보만으로는 둘을 구분할 수 없습니다. 결국 사람이 Log를 확인해야 하고, 그 때문에 새벽에 일어나게 되는 일이 벌어지게 됩니다.
2. 판정 모델 Jev의 도입과 구조
여기서 Jev를 사용해보기로 했습니다. Jev는 TypeSafe의 판정 모델입니다. 일반적인 생성형 AI처럼 긴 설명을 작성하는 모델이 아니라, 정해진 형식의 판정을 수행하는 모델입니다. 판정 방식은 크게 세 가지입니다.
choice: 여러 선택지 중 하나를 선택score: 점수로 평가noul: 예/아니오를 확률로 판단
이번 실험에서는 noul만 사용했습니다. 질문은 단순합니다.
"이 작업을 다시 실행하면 성공할까?"
Jev는 여기에 대해 0~1 사이의 확률 하나를 반환합니다. 입력으로 넘긴 정보도 사람이 장애를 확인할 때 보는 정보와 크게 다르지 않습니다.
dag: warehouse_rollup
task: wh_rollup_agg
try: 1/2
duration: 40s
exit_code: 1
pod_phase: Failed
pod_reason: Error

log tail:
Running command: ['/usr/bin/bash', '-c', 'bash run_job.sh rollup_v2.py 2g 1 180']
... Spark가 남긴 실행 기록 ...
[critical] Process terminated by signal. Likely out of memory error (OOM).
실제로는 요약 정보 몇 줄과 로그 마지막 200줄을 전달했습니다. try: 1/2는 Airflow 표기를 그대로 옮긴 것입니다. 첫 실행이고, 자동 재시도가 2번 남아 있다는 의미입니다. 이번 실험의 모든 작업은 자동 재시도 2번으로 설정했기 때문에 최대 3번 실행됩니다. 한 건을 판정하는 데 걸린 시간은 약 0.4초, 비용은 약 $0.0001이었습니다.
3. 객관적인 정답 데이터 도출 과정
이 실험에서 가장 오래 고민한 부분입니다. Jev가 얼마나 잘 판단했는지 확인하려면 먼저 실제 정답이 있어야 합니다. 그런데 제가 장애를 만들고, 동시에 "이 장애는 재시도로 해결된다"라고 정답까지 직접 지정하면 어떨까요?
시험 문제를 제가 만들고 답안까지 제가 작성하는 것과 같습니다. 그러면 아무리 테스트 결과가 잘 나와도 의미가 없습니다. 그래서 정답은 실제 Airflow 실행 결과에서 가져오기로 했습니다. EC2에 실제 Airflow와 Spark를 구성하고 직접 장애를 발생시켰습니다. 메모리를 부족하게 만들어 프로세스를 죽이고, 실행 중인 컨테이너를 강제 종료하고, 존재하지 않는 테이블을 읽게 하고, 권한이 없는 경로에 쓰게 했습니다.
전체 흐름은 다음과 같습니다.
장애 발생
   ↓
Airflow가 실제로 실행
   ↓
Airflow가 자동으로 재시도
   ↓
최종적으로 성공했는지 확인
   ↓
Airflow 메타 DB에 남은 실행 결과를 정답으로 사용
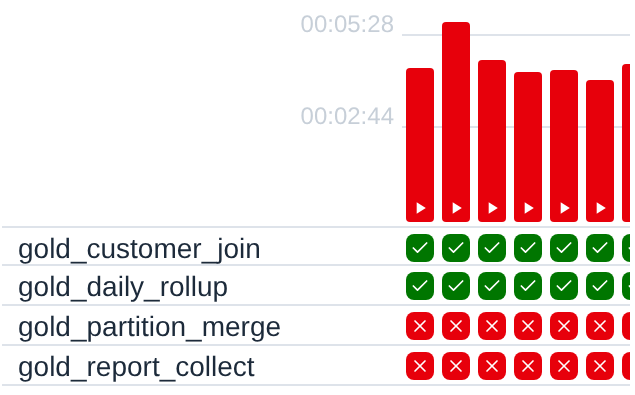
예를 들어 장애가 발생한 뒤 재시도하여 최종적으로 성공했다면, “이 장애는 재시도로 해결된 장애” 로 판단했습니다. 반대로 재시도를 모두 수행했음에도 최종적으로 실패했다면, “이 장애는 재시도만으로 해결되지 않는 장애” 로 판단했습니다.
즉, 정답을 제가 직접 작성한 것이 아닙니다. 실제 장애를 발생시키고, 실제 Airflow가 재시도를 수행하고, 그 결과를 Airflow가 기록하도록 했습니다. 이렇게 하면 Jev의 판단 결과를 실제 실행 결과와 비교할 수 있습니다.
결국 이 실험에서 중요한 것은 “Jev가 그럴듯하게 판단했는가?” 가 아니라, “실제로 재시도해서 해결된 장애를 Jev도 그렇게 판단했는가?” 를 확인하는 것이었습니다.
4. 실무 환경을 모사한 30가지 장애 시나리오
이번 실험에서는 총 30가지 장애 상황을 만들었습니다. 가능하면 실제 운영 환경에서 한 번쯤 발생할 수 있는 상황을 기준으로 구성했습니다.
4.1. Retry로 해결되는 장애 11가지
| 장애 | 현업에서 언제 생기나 |
|---|---|
| 서버 회수 | 스팟 인스턴스가 반납되거나 노드가 빠질 때 |
| 종료 신호 | 롤링 배포·노드 드레인으로 작업이 정리될 때 |
| 프로세스 강제 종료 | 워커가 메모리로 죽거나 노드가 빠질 때 |
| 프로세스 종료 (작업은 정상) | 노드가 빠졌을 뿐 작업에는 문제가 없을 때 |
| 앞 단계 지연 | 상류가 아직 파일을 쓰지 않았는데 먼저 읽을 때 |
| 망가진 파일 | 상류가 쓰다 만 파일을 하류가 먼저 읽을 때 |
| 체크포인트 손상 | 쓰다 만 체크포인트를 읽을 때 |
| 코드 배포 지연 | 필요한 모듈이 아직 배포되지 않았을 때 |
| 테이블 정리 충돌 | Iceberg 정리 작업이 진행되는 동안 읽을 때 |
| 쓰기 충돌 | 두 작업이 같은 테이블에 동시에 쓸 때 |
| 외부 API 일시 오류 | 연동 API가 잠시 503을 반환할 때 |
4.2. 실제 사람의 개입이 필요한 장애 19가지
| 장애 | 현업에서 언제 생기나 |
|---|---|
| 메모리 한도 초과 | 컨테이너 메모리보다 많이 사용할 때 |
| JVM 힙 부족 | 결과를 드라이버로 너무 많이 모을 때 |
| 작업 자신의 메모리 초과 | 작업이 메모리를 과도하게 사용해 워커까지 죽을 때 |
| 수집 한도 초과 | 드라이버로 모으는 결과가 설정 한도를 넘을 때 |
| 디스크 부족 | 정렬·셔플 임시 공간이 부족할 때 |
| 파일 개수 한도 | 파티션을 잘게 쪼개 동시에 여는 파일이 많을 때 |
| 없는 테이블 | 상류가 테이블을 만들지 않았거나 이름이 바뀌었을 때 |
| 형식 불일치 | 상류가 컬럼 타입을 변경해서 쓸 때 |
| 스키마 뒤섞임 | 같은 경로에 형식이 다른 파일이 섞였을 때 |
| 이미지 없음 | 배포한 이미지 태그가 잘못됐을 때 |
| 드라이버 없음 | 필요한 JDBC 드라이버가 이미지에 없을 때 |
| GPU 없는 서버 | GPU를 요구하는데 클러스터에 없을 때 |
| 쓰기 권한 없음 | 대상 경로에 쓸 권한이 없을 때 |
| 외부 DB 무응답 | 연동 DB가 내려갔거나 방화벽에 막혔을 때 |
| 직렬화 실패 | UDF가 직렬화할 수 없는 객체를 붙잡고 있을 때 |
| 워커 크래시 | 네이티브 라이브러리가 Python 워커를 죽일 때 |
| 반복되는 충돌 | 두 작업이 매번 같은 시점에 충돌할 때 |
| 파티션 덮어쓰기 충돌 | 두 작업이 같은 파티션을 동시에 교체할 때 |
| 프로세스 종료 (작업이 문제) | 작업 자체의 문제로 종료됐지만 겉보기에는 동일할 때 |
여기서 마지막 장애는 일부러 만든 함정입니다. 위쪽의 "프로세스 종료 (작업은 정상)" 과 로그를 완전히 동일하게 만들고, 실제 원인과 정답만 반대로 구성했습니다. 겉으로 보이는 로그만으로 판단하면 반드시 틀리게 되어 있습니다.
5. Jev 단독 적용의 성과와 한계
처음에는 최대한 단순하게 구성했습니다. 재시도 횟수가 남아 있는지만 확인하고, 나머지는 Jev의 판단 하나에 맡겼습니다. 비교를 위해 현재 사용하고 있는 방식과 유사한 정규식 기반 규칙도 같은 518건에 적용했습니다. 정규식 규칙은 로그에서 137, OutOfMemoryError와 같은 문자열을 찾고, 발견된 원인별로 재시도 여부를 미리 정의하는 방식입니다.
결과는 다음과 같았습니다.
| 방식 | 재시도 판단 | 실제 재시도로 해결된 건 | 잘못된 판단 | 놓친 장애 |
|---|---|---|---|---|
| 정규식 규칙 | 15 | 3 | 12 | 113 |
| Jev | 32 | 27 | 5 | 89 |
정규식 규칙은 실제로 재시도로 해결된 116건 중 3건만 찾아냈습니다. 재시도 대상으로 판단한 15건 가운데 실제로 해결된 것은 3건이었고, 12건은 재시도해도 해결되지 않았습니다. 반면 Jev는 재시도 대상으로 판단한 32건 중 27건이 실제로 해결됐습니다. 즉, Jev가 재시도 대상으로 판단한 경우의 정확도는 84% 였습니다.
정규식 규칙에 비해 재시도로 해결될 가능성이 높은 장애를 훨씬 잘 골라냈습니다. 하지만 한계도 분명했습니다. 실제로 재시도로 해결된 장애는 총 116건이었지만, Jev가 찾아낸 것은 27건뿐이었습니다. 결국 재시도로 해결할 수 있는 장애의 대부분을 여전히 놓치고 있었습니다.
Jev는 틀리게 재시도하는 경우는 많이 줄였지만, 반대로 재시도 할 만한 장애를 너무 많이 놓치고 있었습니다.
6. Jev가 놓친 장애는 왜 놓쳤을까?
Jev 단독 실험에서 가장 눈에 띄었던 문제는 재시도로 해결되는 장애를 많이 놓친다는 것이었습니다. 실제로 재시도로 해결될 수 있는 장애는 총 116건이었지만, Jev가 재시도로 판단한 것은 27건뿐이었습니다. 그렇다면 Jev는 왜 나머지 89건을 놓쳤을까요?
하나씩 확인해보니 해당 장애들은 다음과 같은 형태였습니다.
- 파일이 없다
- 모듈이 없다
- 테이블을 찾을 수 없다
이런 장애는 앞 단계가 조금 늦었을 뿐이라 기다렸다가 다시 실행하면 해결되는 경우였습니다. 문제는 로그만 보면 정말 파일이나 모듈이 영원히 없는 상황과 구분하기 어렵다는 점입니다. 예를 들어 다음과 같은 로그가 있다고 해보겠습니다.
FileNotFoundException:
s3://warehouse/events/date=2026-09-24/data.parquet
이 로그만 보면 두 가지 가능성이 모두 존재합니다.
① 앞 단계가 아직 파일을 만들고 있다
② 애초에 파일이 만들어지지 않는다
사람이라면 같은 DAG Run의 다른 작업이 아직 실행 중인지 확인해볼 수 있습니다. 하지만 Jev에게 전달된 정보는 실패한 작업의 로그와 실행 정보였습니다. 즉, 로그에 없는 시스템 상태까지 알 수는 없었습니다.
이 부분은 Jev가 잘못 판단했다고 보기는 어려웠습니다. 판단에 필요한 정보 자체가 없었기 때문입니다. 여기서 한 가지 의문이 생겼습니다.
그렇다면 로그에 없는 정보를 Jev에게 추가로 제공하면 더 잘 판단할 수 있지 않을까?
7. Jev에게 더 많은 정보를 주면 좋아질까?
먼저 Airflow가 이미 알고 있는 정보를 확인했습니다. Airflow 메타 DB에는 같은 DAG Run에 속한 다른 작업의 실행 상태가 남아 있습니다. 예를 들어 실패한 작업이 읽으려는 파일을 다른 작업이 만들고 있고, 그 작업이 아직 실행 중이라면 다음과 같이 판단할 수 있습니다.
실패한 작업
    ↓
파일이 없음
    ↓
같은 DAG Run의 앞 단계 확인
    ↓
아직 실행 중
    ↓
조금 기다린 후 재시도하면 될 가능성이 높음
이 정보는 로그를 읽는 것과는 다른 종류의 정보입니다. 로그가 "무슨 일이 발생했는가" 를 보여준다면, 시스템 상태는 "지금 시스템에서 무슨 일이 진행되고 있는가" 를 보여줍니다. 그래서 이 정보를 Jev에게 전달해봤습니다.
예를 들어 다음과 같은 정보를 추가했습니다.
같은 실행 묶음의
cat_rewrite가 126초째 실행 중이고, 해당 작업이 이 경로를 함께 다루고 있다.
그리고 기존처럼 코드에서 직접 판단하지 않고, Jev가 이 정보까지 보고 재시도 여부를 판단하도록 했습니다. 결과는 다음과 같았습니다.
| 로그만 줬을 때 | DB 내용까지 줬을 때 | |
|---|---|---|
| 확률 중앙값 | 0.07 | 0.13 |
| 확률이 올라간 건수 | - | 67건 중 61건 |
| 문턱(0.34)을 넘은 건수 | 3건 | 2건 |
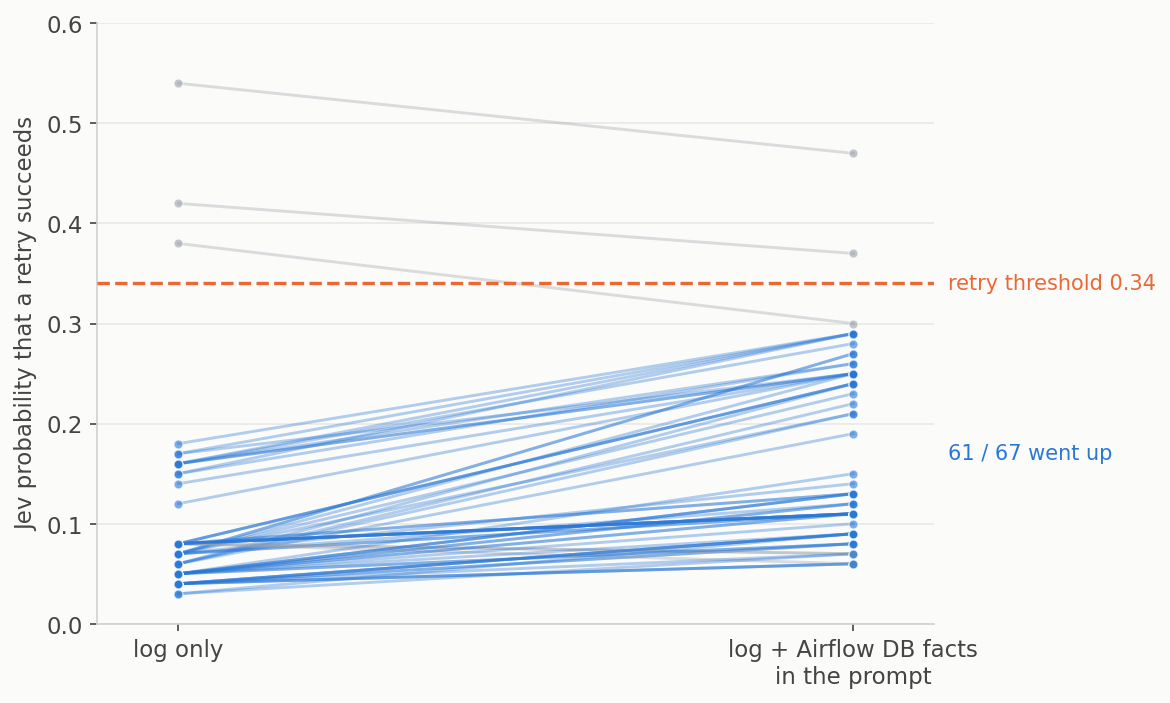
흥미로운 결과였습니다. 67건 중 61건에서는 Jev의 확률이 실제로 올라갔습니다. 즉, 추가 정보를 읽고 판단을 어느 정도 수정하기는 했습니다. 하지만 최종적으로 자동 재시도 기준인 0.34를 넘은 건은 오히려 2건뿐이었습니다. 확실한 시스템 상태를 알려줬다고 해서 Jev가 그 정보를 항상 결정적인 근거로 사용하는 것은 아니었습니다.
전체 518건으로 비교해도 비슷했습니다.
- 로그만 제공 → 27건을 재시도로 판단, 5건 오판
- DB 정보 추가 → 24건을 재시도로 판단, 8건 오판
결국 여기서 중요한 사실을 하나 확인했습니다.
Jev에게 정보를 더 많이 전달하는 것과, 그 정보를 코드에서 확정적으로 사용하는 것은 다르다.
시스템 상태처럼 이미 확인할 수 있는 정보라면 모델에게 다시 판단을 맡길 필요가 없습니다. 오히려 코드가 더 정확하게 처리할 수 있습니다. 그렇다면 여기서 한 가지 질문이 남습니다.
그럼 Jev를 아예 빼버리면 어떻게 될까?
8. Jev가 정말 추가적인 가치를 만들었을까?
여기서부터가 이번 실험에서 가장 중요하게 확인하고 싶었던 부분입니다. DB 조회와 규칙만으로도 상당수의 장애를 찾아낼 수 있었습니다. 그렇다면 굳이 Jev까지 추가할 필요가 있을까요? 이 질문에 답하기 위해 Jev가 없는 시스템과 Jev를 추가한 시스템을 직접 비교했습니다.
먼저 다음과 같이 구성했습니다.
Airflow 장애 발생
       ↓
재시도 가능 횟수 확인
       ↓
시스템 상태 확인
       ↓
로그에 명확한 외부 종료 흔적 확인
       ↓
재시도 여부 판단
여기에는 Jev를 사용하지 않았습니다. 그리고 같은 데이터에 Jev를 추가했습니다.
Airflow 장애 발생
       ↓
재시도 가능 횟수 확인
       ↓
시스템 상태 확인
       ↓
확실하게 판단할 수 있는가?
   ├─ Yes → 코드로 판단
   └─ No
       ↓
로그의 맥락 분석
       ↓
Jev로 판단
결과는 다음과 같았습니다.
| 방식 | 재시도로 넘긴 것 | 그중 실제로 풀림 | 잘못 넘김 | 놓침 |
|---|---|---|---|---|
| 정규식 규칙 | 15 | 3 | 12 | 113 |
| Jev만 | 32 | 27 | 5 | 89 |
| DB 조회 + 흔적 규칙 (Jev 없음) | 91 | 85 | 6 | 31 |
| DB 조회 + 흔적 규칙 + Jev | 113 | 105 | 8 | 11 |
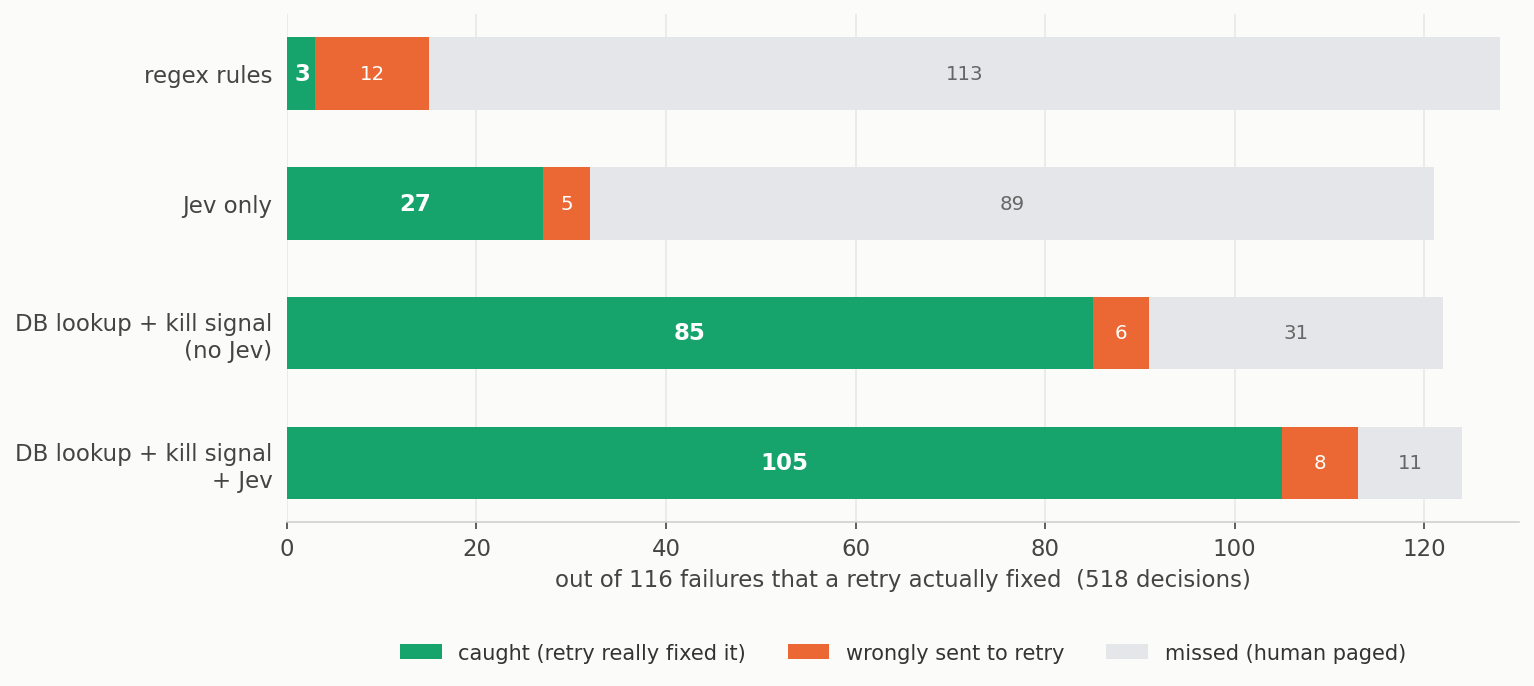
결과를 보면 이번 실험에서 가장 큰 역할을 한 것은 Jev가 아니라 시스템 상태를 직접 확인하는 규칙이었습니다. Jev 없이도 85건을 찾아냈습니다. 하지만 Jev를 추가하자 놓치는 장애가 31건에서 11건으로 줄었습니다. 즉, Jev가 모든 장애를 해결한 것은 아니지만 기존 규칙만으로 판단하기 어려운 장애를 추가로 찾아내는 역할은 분명히 했습니다.
대신 잘못 재시도하는 경우는 6건에서 8건으로 2건 늘었습니다. 따라서 Jev를 추가한다고 해서 모든 지표가 좋아지는 것은 아니었습니다. 대신 놓치고 있던 장애를 더 찾아낼 수 있게 됐습니다.
8.1. Jev가 추가로 찾아낸 장애
Jev를 추가했을 때 새롭게 찾아낸 20건을 살펴봤습니다.
| 장애 | 건수 | 왜 규칙으로는 안 되나 |
|---|---|---|
| 외부 API 일시 오류 | 12 | DB에 남는 정보가 없고 외부 종료 흔적도 없음 |
| 서버 회수 | 6 | exit 137이라 메모리 초과와 로그가 동일함 |
| 종료 신호 | 2 | 롤링 배포로 정리된 흔적이 로그 맥락에만 있음 |
여기서 Jev가 어떤 상황에서 유용했는지가 조금 더 명확해집니다. 예를 들어 exit 137을 보겠습니다. 종료 코드만 보면 다음 두 상황을 구분하기 어렵습니다.
메모리를 너무 많이 사용함
        ↓
프로세스 종료
        ↓
exit 137
또는
서버가 회수됨
        ↓
프로세스 종료
        ↓
exit 137
정규식으로 137을 찾는 것만으로는 둘을 구분하기 어렵습니다. DB에서도 이 차이를 항상 알 수 있는 것은 아니었습니다. 하지만 로그 앞뒤의 맥락을 살펴보면 차이가 나타날 수 있습니다. 실제로 서버 회수 8건 가운데 Jev는 6건을 재시도로 판단했습니다.
이처럼 Jev가 의미가 있었던 지점은 규칙이 이미 알고 있는 장애를 더 빠르게 처리하는 곳이 아니었습니다. 오히려 규칙만으로는 구분하기 어려운 로그의 맥락을 판단하는 영역에서 역할을 했습니다.
8.2. 반대로 Jev가 잘못 판단한 경우
물론 Jev가 항상 올바르게 판단한 것은 아닙니다. 최종 구성에서 잘못 재시도로 넘긴 장애도 있었습니다. 대표적으로 워커 크래시 5건에서 Jev의 확률은 0.39~0.43이었습니다. 또한 일부러 만든 함정 장애에서도 오판이 발생했습니다.
"프로세스 종료 (작업이 문제)"와 "프로세스 종료 (작업은 정상)"은 로그를 완전히 동일하게 만들었습니다. 이 경우 로그만으로는 실제 원인을 구분할 수 없습니다. 규칙은 6건 모두 재시도로 넘겼습니다. 반면 Jev는 이 중 3건에 매우 낮은 확률을 반환해 재시도를 막았습니다. 하지만 나머지 3건은 잘못 재시도로 판단했습니다.
따라서 Jev 역시 판정 모델일 뿐, 정답을 보장하는 시스템은 아니었습니다. 이 결과 때문에 최종 구성에서도 Jev의 문턱값을 무작정 낮추지는 않았습니다. 문턱을 낮추면 놓치는 장애는 줄어들지만 잘못된 재시도가 늘어나기 때문입니다.
9. 결국 Jev는 어디에서 유용했을까?
이번 실험 결과를 판단 근거에 따라 나눠보면 역할이 명확해집니다.
① 시스템 상태로 확실하게 판단할 수 있다
→ 코드로 처리합니다.
예를 들어 같은 DAG Run의 다른 작업이 아직 실행 중인지, 파일을 생성하는 작업이 끝났는지와 같은 정보입니다. 이런 정보는 DB나 시스템 API를 통해 직접 확인할 수 있습니다. 굳이 Jev에게 판단을 맡길 이유가 없습니다.
② 로그에 충분한 맥락이 있지만 규칙으로 구분하기 어렵다
→ Jev를 사용해볼 수 있습니다.
exit 137처럼 동일한 종료 코드가 서로 다른 상황에서 발생하거나, 프로세스가 어떤 맥락에서 종료됐는지를 로그 전체를 보고 판단해야 하는 경우입니다. 이런 상황에서는 단순한 문자열 매칭보다 로그의 여러 정보를 함께 보는 방식이 유리했습니다.
③ 로그에도 판단 근거가 부족하다
→ 사람에게 전달합니다.
자동화 시스템이 모든 장애를 맞힐 수는 없습니다. 판단할 정보 자체가 없다면 Jev에게 억지로 결정을 맡기는 것보다 사람이 확인하는 편이 낫습니다.
10. 최종 결과
최종 구성에서 나온 결과를 정리하면 다음과 같습니다.
| 지표 | 결과 |
|---|---|
| 재시도로 해결되는 장애 중 자동으로 찾아낸 비율 | 105 / 116 = 90.5% |
| 재시도로 넘긴 장애 중 실제로 해결된 비율 | 105 / 113 = 92.9% |
| 전체 판정 정확도 | 499 / 518 = 96.3% |
| 재시도가 남아 있던 판정의 정확도 | 365 / 384 = 95.1% |
518건 중 134건은 이미 재시도를 모두 사용한 상태였습니다. 이 경우 자동으로 선택할 수 있는 것은 사실상 "사람이 확인한다"뿐이므로, 실질적인 자동 재시도 판단 대상은 384건이었습니다. 이를 기준으로 보면 정확도는 95.1% 였습니다.
다만 이 숫자만 보고 Jev의 성능이라고 해석해서는 안 됩니다. 최종 시스템은 시스템 상태 확인 + 규칙 + Jev가 결합된 구조이기 때문입니다. 오히려 이번 실험에서 확인한 중요한 점은 Jev 단독의 성능과 Jev가 시스템의 일부로 들어갔을 때의 역할이 달랐다는 것입니다. Jev 단독으로는 재시도로 해결되는 116건 중 27건만 찾아냈습니다. 반면 DB 조회와 규칙을 먼저 적용한 뒤 Jev를 추가하자 105건까지 찾아낼 수 있었습니다.
즉, Jev가 혼자서 장애를 판단하는 것보다 기존 시스템이 확실하게 판단할 수 있는 영역을 먼저 처리하고, 남은 애매한 영역을 Jev가 보완하는 구조가 더 적합했습니다.
11. 그래서 Jev는 유용한가?
이번 실험의 처음 질문은 간단했습니다.
"Jev를 Airflow 장애 대응에 붙이면 실제로 도움이 될까?"
실험 결과를 보면 Jev만으로 장애를 자동으로 판단하는 것은 아직 어려웠습니다. 처음에는 Jev가 등장하면서 로그만 넣어주면 다양한 장애를 상당히 잘 분류해줄 것이라고 기대했습니다. 하지만 실제로 돌려보니 그렇지는 않았습니다.
이번 실험에서 Jev의 역할을 한 문장으로 정리하면 다음과 같습니다.
Jev는 장애 대응을 대신하는 도구가 아니라, 기존 규칙으로 판단하기 어려운 장애를 보완하는 도구였습니다.
구조도 결국 단순하게 정리할 수 있습니다.
Airflow 장애 발생
      ↓
재시도 가능 횟수 확인
      ↓
시스템 상태로 확실하게 판단할 수 있는가?
      ├─ Yes → 코드로 판단
      │
      └─ No
          ↓
로그에 판단할 만한 맥락이 있는가?
          ├─ Yes → Jev
          │
          └─ No → 사람에게 전달
이번 실험에서 Jev가 가장 잘한 것은 모든 장애를 맞힌 것이 아닙니다. 기존 규칙이 판단할 수 없었던 영역에서 추가적인 판단 근거를 제공한 것입니다. 그리고 실제 Jev의 활용 사례를 찾아보면서 한 가지 흥미로운 점도 확인했습니다. Jev는 단순히 장애 분류에만 사용하는 것이 아니라, 여러 모델 중 어떤 모델로 요청을 보낼지 결정하는 라우팅과 같은 문제에도 활용할 수 있습니다.
예를 들어 사용자의 질문을 바로 특정 LLM에 보내는 것이 아니라,
사용자 질문
     ↓
    Jev
     ↓
어떤 모델로 보낼까?
 ┌──────┼──────┐
 ↓           ↓          ↓
Haiku       Opus      Fable
처럼 먼저 질문의 성격을 판단하고 적절한 모델로 보내는 방식입니다. 이 문제는 이번 Airflow 실험과도 어느 정도 닮아 있습니다. Airflow에서는 "이 장애를 다시 실행할까?" 를 판단했다면, 모델 라우팅에서는 "이 질문을 어떤 모델로 보낼까?" 를 판단합니다. 둘 다 최종 행동 자체를 모델이 수행하는 것이 아니라, 다음 행동을 선택하기 위한 판단을 별도의 모델에게 맡기는 구조입니다.
12. 마무리
이번에는 Airflow 장애를 대상으로 Jev를 검증했습니다. 처음 기대했던 것처럼 Jev 하나가 모든 장애를 알아서 분류해주는 결과는 아니었습니다. 하지만 실제 장애 518건을 돌려보면서, 어떤 판단은 코드가 담당하고 어떤 판단은 Jev에게 맡기는 것이 적절한지 직접 확인할 수 있었습니다.
결국 이번 실험에서 확인한 Jev의 가치는 모든 장애를 맞히는 데 있지 않았습니다. 기존 규칙으로 판단하기 어려웠던 영역에 하나의 판단 단계를 추가하고, 사람이 직접 로그를 확인해야 했던 일부 영역을 자동화할 수 있었다는 점에 있었습니다.
무엇보다 Jev 자체가 아직 초기 모델이기 때문에, 이번 결과를 최종적인 성능으로 보기보다는 실제 운영 문제에 적용했을 때 어떤 부분에서 가능성이 있고 어떤 한계가 있는지를 확인한 실험으로 보는 것이 맞다고 생각합니다. 앞으로 모델 자체가 발전하고, 더 다양한 장애와 운영 환경에서 검증이 쌓인다면 지금은 사람이 확인해야 하는 영역도 점차 자동화할 수 있을 것입니다.
이번 실험을 통해 확인하고 싶었던 것도 바로 그 지점이었습니다. Jev가 모든 장애를 해결할 수 있는가 보다, 장애 대응 과정에서 기존 자동화만으로 다루기 어려운 판단을 맡길 수 있는가. 이번 실험에서는 그 가능성을 확인할 수 있었습니다.
앞으로의 Jev 발전이 기대가 됩니다.