
Spark 가 작업을 배분하는 과정과 결과

Spark 잡에서 태스크 하나가 안 끝나고 몇 시간을 잡아먹는 일이 있습니다. 그럴 때 늘 걸리는 것이 하나 있었습니다. 노드가 다섯 대고 코어가 스무 개인데, 왜 나머지 열아홉 개가 그 하나를 못 도와주는가. 답은 Spark 가 일을 나누는 방식에 있습니다. 키가 파티션이 되고, 파티션이 태스크가 되고, 태스크가 코어에 올라갑니다. 이 순서를 따라가 보면 쏠림이 어느 단계에서 결정되고 왜 뒤에서 못 되돌리는지가 보입니다.
⚠️ 먼저 밝힐 것이 있습니다. 제가 직접 측정한 것은 단일 노드 실험입니다. 아래에서 클러스터가 어떻게 도는지 설명하는 부분은 잰 것이 아니라 Spark 의 스케줄링 모델입니다. 메모리와 파티션 쪽 숫자는 직접 잰 값이고, 그 자리마다 따로 밝혀뒀습니다.
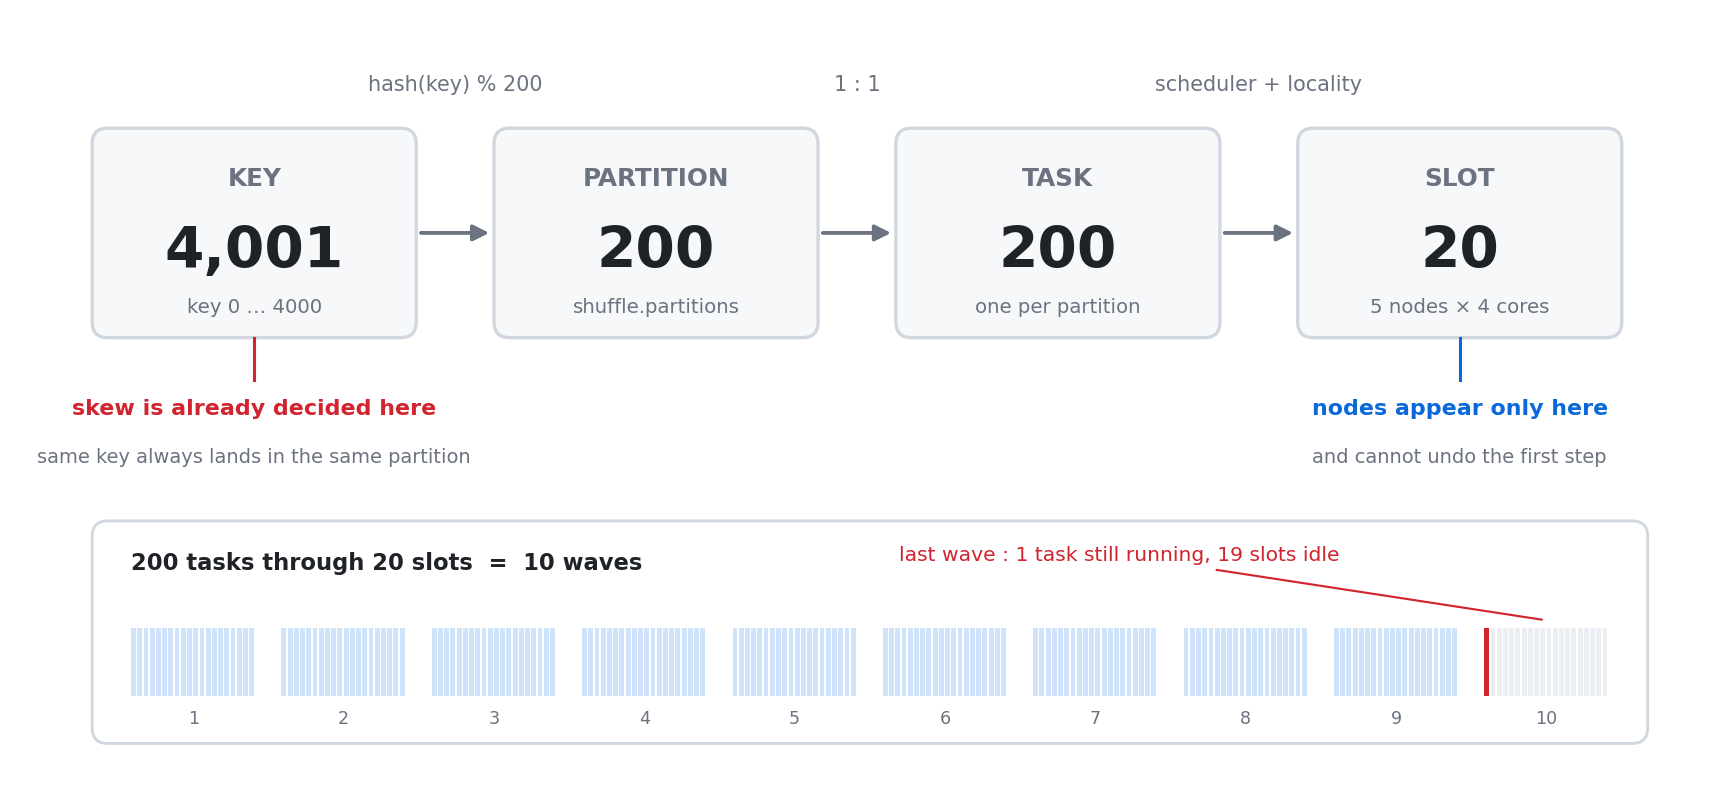
이 글에서 가정하는 환경
노드 5대, 노드마다 executor 1개, executor 당 core 4개
  → 동시에 돌릴 수 있는 태스크 = 5 × 4 = 20개

키는 0 ~ 4000, 모두 4,001개
spark.sql.shuffle.partitions = 200   (기본값)
executor memory = 1500m
1. 네 단계로 정해진다
1.1. 키를 파티션에 배정한다
셔플이 일어나는 연산에서 Spark 는 키의 해시로 갈 자리를 정합니다.
partition = pmod(murmur3(key, 42), 200)
키 4,001개가 200칸에 들어갑니다. 칸당 평균 20개입니다.
파티션 0   ← key 1523, 88, 3901, 447, ...  (약 20개)
파티션 1   ← key 12, 2044, 3376, ...
...
파티션 191 ← key 0, 1180, 2233, ...
...
파티션 199 ← key 777, 1024, ...
여기서 중요한 것 하나. 노드 수는 이 단계에 아무 역할도 하지 않습니다. 쓰는 숫자는 200 하나뿐입니다. 클러스터가 5대든 50대든 배정 결과는 똑같습니다. 그리고 같은 키는 반드시 같은 칸으로 갑니다. 이건 성능을 위한 선택이 아니라 정확성을 위한 조건입니다. 같은 키의 행이 흩어져 있으면 집계도 조인도 틀립니다.
이 글에서는 행이 유난히 몰린 키를 핫 키, 그 키가 들어간 칸을 핫 파티션이라 부릅니다. 나머지 평범한 키와 칸은 콜드 입니다. Spark 공식 용어는 아니고 "바쁜 쪽과 한가한 쪽" 을 가리키는 일반적인 말입니다. 캐시나 스토리지에서 트래픽이 한 구역에 쏠리는 것을 핫스팟이라 부르는 것과 같은 비유입니다.
두 성질을 붙여놓으면 결론이 하나 나옵니다. 한 키에 행이 몰려 있으면 그 몰림은 이 단계에서 이미 확정됩니다. 뒤에 나올 어떤 단계도 이걸 못 되돌립니다.
1.2. 파티션 하나가 태스크 하나가 된다
배정이 끝나면 파티션과 태스크는 일대일로 붙습니다.
파티션 200개 → 태스크 200개
노드가 5대든 50대든 태스크는 200개입니다. 코어를 늘려도 이 숫자는 안 변합니다. 바꾸려면 spark.sql.shuffle.partitions 를 바꿔야 합니다.
1.3. 태스크를 코어에 올린다
여기서 처음 노드가 등장합니다. 스케줄러가 비어 있는 코어에 태스크를 하나씩 올립니다.
슬롯 20개  ←  태스크 200개

1차 : 태스크 0 ~ 19     (20개 동시 실행)
2차 : 태스크 20 ~ 39
...
10차 : 태스크 180 ~ 199
태스크 200개를 슬롯 20개로 처리하니 10 웨이브가 됩니다. 노드를 10대로 늘리면 슬롯이 40개가 되고 5 웨이브가 됩니다. 다만 스케줄러가 아무 코어에나 던지지는 않습니다. 읽어야 할 데이터에 가까운 곳을 먼저 찾습니다. 가까운 순서대로 네 단계입니다.
| 단계 | 뜻 |
|---|---|
PROCESS_LOCAL |
필요한 데이터가 그 executor 의 메모리에 이미 있습니다 |
NODE_LOCAL |
같은 노드의 디스크나 다른 executor 에 있습니다 |
RACK_LOCAL |
같은 랙의 다른 노드에 있습니다 |
ANY |
아무 데나 |
가까운 자리가 지금 바빠도 곧 빌 수 있으니 조금 기다려 봅니다. 그 시간이 spark.locality.wait 이고 기본값은 3초입니다. 기다려도 안 비면 한 단계 멀리 내려갑니다. 이 값이 커지면 데이터를 덜 옮기는 대신 코어가 노는 시간이 늘고, 작으면 반대가 됩니다. 태스크가 아주 짧은 잡에서 이 기본값 3초가 오히려 손해가 되는 경우가 있습니다.
1.4. 한 노드 안에서도 동시에 돈다
executor 하나는 JVM 하나입니다. 그 안에서 코어 수만큼 스레드가 동시에 태스크를 돌립니다.
노드 A 의 executor (JVM 1개)
├─ 스레드 1 → 태스크 (파티션 17)
├─ 스레드 2 → 태스크 (파티션 42)
├─ 스레드 3 → 태스크 (파티션 108)
└─ 스레드 4 → 태스크 (파티션 191)   ← hot
여기서 메모리 이야기가 붙습니다. 이 네 스레드는 같은 JVM 의 같은 메모리 풀을 나눠 씁니다.
executor memory 1500m
  → 실행 메모리 풀 720 MiB
그러면 태스크 하나가 720 ÷ 4 = 180 MiB 만 쓰게 되는가. 직접 재본 답은 아니오였습니다. 다른 셋이 먼저 끝나면 남은 하나가 716 MiB 를 다 씁니다. Spark 의 1/2N ~ 1/N 은 최소한 이만큼은 보장한다는 하한이지, 이만큼만 준다는 상한이 아니기 때문입니다. 이 부분은 Spark Skew Deep Dive 에서 48번 측정한 내용입니다.
2. 그래서 쏠림이 터진다
2.1. 마지막 웨이브에 혼자 남는다
1차부터 9차까지는 스무 개씩 고르게 돌아갑니다. 문제는 마지막입니다.
1 ~ 9차 웨이브 : 태스크 180개가 순서대로 끝난다
10차 웨이브    : 파티션 191 하나만 몇 분째 돌고 있다

                 나머지 슬롯 19개 → 전부 놀고 있다
                 잡은 그 하나가 끝날 때까지 안 끝난다
노드 다섯 대에 코어 스무 개를 붙여놨는데 마지막에는 코어 하나짜리 잡이 됩니다. 모니터링에서 클러스터 CPU 가 낮게 나오는 이유가 이것입니다. 실제로 노는 코어가 열아홉 개입니다.
2.2. 코어를 더 붙여도 안 나눠진다
그러면 코어를 늘리면 되는가. 재봤더니 수익률이 떨어졌습니다.
| skew | 코어 6개의 속도 향상 |
|---|---|
| 8 | 4.23배 |
| 32 | 3.23배 |
같은 코어를 붙였는데 쏠림이 심할수록 덜 빨라집니다. 코어가 늘어도 hot 파티션 하나는 여전히 코어 하나가 처리하기 때문입니다. 나머지 199개만 빨리 끝나고 마지막에 혼자 남는 시간은 그대로입니다.
2.3. 파티션 수를 늘려도 안 된다
쏠림을 만나면 제일 먼저 spark.sql.shuffle.partitions 를 올립니다. 이것도 재봤습니다.
| partitions | hot 파티션 크기 |
|---|---|
| 200 | 525.9 MiB |
| 800 | 513.9 MiB |
| 2000 | 512.0 MiB |
파티션을 열 배로 늘렸는데 hot 파티션은 2.6% 줄었습니다. 1.1로 돌아가면 이유가 분명합니다. 키 하나에 몰린 행은 칸을 2000개로 늘려도 여전히 한 칸입니다. 줄어든 2.6% 는 그 키 말고 같은 칸에 얹혀 있던 다른 키들이 흩어져서 생긴 것입니다. 정작 범인은 그대로입니다.
3. 셔플에서 실제로 오가는 것
파티션 배정은 map 쪽에서 일어납니다. map 태스크 하나가 자기가 읽은 행을 200개 칸으로 나눠 씁니다.
map 태스크 M개 × reduce 파티션 200개 = M × 200 개의 조각

reduce 191번은 그중 자기 몫 M개를 모아온다
reduce 태스크 하나가 모든 map 태스크로부터 조각을 하나씩 가져옵니다. 노드가 여러 대면 이게 네트워크 전송입니다. 여기서 파티션 수를 늘릴 때의 대가가 보입니다. 조각 수가 M × P 로 늘어납니다. 2.3에서 파티션을 2000으로 올리면 조각이 열 배가 되고, 조각 하나하나가 작아지면서 요청 수와 메타데이터가 같이 늡니다. 쏠림은 안 풀리는데 셔플만 잘게 부서집니다.
제 실험은 단일 노드였으므로 이 조각들이 전부 로컬 디스크를 오갔습니다. 여러 노드에 걸친 전송은 재본 적이 없습니다.
4. 런타임에 바뀌는 것
지금까지는 계획 단계 이야기입니다. Spark 3부터는 셔플이 끝난 뒤의 실제 통계를 보고 계획을 고치는 AQE 가 있습니다.
| 하는 일 | 내용 |
|---|---|
| 파티션 합치기 | 작은 파티션들을 묶어 태스크 수를 줄입니다 |
| skew join 쪼개기 | 큰 파티션을 여러 태스크로 나눕니다 |
| 조인 전략 교체 | 통계를 보고 broadcast 로 바꿉니다 |
2.3에서 안 되던 일을 AQE 는 합니다. 파티션 수를 늘리는 것과 달리, AQE 의 skew join 은 같은 키의 행을 여러 태스크로 나눠 처리합니다. 한쪽 테이블의 해당 파티션을 복제해서 맞춰주는 방식입니다.
그래서 쏠림의 실질적인 해법에 가장 가깝습니다. 다만 판정 조건이 둘이고 둘 다 넘어야 합니다.
size > skewedPartitionThresholdInBytes   // 기본 256MB
  && size > median * skewedPartitionFactor  // 기본 5배
그리고 조건이 전부 바이트 기준입니다. 행 수는 보지 않습니다. 바이트로는 평범한데 행 수만 몰린 파티션은 AQE 의 눈에 안 보입니다. 여섯 번 만들어 여섯 번 다 감지되지 않는 것을 Spark Skew Deep Dive 에서 확인했습니다.
5. 정리
네 단계를 한 줄로 늘어놓으면 이렇습니다.
| 단계 | 무엇이 정하나 | 노드가 관여하나 |
|---|---|---|
| 키 → 파티션 | 키의 해시와 파티션 수 | 아니오 |
| 파티션 → 태스크 | 일대일 | 아니오 |
| 태스크 → 코어 | 스케줄러와 지역성 | 예 |
| 코어 안에서 | executor 의 스레드와 메모리 풀 | 예 |
노드는 세 번째 단계에서 처음 등장합니다. 그런데 쏠림은 첫 번째 단계에서 이미 결정됩니다. 뒤의 어떤 단계로도 앞 단계의 결정을 되돌릴 수 없다는 것이 이 글의 요지입니다. 코어를 늘리는 것도, 노드를 늘리는 것도, 파티션 수를 올리는 것도 전부 세 번째와 네 번째 단계를 건드립니다. 첫 번째 단계에서 생긴 덩어리에는 닿지 않습니다.
같은 이유로 speculative execution 도 여기서는 안 듣습니다. 느린 태스크를 다른 코어에서 한 번 더 돌리는 기능인데, 쏠림은 그 태스크가 실제로 할 일이 많아서 느린 것입니다. 다른 데서 돌려도 할 일의 양은 같습니다. 하드웨어가 느려서 생긴 지각에는 듣고, 데이터가 몰려서 생긴 지각에는 안 듣습니다.
그래서 손을 대야 하는 곳은 첫 번째 단계입니다. 키를 바꾸거나(솔팅), 문제의 키만 따로 빼거나, AQE 가 쪼개게 만들거나. 어느 쪽이든 파티션이 만들어지는 순간에 개입해야 합니다.
6. 참고문헌
📑 1. Spark - Performance Tuning : Adaptive Query Execution
📑 2. Spark - Configuration : Scheduling
📑 4. Spark - Tuning : Data Locality