

Apache Iceberg Flink에 추가된 Table Maintenance, Docs는 왜 없었을까?
- Apache Iceberg
- Apache Flink
1. 서론
올해 초 Apache Iceberg의 Flink 모듈에서 JUnit4 의존성을 걷어내는 작업으로 Iceberg에 첫 코드 기여를 했습니다. 이후 Flink 1.19와 1.20으로의 백포팅까지 마무리했고, 그 과정은 Apache Iceberg 오픈소스 기여 경험기에 정리했습니다. 한 번 기여를 마치고 나니 자연스럽게 다음 이슈를 찾아보게 됐습니다.
그런데 이번에 눈에 들어온 건 코드가 아니라 문서(Docs)였습니다. 처음에는 조금 망설였습니다. 이미 코드 기여를 한 번 했는데 다시 문서로 돌아가는 것이 괜히 뒷걸음질하는 것처럼 느껴졌습니다. 첫 오픈소스 기여였던 Spring Kafka에서도 문서 정정이 큰 비중을 차지했기 때문에, 이번에는 조금 더 어려운 것을 해보고 싶다는 생각도 있었습니다.
그런데 이슈를 자세히 살펴보면서 생각이 바뀌었습니다. 기능은 이미 들어가 있는데 그 기능을 어떻게 사용하는지 설명하는 문서가 없었습니다. 문서를 쓰려면 API 표면을 전체적으로 읽어야 했고, 설정의 기본값도 구현체에서 하나씩 확인해야 했습니다. 무엇을 설명할지뿐만 아니라, 처음 보는 사람이 어떤 순서로 읽어야 이해할 수 있을지도 정해야 했습니다.
코드 한 줄을 고치는 것보다 오히려 프로젝트를 더 넓게 읽어야 하는 작업이었습니다. 결과적으로 이 문서 하나를 머지시키는 데 약 두 달이 걸렸고, PR을 세 번 열었습니다. 첫 두 PR은 머지되지 못하고 닫혔고, 세 번째 PR이 2025년 8월 25일에 머지됐습니다. 세 PR을 합쳐 리뷰 코멘트는 97개였습니다.
이 글은 그 두 달 동안 문서를 만들고, 고치고, 구조를 다시 바꿨던 기록입니다. 현재는 Apache Iceberg 공식 문서의 Flink Maintenance 페이지에서 그 결과를 확인할 수 있습니다.
2. 본론
2.1 이슈 : 기능은 있는데 문서가 없다
제가 맡은 이슈는 Add docs for Table Maintenance in Flink (#13307)입니다. Iceberg 커미터인 manuzhang 님이 올린 이슈였고, 내용은 아주 짧았습니다.
Flink Table Maintenance was added in #11144, but there's no doc on its usage yet. TestMaintenanceE2E is a good reference.
이슈 본문이 이렇게 짧다는 것은 두 가지 의미로 보였습니다. 하나는 무엇을 어디까지 써야 하는지가 정해져 있지 않다는 것이고, 다른 하나는 참고할 자료가 사실상 테스트 코드 하나뿐이라는 것입니다. 실제로 이슈에서 가리키는 TestMaintenanceE2E는 End-to-End 동작을 확인하는 테스트라 전체 흐름은 보여줍니다.
하지만 각 설정이 무엇을 의미하는지, 기본값은 무엇인지, 어떤 설정을 함께 사용해야 하는지는 알려주지 않습니다. 그래서 이 이슈는 단순히 "문서를 작성해주세요"라기보다 "문서의 구조부터 만들어주세요"에 가까웠습니다.
2.2 Table Maintenance : 기능의 배경
문서를 쓰려면 먼저 이 기능이 왜 필요한지 이해해야 했습니다. Iceberg 테이블에 Flink Streaming으로 계속 데이터를 적재하면 시간이 지나면서 두 가지가 쌓입니다. 하나는 작은 파일입니다. 체크포인트마다 커밋이 일어나면서 파일이 잘게 나뉘어 쌓입니다. 시간이 지나면 실제 데이터를 읽는 것보다 많은 파일을 열고 처리하는 데 더 많은 비용이 들어갈 수 있습니다.
다른 하나는 스냅샷입니다. 커밋이 발생할 때마다 스냅샷이 만들어지고, 이를 정리하지 않으면 메타데이터도 계속 늘어납니다. Iceberg에는 원래 이런 문제를 해결하기 위한 유지보수 작업이 있었습니다. 문제는 이 작업을 Spark로 수행해야 했다는 것이었습니다.
데이터 적재는 Flink로 하고 있는데, 테이블을 정리하기 위해 유지보수 작업만을 위한 Spark 클러스터를 별도로 운영해야 하는 상황이 생기는 것입니다. 스트리밍 파이프라인 하나를 운영하면서 다른 엔진까지 유지해야 하니 구조가 복잡해지고 운영 비용도 늘어날 수 있습니다. TableMaintenance API는 바로 이 부분을 해결하기 위해 만들어졌습니다.
Flink 잡이 직접 Iceberg 테이블의 유지보수 작업을 수행할 수 있도록 하는 것입니다. 기존 Flink 스트리밍 파이프라인에 붙일 수도 있고, 독립적인 Flink 잡으로 실행할 수도 있습니다. 결국 핵심은 별도의 Spark 클러스터 없이 Flink 안에서 테이블 유지보수를 수행할 수 있다는 점입니다.
이 배경을 이해하고 나니 문서의 첫 부분에서 무엇을 설명해야 할지도 자연스럽게 정리됐습니다. API 사용법부터 나열하기보다 왜 이 기능이 필요한지부터 설명해야 한다는 것이었습니다. 최종 문서의 Overview가 Spark 의존성 이야기로 시작하는 이유도 이 때문입니다.
2.3 문서 구성 : 무엇을 설명할 것인가
참고할 만한 자료가 테스트 코드 하나뿐이었기 때문에 결국 구현체를 직접 읽어야 했습니다. flink/v2.0/flink/src/main/java/org/apache/iceberg/flink/maintenance/api/ 아래를 하나씩 살펴보면서 공개된 API를 정리했습니다. 그렇게 정리한 내용은 크게 네 가지였습니다.
-
어떤 유지보수 작업을 할 수 있는가
ExpireSnapshotsRewriteDataFiles
-
언제 실행할 것인가
- 커밋 수
- 데이터 파일 수
- 파일 크기
- 시간 간격
- 기타 스케줄링 조건
-
동시 실행을 어떻게 막는가
TriggerLockFactory- JDBC Lock
- ZooKeeper Lock
-
어떻게 연결해서 사용하는가
- 독립 Flink 잡
IcebergSink뒤에 연결- Java API
- SQL
일단 여기까지 정리하고 첫 PR을 열었습니다.
2.4 첫 번째 PR (#13360) : 초안과 피드백
#13360은 2025년 6월 20일에 열었습니다.
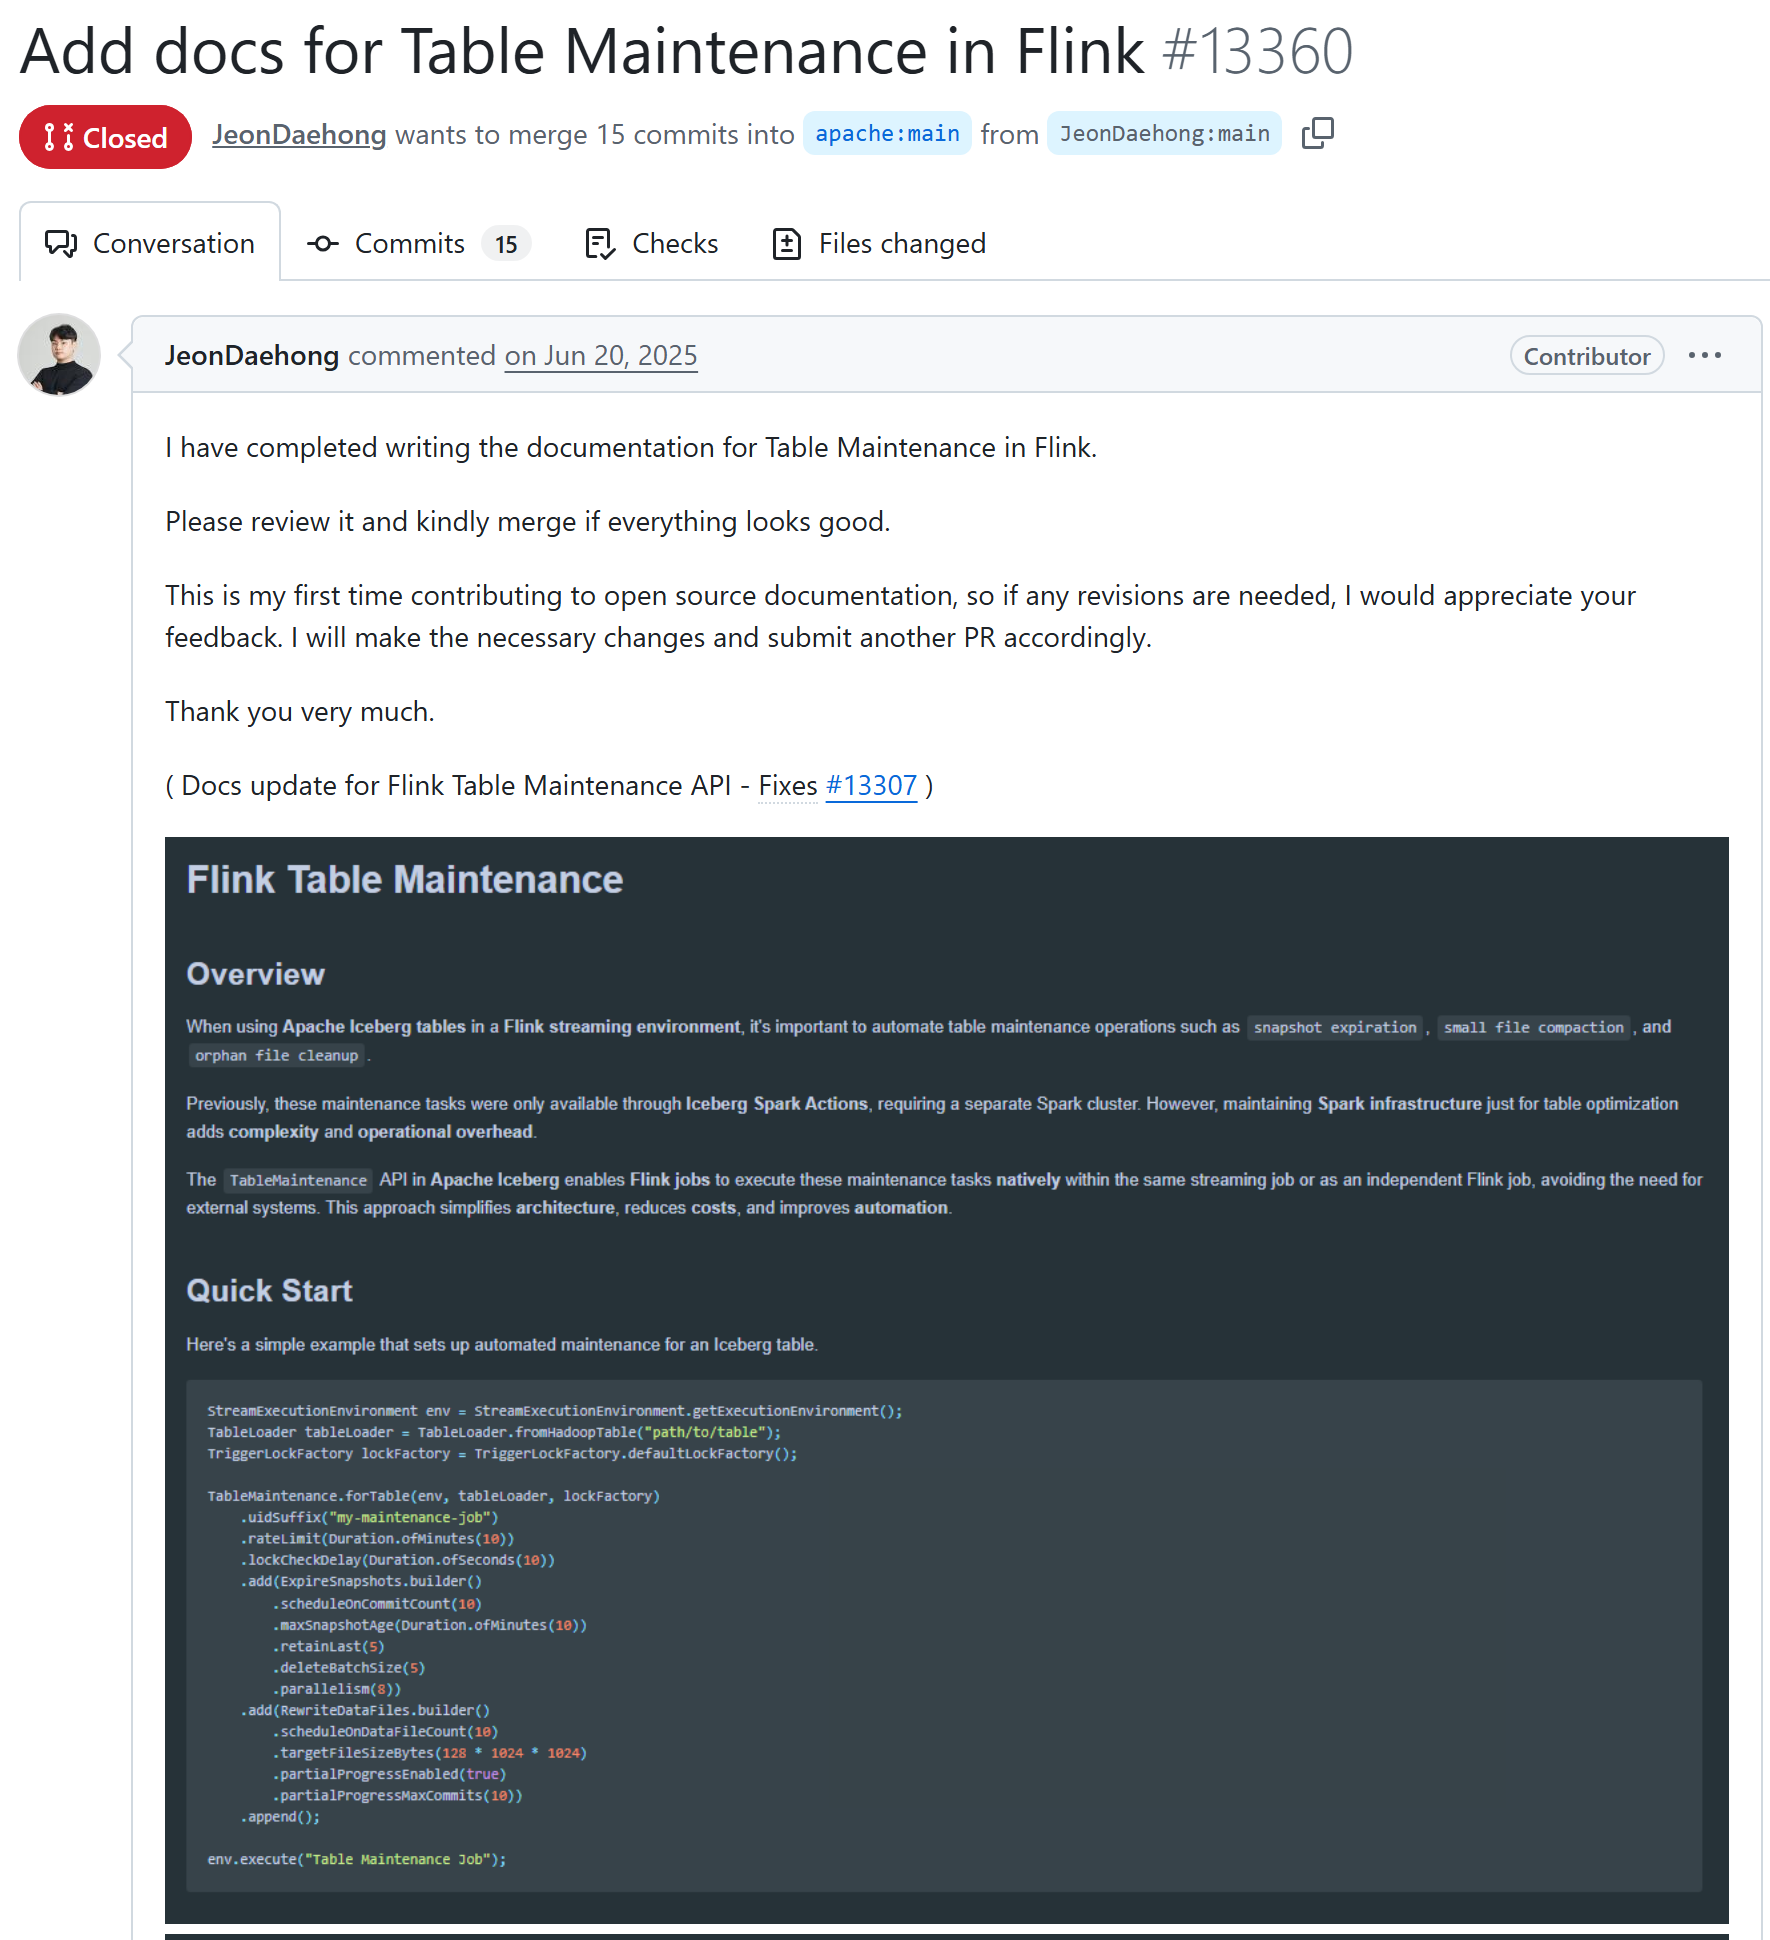
결과적으로 이 PR은 머지되지 못하고 8월 9일에 닫았습니다. 50일 동안 커밋을 15개 쌓았지만, 결국 기존 방향을 다시 잡아야 했습니다. 리뷰어는 Iceberg 커미터인 pvary 님과 Guosmilesmile 님이었고, 받은 지적은 크게 세 가지였습니다.
락의 필요성
I'm not sure that based on this doc, the average user will know what is this lock, and why it is needed
저는 TriggerLockFactory를 어떻게 만들어서 넣는지만 적어두었습니다. 코드를 직접 읽은 저에게는 락이 왜 필요한지가 너무 당연해서 설명할 필요성을 느끼지 못했던 것 같습니다. 하지만 처음 문서를 보는 사용자 입장에서는 정체를 알 수 없는 필수 인자 하나가 갑자기 등장한 것과 다르지 않았습니다.
설정 항목의 누락
Are there some configurations that we haven't listed, like
minInputFiles,rewriteAll,maxFileGroupSizeBytes, and so on?
제가 만든 표는 예제를 작성하면서 확인한 설정을 중심으로 구성되어 있었습니다. 즉 사용자가 알아야 할 전체 목록이라기보다 제가 알고 있던 목록에 가까웠습니다.
대표 예제의 기본 설정
I would turn this off in the main example. This becomes interesting if the table is big, and otherwise it add too many small commits
대표 예제에서 partialProgressEnabled를 켜두었습니다. 하지만 이 옵션은 큰 테이블에서 특히 의미가 있고, 작은 테이블에서는 오히려 작은 커밋이 많이 발생할 수 있습니다. 대표 예제는 사용자가 그대로 복사해서 사용할 가능성이 높기 때문에 가장 무난한 설정을 보여줘야 한다는 지적이었습니다.
이 외에도 제가 잘못 이해하고 작성한 부분이 있었습니다.
Users neither need to nor can call the
addPostCommitTopologymethod. Compression in the sink is enabled through configuration.
사용자가 직접 호출할 수 없는 메서드를 사용법인 것처럼 문서에 적어둔 것입니다. 이 부분은 제가 잘못 이해했다고 답하고 문서에서 제거했습니다. 리뷰가 계속 쌓이면서 단순히 커밋을 추가하는 것만으로는 해결하기 어렵겠다는 생각이 들었습니다.
결국 PR을 닫고 피드백을 반영해 새 PR을 여는 것으로 방향을 바꿨습니다.
2.5 두 번째 PR (#13771) : 설정 항목의 재검토
#13771은 첫 PR을 닫은 지 30분 만에 열었습니다. 이번 PR에서 받은 핵심 리뷰는 약 20개였습니다. 대부분 설정 항목이 정확하게 정리되어 있는가에 대한 내용이었습니다.
특히 이런 지적들이 있었습니다.
Some configurations are still missing from the documentation :
minFileSizeBytes/maxFileSizeBytes/minInputFiles/deleteFileThreshold/rewriteAll/maxFileGroupSizeBytes/maxFilesToRewrite/filter
그리고 또 다른 설정도 빠져 있었습니다.
We are missing some configurations that have not been added, such as
planningWorkerPoolSizeandcleanExpiredMetadata.
첫 번째 PR에서도 설정이 부족하다는 지적을 받아 보완했는데도 여전히 이만큼이 빠져 있었습니다. 빌더 메서드를 눈으로 하나씩 훑으면서 정리했기 때문입니다. 그러다 보니 상속받은 메서드나 오버로드된 메서드를 계속 놓쳤습니다.
기본값에 대한 지적도 이어졌습니다.
Default value is 5 days ago
Defaults to
Integer.MAX_VALUE, which means this feature is not enabled by default.
Default is 107374182400(100GB).
구조에 대한 의견도 있었습니다.
Can we extract the common configurations belonging to the
MaintenanceTaskBuilder, instead of having them appear in each functional configuration separately?
스케줄링 옵션처럼 여러 작업에서 공통으로 사용하는 설정을 각 작업마다 반복해서 적어두었는데, 이를 공통 설정 섹션으로 분리하자는 제안이었습니다. 현재 문서의 Maintenance Task Common Options가 여기서 나왔습니다. 결국 이 PR도 8월 18일에 닫았습니다.
첫 번째 PR에서 방향을 다시 잡았다면, 두 번째 PR에서는 이 내용을 어떤 구조와 위치로 정리할지를 다시 결정해야 했습니다.
2.6 세 번째 PR (#13853) : 문서 구조의 재편
#13853은 두 번째 PR을 닫은 날 바로 열었습니다.
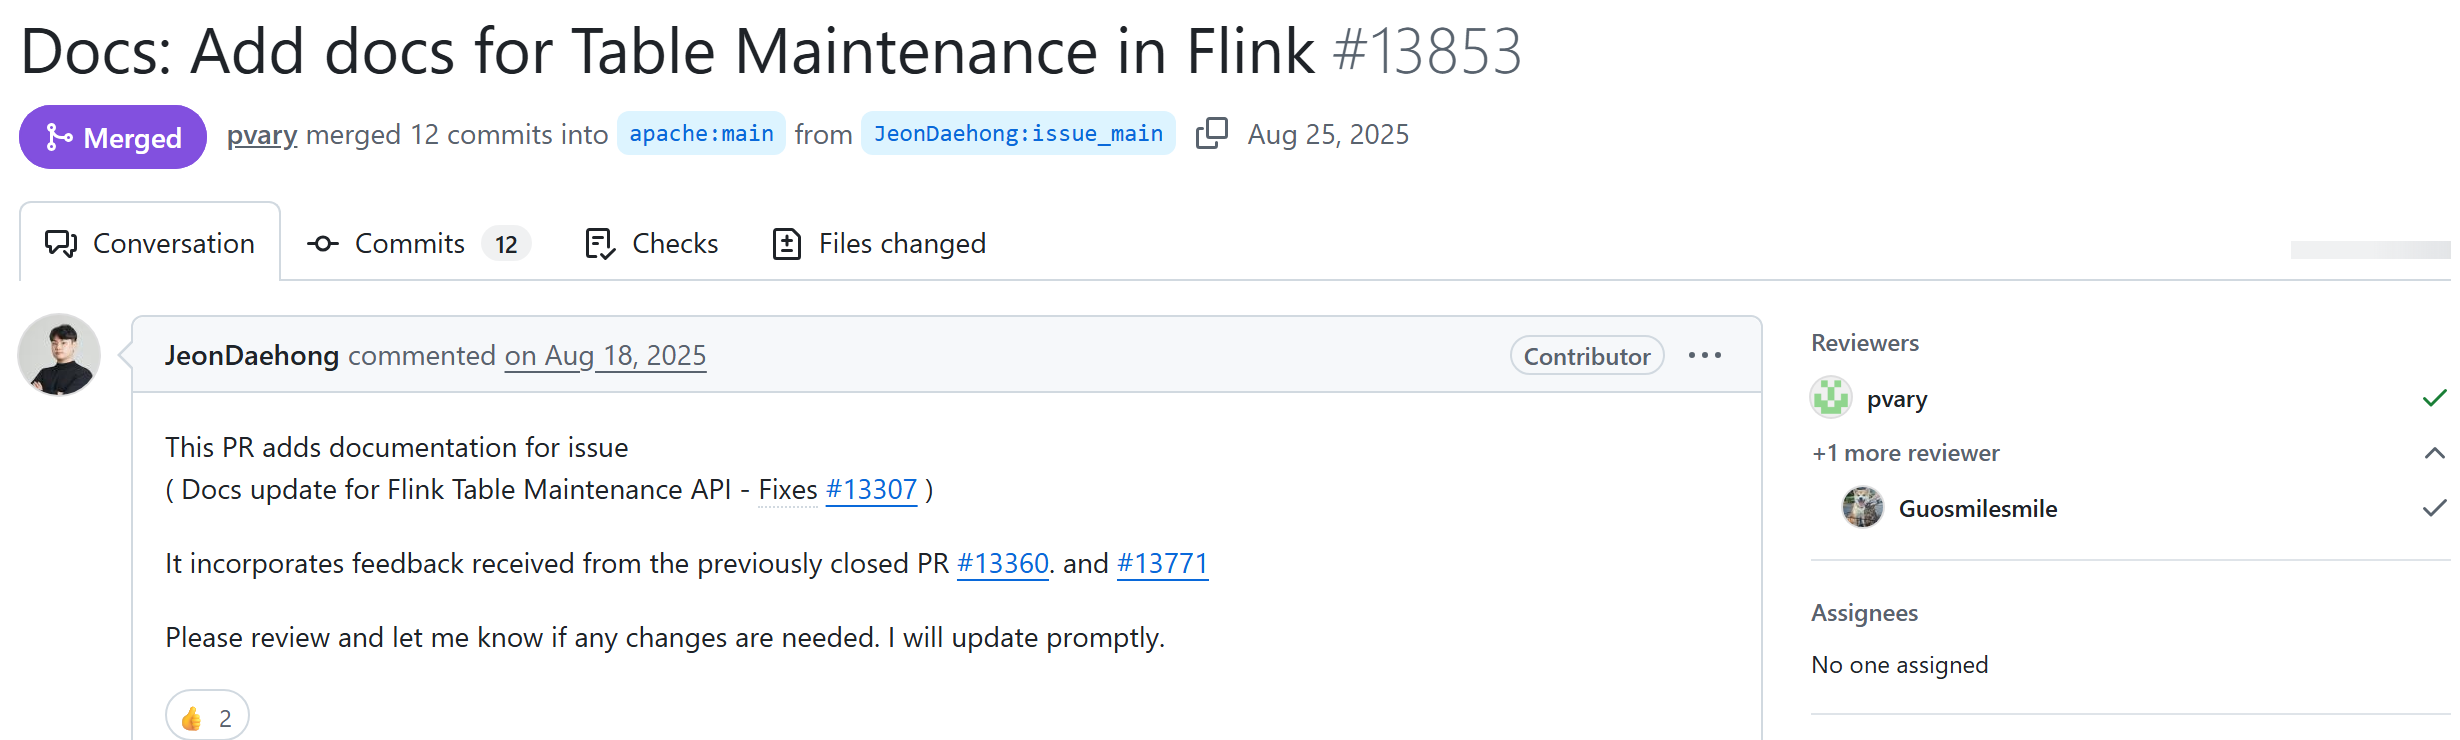
이번에는 내용보다 먼저 문서의 위치와 구조가 바뀌었습니다. 처음에는 flink-table-maintenance.md라는 새로운 페이지를 만들려고 했습니다. 그런데 리뷰 과정에서 기존의 flink-actions.md와 합치는 방향으로 정리되었습니다.
기존 flink-actions.md에는 배치 모드에서 파일을 재작성하는 Rewrite files action이 이미 설명되어 있었습니다. 즉 같은 유지보수라는 주제가 배치와 스트리밍으로 서로 다른 문서에 나뉘는 상황이었던 것입니다. 사용자 입장에서는 배치로 할 때는 한 문서를 보고, 스트리밍으로 할 때는 다른 문서를 봐야 합니다.
그래서 최종적으로 다음과 같이 정리했습니다.
- 기존
flink-actions.md의 내용을Flink Table Maintenance BatchMode아래로 이동 - 새로 작성한 스트리밍 내용을
Flink Table Maintenance StreamingMode아래에 배치 - 파일 이름을
flink-maintenance.md로 변경 mkdocs.yml의 내비게이션도 함께 수정
제목 레벨도 전체적으로 다시 조정했습니다. Guosmilesmile 님이 ### Overview, #### ExpireSnapshots처럼 바꿔야 할 제목 레벨을 하나씩 suggestion으로 남겨주셨고, 그대로 반영했습니다. 제목 레벨만 조정하는 데도 리뷰 코멘트가 스무 개 넘게 오갔습니다.
처음에는 "내용이 같은데 ###냐 ####냐가 그렇게 중요한가?" 싶었습니다. 그런데 실제로 문서를 렌더링해서 보니 이유를 알 수 있었습니다.
제목 레벨이 그대로 페이지의 목차 구조가 되기 때문입니다.
문서 구조가 조금만 어긋나도 배치 모드와 스트리밍 모드의 관계가 이상하게 보이거나, 락 설명이 특정 작업의 하위 항목처럼 보일 수 있습니다. Markdown 파일만 보고 있을 때는 잘 보이지 않는 문제였습니다.
2.7 권장 사용법과 실제 사용법
구조가 정리된 뒤에도 내용에 대한 리뷰는 계속됐습니다. 대표적인 것이 fromHadoopTable이었습니다.
fromHadoopTable-> Can we change this tohiveor something else? We would like to remove the references of the HadoopTable from the docs as it is not encouraged in production environments
제가 작성한 예제는 TableLoader.fromHadoopTable(...)로 시작하고 있었습니다. 테스트 코드를 참고해서 작성했기 때문에 자연스럽게 그렇게 사용했는데, HadoopTable은 운영 환경에서 권장되지 않는 방식이라 문서에서 제거하는 중이라는 설명이었습니다. 그래서 CatalogLoader.hive(...)를 사용하는 형태로 바꿨습니다.
이 지적이 특히 기억에 남았습니다. 문법적으로 틀린 코드도 아니고 실행되지 않는 코드도 아니었습니다. 그런데 공식 문서에서는 "실행되는 예제"와 "권장되는 예제"가 다를 수 있었습니다. 문서의 코드는 결국 프로젝트가 사용자에게 보여주는 권장 사용법이기 때문입니다.
그리고 2025년 8월 25일, 세 번째 PR이 머지되었습니다. 첫 PR을 열었던 6월 20일부터 66일째였습니다.
2.8 최종 문서 : 사용자를 기준으로 다시 구성하기
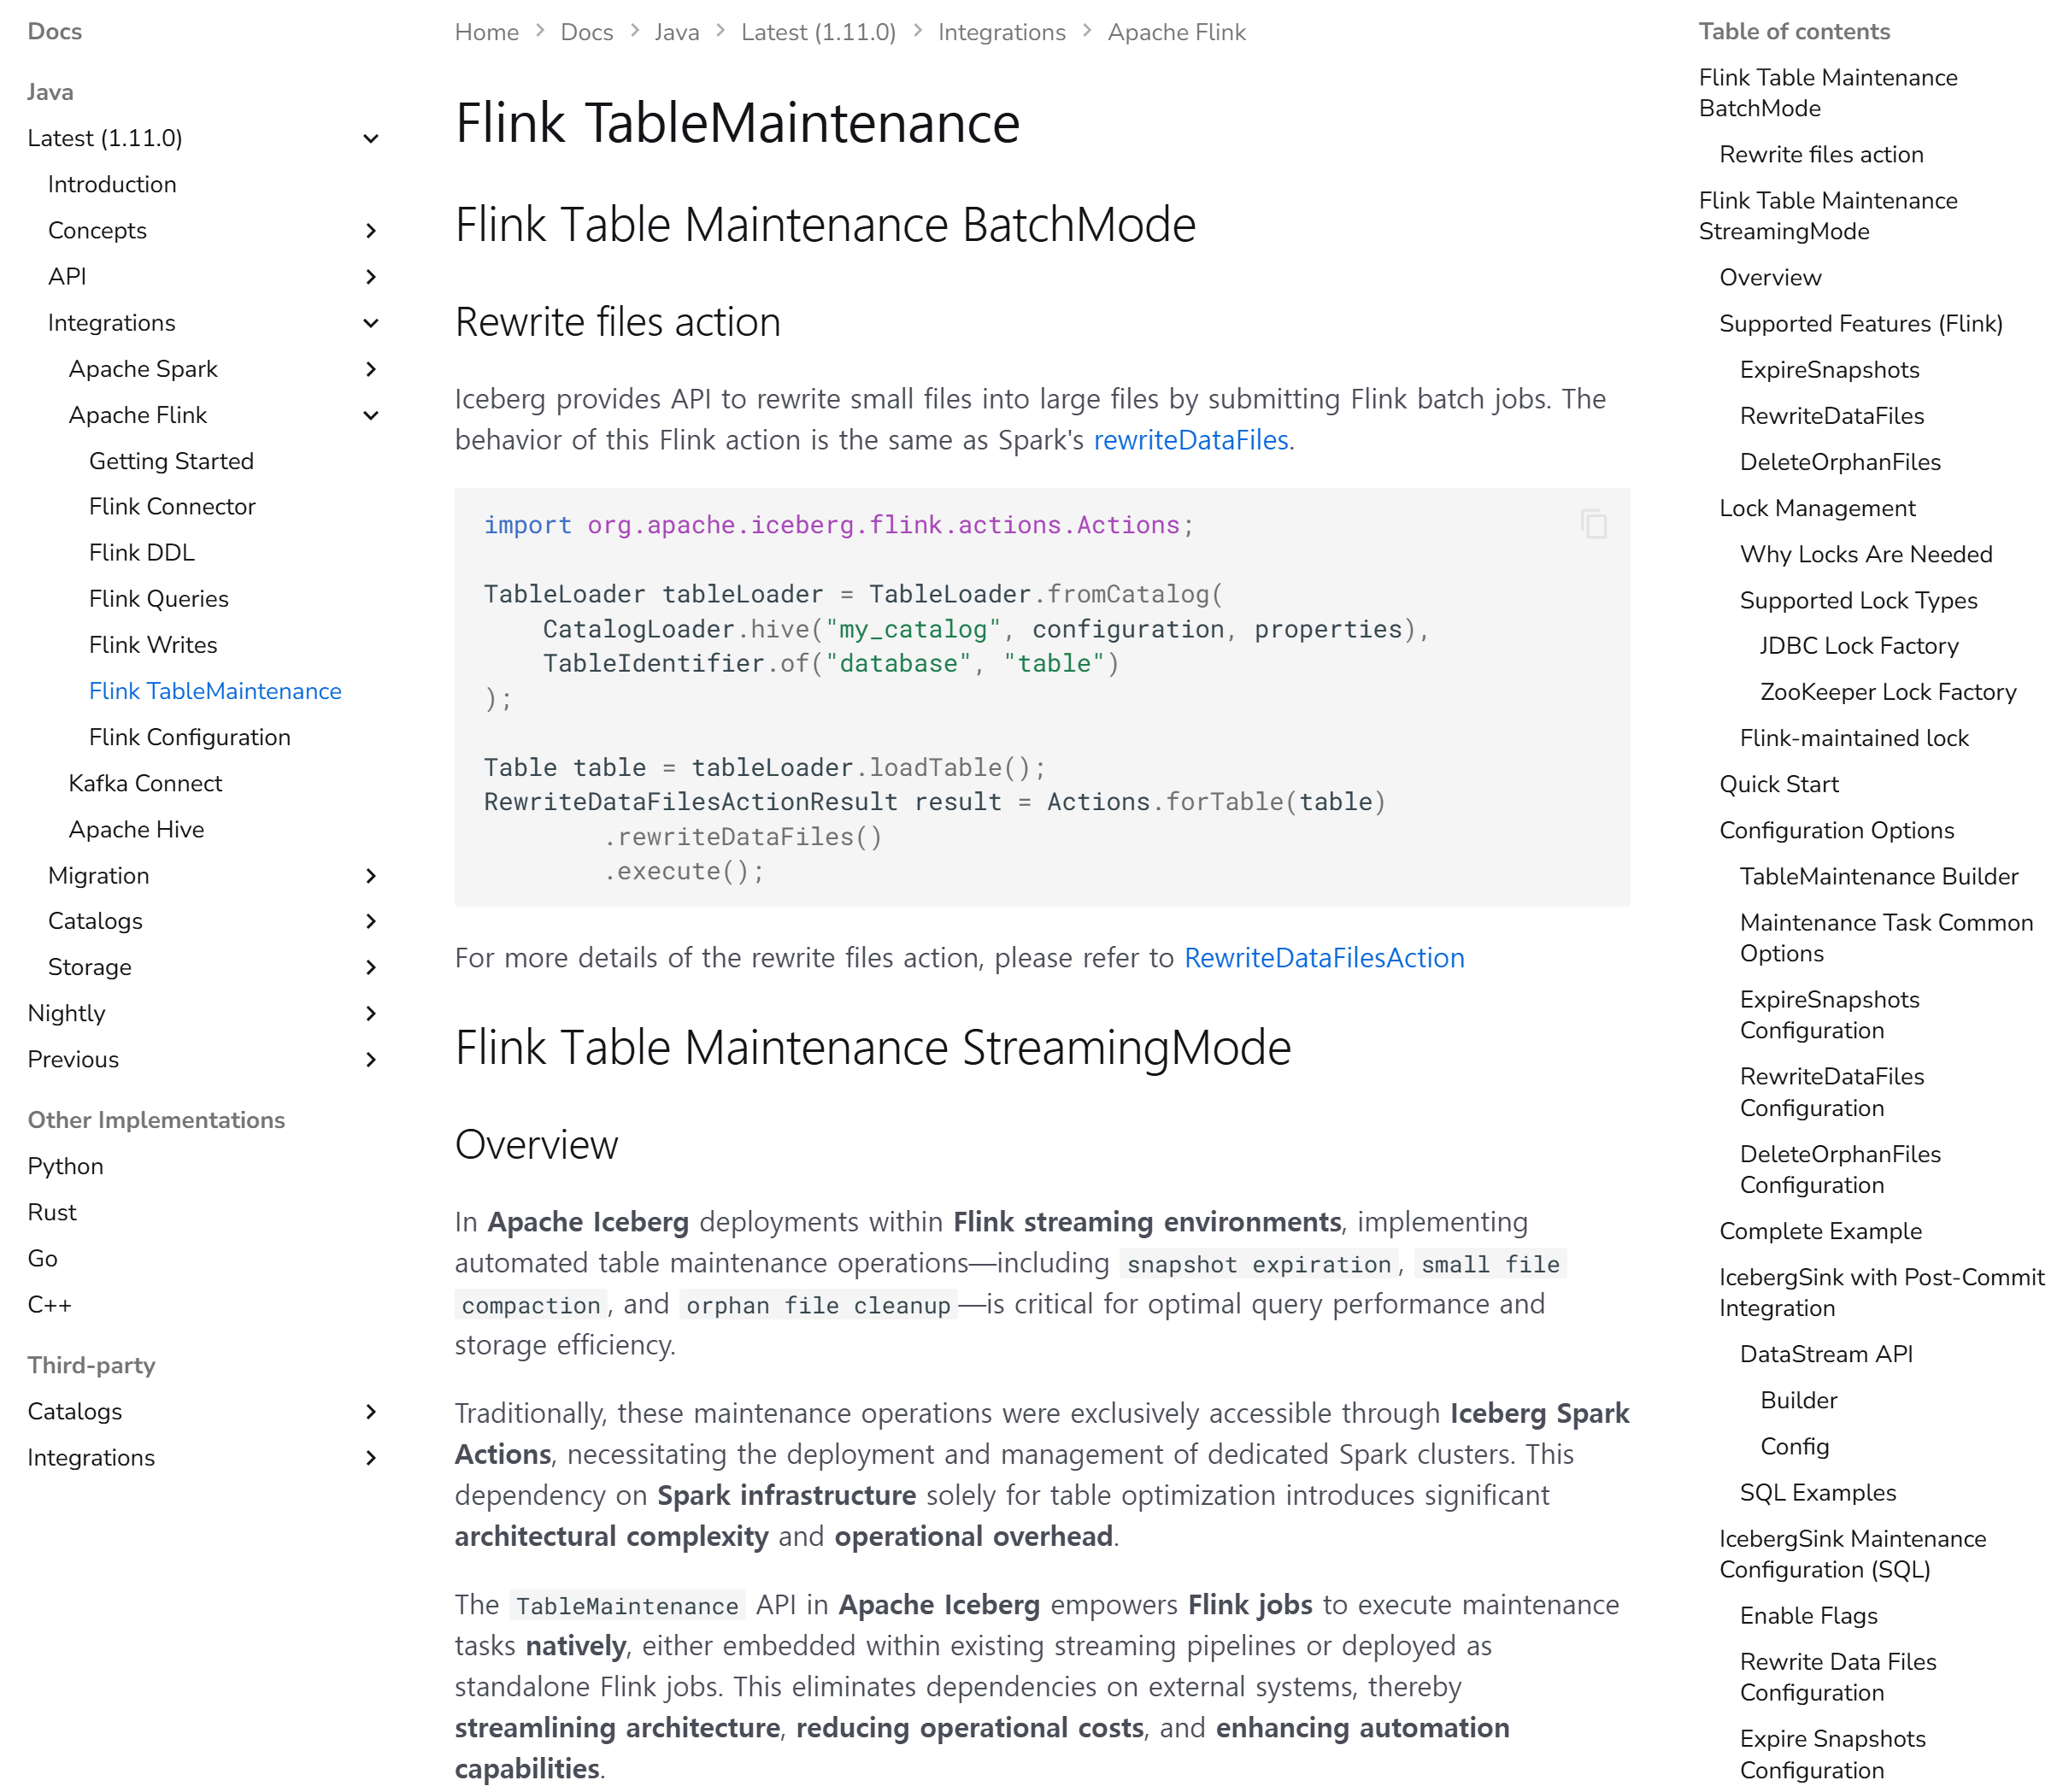
최종적으로 머지된 Flink Maintenance 문서는 다음과 같은 구조가 되었습니다.
-
Flink Table Maintenance BatchMode
- 기존
Rewrite files action
- 기존
-
Flink Table Maintenance StreamingMode
- Overview : Spark 의존성을 줄이기 위한 배경
- Supported Features :
ExpireSnapshots,RewriteDataFiles - Lock Management : 락이 필요한 이유와 JDBC · ZooKeeper 구현
- Quick Start : 가장 간단한 실행 예제
- Configuration Options : 공통 및 작업별 설정
- Complete Example : 전체 예제
- IcebergSink with Post-Commit Integration : DataStream API와 SQL
- Best Practices : 자원 관리, 스케줄링, 성능 튜닝
- Troubleshooting
이 중에서 개인적으로 가장 신경 쓴 부분은 Troubleshooting이었습니다. 설정 표는 구현체를 읽으면 어느 정도 채울 수 있습니다. 하지만 Troubleshooting은 실제로 어떤 상황에서 문제가 발생하고, 왜 발생하며, 어떻게 피할 수 있는지까지 이해해야 쓸 수 있기 때문입니다.
최종적으로 세 가지 상황을 정리했습니다.
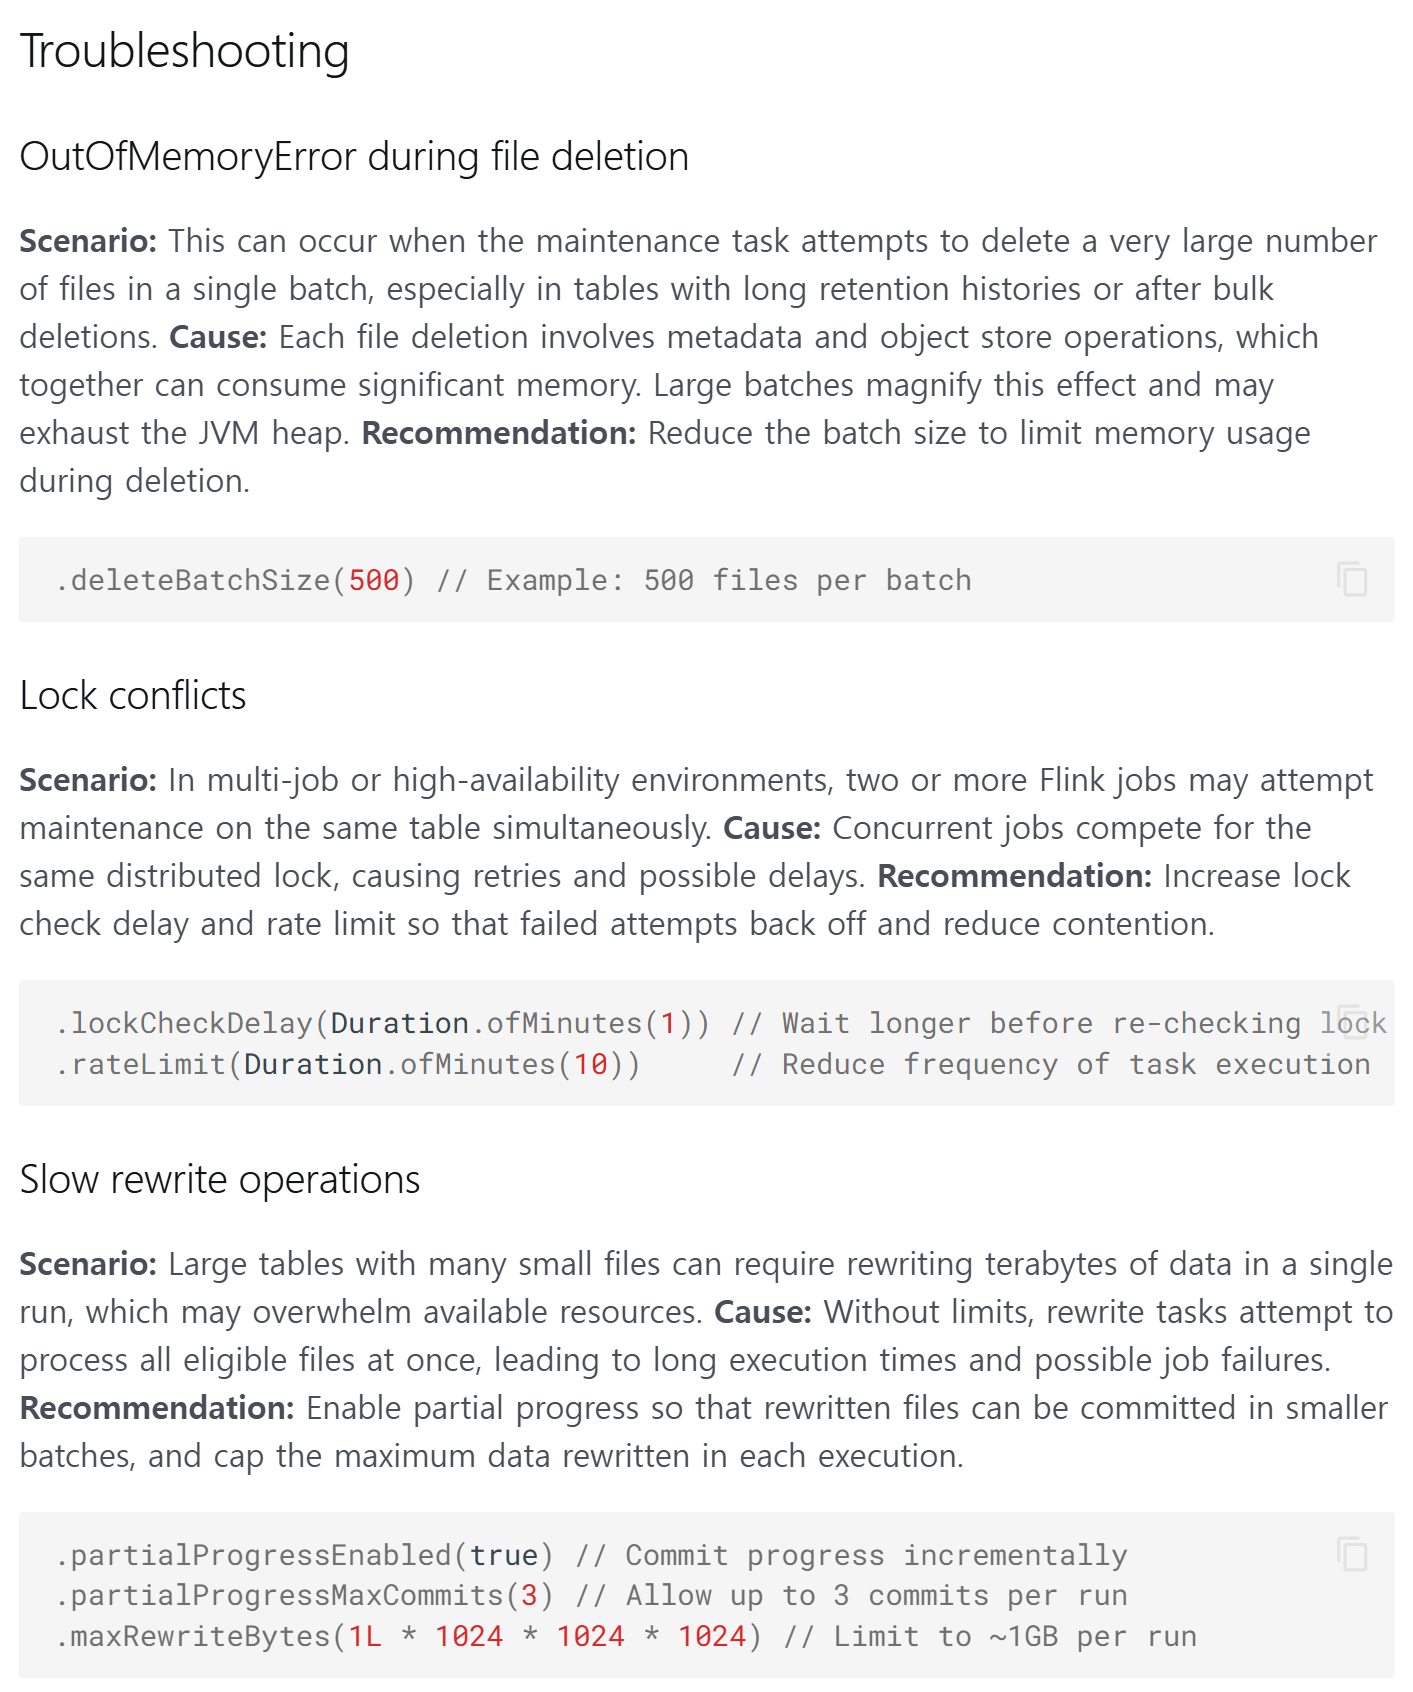
OutOfMemoryError during file deletion
한 번의 배치에서 너무 많은 파일을 삭제하려 할 때 발생할 수 있습니다. 파일 하나를 삭제하는 데도 메타데이터 연산과 오브젝트 스토리지 호출 등이 필요하기 때문에, 배치 크기가 지나치게 크면 메모리 사용량이 커질 수 있습니다.
.deleteBatchSize(500) // Example: 500 files per batch
Lock conflicts
여러 작업이 같은 테이블의 유지보수를 동시에 시도하면서 같은 분산 락을 두고 경쟁하는 상황입니다. 재시도가 반복되면 작업 지연도 같이 늘어날 수 있습니다.
.lockCheckDelay(Duration.ofMinutes(1)) // Wait longer before re-checking lock
.rateLimit(Duration.ofMinutes(10))     // Reduce frequency of task execution
Slow rewrite operations
작은 파일이 많이 쌓인 큰 테이블에서 한 번의 실행이 지나치게 많은 데이터를 재작성하려는 상황입니다. 대상 범위가 너무 크면 실행 시간이 길어지고 잡이 실패할 가능성도 높아집니다.
.partialProgressEnabled(true) // Commit progress incrementally
.partialProgressMaxCommits(3) // Allow up to 3 commits per run
.maxRewriteBytes(1L * 1024 * 1024 * 1024) // Limit to ~1GB per run
첫 번째 PR에서 대표 예제에 넣었다가 지적받았던 partialProgressEnabled가 여기서는 오히려 필요한 설정이 됐습니다. 작은 테이블에서는 불필요한 작은 커밋을 만들 수 있지만, 큰 테이블을 조금씩 나누어 처리해야 하는 상황에서는 유용합니다. 같은 옵션이라도 어떤 상황을 설명하는 문맥에 놓이느냐에 따라 의미가 달라질 수 있다는 것을 이 부분을 작성하면서 알게 됐습니다.
Best Practices에도 리뷰에서 나온 내용을 하나 추가했습니다.
Setting an appropriate
maxFileGroupSizeBytescan break down large FileGroups into smaller ones, thereby increasing the speed of parallel processing.
리뷰어가 문장까지 직접 제안해준 부분이었습니다. 이런 내용은 단순히 API를 읽는 것만으로는 알기 어렵습니다. 실제로 그 기능을 사용해본 사람이 어떤 부분을 신경 쓰는지가 문서에 들어오면서 내용도 조금씩 현실적으로 바뀌었습니다.
2.9 리뷰 과정에서 얻은 것
세 PR에 걸쳐 97개의 리뷰 코멘트를 받으면서 코드 기여와는 조금 다른 것을 배웠습니다.
구현체에서 확인하는 기본값
가장 많이 지적받은 부분 중 하나가 기본값이었습니다. 제가 틀렸거나 빠뜨렸던 값들을 정리하면 다음과 같습니다.
| 설정 | 실제 기본값 |
|---|---|
maxSnapshotAge |
5 days |
retainLast |
1 |
cleanExpiredMetadata |
false |
minFileSizeBytes |
target file size의 75% |
maxFileSizeBytes |
target file size의 180% |
minInputFiles |
5 |
deleteFileThreshold |
Integer.MAX_VALUE |
maxFileGroupSizeBytes |
107374182400 (100GB) |
maxFilesToRewrite |
null (전체 대상) |
filter |
Expressions.alwaysTrue() |
기본값은 기존 문서나 다른 블로그를 보고 작성하면 틀릴 가능성이 있습니다. 버전에 따라 값이 달라질 수도 있고, 상위 클래스에서 정의된 값을 하위 클래스가 덮어쓰는 경우도 있습니다. 결국 가장 확실한 방법은 해당 버전의 구현체를 직접 열어서 기본값을 확인하는 것이었습니다.
특히 minFileSizeBytes처럼 다른 설정값을 기준으로 계산되는 값은 더 주의해야 합니다. targetFileSizeBytes가 변경되면 함께 바뀌기 때문에 단순한 절대값으로 적으면 안 됩니다.
동작과 권장의 차이
fromHadoopTable 지적이 여기에 해당합니다. 실제로 동작하는 코드라도 프로젝트에서 권장하지 않는 방식이라면 공식 문서에 넣으면 안 됩니다. 공식 문서의 예제는 사실상 프로젝트의 권장 사용법처럼 받아들여지기 때문입니다.
사용자는 문서의 코드를 그대로 복사해서 시작할 가능성이 높습니다. 그래서 문서를 작성할 때는 "이 코드가 동작하는가?"뿐만 아니라 "현재 프로젝트에서 이 방식으로 사용하는 것이 권장되는가?"도 확인해야 했습니다.
"무엇"보다 "왜"를 먼저 설명하기
락에 대한 리뷰가 대표적이었습니다. 저는 처음에 TriggerLockFactory를 어떻게 만드는지만 설명했습니다. 하지만 왜 락이 필요한지는 설명하지 않았습니다. 최종 문서에서는 다음과 같은 이유를 설명했습니다.
-
Concurrent Access 여러 Flink 잡이 동시에 유지보수를 실행할 수 있습니다.
-
Data Consistency 같은 테이블에 대해 여러 유지보수 작업이 동시에 실행되는 것을 막습니다.
-
Resource Management 자원 충돌과 스케줄링 문제를 줄일 수 있습니다.
-
Avoid Duplicate Work 잡이 하나만 실행되고 있어도 같은 작업의 인스턴스가 여러 개 생길 수 있습니다.
특히 네 번째 내용은 pvary 님의 리뷰에서 알게 됐습니다.
The multiple instances of the same tasks could conflict even when only a single compaction job is running.
저는 처음에 락이 필요한 이유를 여러 잡 사이의 충돌 정도로만 생각했습니다. 하지만 실제로는 하나의 잡 안에서도 같은 작업이 중복 실행될 수 있기 때문에 락이 필요했습니다. 한 번 반영했던 설명이 커밋 과정에서 빠졌다가 다시 지적되기도 했습니다.
덕분에 마지막에는 이 부분을 꽤 명확하게 정리할 수 있었습니다.
문서 구조와 사용자 경험
제목 레벨에 리뷰가 스무 개 넘게 달린 것이 처음에는 조금 의아했습니다. 내용이 같은데 ###냐 ####냐가 그렇게 중요한가 싶었습니다. 그런데 MkDocs로 렌더링된 페이지를 확인해보니 이해가 됐습니다.
제목 레벨이 그대로 목차 구조가 되기 때문입니다.
배치 모드와 스트리밍 모드가 같은 수준에 있어야 하는데 하나가 다른 항목의 하위로 들어가면 문서 전체의 구조가 이상해집니다. Markdown 파일만 보고 있을 때는 잘 보이지 않았던 문제였습니다. 결국 문서는 텍스트 파일 하나가 아니라 사용자가 실제로 읽는 화면까지 포함해서 봐야 하는 작업이었습니다.
3. 결론
두 달 동안 PR 세 개와 리뷰 97개를 거치면서 가장 크게 달라진 건 문서 기여를 바라보는 방식이었습니다. 처음에는 문서를 코드보다 가벼운 기여라고 생각했습니다. 첫 오픈소스 기여도 문서 정정이었고, 그래서 이번에는 그보다 더 어려운 것을 해보고 싶다는 생각도 있었습니다.
그런데 직접 해보니 생각과 달랐습니다. 문서를 제대로 쓰려면 그 기능의 공개 API를 전체적으로 이해해야 했습니다. 코드 기여는 고쳐야 하는 한 지점을 깊게 파고들 수 있지만, 문서는 사용자가 마주할 여러 경로를 빠짐없이 살펴봐야 합니다.
설정 하나를 빠뜨리면 그 기능은 문서만 봐서는 존재하지 않는 것과 마찬가지가 됩니다. 그리고 문서 리뷰에서는 코드 리뷰와 다른 관점이 필요했습니다. 처음 보는 사람이 이 설명을 이해할 수 있는지, 예제를 그대로 복사해도 되는지, 제목 구조가 목차에서 제대로 보이는지, 이 설정을 어떤 상황에서 사용해야 하는지까지 확인해야 했습니다.
결국 리뷰어들은 문서 자체만 읽은 게 아니라 그 문서를 처음 보는 사용자의 입장에서 읽고 있었습니다. 또 하나 배운 것은 PR을 닫는 것도 작업의 일부라는 점입니다. 첫 PR을 50일이나 붙잡고 있다가 닫을 때는 솔직히 아쉬웠습니다.
하지만 지금 돌아보면 그동안 받은 피드백이 두 번째 PR의 뼈대가 됐고, 두 번째 PR에서 정리한 설정과 구조가 세 번째 PR에도 이어졌습니다. 방향 자체를 바꿔야 하는 상황에서는 기존 PR에 계속 커밋을 쌓는 것보다, 한 번 정리하고 새로 시작하는 편이 나을 때도 있다는 것을 배웠습니다. 마지막으로 이번 작업은 제가 기능을 만든 사람의 의도까지 따라가 봐야 했던 첫 기여였습니다.
TableMaintenance가 왜 락을 필요로 하는지, 왜 여러 스케줄링 조건을 제공하는지, 왜 특정 API를 권장하지 않는지를 이해하지 못하면 문서에 제대로 설명할 수 없었습니다. 결국 문서를 작성한다는 건 단순히 코드를 읽고 설명을 옮기는 일이 아니었습니다. 기능을 만든 사람이 왜 그렇게 설계했는지를 이해하고, 그걸 처음 사용하는 사람의 언어로 다시 풀어내는 작업에 가까웠습니다.
처음에는 "코드 기여 다음에 문서 기여를 하는 게 맞나?"라는 생각으로 시작했습니다. 지금은 오히려 이번 작업 덕분에 Iceberg의 기능을 사용자 입장에서 다시 바라보는 경험을 할 수 있었다고 생각합니다. 그리고 다음에 다른 기능의 문서를 보게 된다면, 예전처럼 "설정 몇 개 적어주면 되겠지"라고 생각하지는 않을 것 같습니다.