

Apache Gravitino 여러 이슈를 해결하며 프로젝트 깊게 파보기
- Apache Gravitino
1. 서론
1.1 Apache Gravitino는 무엇인가
Gravitino는 흩어져 있는 메타데이터를 한곳에서 다룰 수 있게 해주는 프로젝트입니다. Apache에서는 이를 메타데이터 레이크(metadata lake) 라고 부릅니다. 2023년에 공개된 뒤 Apache 인큐베이터를 거쳤고, 지금은 정식 Top-Level Project가 되었습니다.
이름은 조금 낯설지만 해결하려는 문제는 꽤 익숙합니다. 데이터를 다루는 시스템이 커질수록 데이터가 어디에 있고, 어떤 형태로 존재하는지를 관리하는 시스템도 같이 늘어납니다. 예를 들면 다음과 같습니다.
| 무엇이 | 어디에 |
|---|---|
| Hive 테이블 | Hive Metastore |
| Iceberg 테이블 | REST Catalog, Glue, Hive Metastore 등 |
| 원본 파일 | S3, HDFS의 경로 |
| 운영 DB 테이블 | MySQL, PostgreSQL의 시스템 카탈로그 |
| 모델과 피처 | 별도의 관리 시스템이나 문서 |
각 시스템은 자기 영역에서는 잘 동작합니다. 문제는 이들을 가로질러 정보를 찾아야 할 때 생깁니다. "이 컬럼을 사용하는 테이블이 어디에 있지?" "이 데이터에 접근할 수 있는 사람은 누구지?" 이런 질문을 하려면 시스템마다 따로 확인해야 합니다.
Gravitino는 이 위에 하나의 메타데이터 관리 계층을 둡니다. 여러 시스템에 흩어진 메타데이터를 하나의 인터페이스로 다룰 수 있게 만드는 것입니다. 여기서 흥미로웠던 부분은 메타데이터를 Gravitino 안으로 복사해 두는 방식이 아니라는 점입니다. 원본 시스템과 연결해서 메타데이터를 다룹니다. 원본의 변경 사항을 별도로 동기화해야 하는 구조가 아니라는 뜻입니다.
Gravitino 내부 구조도 이 개념을 따라갑니다. 가장 위에 Metalake가 있고, 그 아래에 Catalog가 연결됩니다. Catalog 안에는 Schema와 Table이 있고, 그 외에도 Fileset과 Model 같은 객체가 존재합니다.
이번에 수정한 코드들도 이 구조 곳곳에 흩어져 있었습니다.
1.2 한 프로젝트에 오래 머물러 보기
지금까지 오픈소스에 기여할 때는 한 프로젝트에서 이슈 하나를 해결하고, 머지되면 다음 프로젝트로 넘어가는 경우가 많았습니다. 기여 자체는 남았지만 한 가지 아쉬움이 있었습니다. 그 프로젝트가 어떻게 생겼는지는 잘 모르겠다는 것이었습니다.
그래서 이번에는 반대로 해보기로 했습니다. 프로젝트를 여러 개 돌아다니기보다 하나를 정하고, 그 안에서 이슈를 계속 찾아 해결해 보기로 했습니다. 같은 저장소를 반복해서 읽다 보면 처음에는 보이지 않던 구조가 조금씩 보일 것 같았습니다.
Gravitino를 선택한 이유도 있었습니다. 평소 Iceberg와 Hadoop 생태계를 다루고 있어서 완전히 낯선 영역은 아니었고, 비교적 최근에 Apache Top-Level Project가 된 만큼 직접 들여다볼 만한 부분도 많아 보였습니다. 무엇보다 한 프로젝트를 오래 파보자는 이번 목표와 잘 맞았습니다.
1.3 작은 이슈부터 시작하기
처음부터 큰 기능을 맡지는 않았습니다. 우선 몇 줄 정도의 수정으로 해결할 수 있는 작은 이슈부터 골랐습니다. 작은 이슈의 장점은 명확합니다. 고치는 데 걸리는 시간은 짧습니다. 대신 그 코드가 왜 그렇게 작성되어 있는지 확인하는 데는 생각보다 시간이 걸립니다.
저는 오히려 그 점이 좋았습니다. 코드를 빨리 수정하는 것보다 주변 코드를 읽고, 호출 흐름을 따라가고, 기존 테스트를 확인하는 시간이 길어야 프로젝트를 제대로 볼 수 있을 것이라고 생각했기 때문입니다.
2. 본론
2.1 이슈를 고른 방식
이번에 해결한 이슈 일곱 개는 모두 같은 분이 올린 이슈였습니다. Apache Software Foundation 멤버이자 Gravitino PMC 멤버인 Justin Mclean이 올린 [Improvement] 이슈들이었습니다. 코드를 읽다가 발견한 작은 문제들을 꾸준히 올려둔 형태였고, 대략 다음과 같은 종류였습니다.
| 유형 | 예 |
|---|---|
| 빠진 방어 코드 | 검증 호출 누락, null 확인 없이 사용 |
| 너무 넓게 적용된 조건 | 이른 return이 다른 변경까지 막는 경우 |
| 제대로 검증하지 않는 테스트 | 잘못된 필드를 넣었지만 테스트는 계속 통과하는 경우 |
처음 들어가는 이슈로 괜찮겠다고 생각했습니다. 무엇을 고쳐야 하는지가 비교적 분명하기 때문입니다. 그렇다고 단순히 한 줄을 추가하고 끝나는 것도 아니었습니다. 실제로 수정하려면 해당 클래스가 어떤 역할을 하는지, 호출하는 쪽에서는 어떻게 사용하는지, 기존 테스트는 무엇을 보장하고 있는지를 확인해야 했습니다.
작은 이슈를 따라가면서 프로젝트 구조를 조금씩 알아가는 방식이었습니다.
2.2 검증 호출이 빠진 코드
💬 파티션 추가 요청
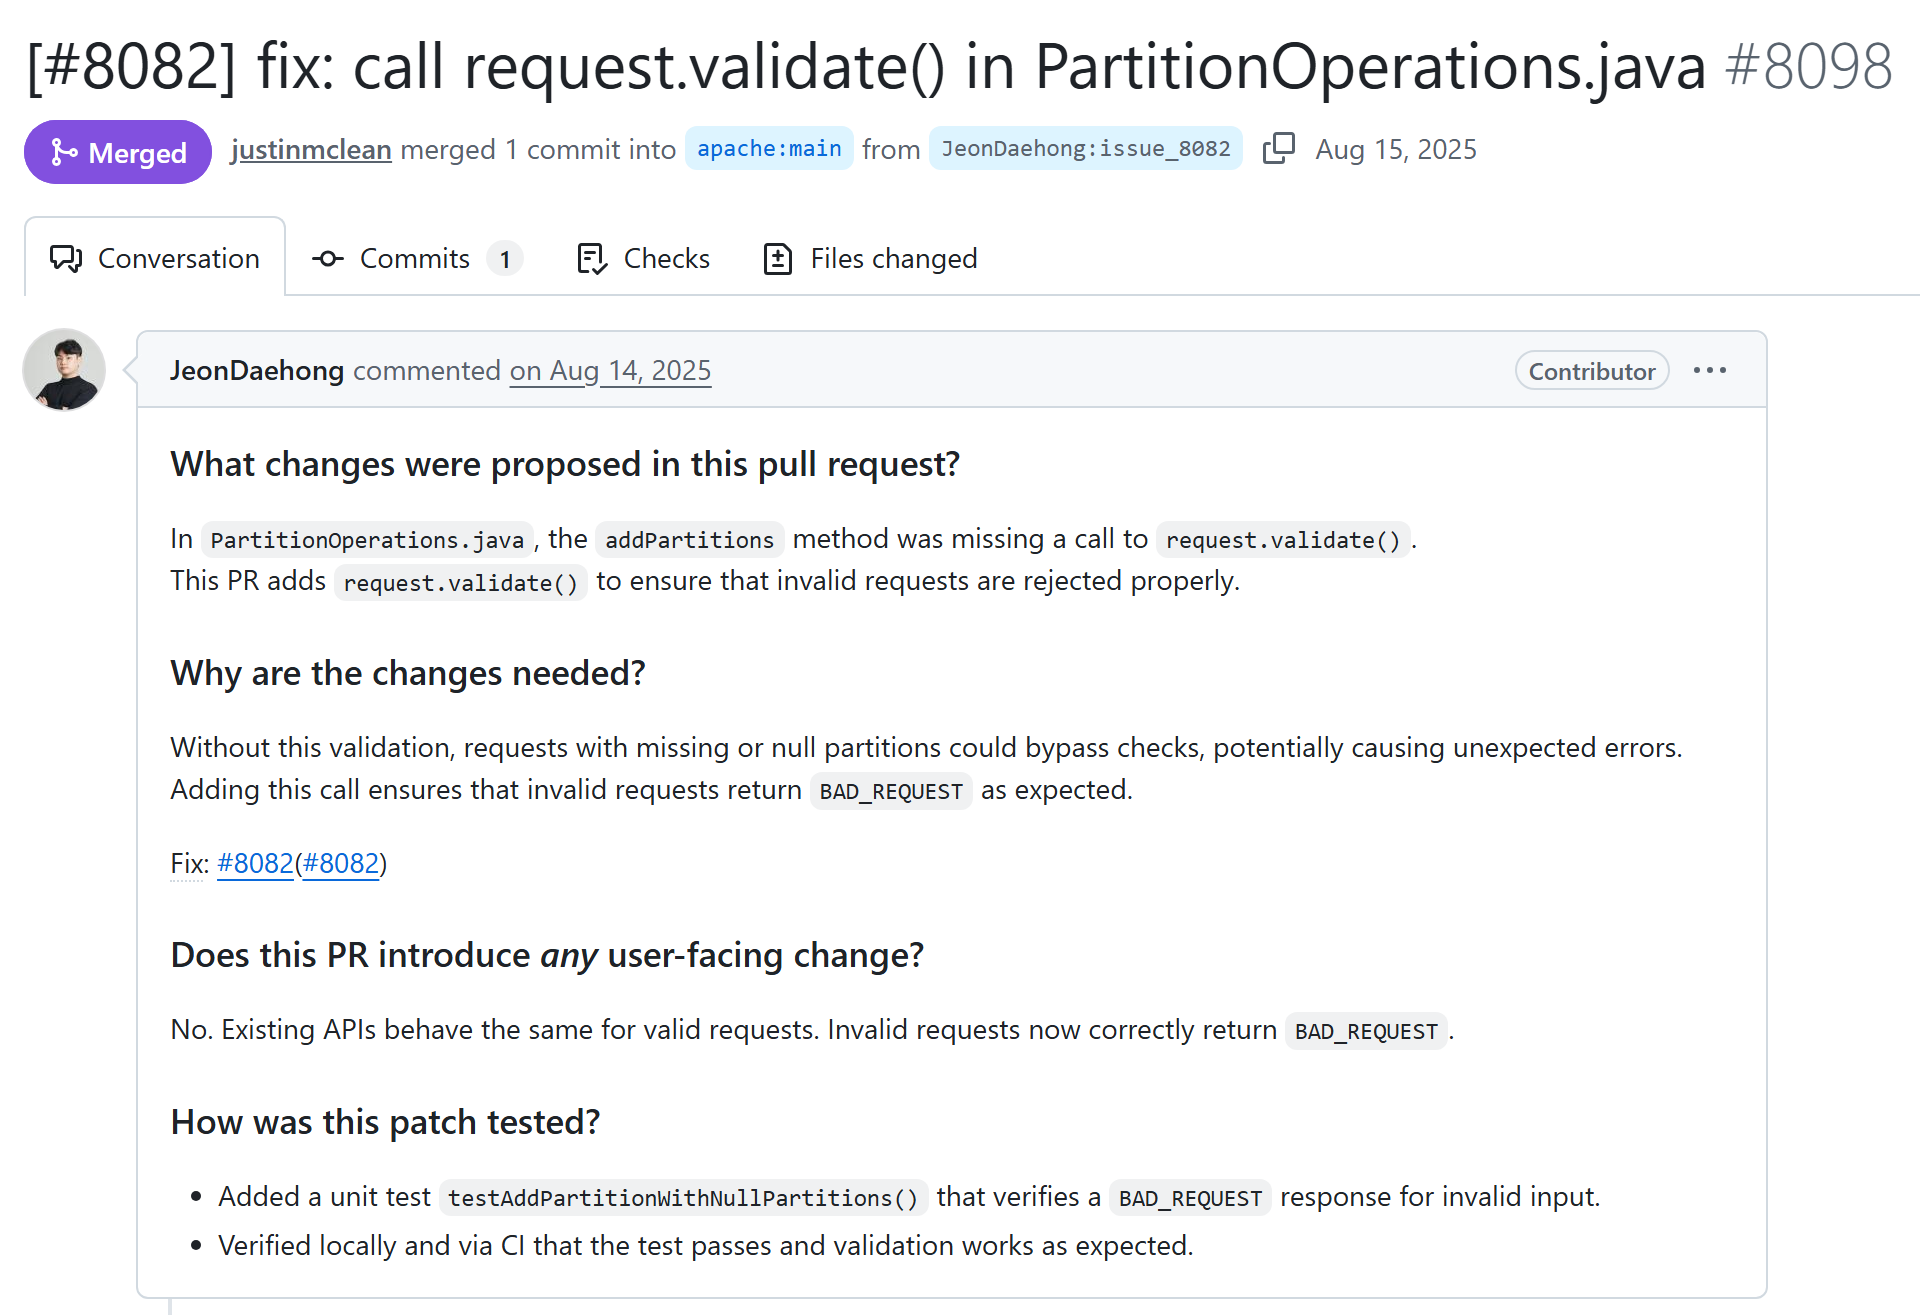
#8082는 PartitionOperations.addPartitions에서 request.validate()를 호출하지 않는 문제였습니다. Gravitino의 REST 요청 DTO들은 요청 자체를 검증하는 validate() 메서드를 가지고 있습니다. 일반적인 흐름은 요청을 받은 뒤 검증하고, 실제 작업을 수행하는 방식입니다.
그런데 이 메서드에서는 그 호출이 빠져 있었습니다.
Preconditions.checkArgument(
    request.getPartitions().length == 1, "Only one partition is supported");

request.validate();   // this one line was missing
재미있었던 건 바로 위에 이미 Preconditions.checkArgument가 있었다는 점입니다. 겉으로 보면 검증하고 있는 것처럼 보입니다. 하지만 실제로 확인하는 것은 파티션 개수뿐이었습니다. 파티션의 내용이 유효한지는 별도의 validate()가 담당하고 있었습니다.
검증을 건너뛰면 잘못된 요청이 초기에 BAD_REQUEST로 거절되지 않고 더 안쪽까지 들어갑니다. 그러면 실제 오류가 발생하는 위치와 사용자가 잘못 입력한 지점이 멀어질 수 있습니다. 수정은 한 줄이었습니다. PR #8098로 올렸고 2025년 8월 15일에 머지됐습니다.
💬 응답 DTO의 부모 검증
#8303도 비슷한 문제였습니다. OAuth2TokenResponse.validate()가 부모 클래스의 validate()를 호출하지 않고 있었습니다.
@Override
public void validate() throws IllegalArgumentException {

  super.validate();   // added

  Preconditions.checkArgument(
      StringUtils.isNotBlank(accessToken), "Invalid access token: null");
  ...
}
BaseResponse.validate()에서는 응답 코드와 관련된 공통 검증을 수행하고 있었습니다. 그런데 자식 클래스에서 validate()를 재정의하면서 super.validate()를 빠뜨린 것입니다. 결과적으로 자식 클래스는 자기 필드만 검사하고 부모가 담당하던 검증은 건너뛰게 됩니다.
수정 자체는 한 줄이었지만, 코드를 따라가면서 상속 관계와 검증 책임이 어떻게 나뉘어 있는지를 같이 볼 수 있었습니다. PR #8376으로 2025년 9월 2일에 머지됐습니다. 그리고 이게 이번에 올린 마지막 Gravitino PR이었습니다.
2.3 값이 없을 때를 생각하지 않은 코드
💬 CLI의 managed 속성
#8083은 Fileset을 생성하는 CLI 명령에서 managed 속성이 없을 때 NullPointerException이 발생하는 문제였습니다. 원래 코드는 다음과 같은 형태였습니다.
boolean managed = properties.get("managed").equals("true");
managed는 사용자가 선택적으로 전달하는 속성이었습니다. 그런데 코드에서는 항상 값이 존재한다고 가정하고 있었습니다. 값이 없으면 properties.get("managed")가 null이 되고, 바로 .equals()를 호출하면서 예외가 발생합니다.
수정은 다음과 같이 했습니다.
boolean managed =
    Optional.ofNullable(properties.get("managed"))
        .map("true"::equals)
        .orElse(false);
여기서 중요한 건 단순히 NullPointerException을 없애는 것이 아니었습니다. 값이 없을 때 어떻게 동작해야 하는가를 확인해야 했습니다. 기존 동작과 CLI의 의미를 확인해 보니 기본값은 false, 즉 external Fileset으로 보는 것이 맞았습니다.
결국 코드 한 줄을 안전하게 바꾸기 위해서도 그 값이 어디에서 사용되고, 기본 동작이 무엇인지까지 확인해야 했습니다. PR #8144로 2025년 8월 20일에 머지됐습니다.
💬 초기화되지 않은 필드
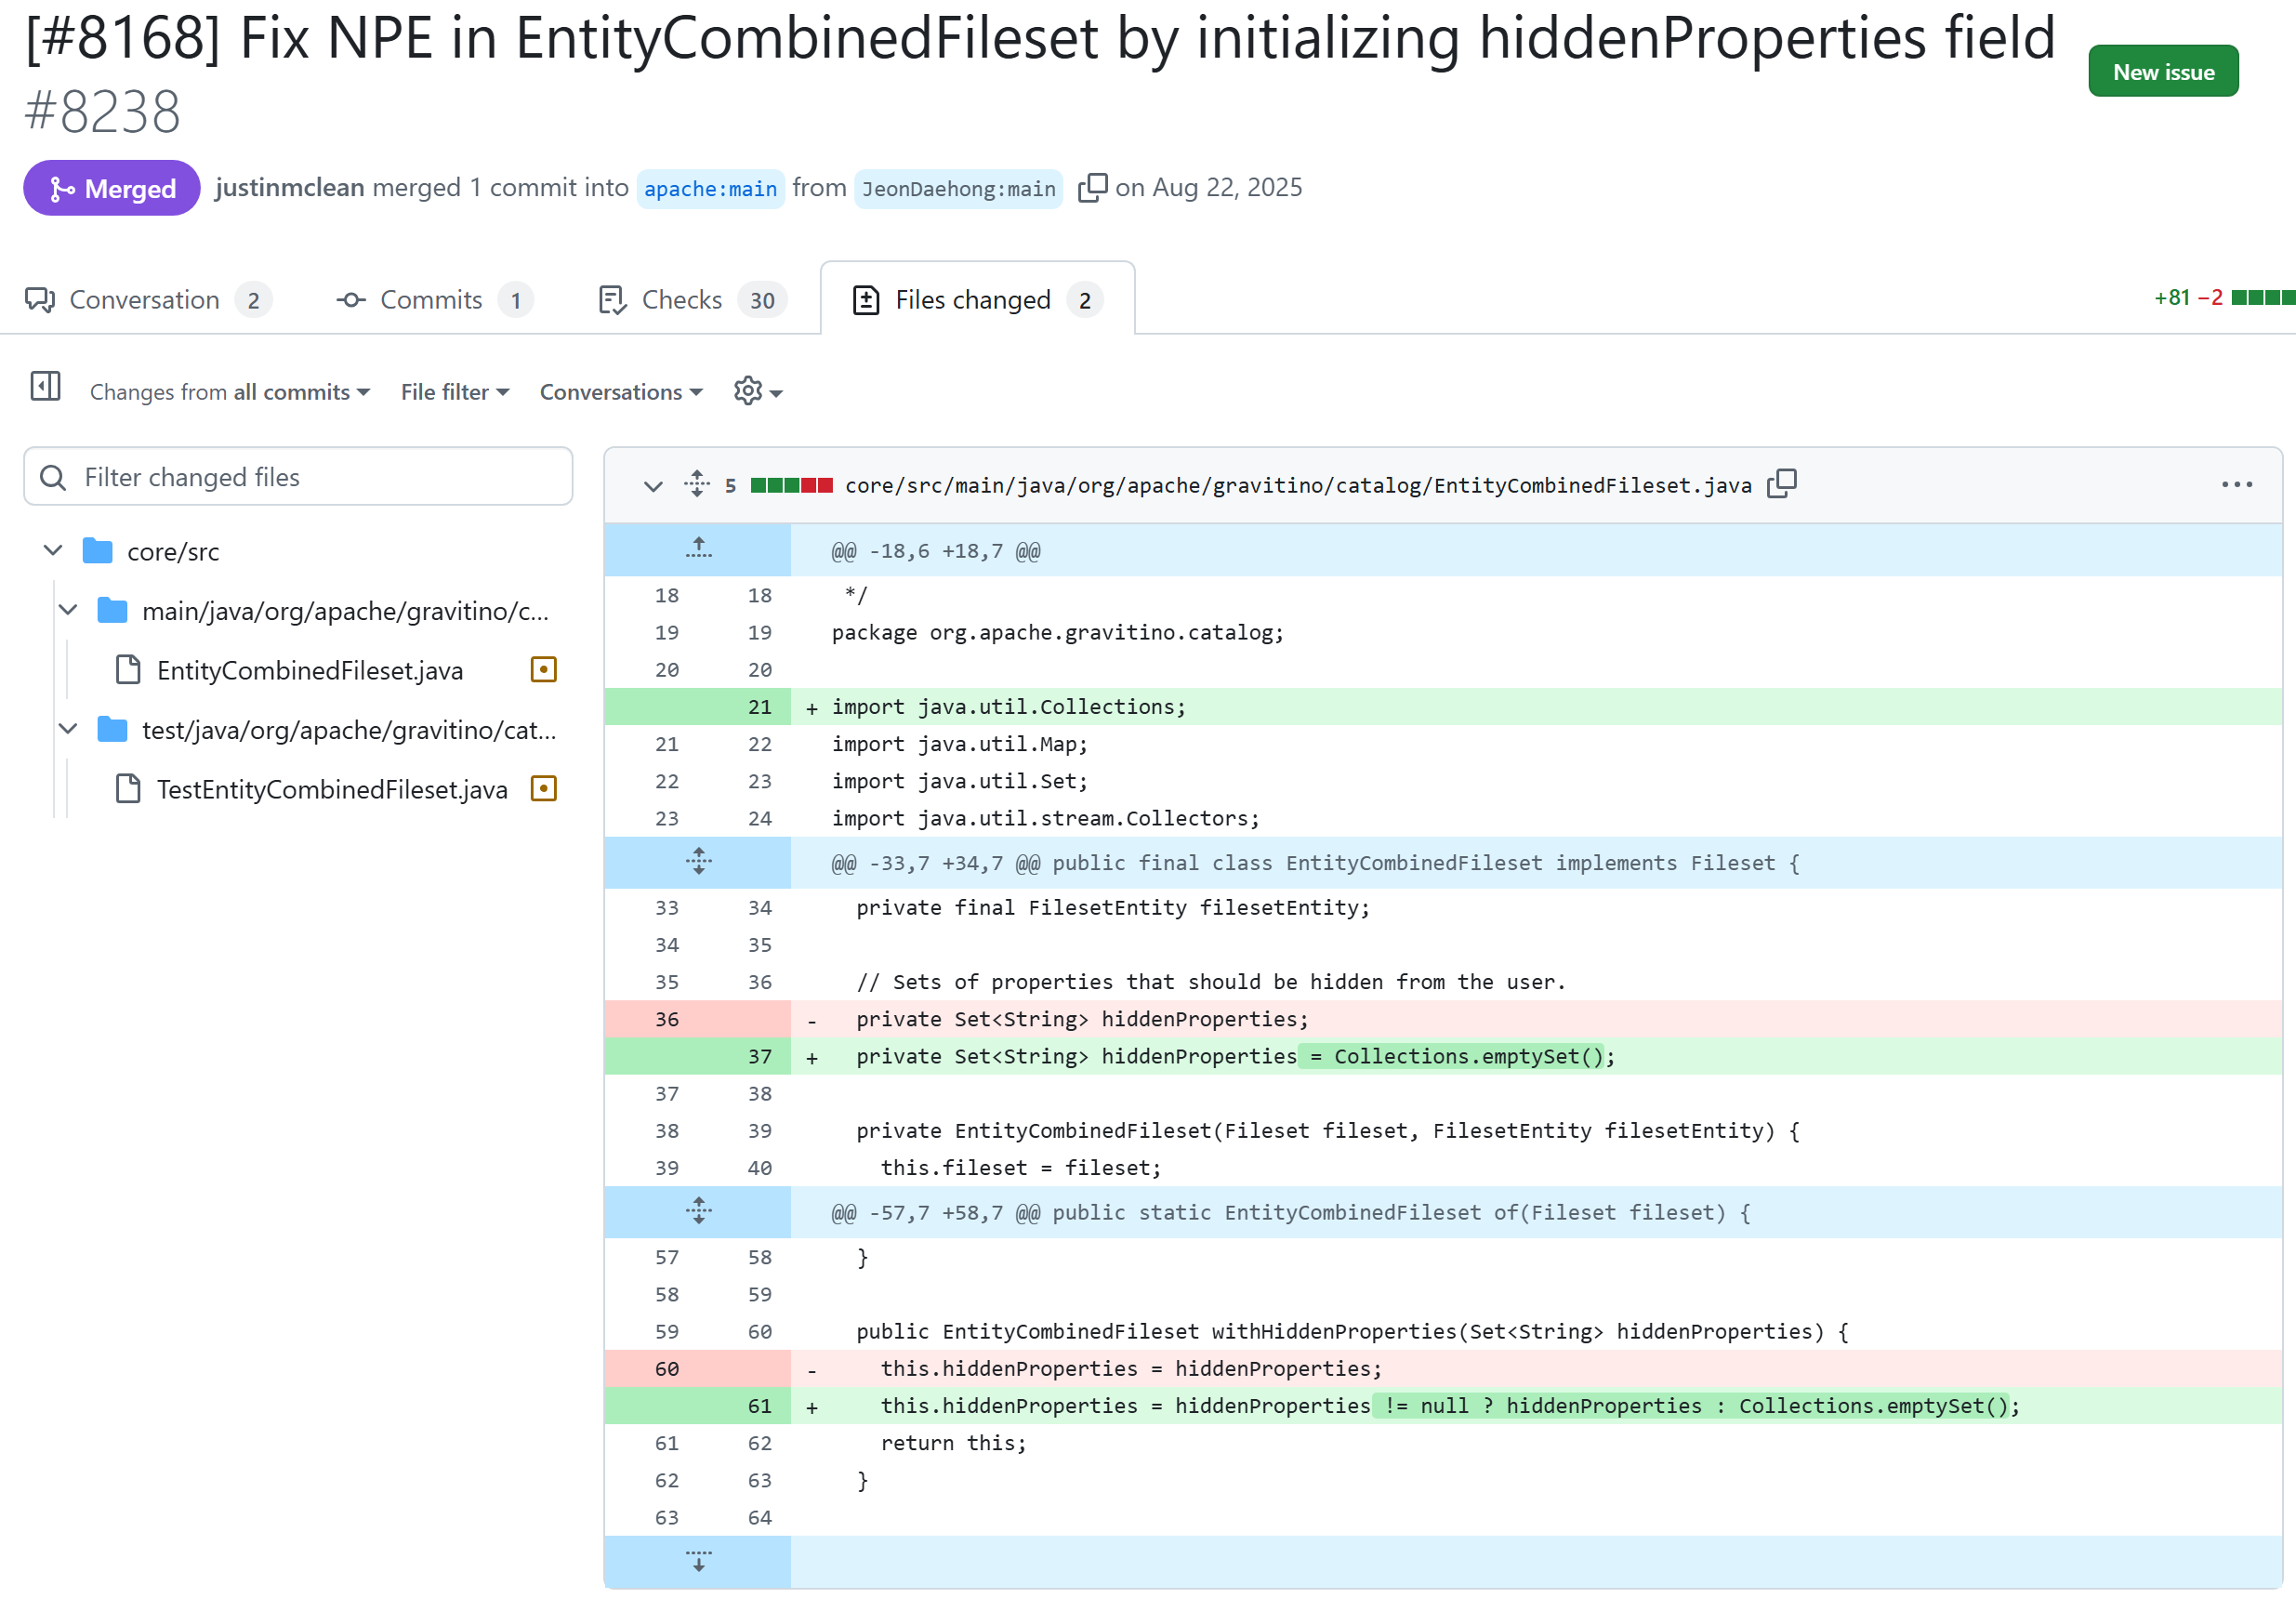
#8168은 EntityCombinedFileset의 hiddenProperties가 초기화되지 않은 상태로 사용될 수 있는 문제였습니다.
// before
private Set<String> hiddenProperties;

// after
private Set<String> hiddenProperties = Collections.emptySet();

public EntityCombinedFileset withHiddenProperties(Set<String> hiddenProperties) {
  this.hiddenProperties =
      hiddenProperties != null ? hiddenProperties : Collections.emptySet();
  return this;
}
이 객체는 of(fileset)으로 생성한 뒤 withHiddenProperties()를 선택적으로 호출할 수 있는 구조였습니다. 그런데 withHiddenProperties()를 호출하지 않은 상태에서 properties()를 호출하면 초기화되지 않은 필드를 사용할 가능성이 있었습니다. 빌더처럼 생긴 객체에서는 이런 부분을 특히 조심해야 합니다. 선택적으로 호출할 수 있는 메서드라면, 호출하지 않았을 때도 객체가 정상적으로 동작해야 하기 때문입니다.
그래서 필드 자체를 빈 집합으로 초기화하고, 외부에서 null이 들어오는 경우에도 빈 집합으로 처리했습니다. 이 두 이슈에서 재미있었던 점은 수정 코드보다 테스트 코드가 훨씬 길었다는 것입니다. Fileset CLI 관련 테스트는 151줄, hiddenProperties 관련 테스트는 78줄을 새로 추가했습니다.
결국 버그를 고치는 건 몇 줄이지만, 다시 같은 문제가 생기지 않게 만드는 건 테스트의 역할이라는 걸 다시 느꼈습니다. PR #8144는 2025년 8월 20일, PR #8238은 2025년 8월 22일에 각각 머지됐습니다.
2.4 조건이 너무 넓게 걸린 코드
💬 그룹을 수정해도 저장되지 않던 문제
일곱 개 중 가장 기억에 남은 이슈입니다. #8201은 GroupMetaService.updateGroup의 이른 return 때문에 그룹 이름 변경이 저장되지 않는 문제였습니다. 기존 코드는 역할(role)이 변경됐는지를 먼저 확인했습니다.
Set<Long> insertRoleIds = Sets.difference(newRoleIds, oldRoleIds);
Set<Long> deleteRoleIds = Sets.difference(oldRoleIds, newRoleIds);

if (insertRoleIds.isEmpty() && deleteRoleIds.isEmpty()) {
  return newEntity;
}
역할이 바뀌지 않았다면 더 이상 할 일이 없다고 판단한 것입니다. 그런데 이 메서드가 하는 일이 역할 변경뿐이 아니었습니다. 그룹 이름과 감사 정보도 함께 업데이트하고 있었습니다. 그래서 역할은 그대로 두고 이름만 변경하면 DB에는 아무것도 저장되지 않는 문제가 생겼습니다.
더 헷갈리는 부분도 있었습니다. 호출한 쪽에서는 newEntity를 반환받기 때문에 이름이 변경된 것처럼 보입니다. 즉, API 호출 자체는 성공했는데 실제 데이터를 다시 조회해 보면 이름이 바뀌지 않은 상황이 됩니다.
수정 방향은 이른 return을 없애는 것이었습니다. 다만 조건 자체를 완전히 없애지는 않았습니다.
SessionUtils.doMultipleWithCommit(
    () -> /* update group metadata : always, unconditionally */,
    () -> {
      if (!insertRoleIds.isEmpty()) {
        /* add roles */
      }
    },
    () -> {
      if (!deleteRoleIds.isEmpty()) {
        /* remove roles */
      }
    });
역할이 변경되지 않았다면 역할 관련 쿼리는 실행하지 않고, 그룹 자체의 업데이트는 항상 수행하도록 범위를 나눴습니다. 처음 조건을 넣은 의도도 이해할 수 있었습니다. 역할이 바뀌지 않았다면 관련 DB 작업을 하지 않는 것이니까요.
문제는 그 조건이 역할 변경뿐 아니라 메서드 전체를 건너뛰게 만들었다는 것이었습니다. 이 이슈를 보면서 조건문을 볼 때 단순히 "이 조건이 맞는가?"만 보는 게 아니라, 이 조건이 어디까지의 작업을 건너뛰게 만드는가도 봐야겠다는 생각을 했습니다. 역할 변경 없이 이름만 바꾸는 경우를 검증하는 테스트도 추가했습니다.
PR #8255로 2025년 8월 23일에 머지됐습니다.
2.5 아무것도 검증하지 않는 테스트
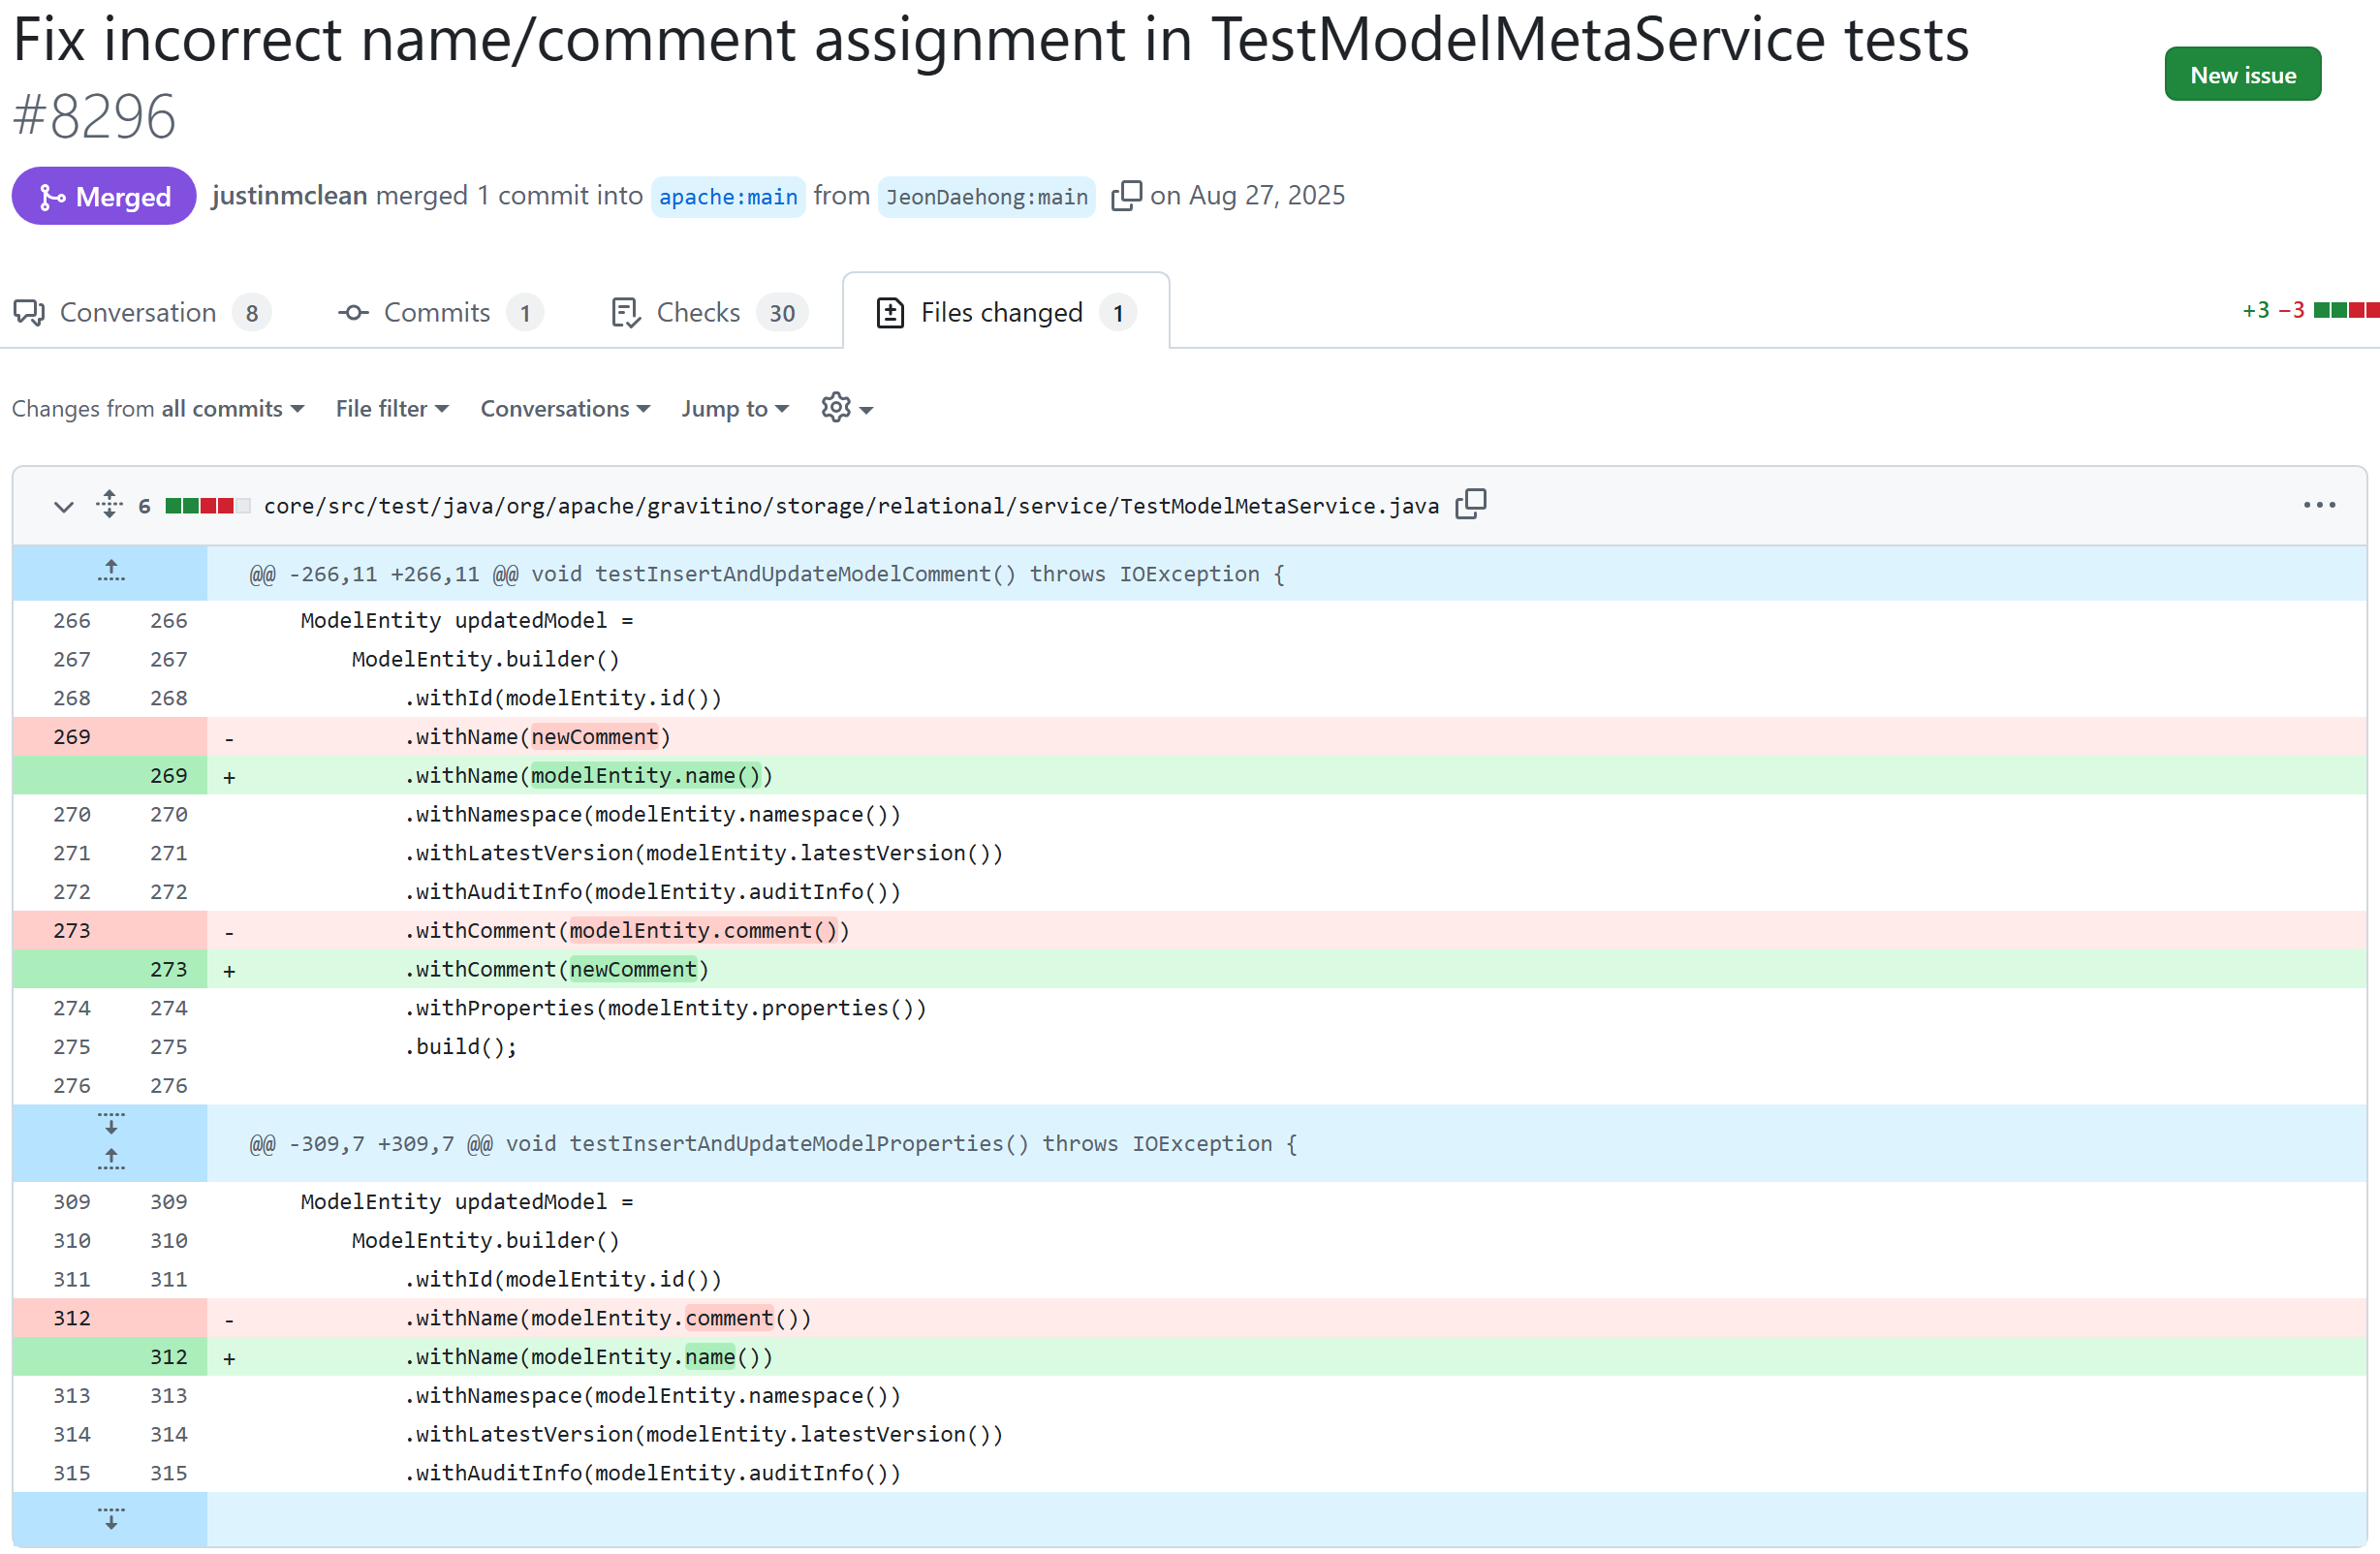
#8282는 TestModelMetaService의 테스트 두 개가 잘못된 필드를 검증하고 있던 문제였습니다. 예를 들어 다음 테스트는 코멘트 변경을 검증하는 테스트였습니다.
// testInsertAndUpdateModelComment
.withName(newComment)
.withComment(modelEntity.comment())
그런데 실제로는 코멘트를 변경하지 않고 이름을 변경하고 있었습니다. 다른 테스트에서는 반대로 withName(modelEntity.comment())처럼 코멘트 값을 이름 자리에 넣고 있었습니다. 수정한 코드는 다음과 같습니다.
.withName(modelEntity.name())
.withComment(newComment)
고친 코드는 세 줄뿐이었습니다. 그런데 개인적으로는 이런 종류의 문제가 가장 신경 쓰였습니다.
테스트가 계속 통과하고 있었기 때문입니다.
테스트가 실패했다면 이상하다는 걸 바로 알 수 있습니다. 하지만 잘못된 값을 넣은 채로도 테스트가 통과하면, 그 테스트를 다시 들여다볼 이유가 쉽게 생기지 않습니다. 그래서 이 이슈를 본 이후에는 테스트를 추가할 때 가능하면 일부러 구현을 틀리게 만들었을 때 테스트가 실제로 실패하는지도 확인하려고 합니다.
테스트가 실행된다는 것과 테스트가 제대로 검증하고 있다는 것은 다른 문제였습니다. PR #8296으로 2025년 8월 27일에 머지됐습니다.
3. 결론
3.1 반복해서 보니 비슷한 문제가 보였다
일곱 개의 이슈를 연달아 고치고 나니 비슷한 패턴이 반복된다는 것이 보였습니다.
| 자주 나온 유형 | 어디서 |
|---|---|
| 필요한 검증을 호출하지 않음 | 파티션 요청, OAuth 응답 |
| 없을 수 있는 값을 항상 있다고 가정 | CLI 속성, 초기화되지 않은 필드 |
| 조건의 범위가 너무 넓음 | 그룹 수정의 이른 return |
| 테스트는 통과하지만 실제 값을 검증하지 않음 | 모델 메타 테스트 |
한 프로젝트를 계속 본 덕분이라고 생각합니다. 이슈를 하나씩 다른 프로젝트에서 만났다면 각각을 별개의 버그로 보고 넘어갔을 가능성이 큽니다. 하지만 같은 저장소에서 비슷한 문제를 계속 보다 보니 이 프로젝트의 코드가 어떤 방식으로 구성되어 있고, 어떤 부분에서 실수가 생기는지가 조금씩 보이기 시작했습니다.
처음에는 이슈를 해결하기 위해 코드를 읽었습니다. 나중에는 코드를 읽다 보니 이슈가 왜 생겼는지가 보였습니다. 이 차이가 이번에 Gravitino를 오래 들여다보면서 얻은 가장 큰 변화였습니다.
3.2 작은 이슈라고 쉬운 건 아니었다
이번에 고친 코드는 대부분 몇 줄 수준이었습니다. 하지만 실제로는 그보다 훨씬 많은 코드를 읽었습니다. super.validate() 한 줄을 추가하려면 부모 클래스가 무엇을 검증하는지 확인해야 했고, hiddenProperties를 초기화하려면 객체가 어떤 경로로 생성되고 사용되는지 따라가야 했습니다.
그룹 수정 문제도 마찬가지였습니다. return 하나를 지우는 것으로 끝나는 게 아니라, 그 조건이 왜 들어갔는지와 그 아래에서 어떤 작업들이 수행되는지를 모두 확인해야 했습니다. 결국 수정하는 코드의 양과 읽어야 하는 코드의 양은 전혀 다른 문제였습니다.
오히려 작은 이슈일수록 수정하는 시간보다 코드를 이해하는 데 더 많은 시간이 들었습니다.
3.3 조건은 무엇을 막고 있는지도 봐야 했다
가장 기억에 남는 건 그룹 수정 이슈였습니다. 쿼리를 아끼려고 넣은 조건 하나가 이름 변경까지 막고 있었습니다. 그렇다고 그 조건을 무조건 없애는 게 해결책은 아니었습니다. 역할이 바뀌지 않았을 때 역할 관련 쿼리를 실행하지 않으려던 의도 자체는 남겨야 했습니다.
결국 필요한 건 조건을 없애는 것이 아니라 조건이 적용되는 범위를 정확하게 줄이는 것이었습니다. 코드를 읽으면서 if나 return을 볼 때 단순히 조건의 참·거짓만 볼 게 아니라, 이 조건이 아래의 어떤 작업까지 같이 건너뛰게 만드는지를 보는 습관이 생겼습니다.
3.4 통과하는 테스트가 항상 검증하는 것은 아니다
이번 이슈들을 보면서 테스트에 대해서도 조금 달라졌습니다. 필드를 잘못 넣은 테스트가 계속 통과하고 있었습니다. 테스트가 실행되고 있다는 사실만 보면 문제가 없어 보입니다. 하지만 실제로 확인하려던 값이 아니라 다른 값을 확인하고 있다면 그 테스트가 존재하는 의미가 거의 없습니다.
그래서 최근에는 테스트를 추가할 때 단순히 정상 케이스를 통과시키는 것에서 끝내지 않고, 구현을 일부러 잘못 바꿨을 때 테스트가 실패하는지도 확인하려고 합니다. 테스트의 개수나 커버리지 숫자만으로는 이런 문제를 발견하기 어렵습니다. 결국 중요한 건 테스트가 존재하느냐보다 무엇을 실제로 검증하고 있느냐였습니다.
3.5 앞으로
이번에는 주로 방어 코드와 테스트처럼 비교적 작은 영역에서 시작했습니다. 다음에는 Catalog 연결처럼 Gravitino의 실제 동작과 구조에 더 가까운 부분을 들여다볼 생각입니다. 처음에는 올라온 이슈를 하나씩 따라가는 것만으로도 충분했습니다.
하지만 한 프로젝트를 계속 보다 보니 이제는 반대로 코드를 읽다가 "여기는 이렇게 동작하는 게 맞나?"라고 생각해볼 수 있는 지점도 조금씩 보이기 시작했습니다. Gravitino를 하면서 오픈소스 프로젝트를 단순히 "이슈를 해결하는 곳"으로 보는 것에서 조금 벗어나게 됐습니다. 하나의 프로젝트를 오래 들여다보면서 그 구조와 코드가 만들어진 이유를 따라가는 과정 자체가 오픈소스를 깊게 이해하는 방법이라는 걸 배웠습니다.
이번 일곱 개의 작은 이슈는 그 과정을 시작하게 해준 계기였습니다.