
증권 계좌 통합 데이터 플랫폼 프로젝트
- Data Engineer
- Stock
- Side Project
팀 프로젝트로 여러 증권사 계좌를 한곳에서 보고 조건을 걸어 두면 매매 타이밍을 알려 주는 앱 Stock-Project 를 만들었습니다. 저는 여기서 데이터 파이프라인과 Kubernetes 클러스터 운영을 맡았습니다.
사용자는 앱에서 버튼 하나를 누를 뿐이지만 그 뒤에서는 외부 API 호출부터 Lake 적재, 앱 DB 반영까지 여러 단계가 이어지게 됩니다. 이 글에서는 그 구조를 어떤 기준으로 설계했고 실제로 두 달 동안 운영해 보니 어떤 결과가 나왔는지를 정리해 보려고 합니다.
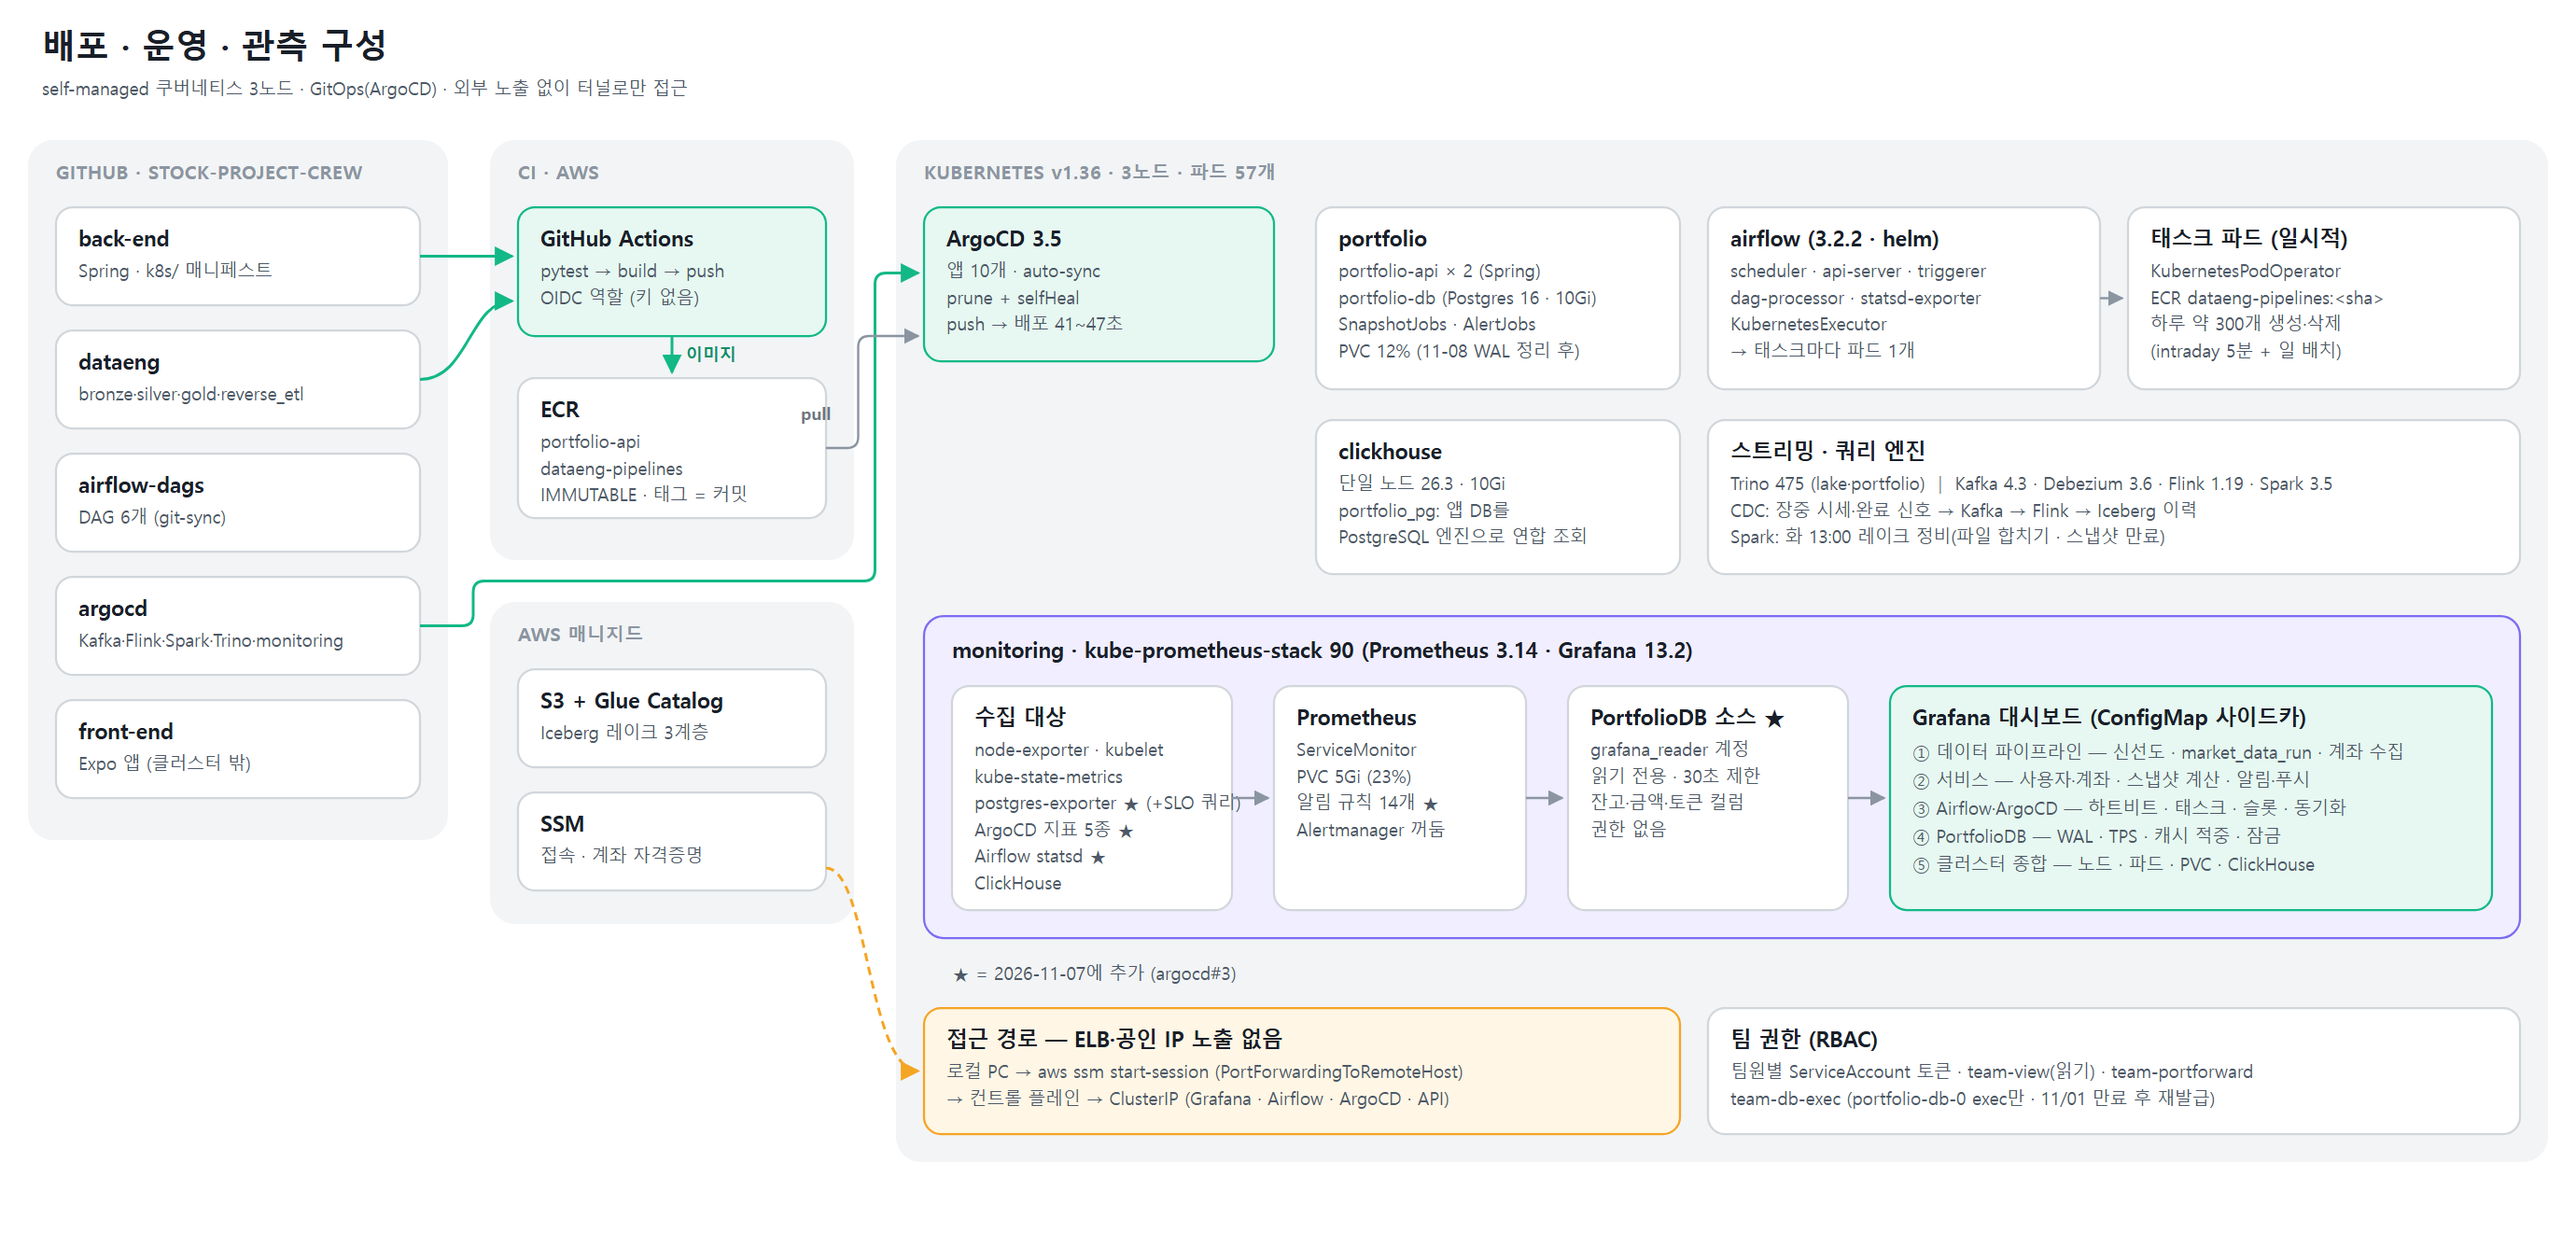
환경
- Kubernetes v1.36 (EC2 3노드, self-managed)
- Airflow 3.2 + KubernetesPodOperator
- S3 + Apache Iceberg + Glue Catalog
- PostgreSQL 16, Trino 475, ClickHouse 26.3
- Debezium + Kafka 4.3, Flink 1.19, Spark 3.5, Paimon 1.4
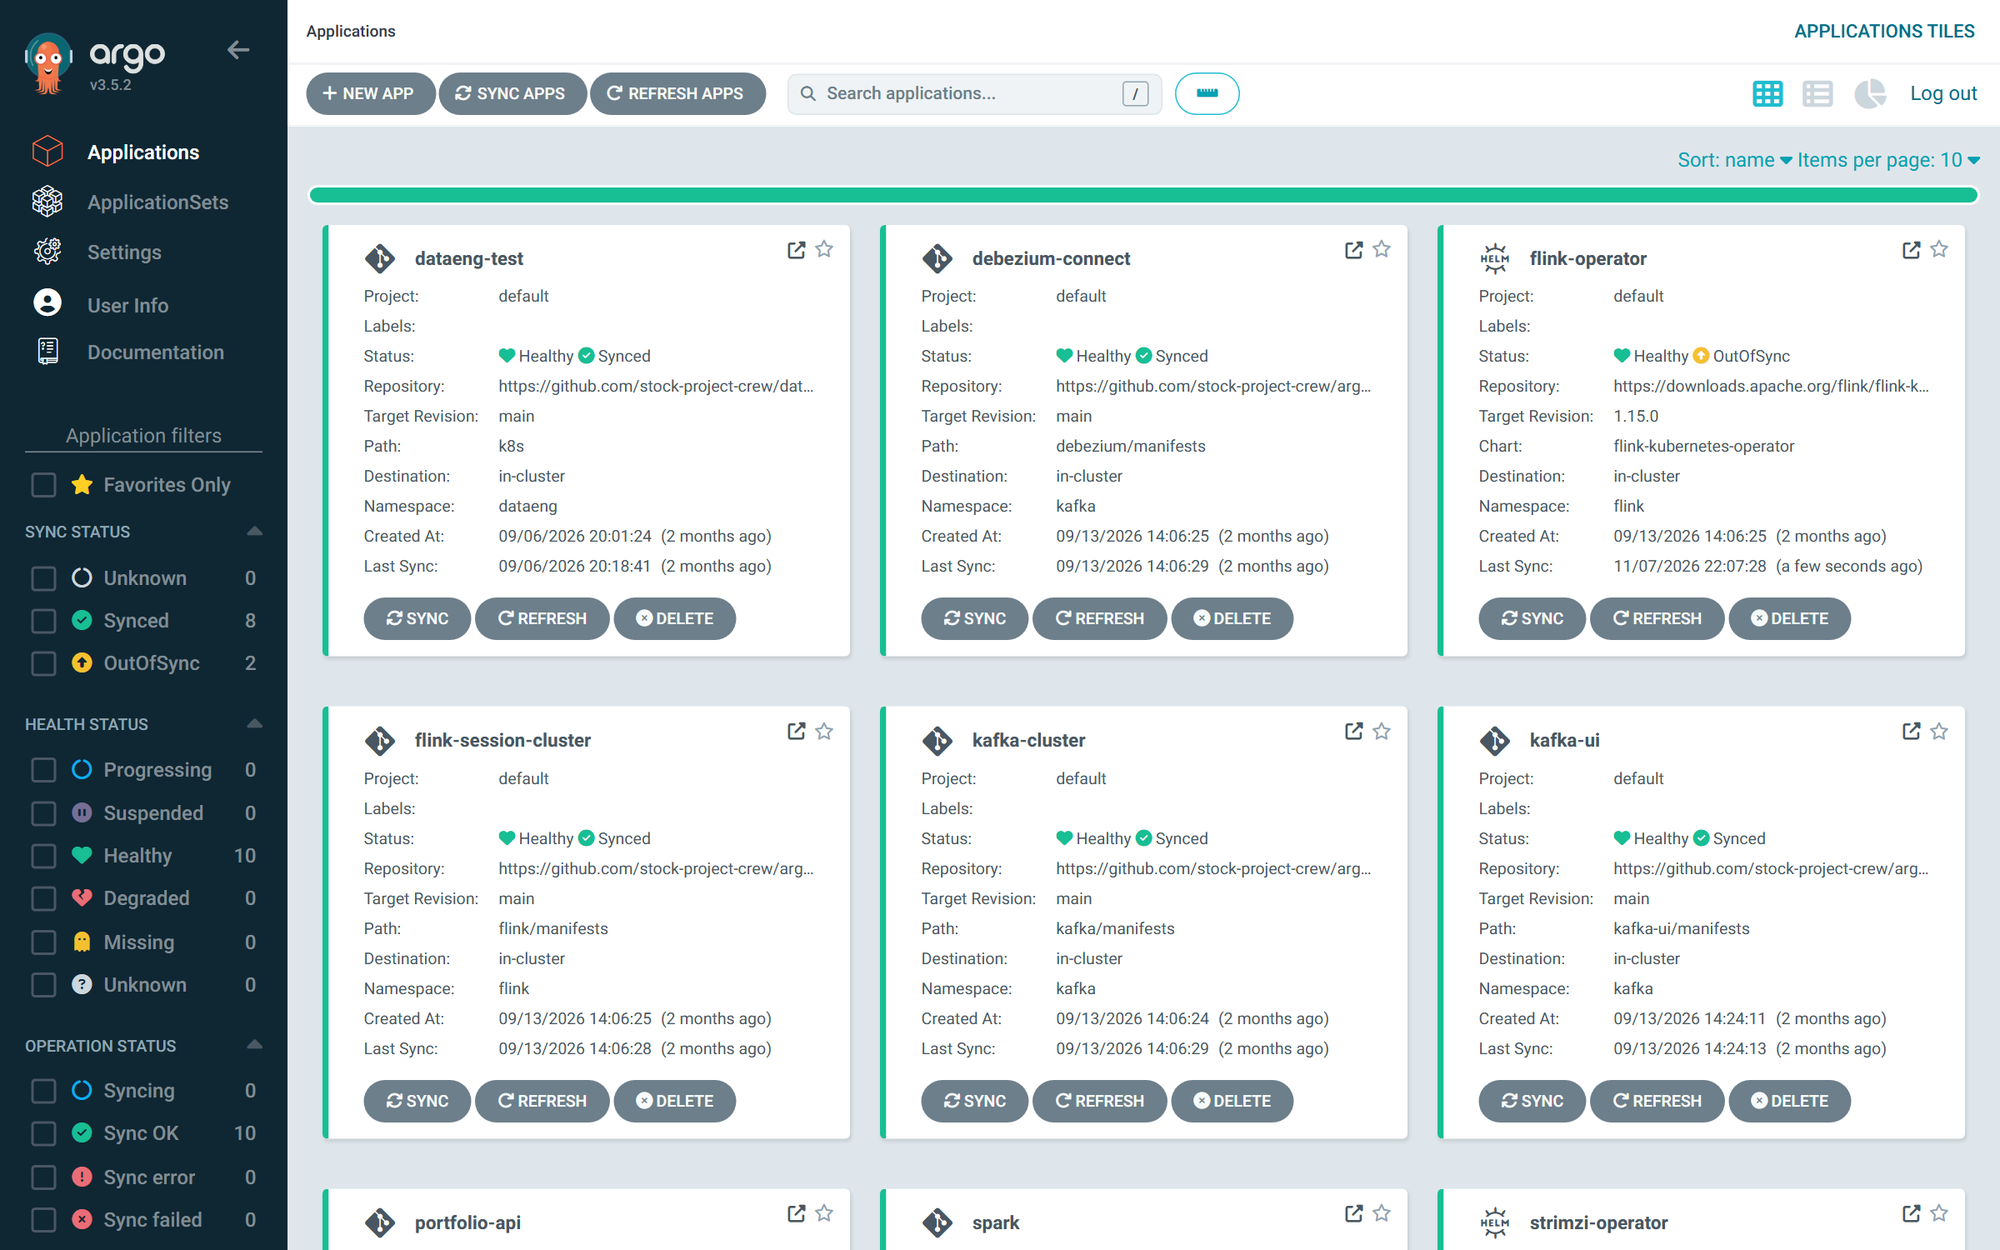
- Prometheus + Grafana, ArgoCD
1. 배경
1.1 프로젝트를 시작한 이유
당시에는 국내 증시가 붐이었습니다. 저도 주식으로 꽤 많이 벌고 있었는데 계좌가 여러 개로 나뉘어 있다 보니 내 자산이 지금 어떻게 구성되어 있는지 한눈에 보기가 어려웠습니다. 특히 ETF 는 그 안에 어떤 종목이 얼마나 들어 있는지까지 분해해서 볼 수 있으면 훨씬 편하겠다는 생각을 자주 했습니다.
동시에 데이터 사이드 프로젝트를 하나 제대로 해보고 싶다는 마음도 있었습니다. 그래서 이 두 가지를 합쳐, 여러 계좌를 한곳에서 보고 조건이 맞으면 알려 주는 앱을 팀 프로젝트로 만들게 되었습니다.
1.2 필요한 데이터
이 앱이 필요로 하는 데이터는 크게 세 가지였습니다.
- 사용자의 증권 계좌 잔고와 체결 내역 (한국투자증권 KIS, CODEF)
- 국내·미국 전 종목의 일봉, 투자자 수급, 환율
- 장중 알림에 쓸 5분 단위 시세
이 데이터는 전부 외부 API 에서 옵니다. 호출 한도가 있고 가끔은 비어서 오고 이미 받은 과거 값이 나중에 바뀌기도 합니다. 반면 백엔드 입장에서는 "지금 이 데이터를 믿고 계산해도 되는가" 하나만 알면 됩니다.
그래서 처음부터 역할을 나눴습니다. 백엔드는 앱 DB 하나만 읽고 그 DB 에 믿을 수 있는 데이터를 제때 넣는 것까지가 데이터 쪽 책임입니다. 아래에 나오는 선택 대부분이 이 약속에서 나왔습니다.
2. 설계 시 중요한 점
설계하면서 끝까지 지킨 기준은 네 가지였습니다.
2.1 Lake 와 앱 DB 의 역할 분리
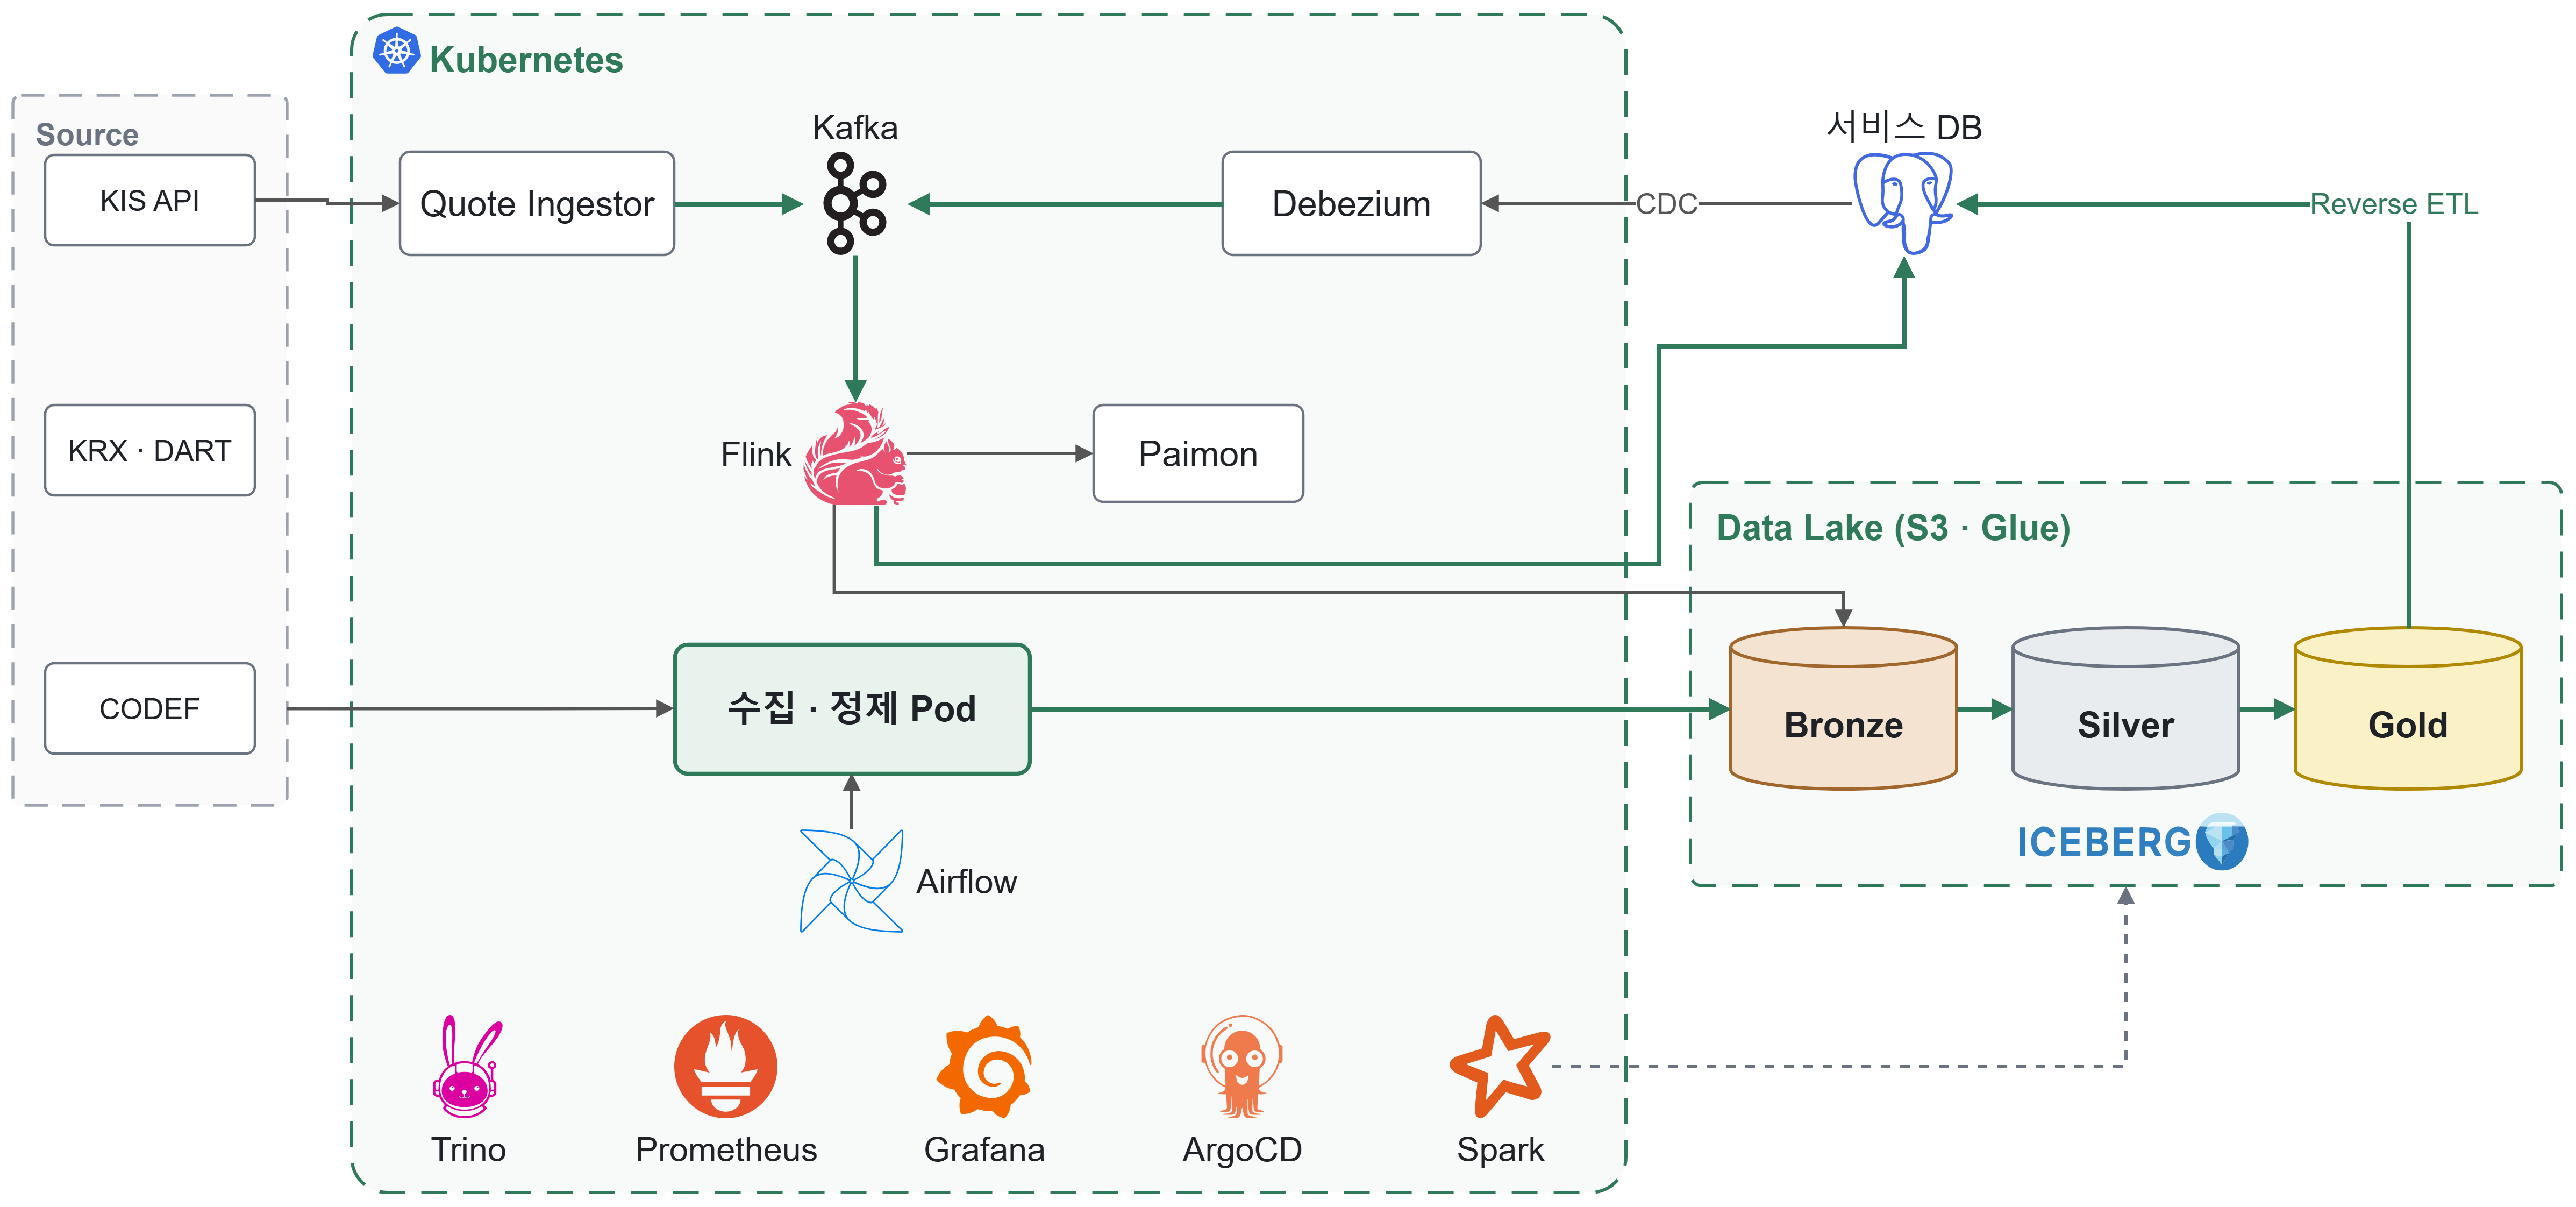
외부 API 응답은 원본 그대로 S3 위 Iceberg Lake 에 쌓고(bronze), 표준 컬럼으로 정제한 뒤(silver), 서빙용으로 계산합니다(gold). 그중 백엔드가 쓸 것만 앱 DB 의 data 스키마로 밀어 넣는데 이 과정을 reverse ETL 이라고 합니다.
저장이 두세 벌이 되는 대가는 있습니다. 하지만 정제 규칙이 틀렸을 때 원본에서 다시 계산할 수 있고 이 선택은 뒤에서 실제로 한 번 저를 구해 주게 됩니다.
2.2 완료 신호
알림 평가가 일부 종목만 들어온 상태에서 돌게 되면 빠진 종목이 "거래 없음" 으로 판정되어 잘못된 푸시가 나가게 됩니다. market_data_run 이라는 완료 신호 테이블을 두고 대상 종목이 전부 들어왔을 때만 DONE 을 쓰도록 했습니다.
처음에는 기준이 "직전 거래일의 95% 이상" 이었습니다. 그런데 10월 8일에 국내 수급이 2종목만 들어오고도 DONE 이 된 일이 있었는데 분모가 그날의 부분 적재에 끌려 같이 줄어들었기 때문입니다. 그 뒤로 기준을 "전부" 로 올리고 대상은 직전 5거래일 중 하루라도 있던 종목으로 넓혔습니다.
2.3 자격증명 관리
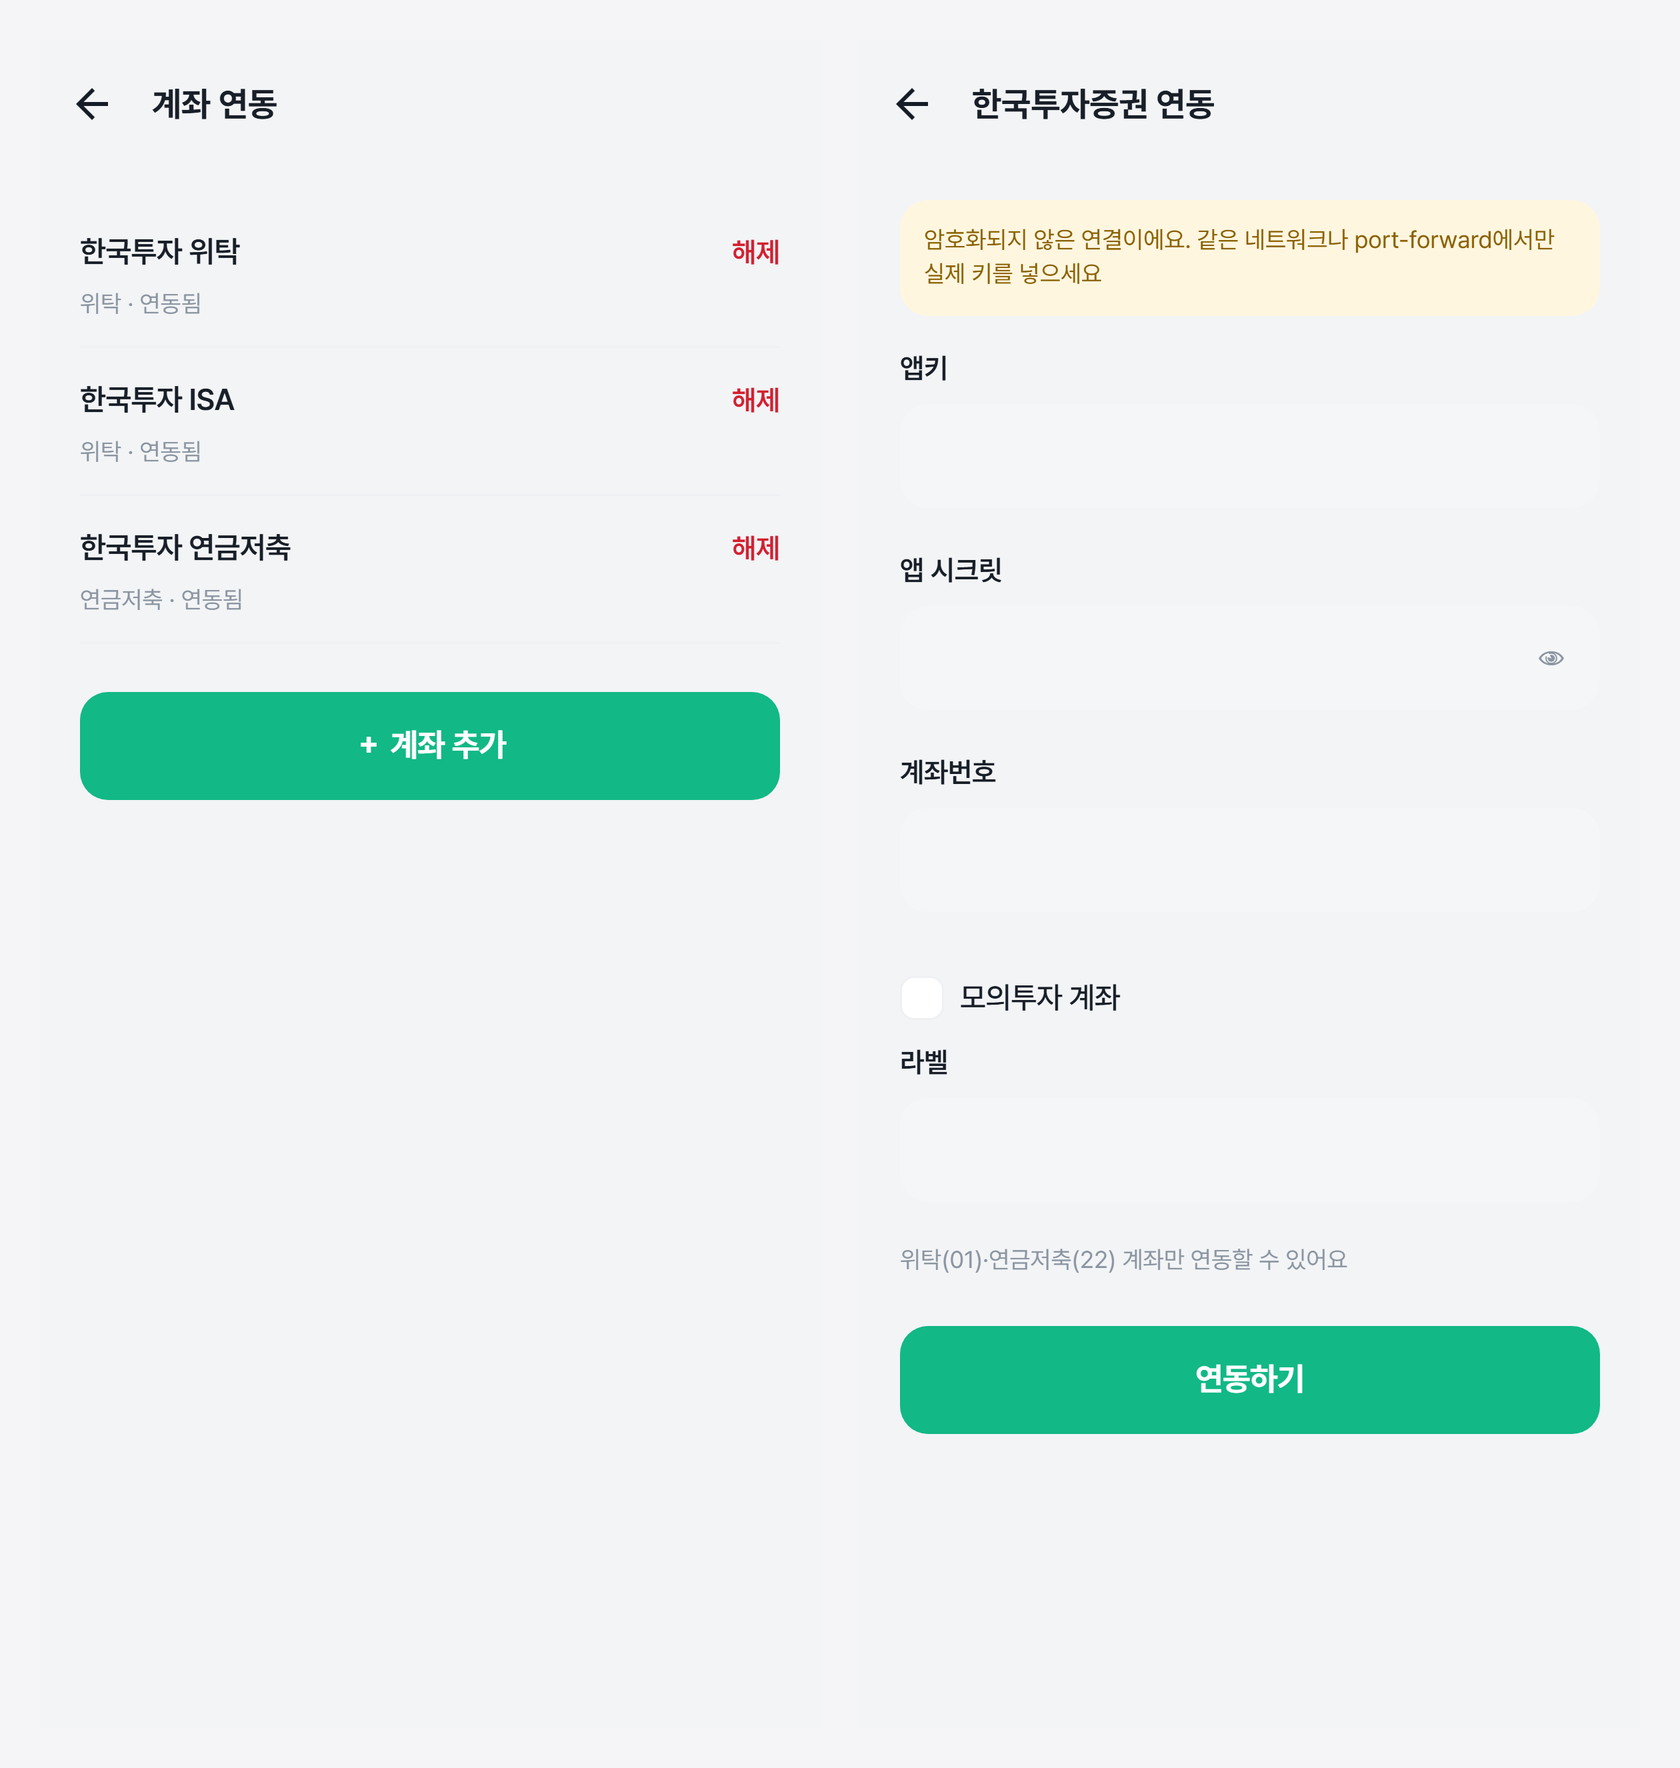
사용자가 입력한 증권사 앱키는 앱 DB 가 아니라 AWS SSM Parameter Store 에 저장하고 앱 DB 에는 그 경로만 남깁니다. 계좌번호도 원문 대신 해시값으로 다루기 때문에 운영 화면이나 로그에는 ar_b1279c9c1 같은 값만 보입니다.
백엔드는 수집을 직접 하지 않습니다. collection_run 테이블에 요청 행 하나만 쓰고 끝나며 Airflow 의 수집 Pod 이 그 요청을 집어 가는 구조입니다. 자격증명을 읽을 수 있는 것은 그 Pod 뿐입니다.
2.4 데이터 주기별 경로
모든 데이터를 같은 레이어로 보내지 않았습니다.
| 경로 | 데이터 | 주기 |
|---|---|---|
| Lake 경유 배치 | 일봉, 수급, 환율, 계좌 | 하루 1번 |
| 앱 DB 직접 적재 | 장중 시세 | 5분 |
5분 주기 데이터를 Iceberg 에 쓰면 Snapshot 이 하루에 수백 개씩 쌓이게 됩니다. 무엇보다 장중 알림에서는 몇 분 늦는 것 자체가 실패이기 때문에, 장중 시세만 Lake 를 건너뛰도록 했습니다.
2.5 기술 선정 이유와 장단점
기술마다 왜 골랐는지와 그 대가로 무엇을 감수했는지를 표로 정리했습니다.
| 기술 | 맡은 일 | 고른 이유 | 단점 |
|---|---|---|---|
| Airflow + KubernetesPodOperator | 배치 오케스트레이션 | Task 마다 Pod 을 따로 띄워서 의존성과 메모리 한도를 Task 별로 줄 수 있다 | 짧은 Task 는 실행 시간의 절반이 Pod 기동이다 |
| S3 + Iceberg | Lake 저장 | ACID Commit, 스키마 변경, Snapshot 으로 언제 무엇이 바뀌었는지 추적할 수 있다 | pyiceberg 의 쓰기 API 가 Spark 보다 얇고, 파일 합치기가 없다 |
| AWS Glue Data Catalog | Iceberg Catalog | 클러스터가 꺼져 있어도 살아 있어서 Athena 로 조회할 수 있다 | AWS 에 종속된다 |
| reverse ETL → PostgreSQL | 백엔드 서빙 테이블 | 백엔드는 앱 DB 하나만 알면 되고, 단건 조회는 PostgreSQL 이 맞다 | Lake 와 앱 DB 에 이중으로 저장되고, 둘을 맞추는 책임이 데이터 쪽에 생긴다 |
| Trino | Lake 와 앱 DB 교차 조회 | 서로 다른 저장소를 SQL 한 번으로 비교할 수 있다 | 상시 메모리를 1GB 넘게 쓴다 |
| Debezium + Kafka + Flink | 변경 이력 적재 (CDC) | 쓰는 쪽 코드를 고치지 않고도 덮어쓰이거나 지워지는 데이터의 이력을 남길 수 있다 | 상시 메모리가 크고, 소비자가 없으면 WAL 이 쌓인다 |
| Paimon | 현재 상태 테이블과 변경 스트림 | 키별로 값을 합쳐 두면서, 그 상태가 바뀔 때 변경 로그를 다시 스트림으로 내준다 | 같은 Topic 을 두 번 읽어야 하고, 클라이언트 의존성 문제로 세 번 막혔다 |
| Spark | Lake 정비 | pyiceberg 로는 할 수 없는 파일 합치기와 Snapshot 만료를 할 수 있다 | Snapshot 만료는 되돌릴 수 없어서 DRY_RUN 을 먼저 돌려야 한다 |
| Prometheus + Grafana | 모니터링과 알림 | 앱 DB 에서 뽑은 도메인 지표에 알림을 걸 수 있다 | Prometheus 보존 기간이 짧아서 장기 추이는 따로 뽑아야 한다 |
| SSM Parameter Store | 계좌 자격증명 | 경로 단위로 IAM 권한을 줄 수 있고 표준 티어는 무료다 | 자격증명 교체가 자동화되어 있지 않다 |
2.6 Iceberg 와 Paimon 을 나눈 이유
Lake 포맷을 두 개나 쓴 데에는 이유가 있습니다. Iceberg 는 "무슨 일이 있었나" 를 쌓는 데 쓰고, Paimon 은 "지금 어떤가" 를 유지하는 데 썼습니다.
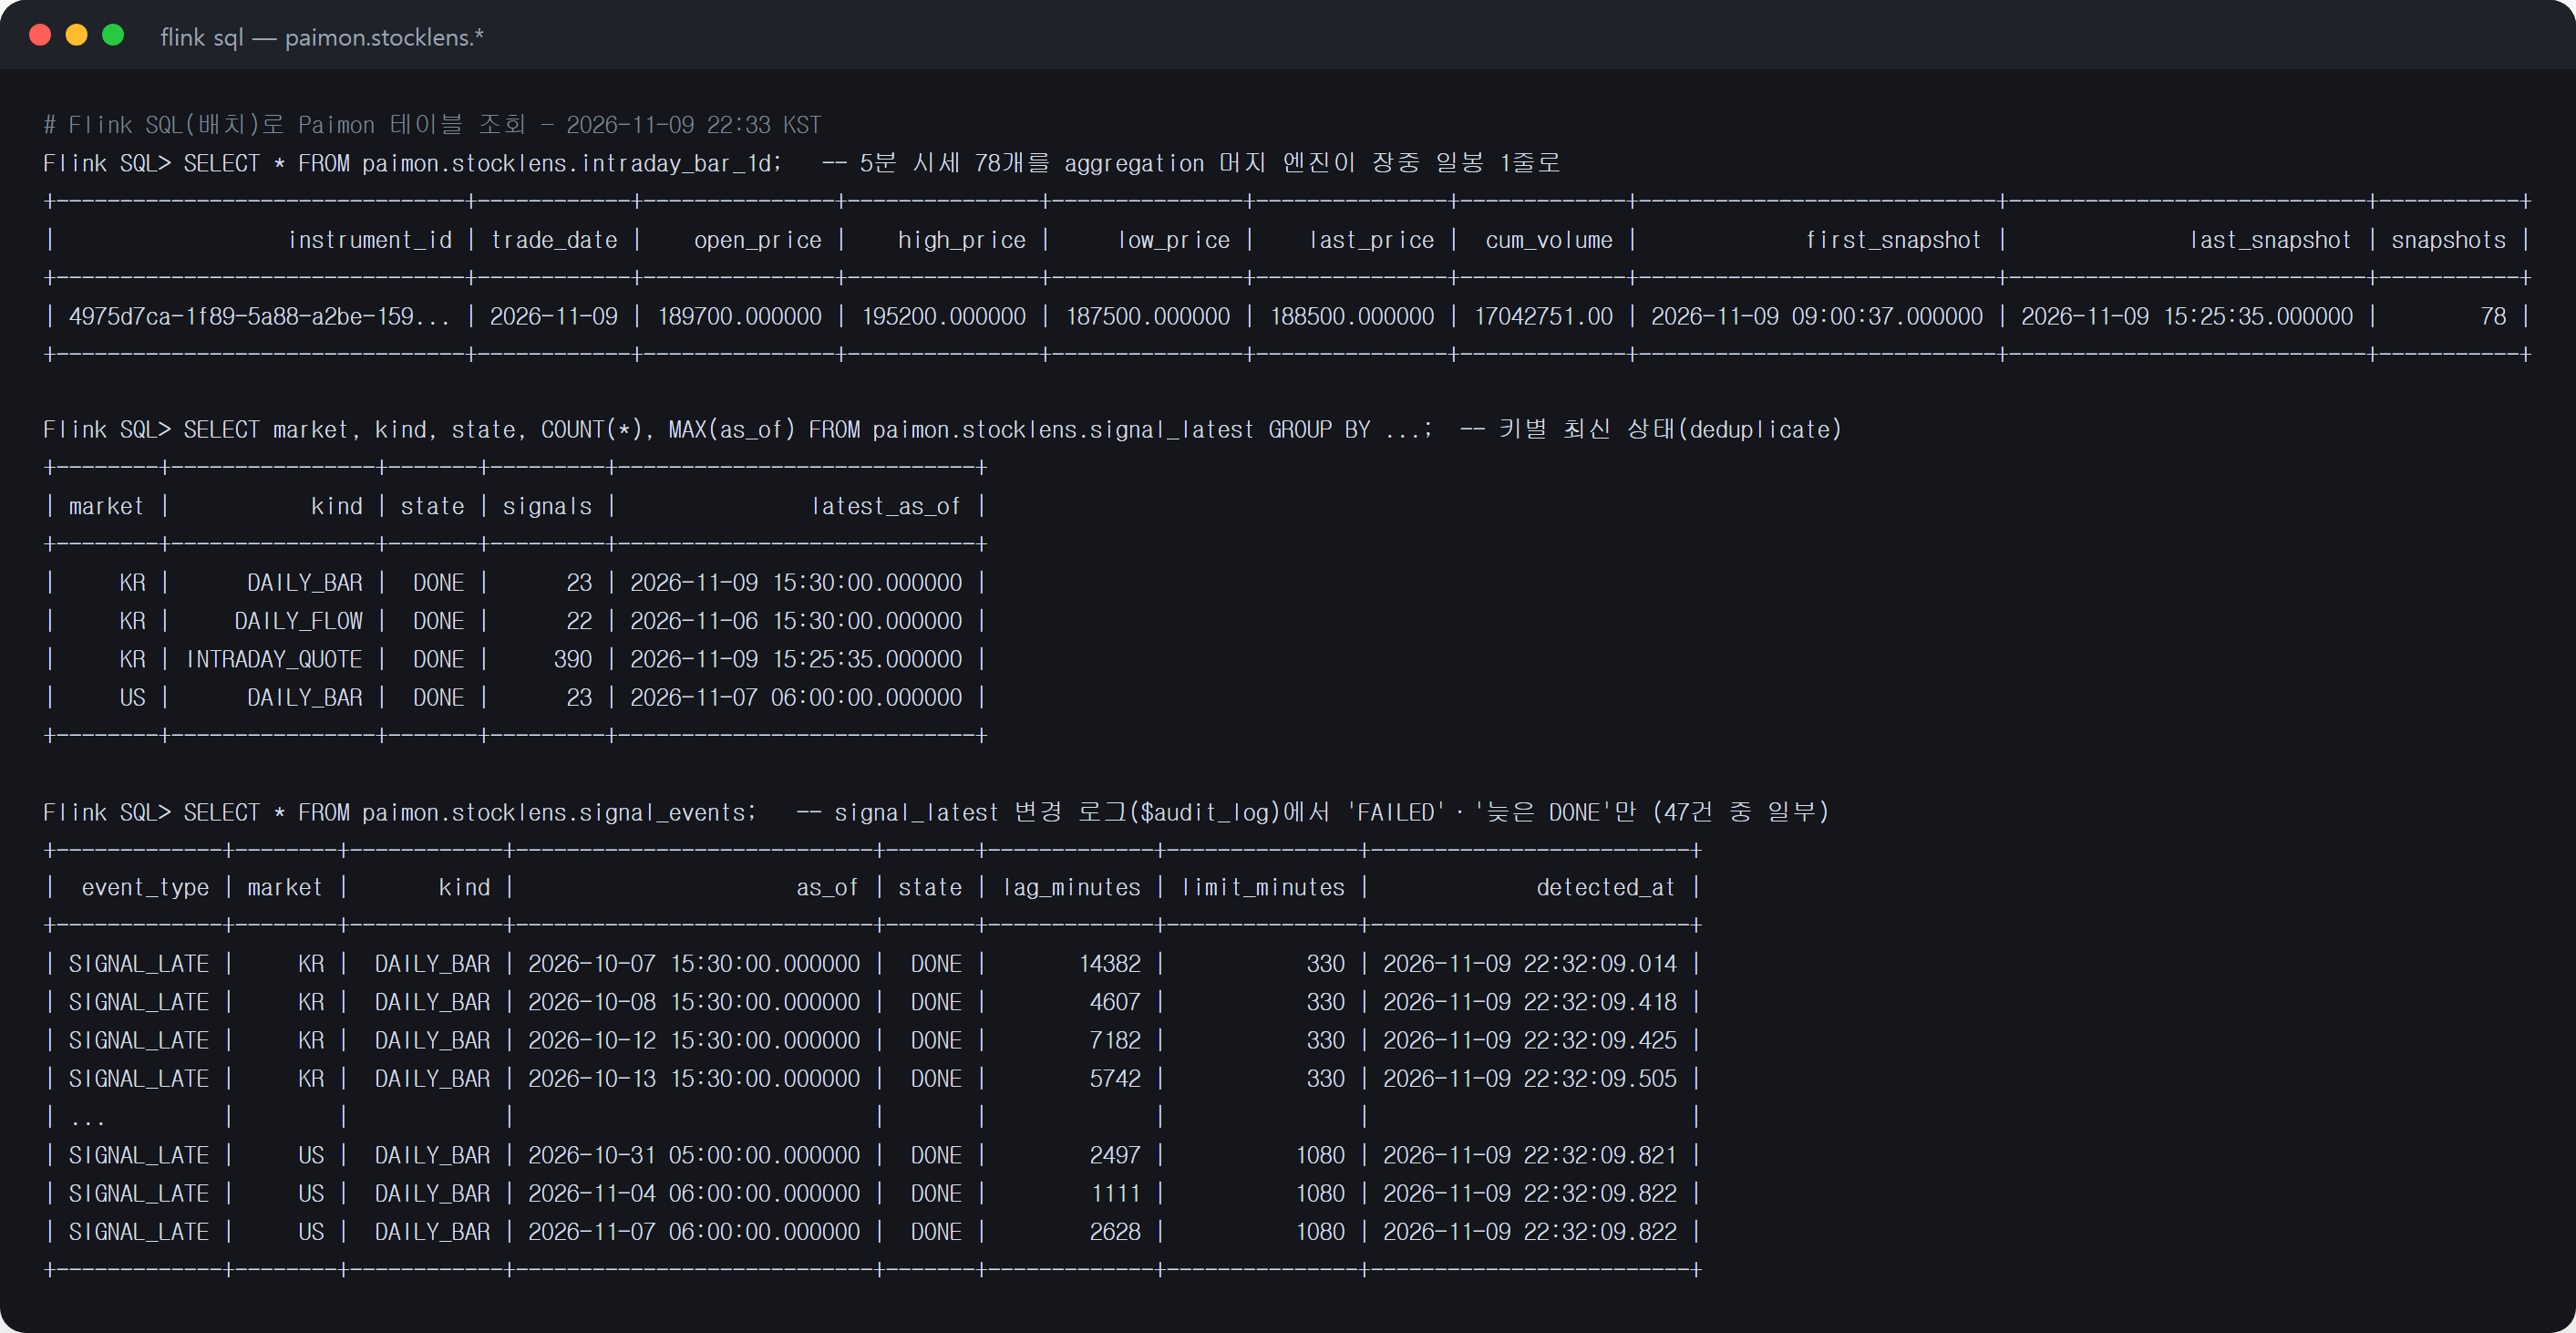
Paimon 이 필요했던 일은 두 가지였습니다. 하나는 5분마다 들어오는 시세를 종목별 장중 일봉(시가, 고가, 저가, 현재가)으로 계속 합쳐 두는 것이고, 다른 하나는 완료 신호가 FAILED 가 되거나 늦게 DONE 이 되는 순간을 이벤트로 받는 것이었습니다. 이 두 가지를 하려면 테이블이 세 가지를 해줘야 했습니다.
- 같은 키로 계속 들어오는 값을 필드마다 다른 규칙으로 합칠 것 (시가는 첫 값, 고가는 최댓값)
- 합쳐진 결과를 SQL 로 바로 조회할 수 있을 것
- 결과가 바뀔 때마다 그 변경을 다시 스트림으로 읽을 수 있을 것
| 후보 | 필드별 병합 | 바로 조회 | 변경 스트림 | 결과 |
|---|---|---|---|---|
| Iceberg upsert | 직접은 안 됨 | 됨 | 안 됨 | 덮어쓰기와 삭제가 섞인 테이블은 Flink 가 스트림으로 읽지 못한다 |
| 앱 DB 에 상태 테이블 | 됨 | 됨 | CDC 를 한 번 더 돌려야 함 | 서비스 DB 에 스트림 쓰기 부하가 붙는다 |
| Flink Job 상태만 사용 | 됨 | 안 됨 | Job 안에서만 | 운영자가 밖에서 볼 수 없다 |
| Kafka 압축 Topic | 안 됨 | 안 됨 | 됨 | 키별 마지막 값만 남는다 |
| Paimon 기본 키 테이블 | 됨 | 됨 | 됨 | 선택 |
결정적이었던 것은 세 번째 조건입니다. Iceberg 는 이력을 쌓는 데는 좋지만 갱신되는 테이블의 변경을 스트림으로 내보내지 못합니다. Paimon 은 같은 키의 새 값이 들어오면 Merge Engine 이 합쳐 주고, 합치기 전 값과 새 값을 짝지어 변경 로그로 내보내 주기 때문에, 같은 S3 위에서 상태 테이블과 그 상태의 변경 스트림을 한 번에 가질 수 있었습니다.
반대로 이력 적재까지 Paimon 으로 옮기지 않은 이유는, 배치 파이프라인이 이미 Iceberg 위에 있었고 Trino 와 Athena 로 바로 조회되고 있었기 때문입니다. 그래서 쌓아 두고 분석하는 데이터는 Iceberg, 계속 갱신되면서 변경에 반응해야 하는 데이터는 Paimon 으로 역할을 나눴습니다.
3. 구현 과정
설계는 7월부터 시작했고, 구현은 9월 말부터 11월 중순까지 약 8주 동안 했습니다. 단계별로 무엇을 했는지를 설계 문서와 Commit 이력 기준으로 정리하면 다음과 같습니다.
| 단계 | 기간 | 한 일 |
|---|---|---|
| 설계 | 7월 ~ 9월 중순 | 기능 정의, 아키텍처와 기술 스택 설계, 필요한 기술 공부, 팀 설계 맞추기 |
| 1주차 | 9/21 ~ 9/27 | 파이프라인 이미지와 CI, 계좌 수집, Iceberg Catalog 확정 |
| 2주차 | 9/28 ~ 10/4 | 역할 분담, 시장 영업일 캘린더, 일일 배치 DAG |
| 3주차 | 10/5 ~ 10/11 | 환율, 일봉 백필, 알림용 데이터와 reverse ETL, 완료 신호 |
| 4주차 | 10/12 ~ 10/18 | 미국 전 종목 확대에 따른 OOM · 부분 적재 수정 |
| 5주차 | 10/19 ~ 10/25 | 미국 완료 신호 보정, 수집 호출 간격 조정 |
| 6주차 | 10/26 ~ 11/1 | 실전 · 모의 계좌 구분, 데이터 품질 전수 점검과 복구 |
| 7주차 | 11/2 ~ 11/8 | Grafana 대시보드, Prometheus 알림 규칙, Trino Catalog |
| 8주차 | 11/9 ~ 11/14 | CDC 이력 적재, Paimon, Lake 정비, 최적화 |
3.1 설계 (7월 ~ 9월 중순)
구현에 들어가기 전에 두 달 넘게 설계를 했습니다. 먼저 만들고 싶은 기능을 계좌 통합, 매수/매도 알림, ETF Look-through, 뉴스 해석, 장기투자 백테스트 다섯 가지로 정리하고, 기능마다 어떤 데이터가 어떤 주기로 필요한지를 문서로 적었습니다.
아키텍처는 Lambda 와 Medallion 을 겹치는 구조로 잡았습니다. 실시간 경로는 Kafka 와 Spark Structured Streaming 이 맡고, 배치 경로는 Airflow 와 Spark, dbt 가 S3 위 Iceberg 의 bronze → silver → gold 를 채우며, 서빙은 Trino 와 PostgreSQL 이 맡는 그림이었습니다. 설계를 하면서 이 스택에 필요한 기술들도 같이 공부했습니다.
8월에는 백엔드를 맡은 팀원이 화면과 API 스펙을 확정해 가면서, 데이터 쪽이 넘겨줘야 할 테이블과 팀 사이의 경계를 맞추는 작업을 했습니다. 그리고 9월에 실제 요구사항(일 단위 시세, 5분 단위 알림, 하루 한 번 계좌 수집)을 받고 나서는 처음 설계에서 많은 부분을 덜어내게 되었는데, 2장의 설계 기준은 이 과정에서 정리된 것입니다.
3.2 1주차 : 파이프라인 이미지와 계좌 수집
Airflow Task 가 쓸 파이프라인 이미지와 ECR 빌드 Workflow 를 만들고 계좌 수집(KIS · CODEF)의 bronze → silver 를 먼저 붙였습니다. Kubernetes 클러스터와 Kafka · Flink 같은 스트리밍 스택은 이보다 앞선 9월에 초기 설계에 따라 올라가 있었습니다.
이 주에 Iceberg Catalog 를 하루 만에 두 번 바꾸게 됩니다. 처음에는 클러스터 안의 PostgreSQL JDBC Catalog 를 썼는데 클러스터가 꺼지면 Catalog 도 같이 꺼진다는 문제가 있었습니다. 같은 날 AWS Glue Data Catalog 로 옮겼고 클러스터가 꺼져 있어도 Athena 로 조회할 수 있게 되었습니다.
3.3 2주차 : 시장 영업일 캘린더와 일일 배치 DAG
10월 4일에 팀에서 파이프라인을 둘로 나눴습니다. 종목 마스터와 기업행위, ETF 구성종목은 팀원이 맡고 저는 환율, 시장 영업일 캘린더, 시세, 백엔드 DB 스냅샷을 맡았습니다.
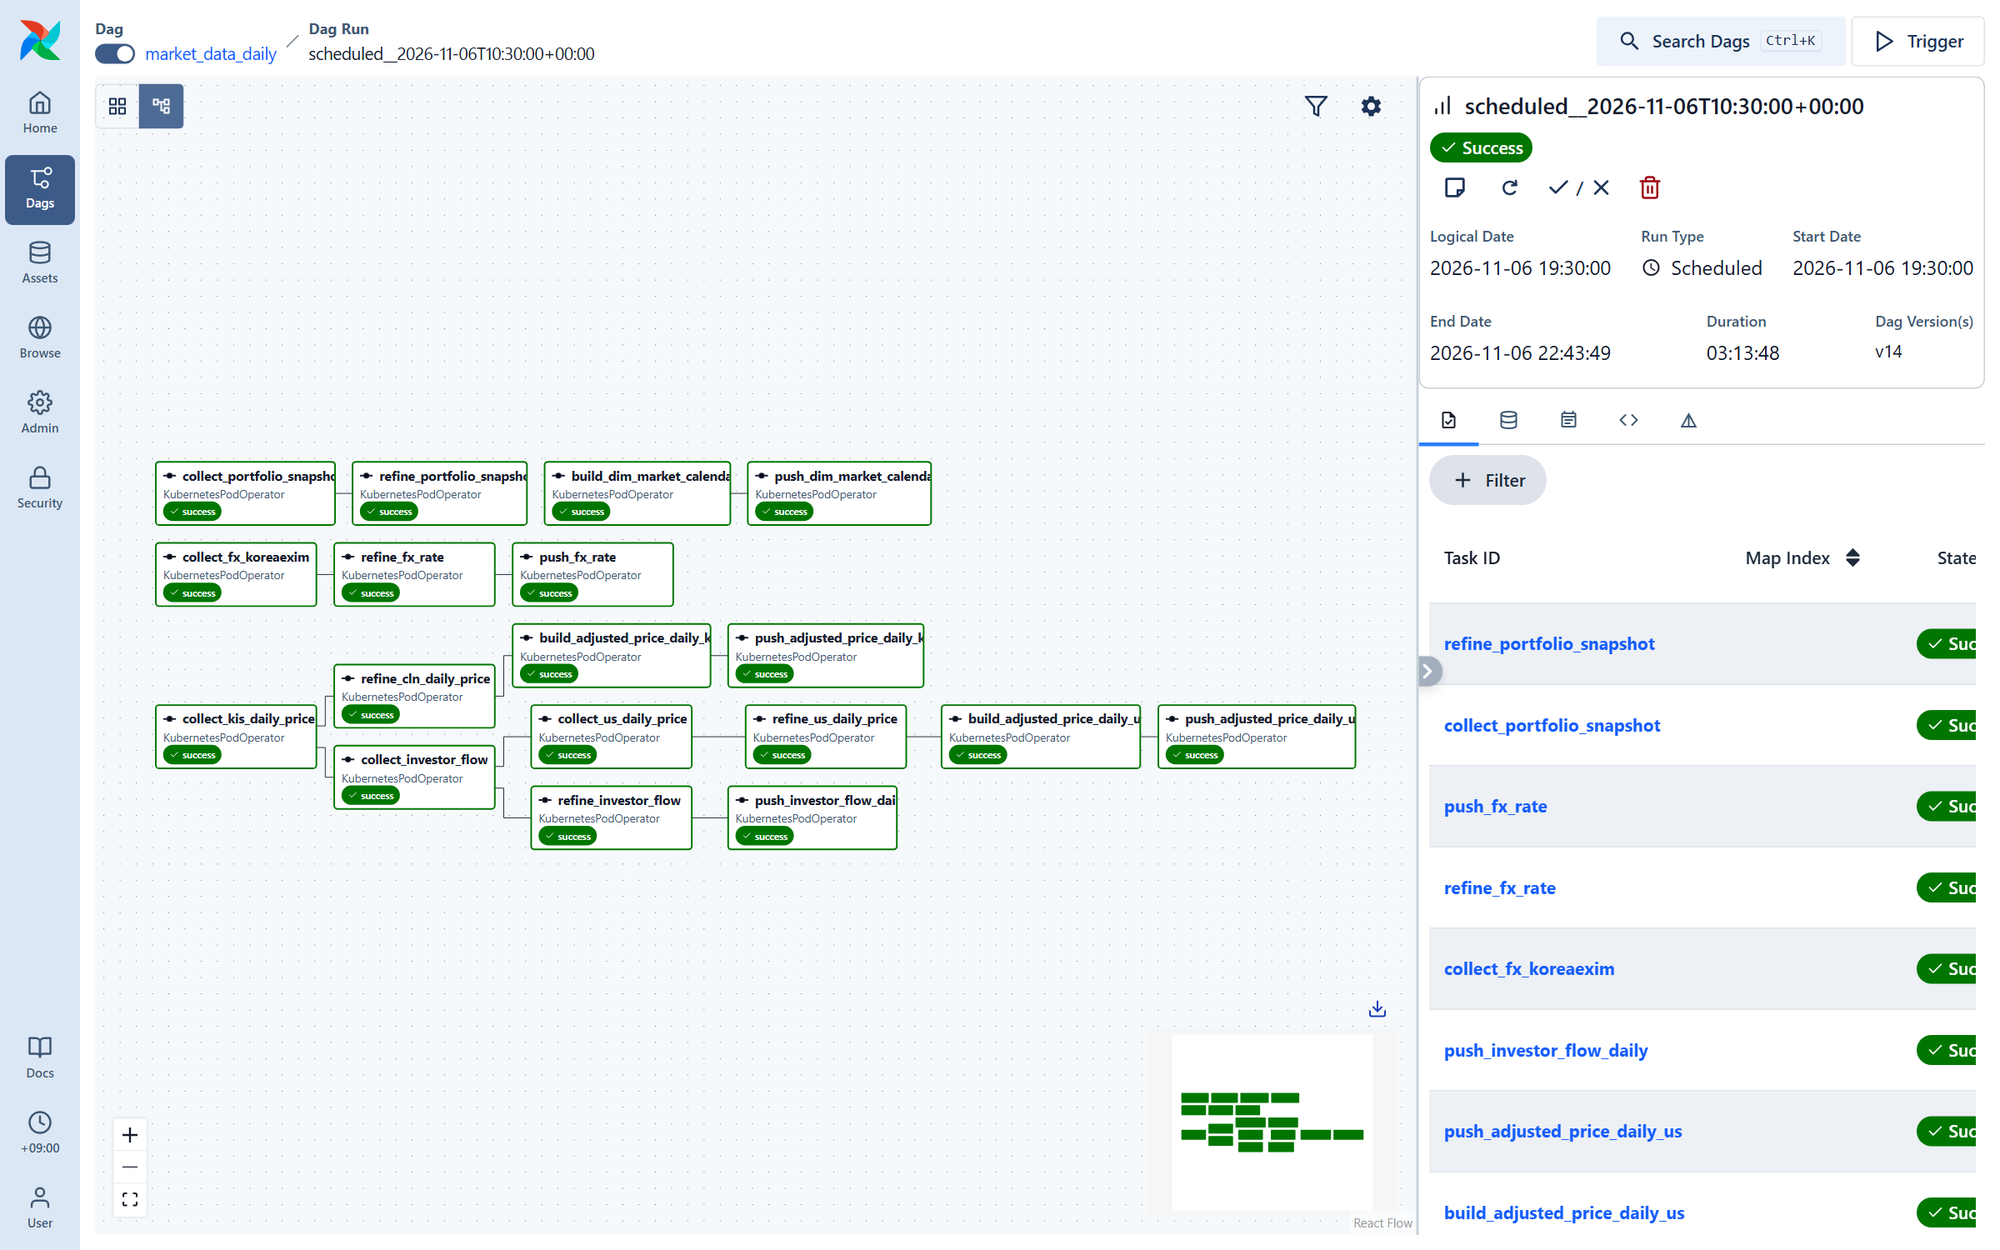
이 주에는 시장 영업일 캘린더와 일일 배치 DAG market_data_daily 를 만들었습니다. 이후에 추가되는 Task 는 모두 이 DAG 에 붙게 됩니다.
3.4 3주차 : 시세 · 환율 수집과 reverse ETL
가장 많은 것을 만든 주입니다. 환율은 수출입은행 매매기준율로 확정했고 KIS 일봉 300거래일 백필과 백엔드 DB 일일 스냅샷을 넣었습니다. 주 후반에는 알림에 쓸 데이터인 수정주가, 투자자 수급, 미국 일봉, 장중 스냅샷과 reverse ETL, 완료 신호까지 한 번에 붙였습니다.
이때 KIS 의 호출 한도가 DAG 모양을 정하게 됩니다. KIS 는 앱키 하나당 초당 호출 수가 제한되어 있어서 국내 일봉 · 수급 · 미국 일봉 수집을 동시에 돌리면 500 오류가 쏟아졌습니다. 결국 세 Task 를 직렬로 묶을 수밖에 없었습니다.
같은 주에 수정주가 이중 보정도 발견했습니다. KIS 국내 일봉은 이미 수정주가인데 여기에 기업행위 비율을 한 번 더 곱하고 있었고(64종목), 국내의 보정 계수를 1로 고정해서 해결했습니다.
3.5 4주차 : 미국 전 종목 확대
원래는 알림을 걸었거나 보유한 종목만 받는 설계였는데 10월 14일에 "해외 전체" 요구가 들어왔습니다. 미국 일봉이 약 410만 행으로 늘어나면서 정제 Pod 이 OOM 으로 죽었고 전량 재구축을 종목 묶음 단위로 나눠 처리하도록 바꿨습니다.
Iceberg 쓰기 방식도 이 주에 바꿨습니다. pyiceberg 의 upsert 를 1,000행씩 나눠 호출하고 있었는데 수급 데이터 8만 행이면 Commit 이 80번 넘게 일어나 15분 실행 제한을 넘겼고 중간에 죽으면 그날 종목 일부만 남는 부분 적재가 생겼습니다. 대상 범위를 한 번 읽고 한 번에 덮어쓰는 방식으로 바꿔서 끝까지 가거나 아무것도 안 바뀌거나 둘 중 하나가 되도록 했습니다.
그 결과 하루 배치 약 3시간 중 미국 일봉 수집이 약 2시간(60% 이상) 을 차지하게 되었습니다. 병목은 외부 API 의 호출 한도였던 것입니다.
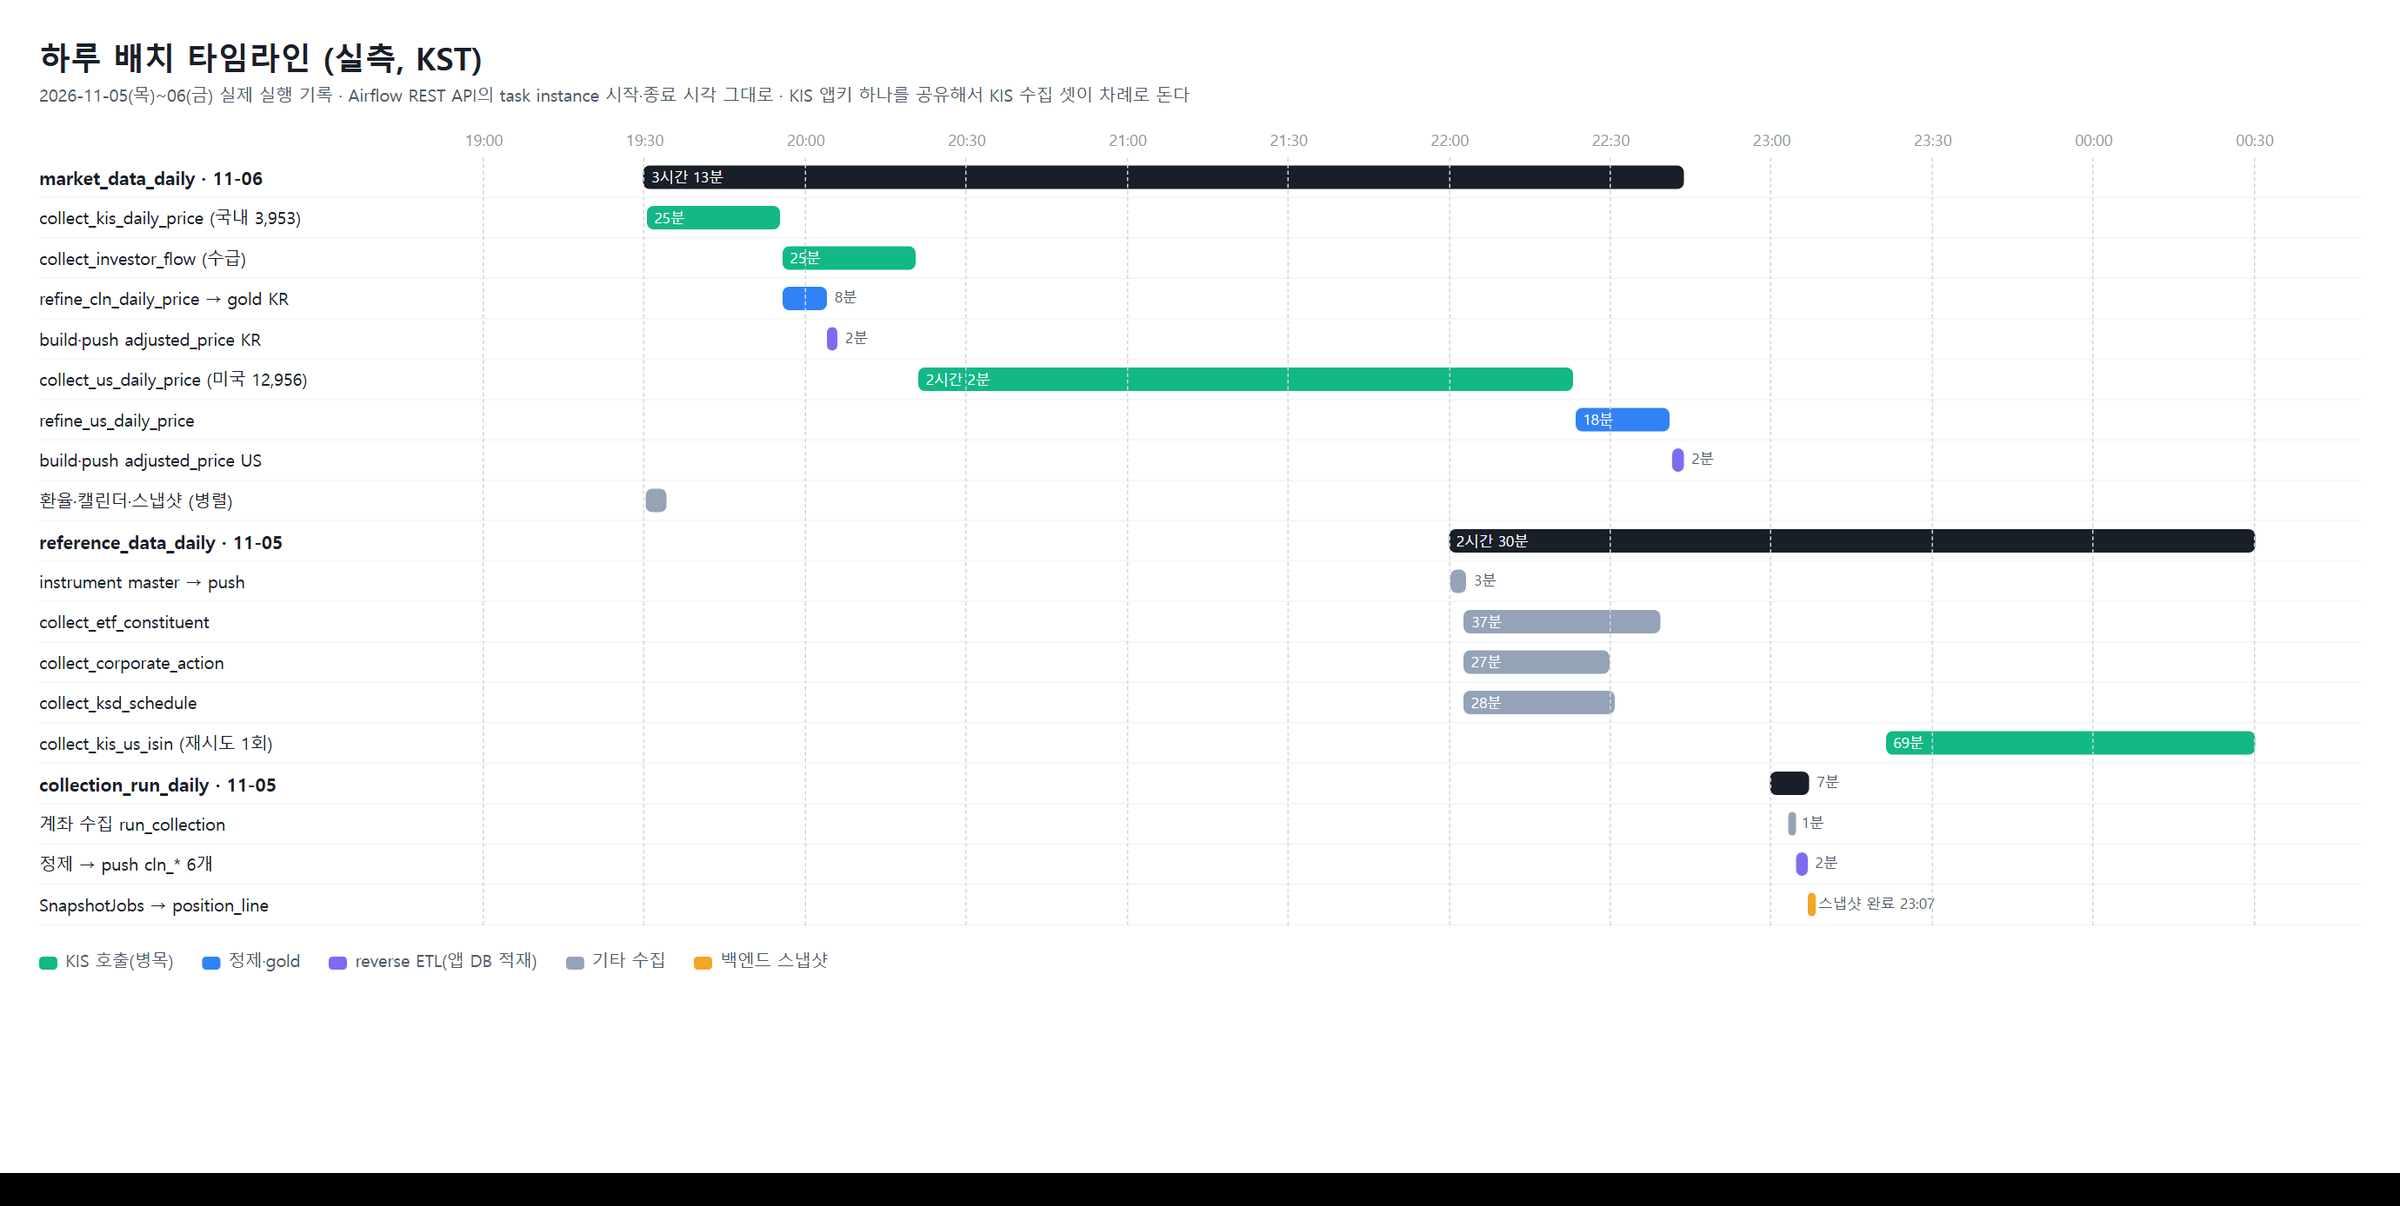
3.6 5주차 : 완료 신호 보정
완료 신호를 "전부 왔을 때만" 으로 올리고 나니, 상장폐지된 미국 종목 때문에 매일 FAILED 가 나는 문제가 생겼습니다. 원천에 더는 없는 종목은 대상에서 빼도록 하고 수집 호출 간격도 호출 시작 시각 기준으로 맞췄습니다.
3.7 6주차 : 데이터 품질 점검
실전 계좌와 모의 계좌를 계좌별로 구분해서 수집하도록 바꾸고 수집 로그에 계좌번호가 남던 문제를 고쳤습니다. 그리고 운영 데이터를 전수로 점검했는데 여기서 가장 까다로운 문제가 나왔습니다.
KIS 는 병합이나 무상증자가 생기면 과거 가격 전체를 소급해서 다시 보정하는데 저는 매일 최근 날짜만 수집하고 있었으니 Lake 에는 옛 기준 가격이 그대로 남아 있었던 것입니다. 1년 내 ±50% 가격 점프 45건으로 드러났고 이때 테스트는 전부 통과하고 있었습니다. 2.1 에서 말한 원본 보관 덕분에 복구가 가능했는데 원본에서 새 기준으로 과거를 다시 맞춘 뒤 gold 를 재생성할 수 있었습니다.
3.8 7주차 : 모니터링
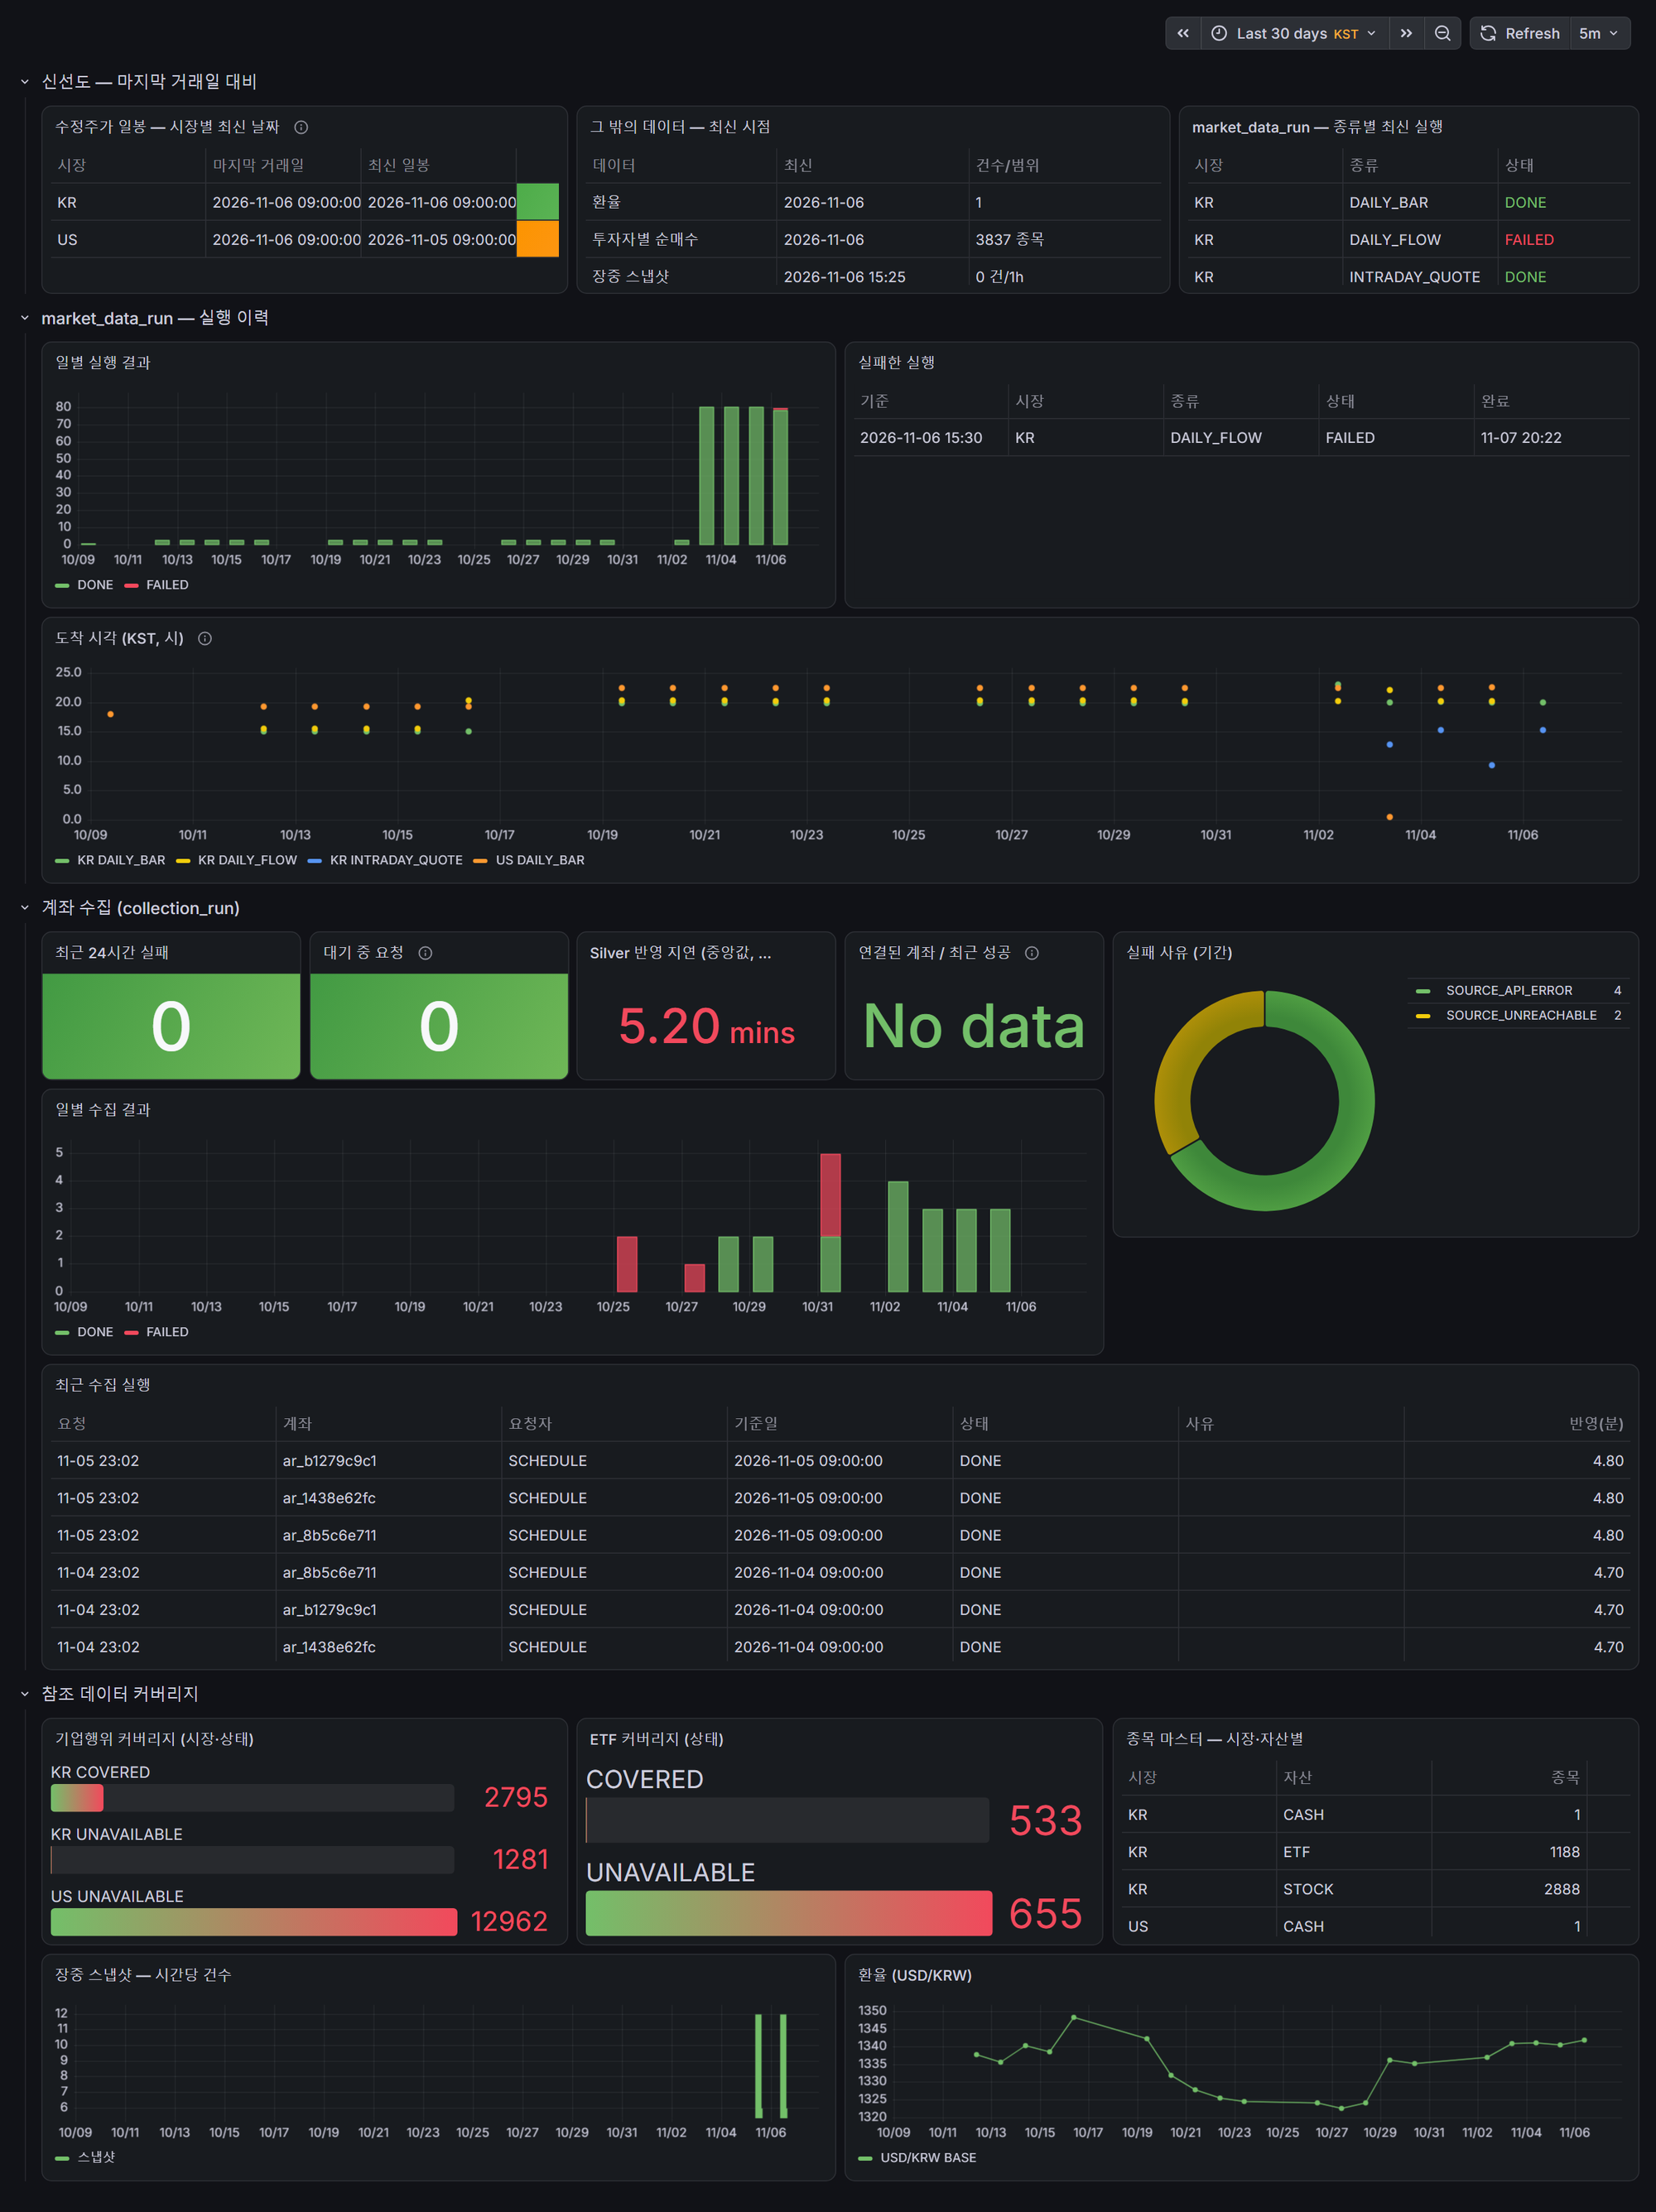
그동안은 노드와 Pod 의 자원만 보고 있었습니다. 이 주에 앱 DB 를 직접 읽는 Grafana 대시보드 4종과 Prometheus 알림 규칙 14개를 넣고 Trino 에 Lake 와 앱 DB Catalog 를 붙였습니다. 알림 규칙이 적용 직후에 무엇을 잡아냈는지는 4.5 에서 다룹니다.
3.9 8주차 : CDC 와 Lake 정비
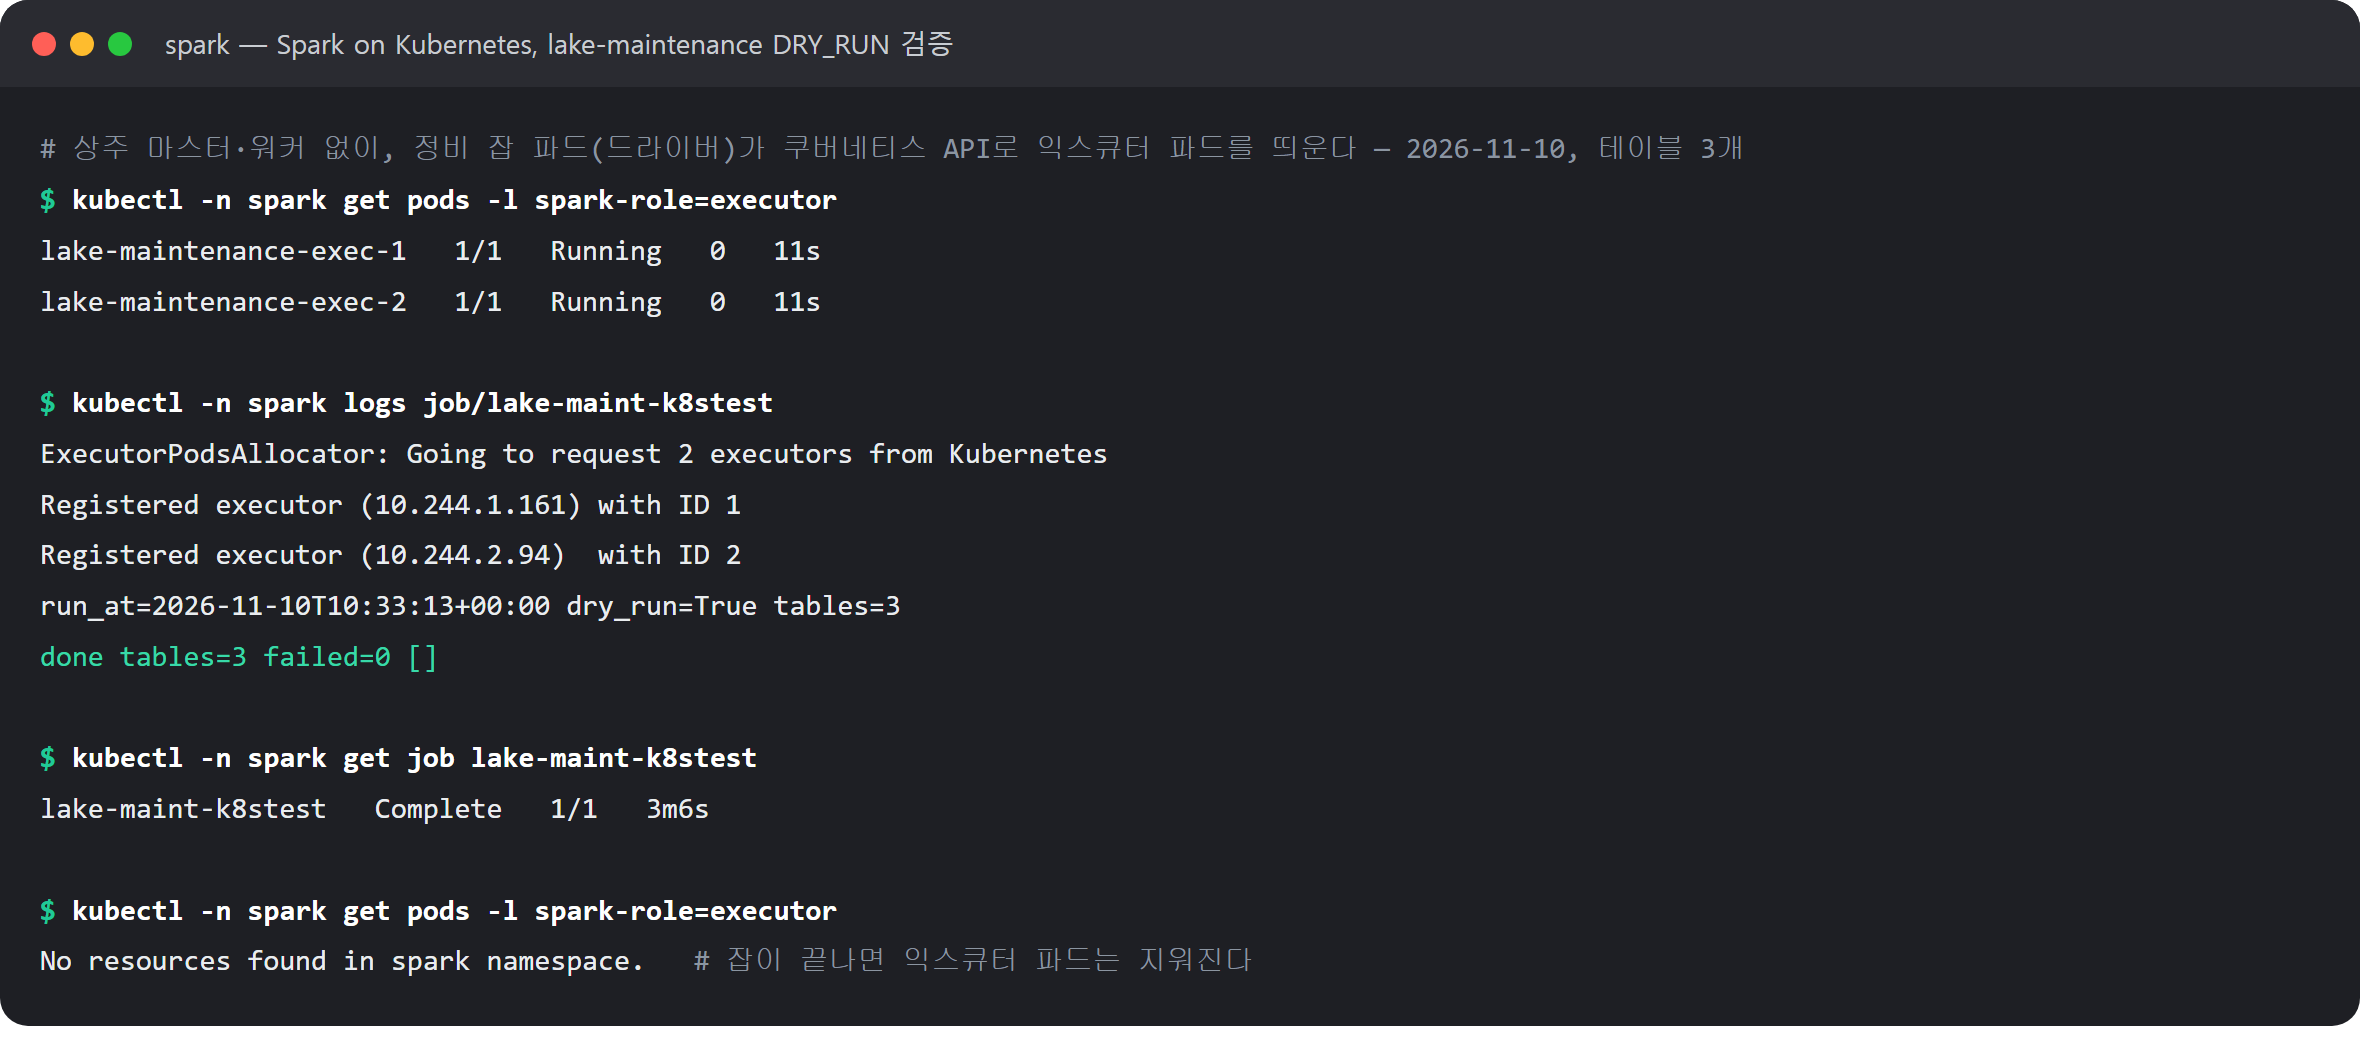
두 달 동안 일이 없던 Kafka · Flink · Spark 에 역할을 줬습니다. 앱 DB 의 변경 로그를 Iceberg 이력과 Paimon 상태 테이블로 보내고 Spark 로 Lake 정비(파일 합치기, Snapshot 만료)를 돌렸습니다. 운영 기록을 보고 손댄 최적화도 이 주에 했는데 5장에서 자세히 다룹니다.
4. 결과 (시나리오별)
사용자가 앱에서 하는 일을 하나씩 따라가며 결과를 정리했습니다.
4.1 계좌 동기화
버튼을 누르면 요청 → 수집 → 정제 → 앱 DB 반영 → 스냅샷 계산이 차례로 이어집니다.
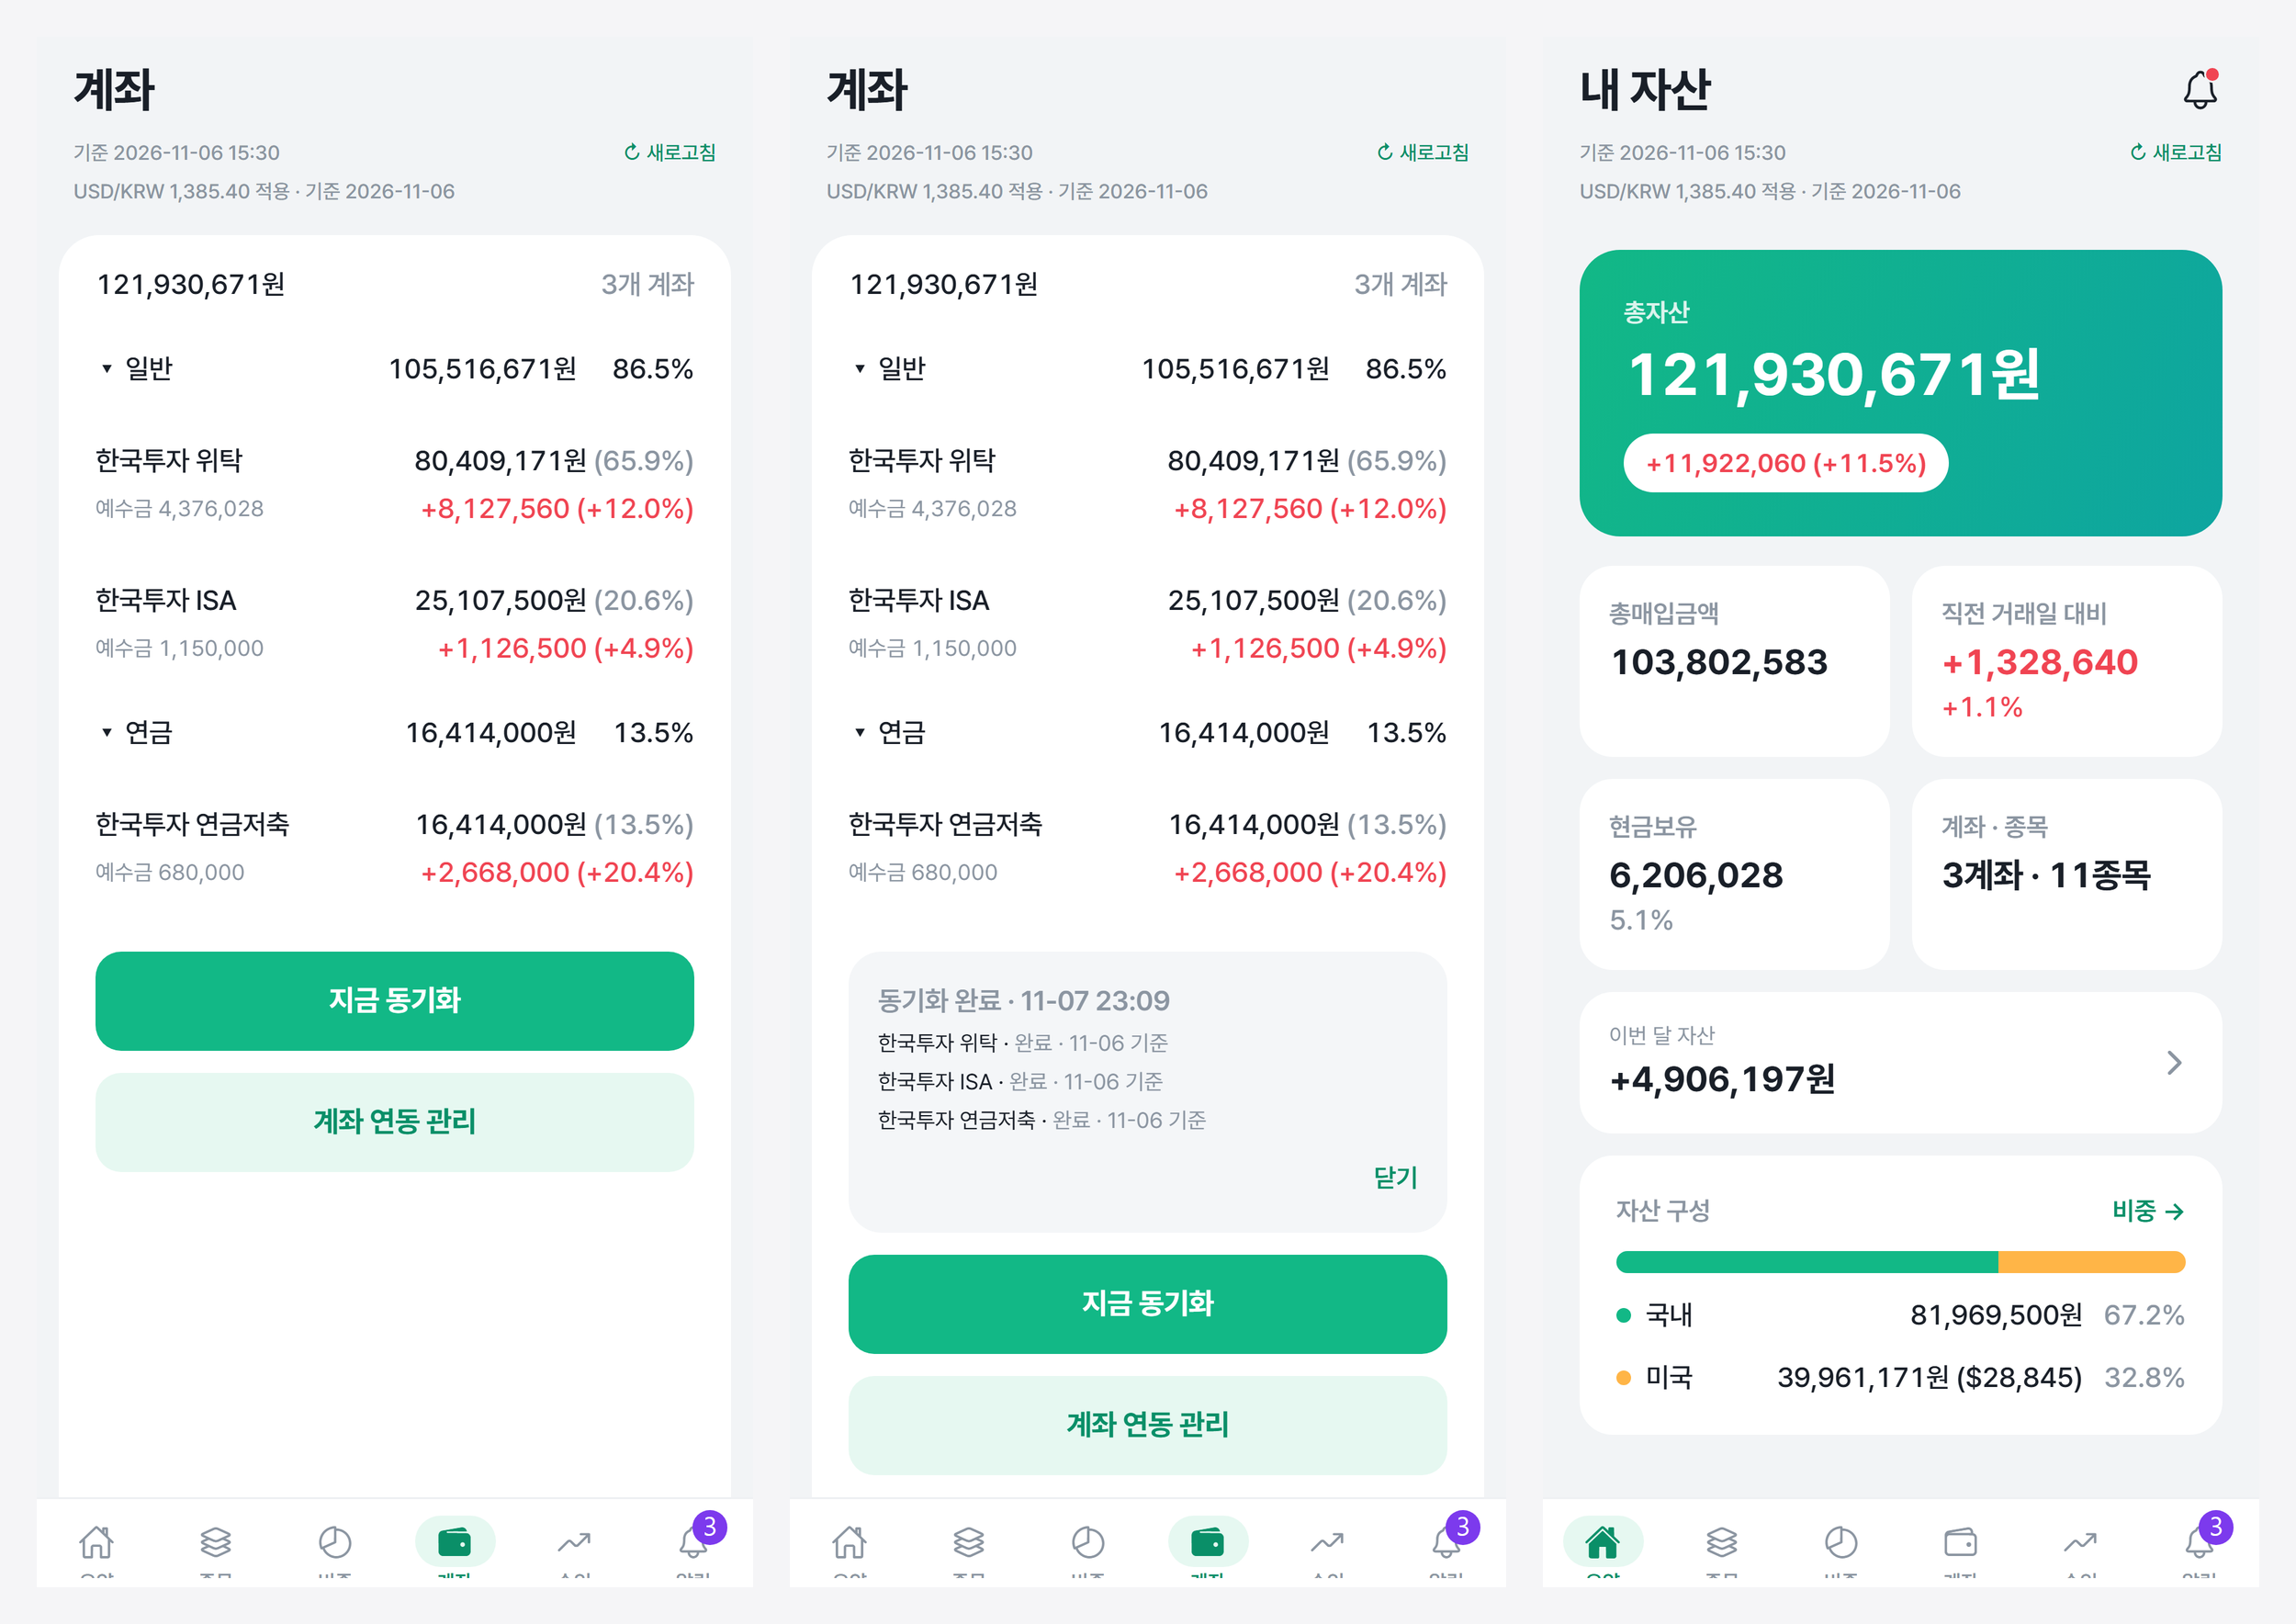
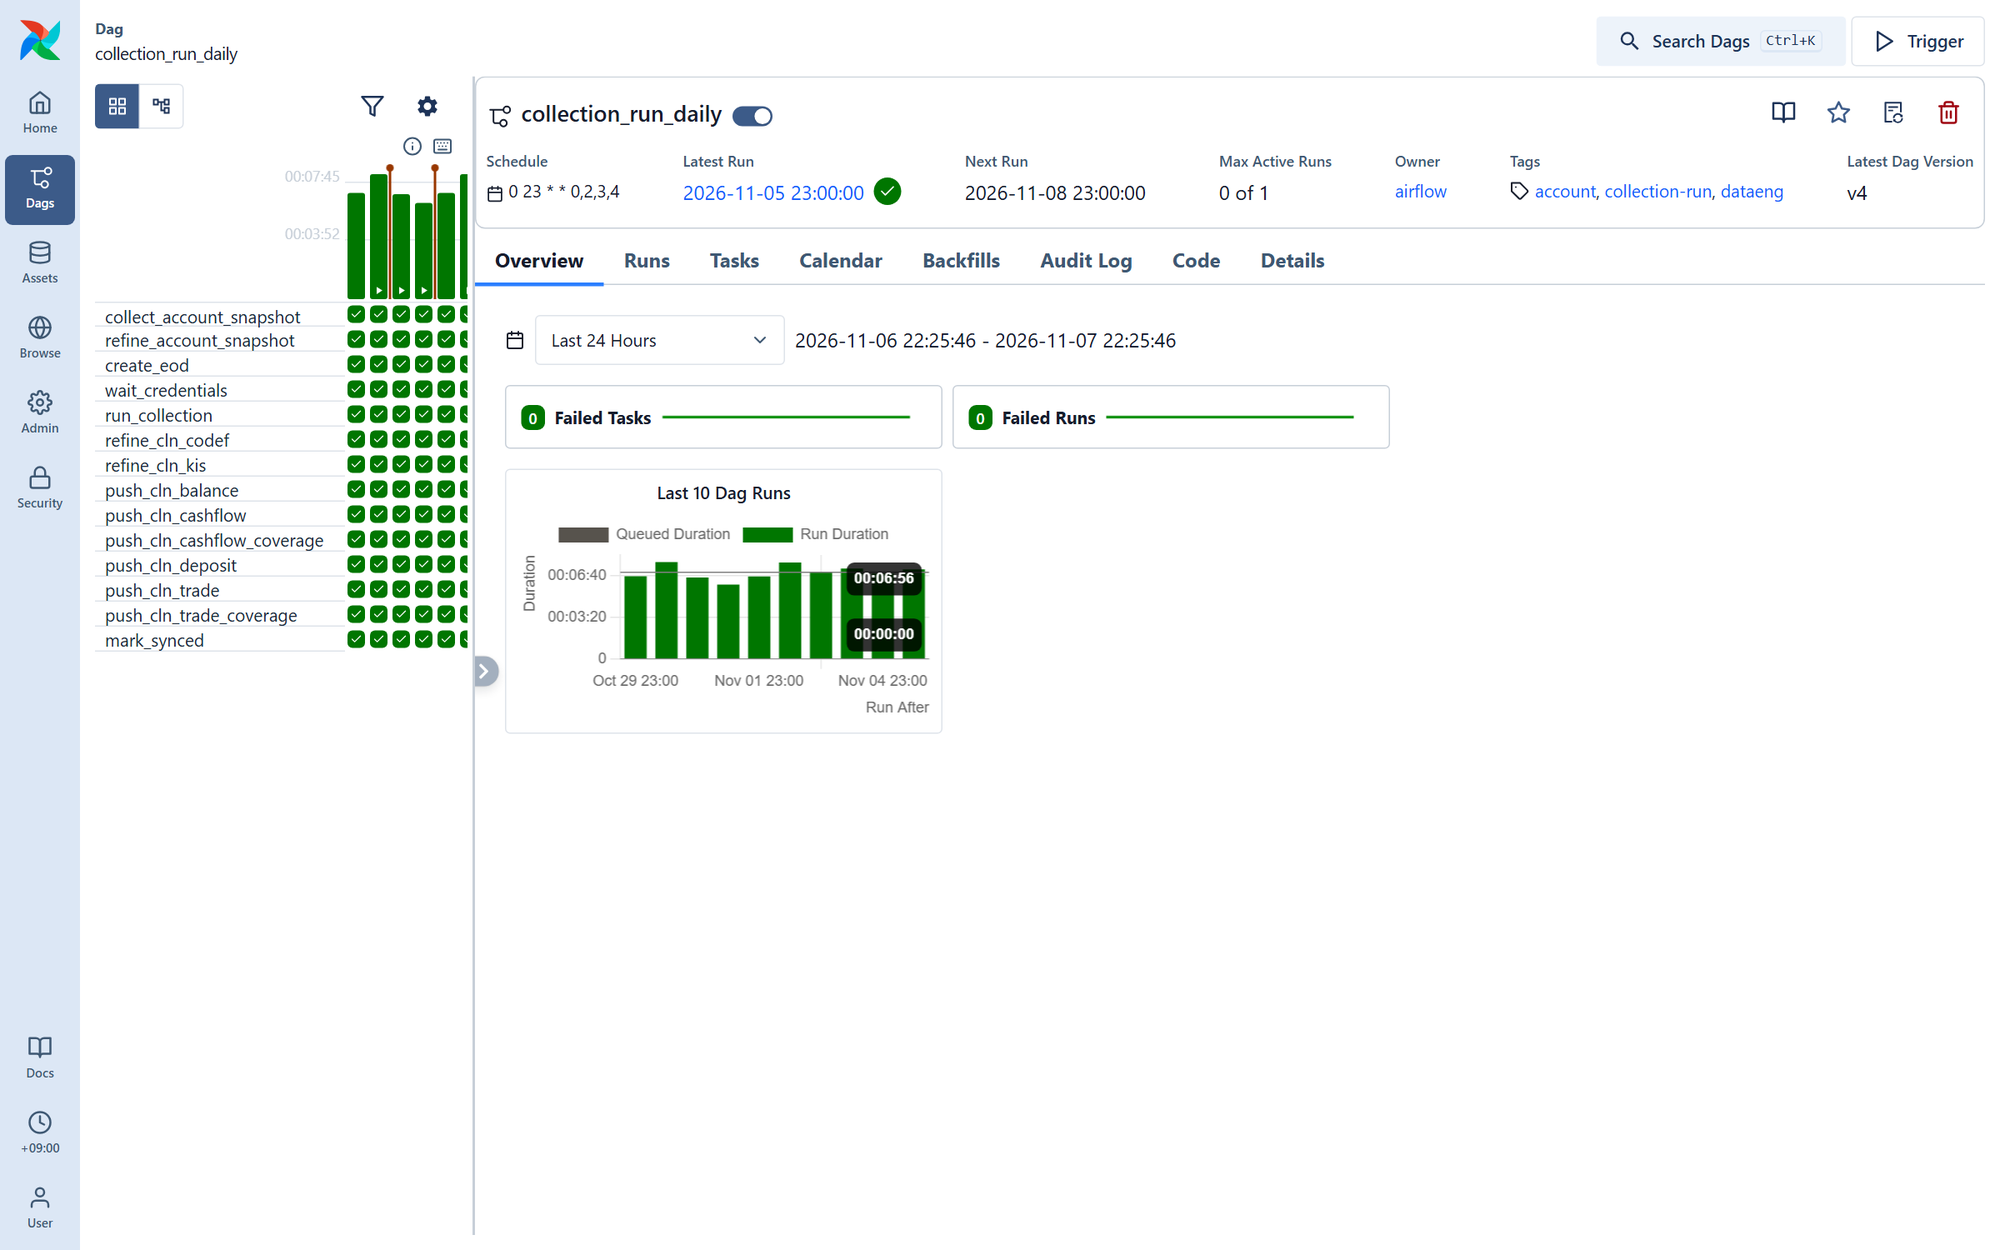
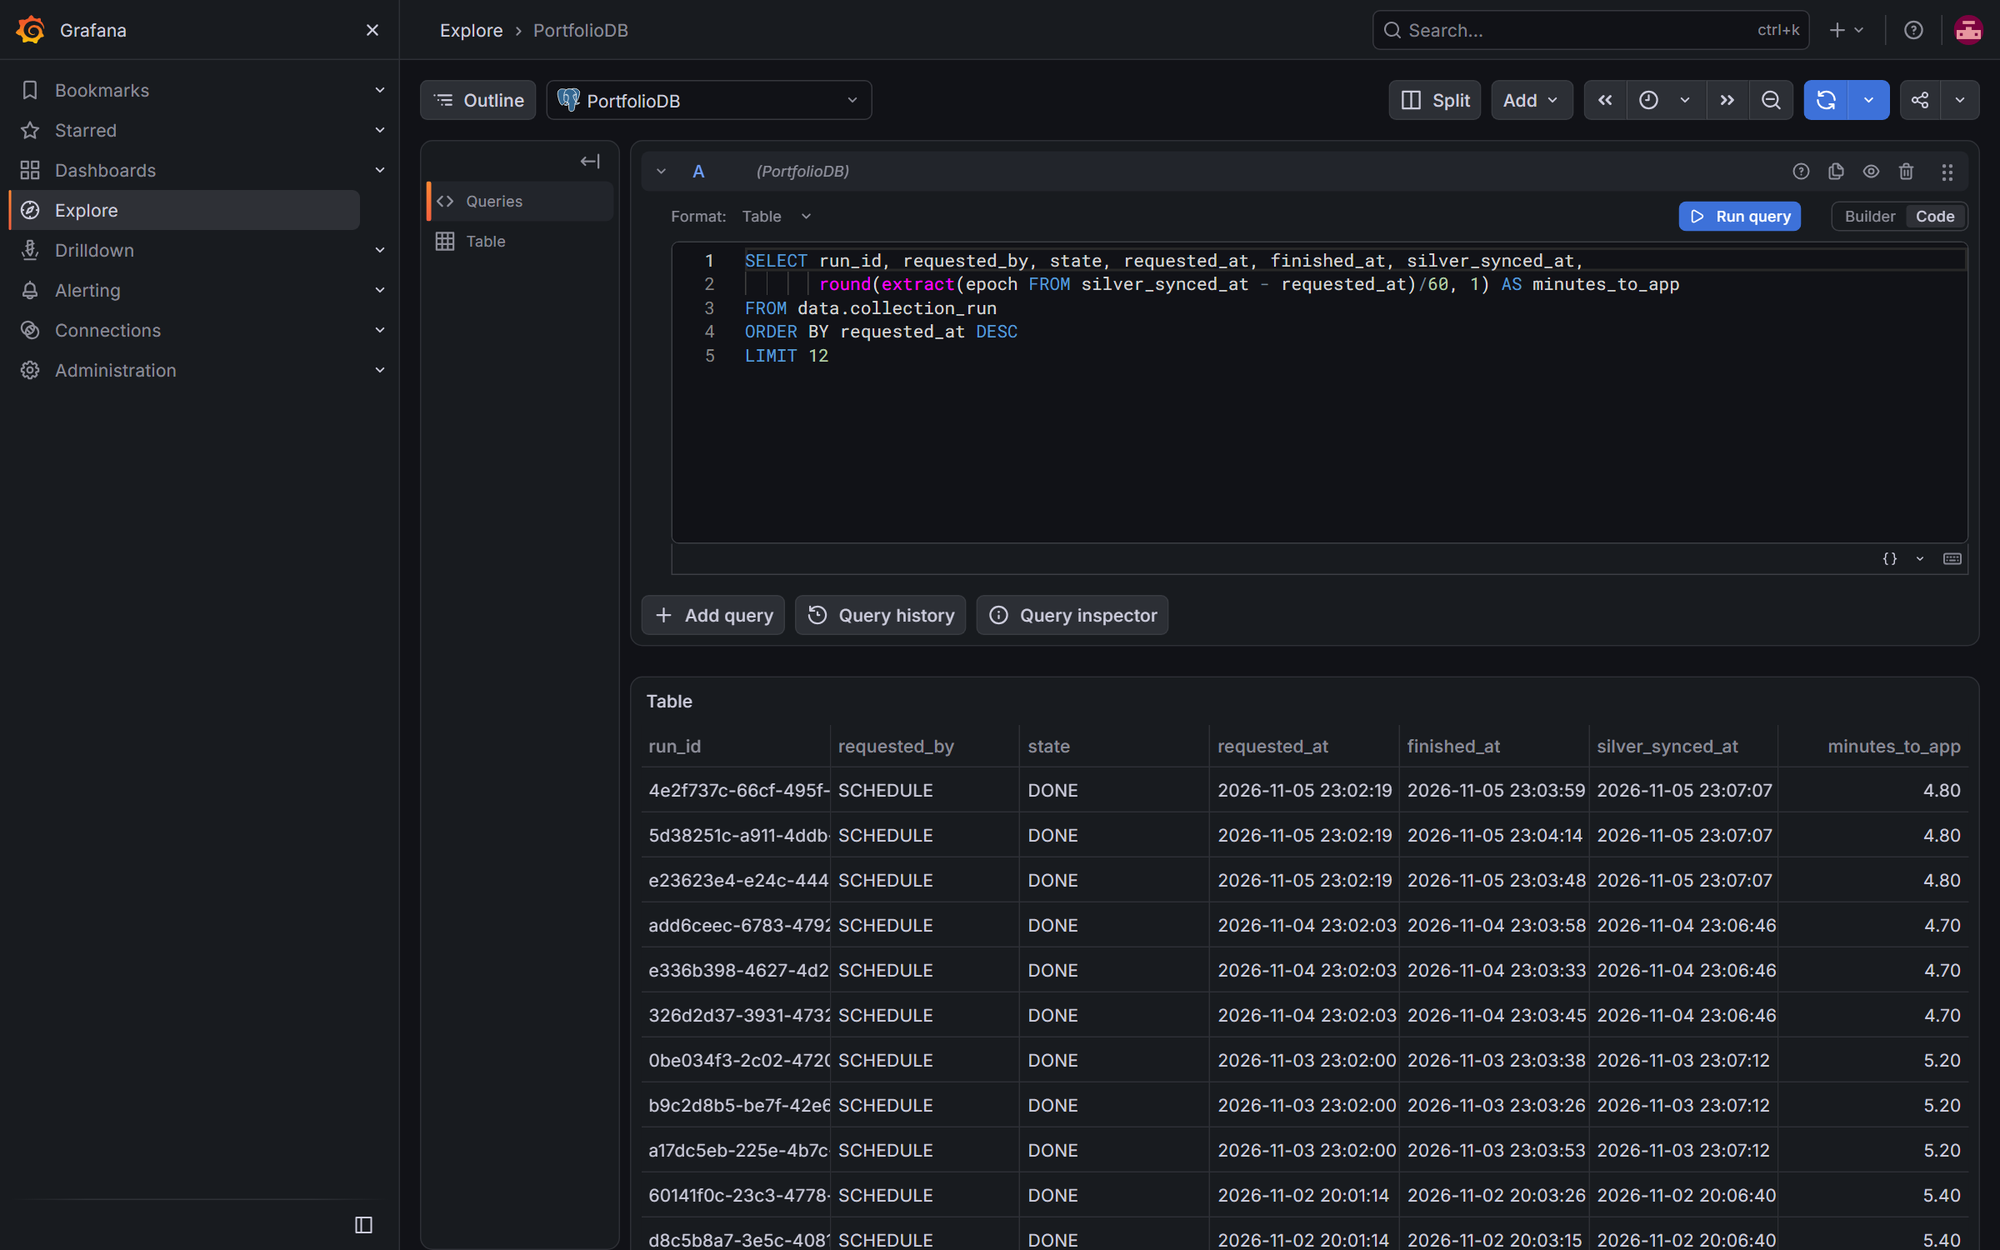
- 요청 → 앱 DB 반영 : p50 약 5분, 최대 약 9분
다만 이 5분은 배치 안에서 걸리는 시간입니다. 배치가 하루에 한 번이라 버튼을 누른 사용자는 최대 하루를 기다려야 하고 첫 테스트 피드백도 "동기화를 눌렀는데 계좌가 안 보인다" 였습니다. 이 부분은 설계상 한계로 남았습니다.
4.2 일일 시세 반영
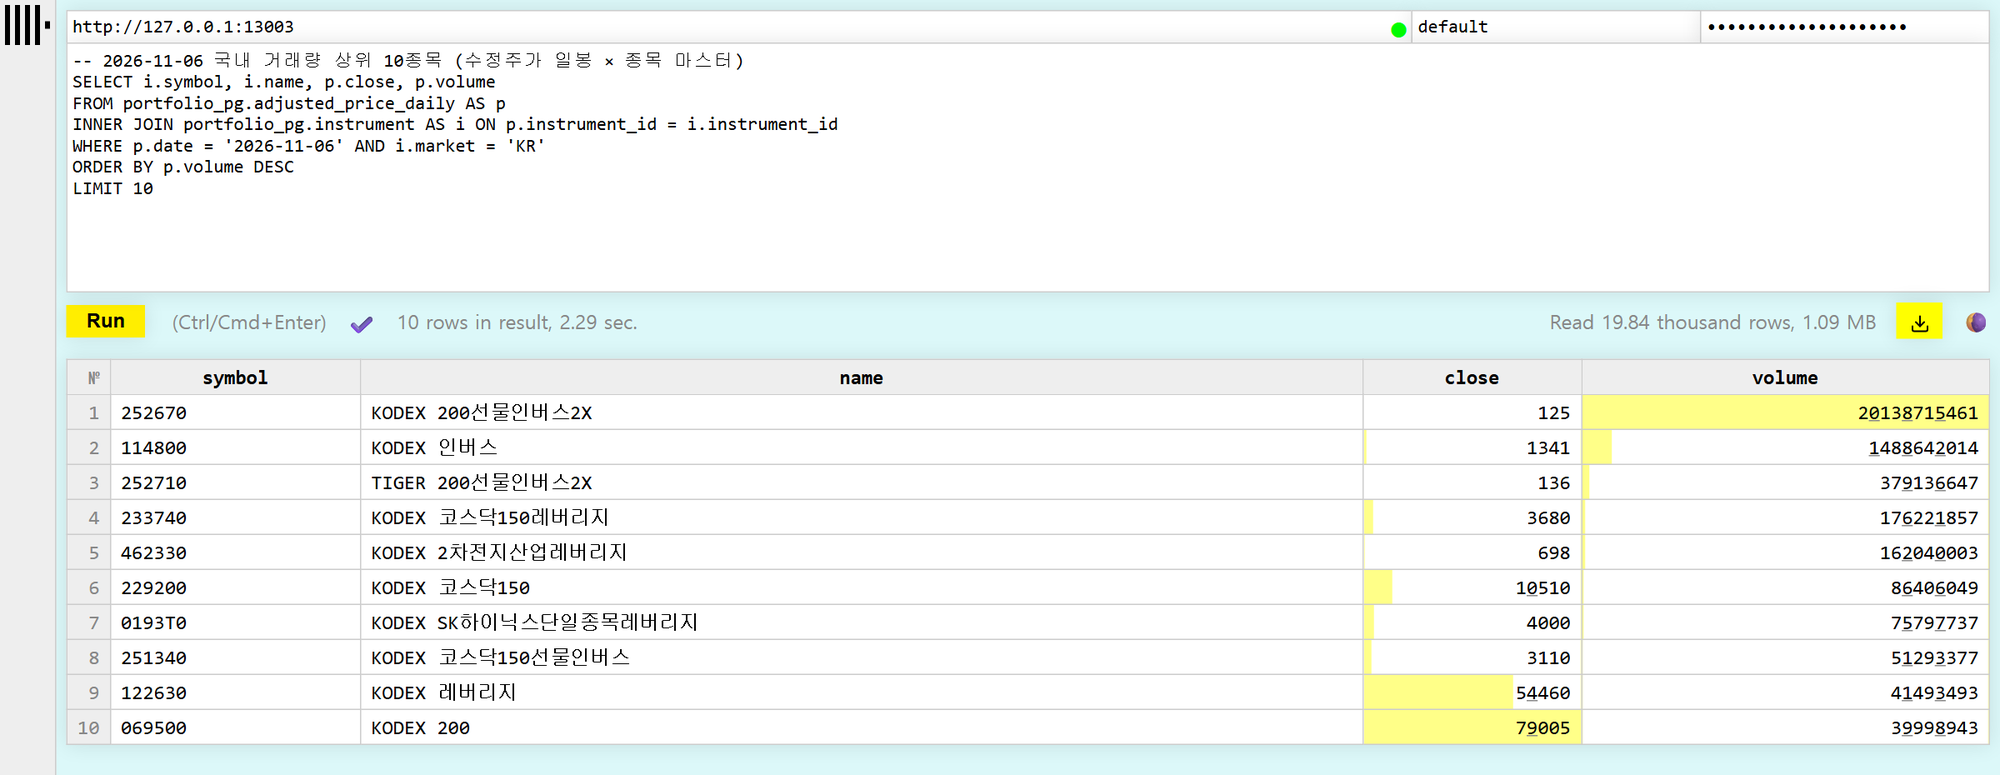
- 국내 일봉 도착 : 22거래일 중 22일
DONE, p50 20시 전후 - Lake gold 약 560만 행 = 앱 DB 같은 수
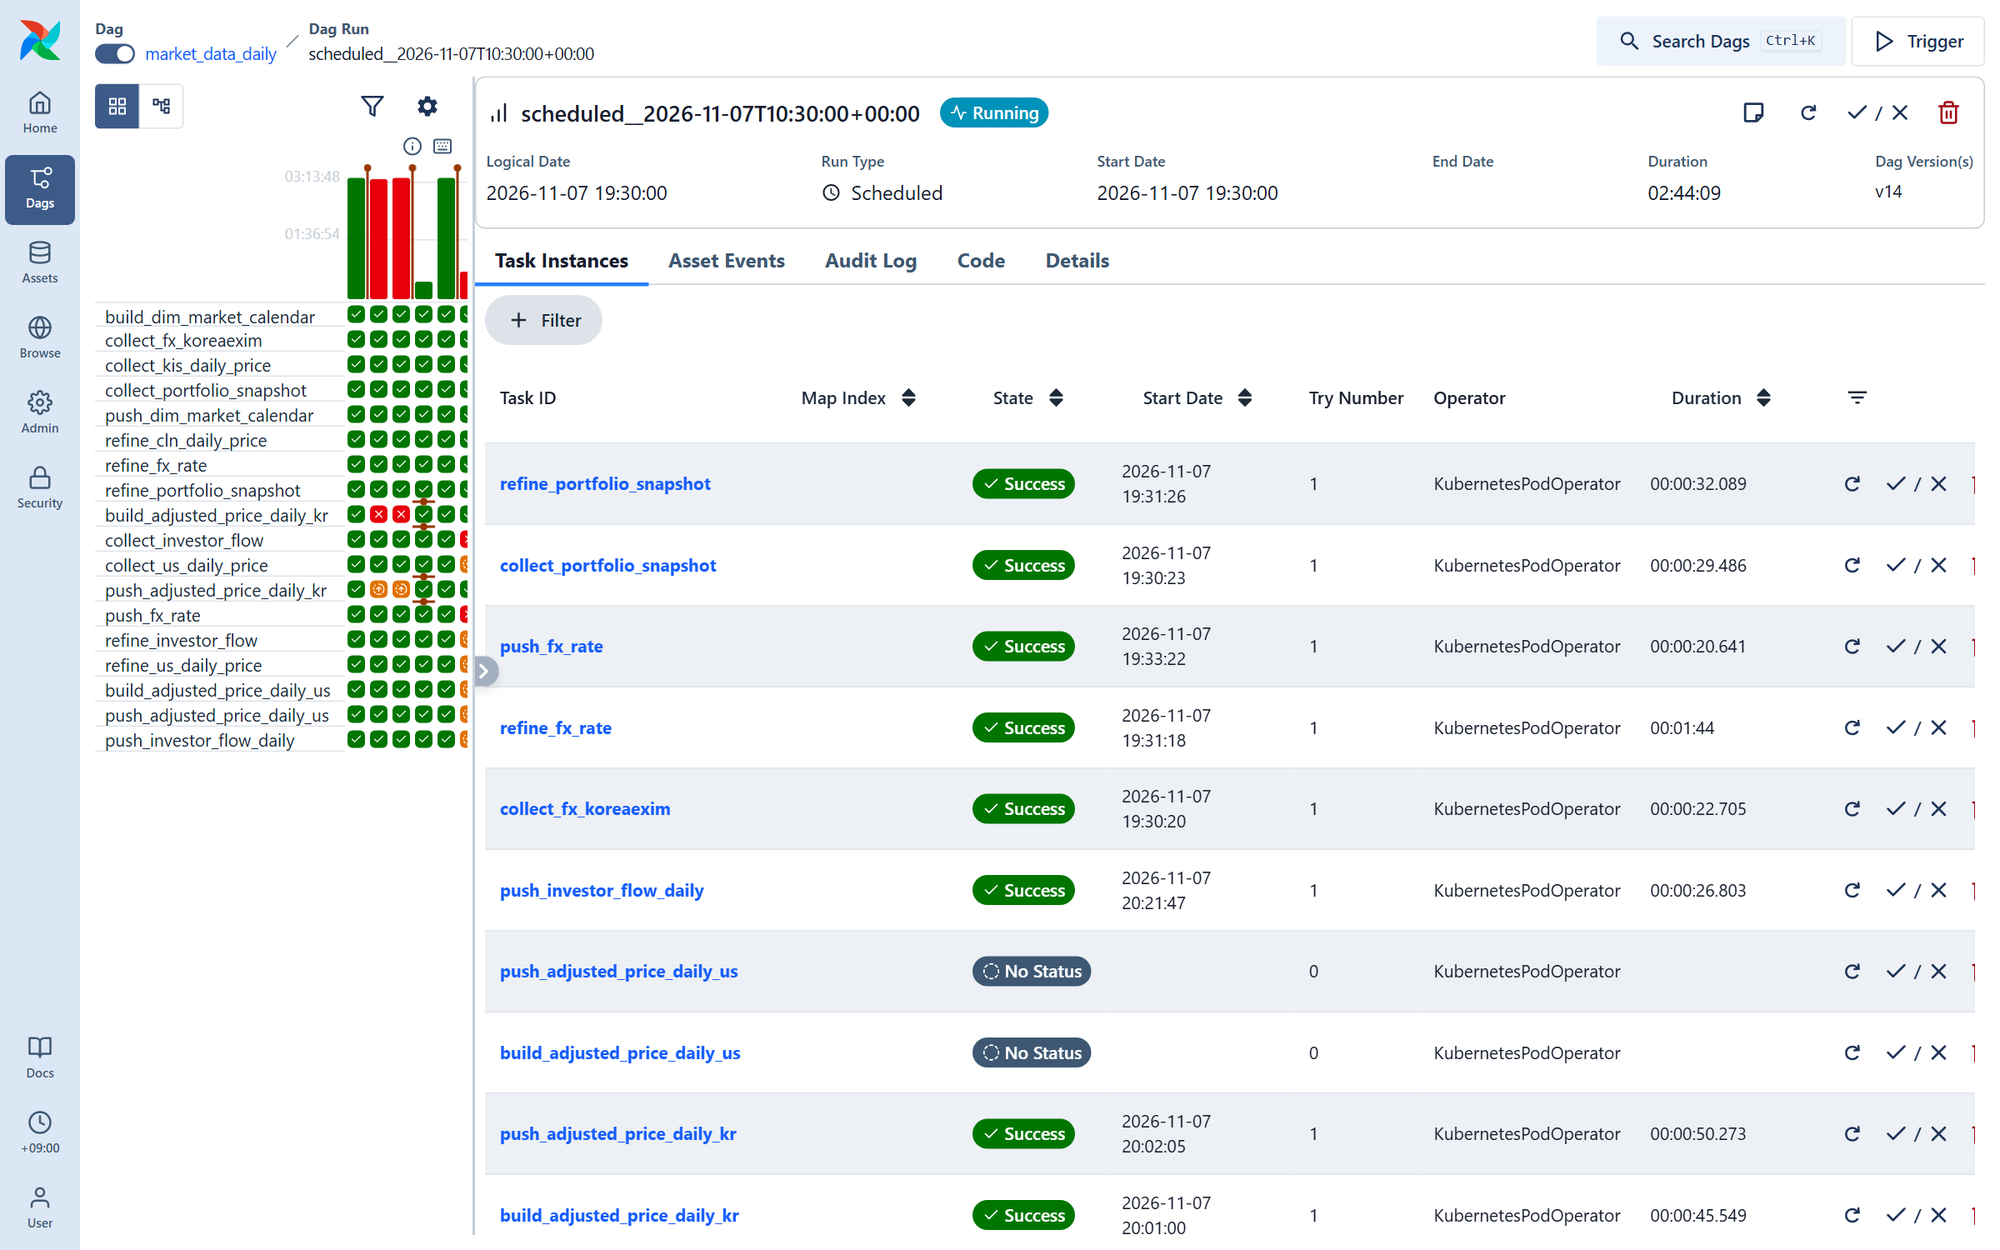
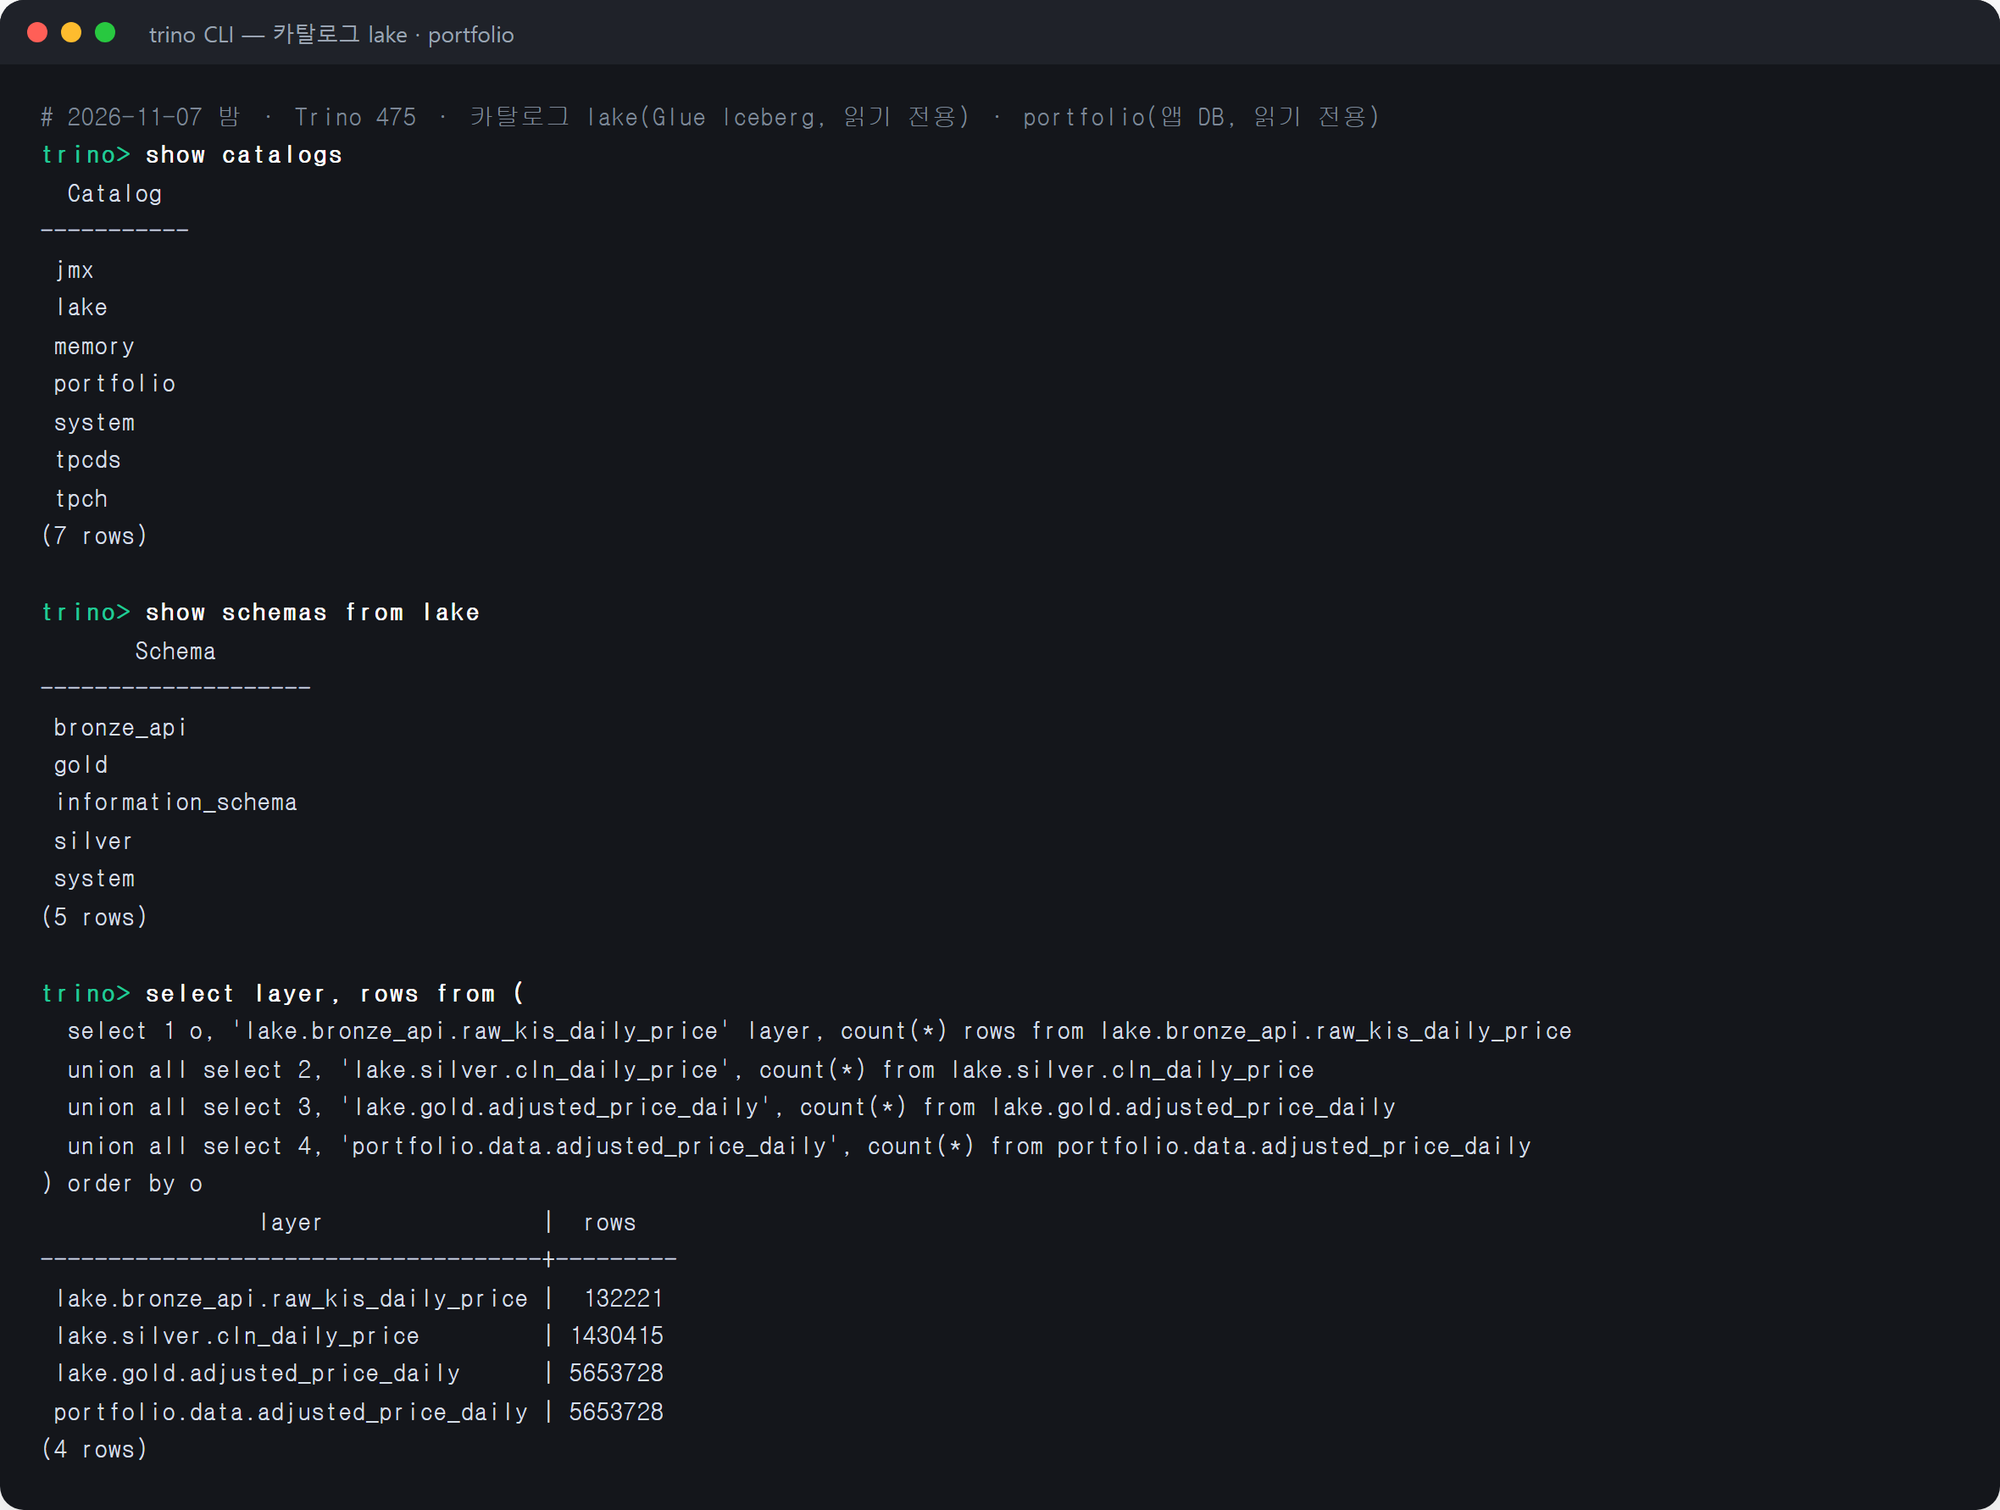
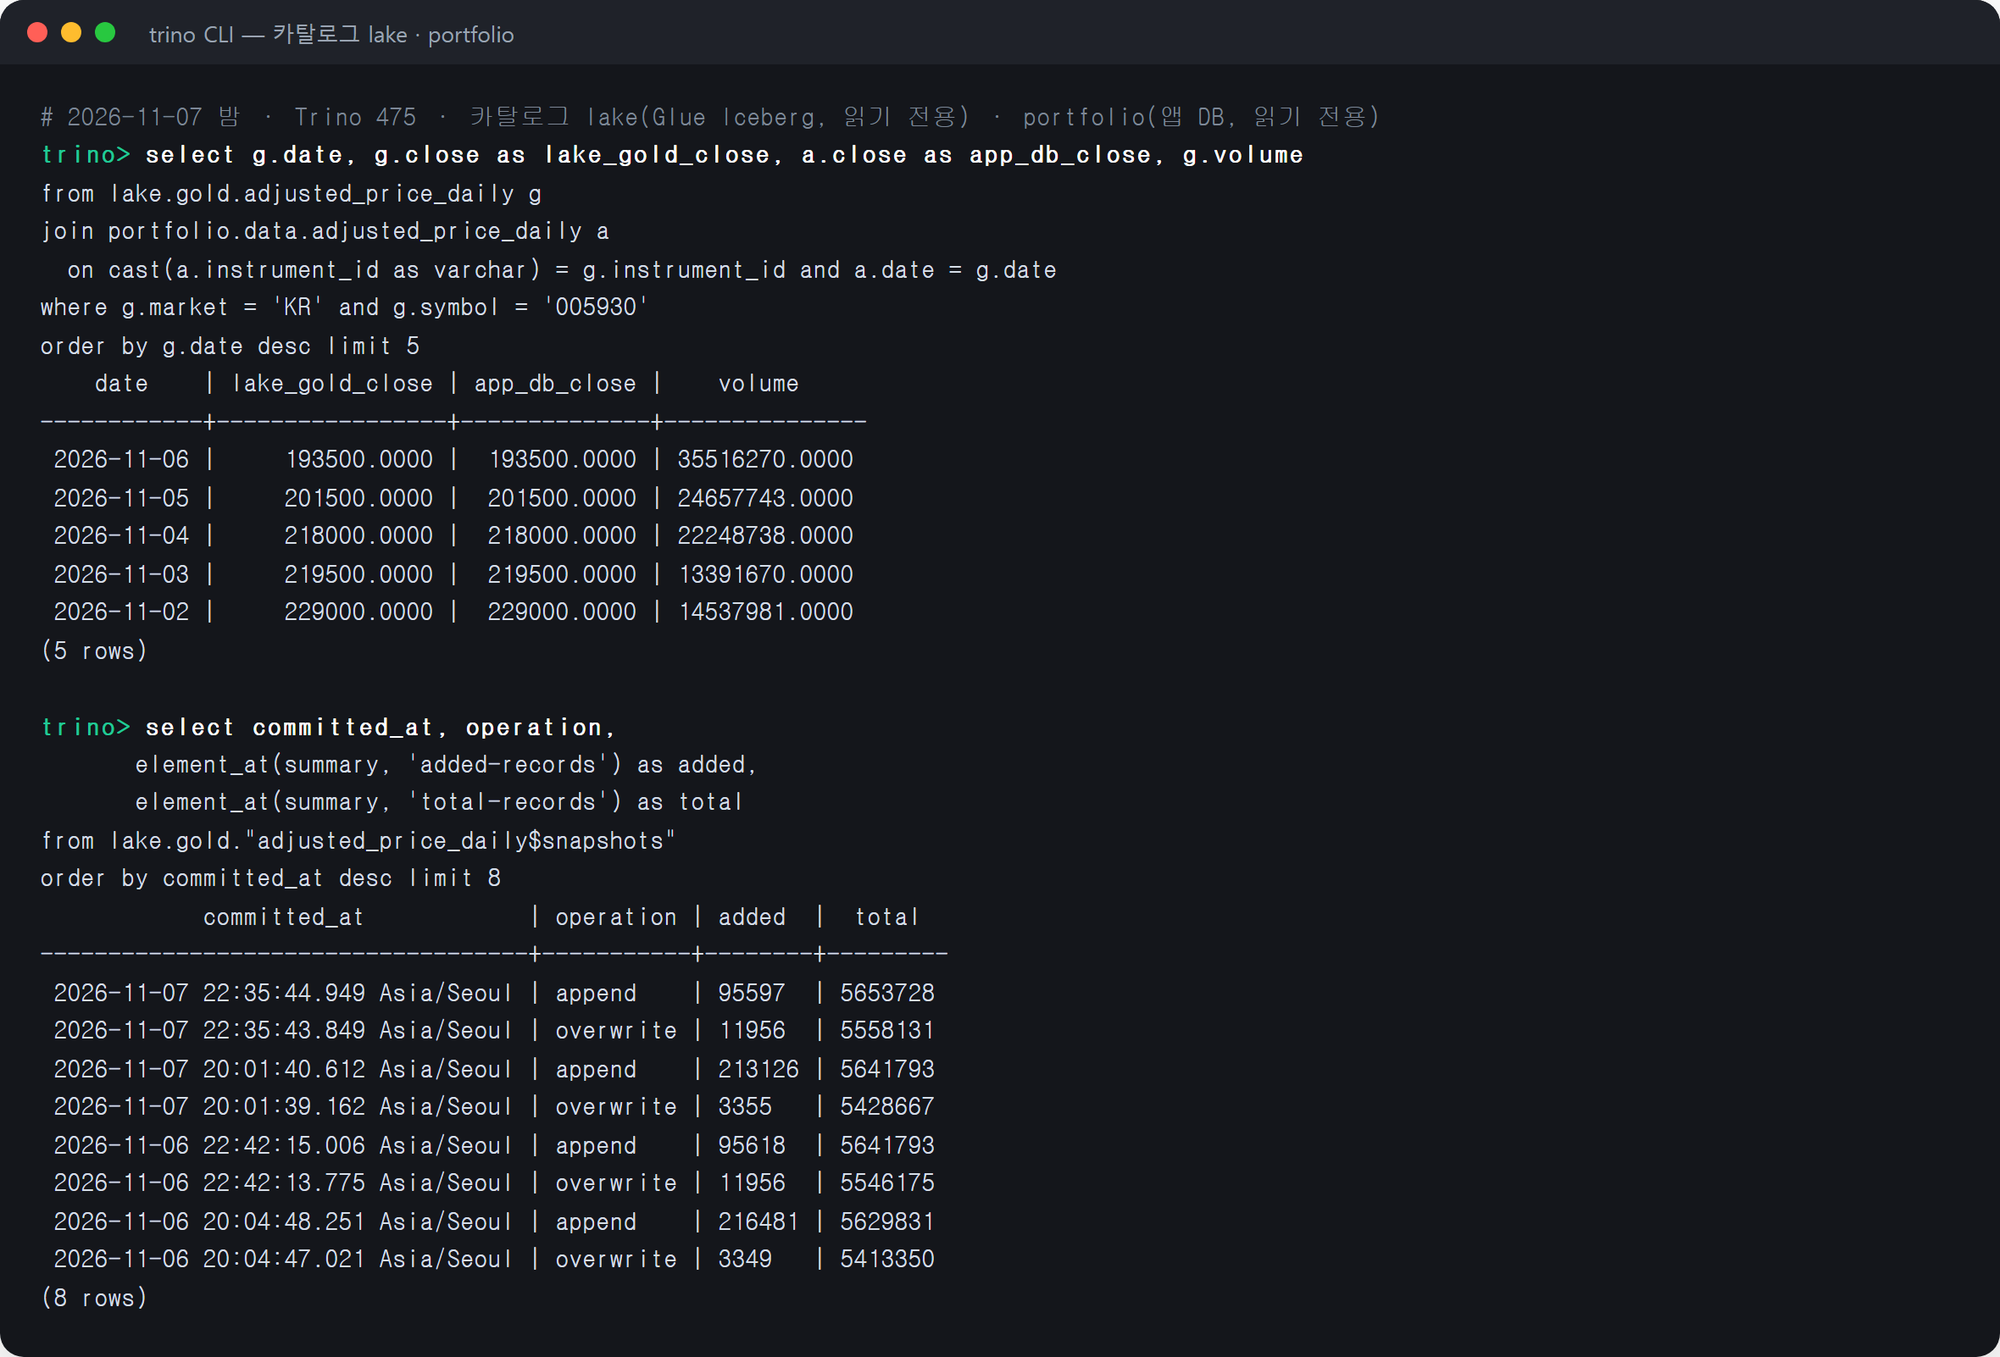
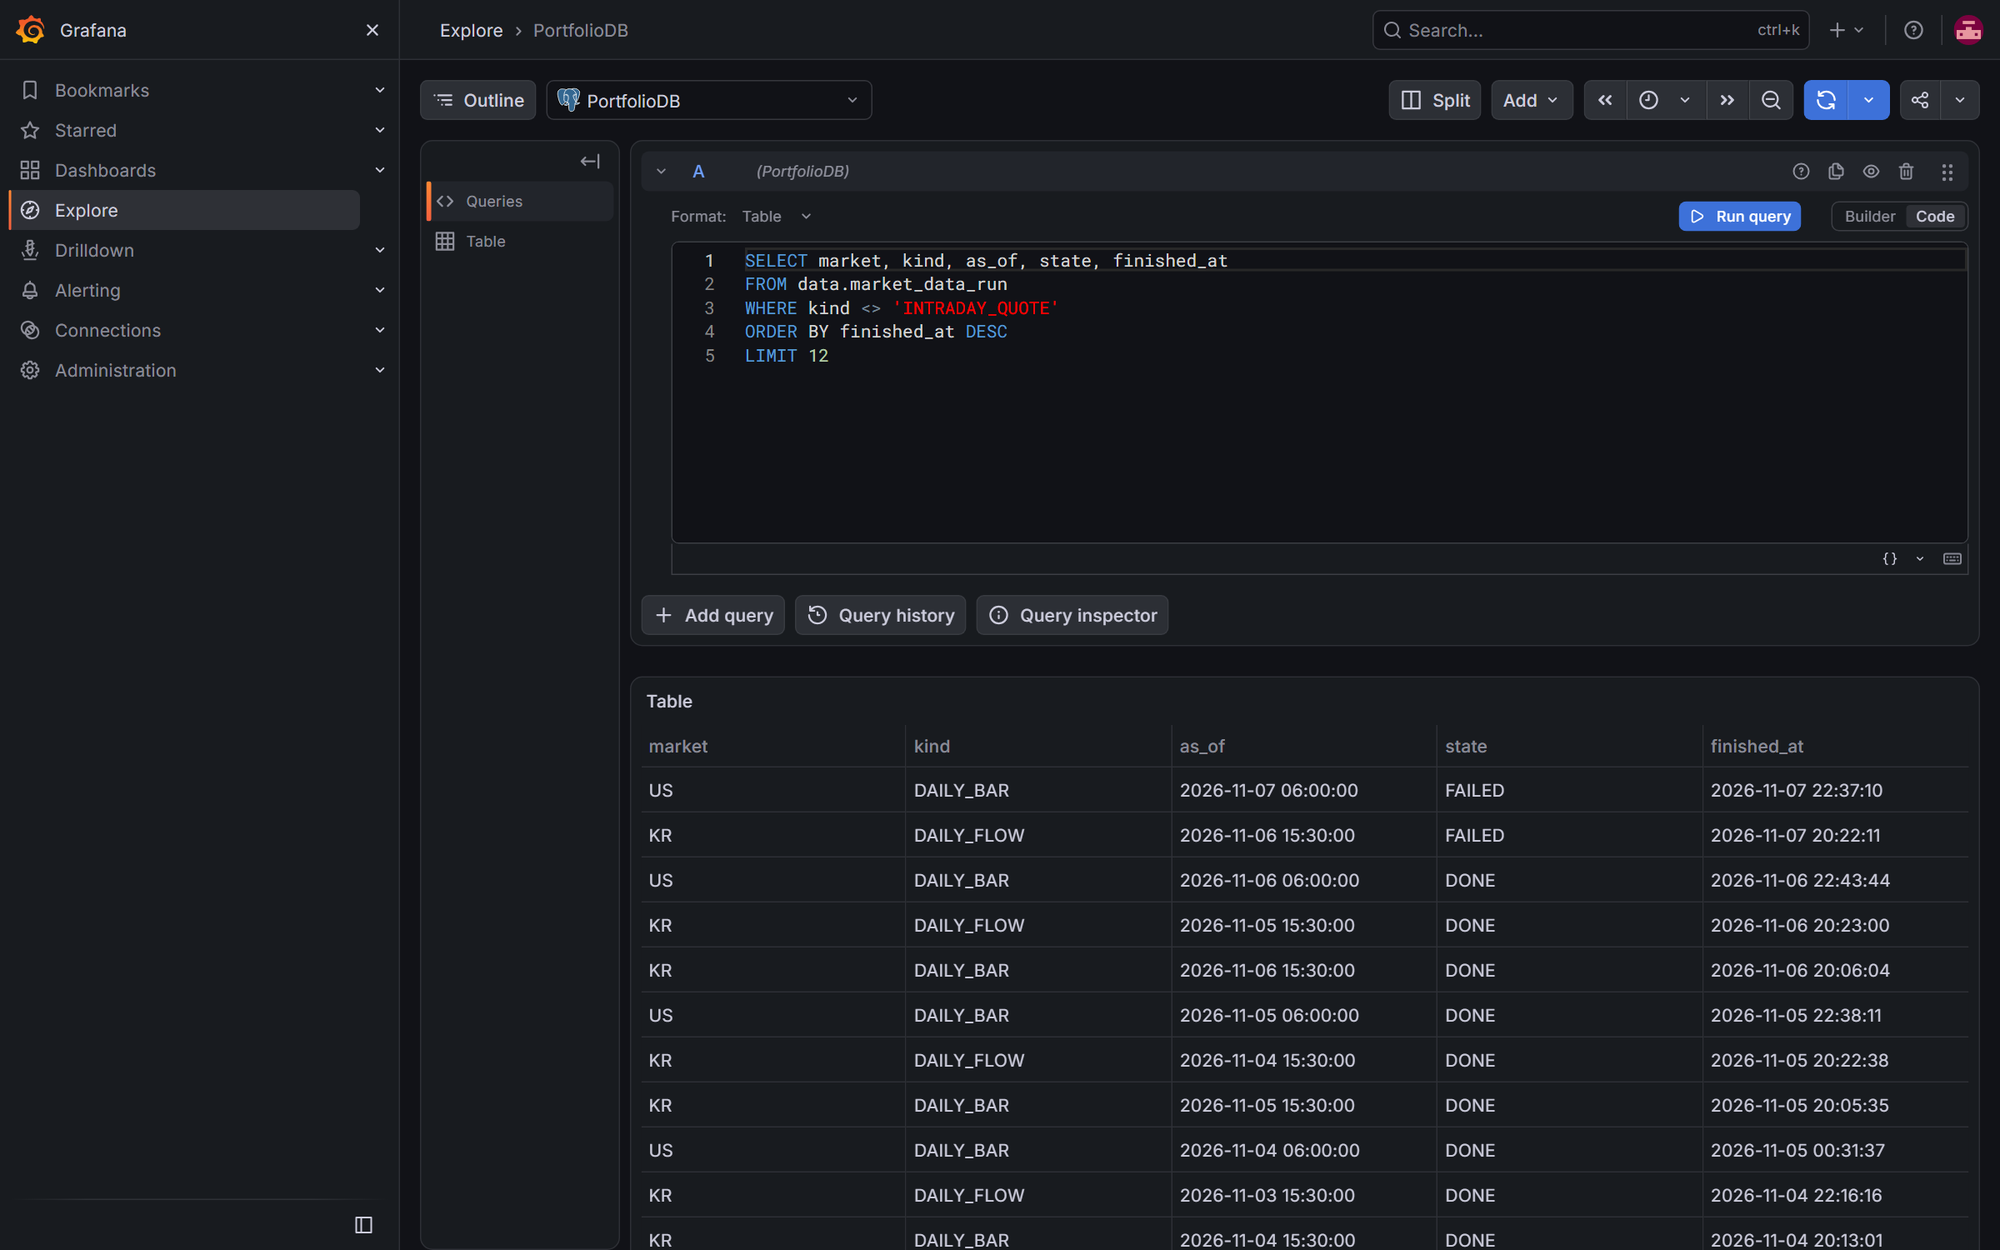
완료 게이트도 실제로 일을 했습니다. 11월 7일 밤에 미국 9종목은 KIS 가 500 오류를 돌려줬고 국내 수급 약 120종목은 응답에 그날 행이 없었습니다. 게이트가 두 건을 FAILED 로 막았고 다음 실행이 빈칸을 채우자 DONE 으로 바뀌었습니다. 게이트가 없었다면 이 종목들은 "거래 없음" 으로 계산되었을 것입니다.
4.3 알림
- 장중 시세 수집 : 5분 주기, 약 2,600번 실행, 성공률 99.4%
- 실제 작업 약 20초, 실행 전체 약 40초
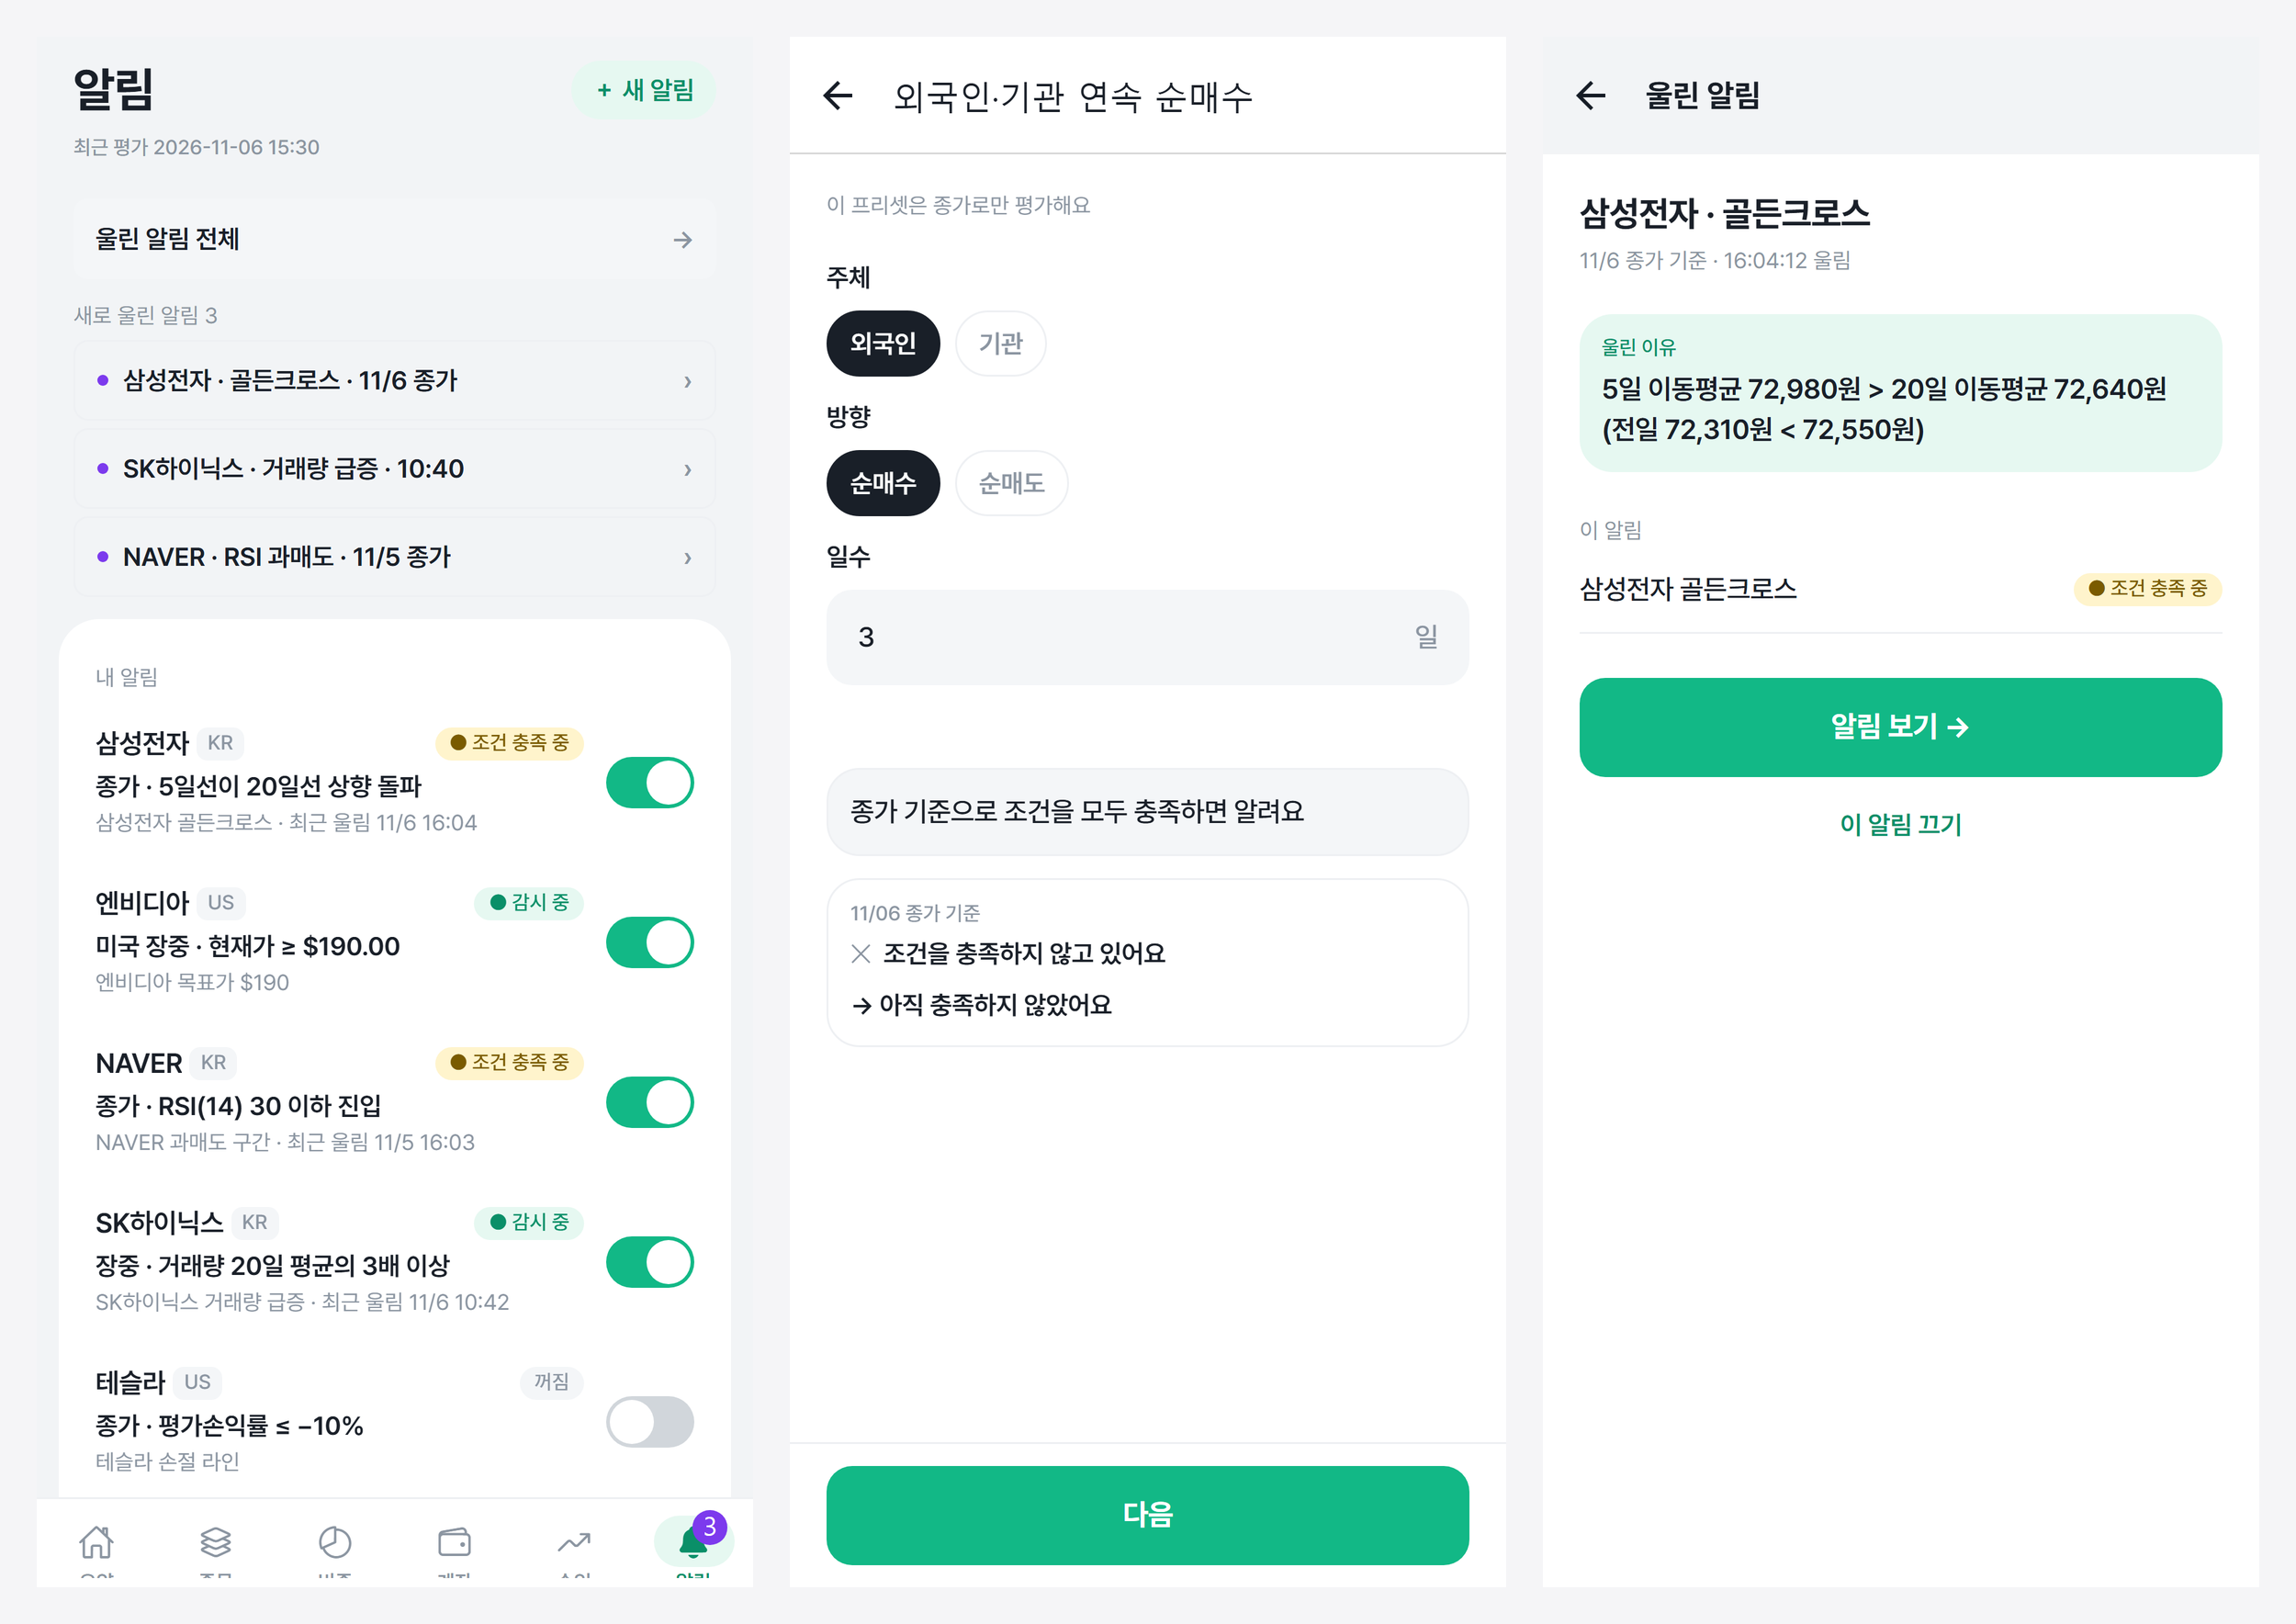
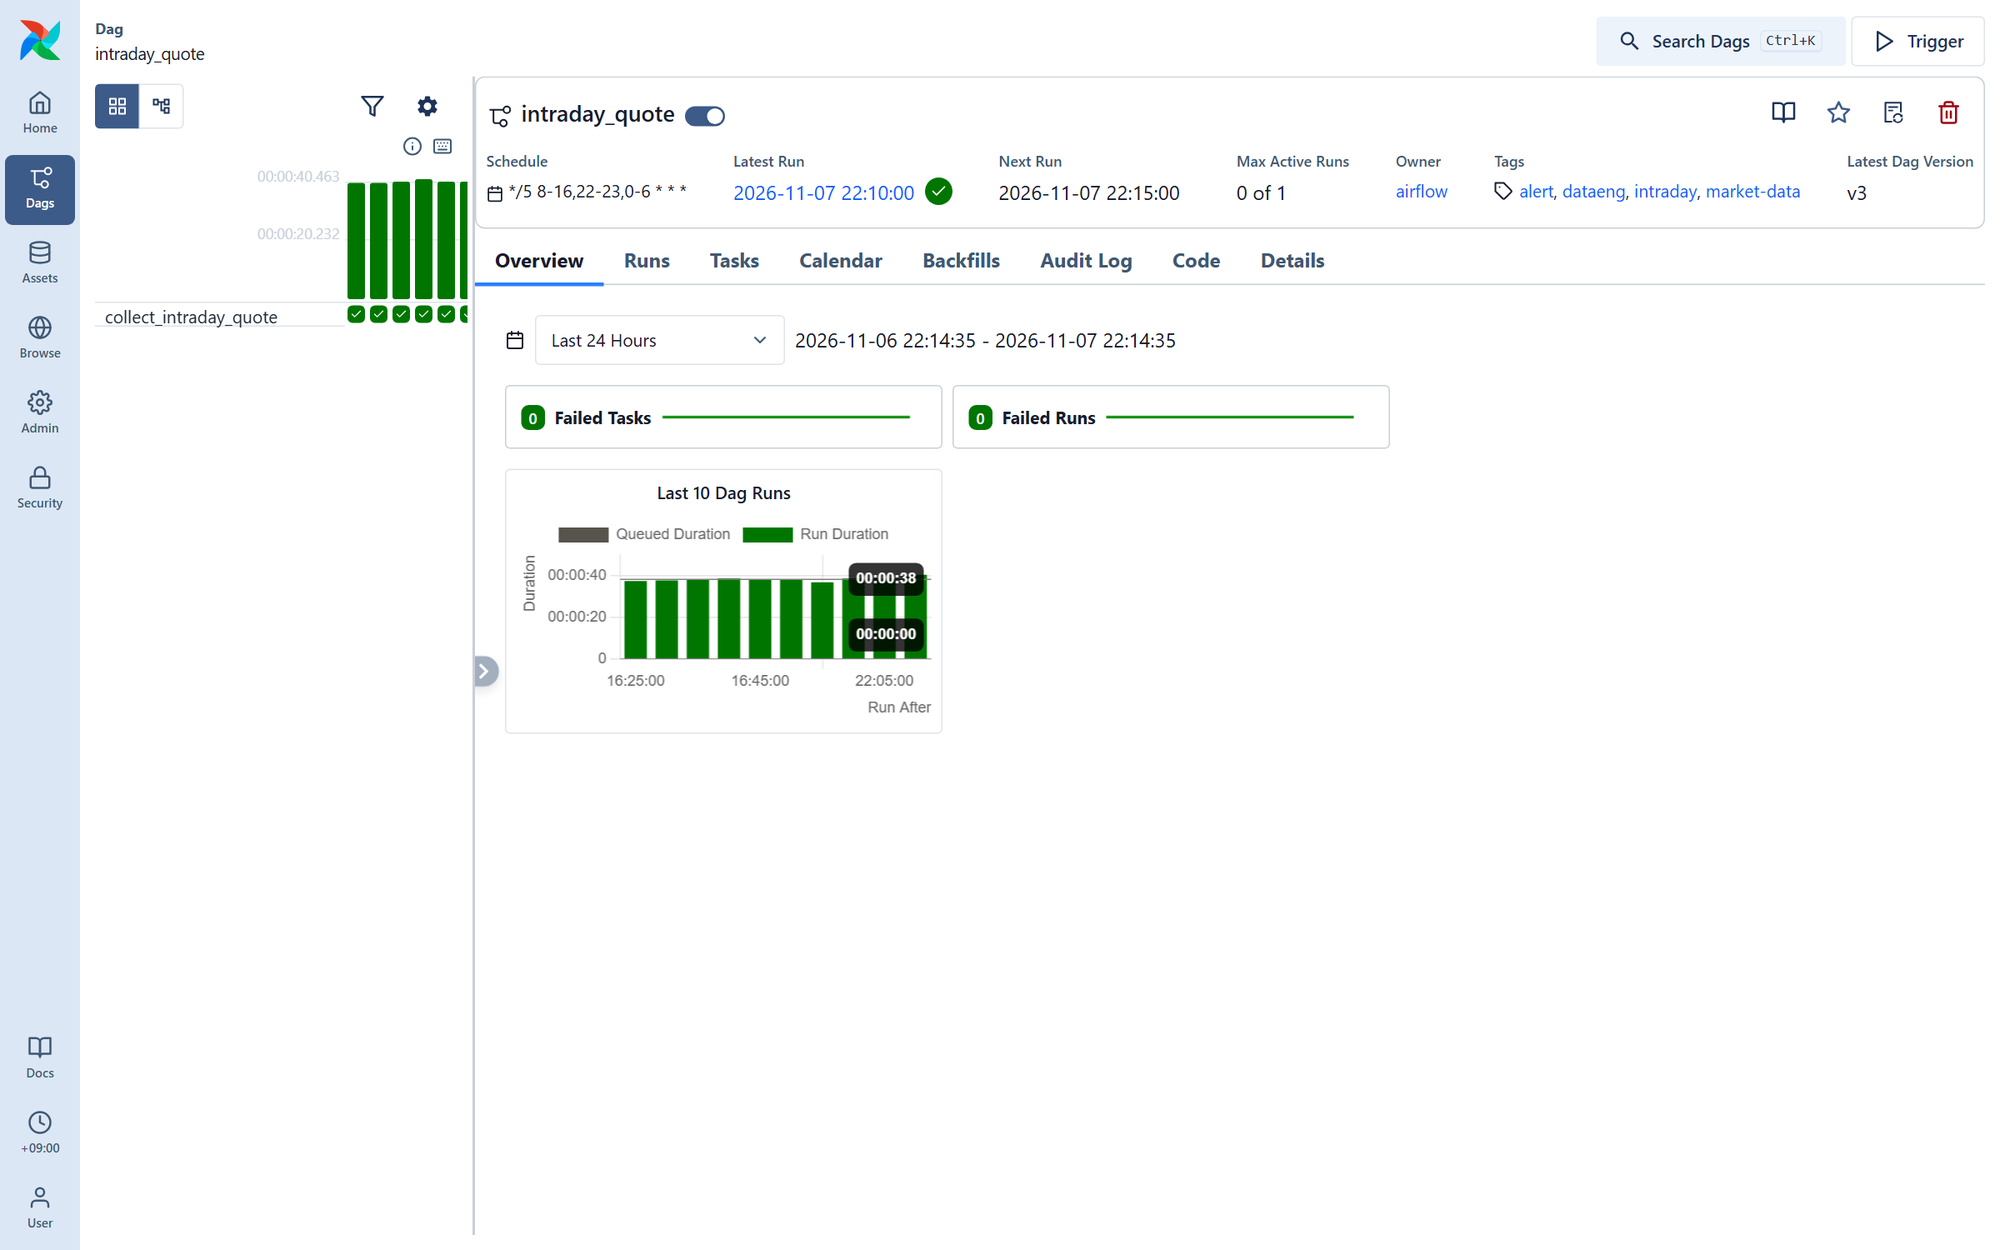
실행 시간의 절반이 Pod 기동 시간입니다. Task 마다 Pod 을 띄우는 방식은 의존성을 격리하기에는 좋았지만 짧은 주기 작업과는 잘 맞지 않았습니다.
4.4 변경 이력 보존 (CDC)
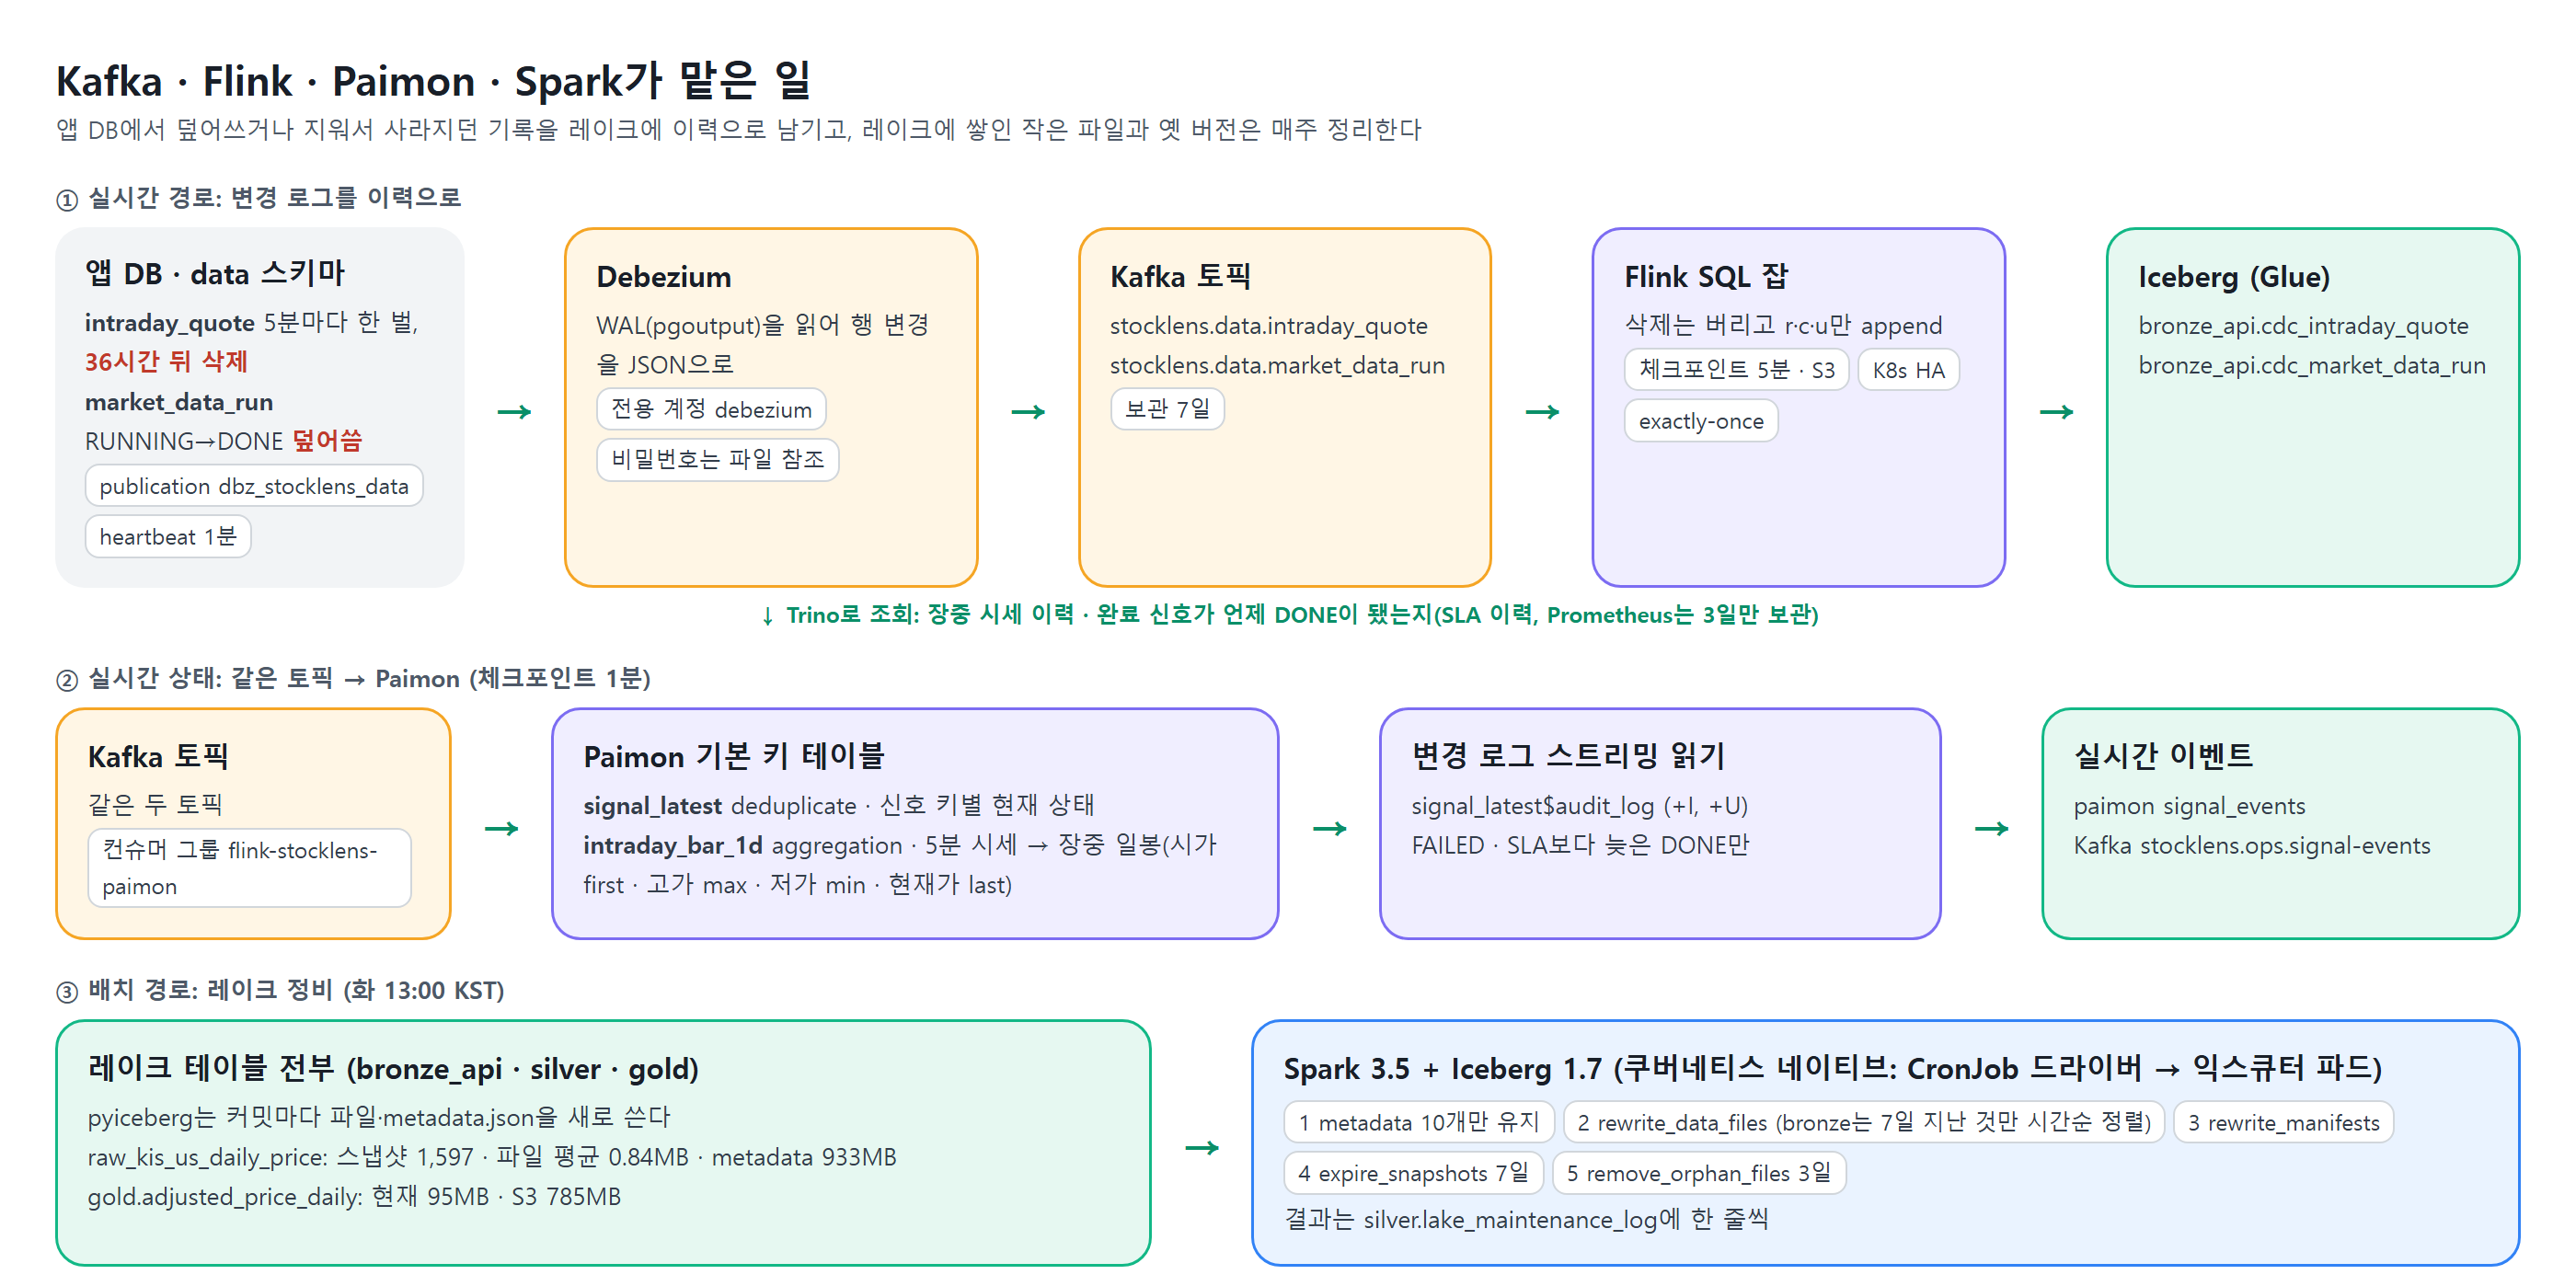
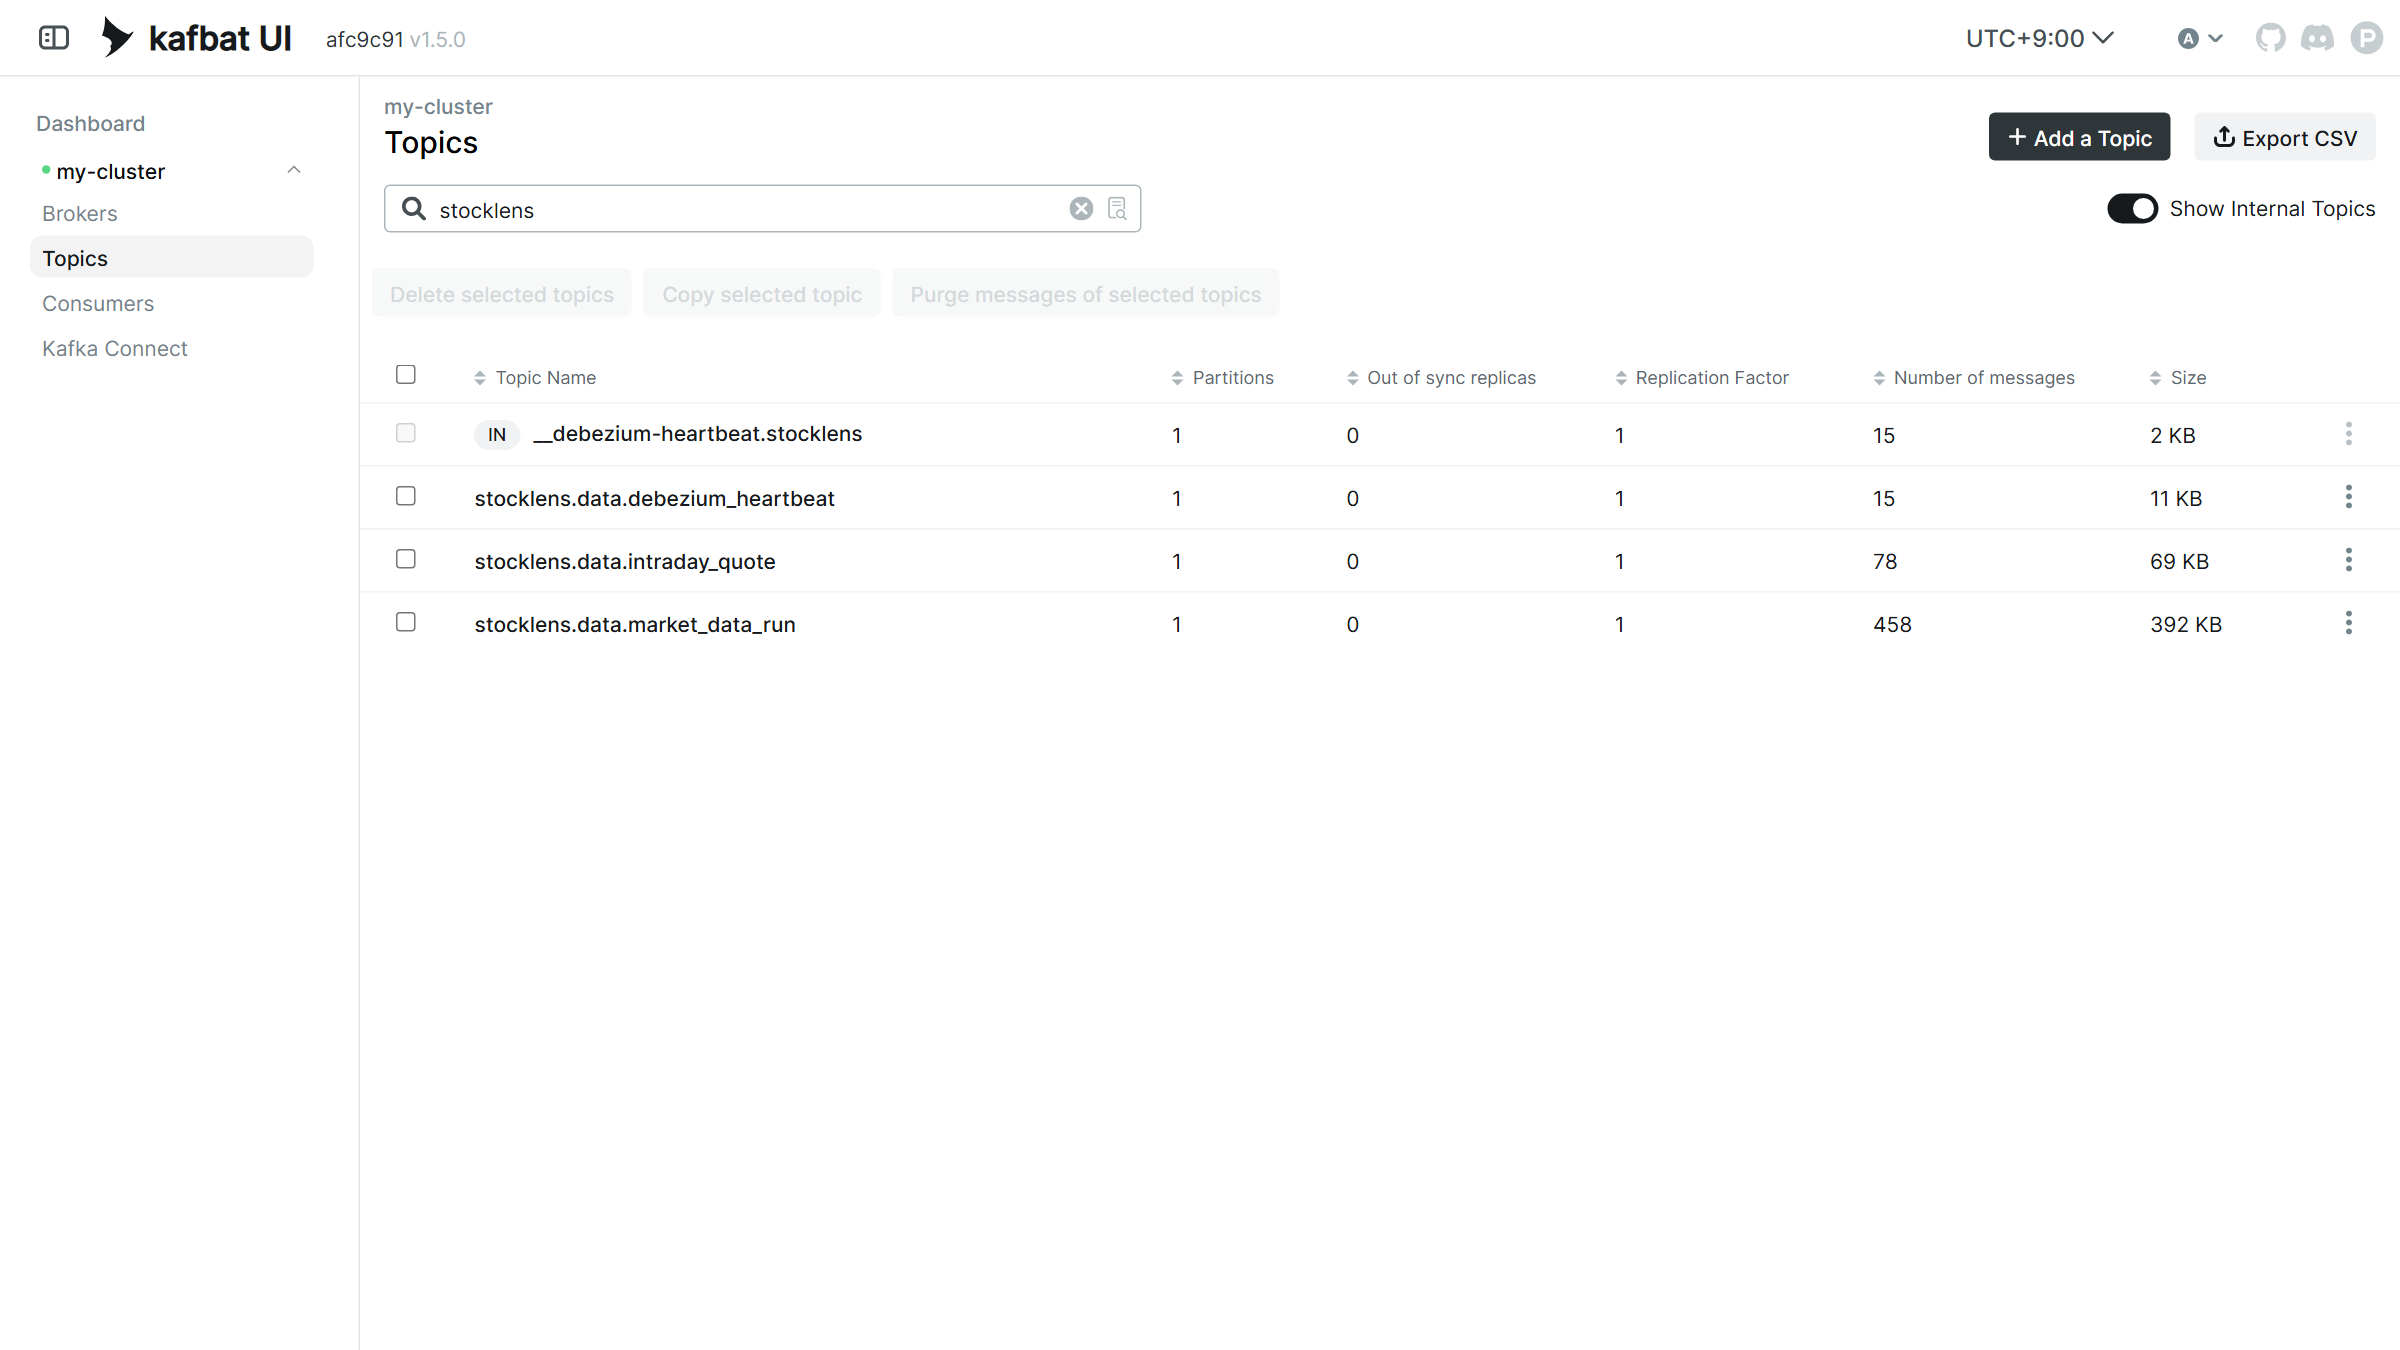
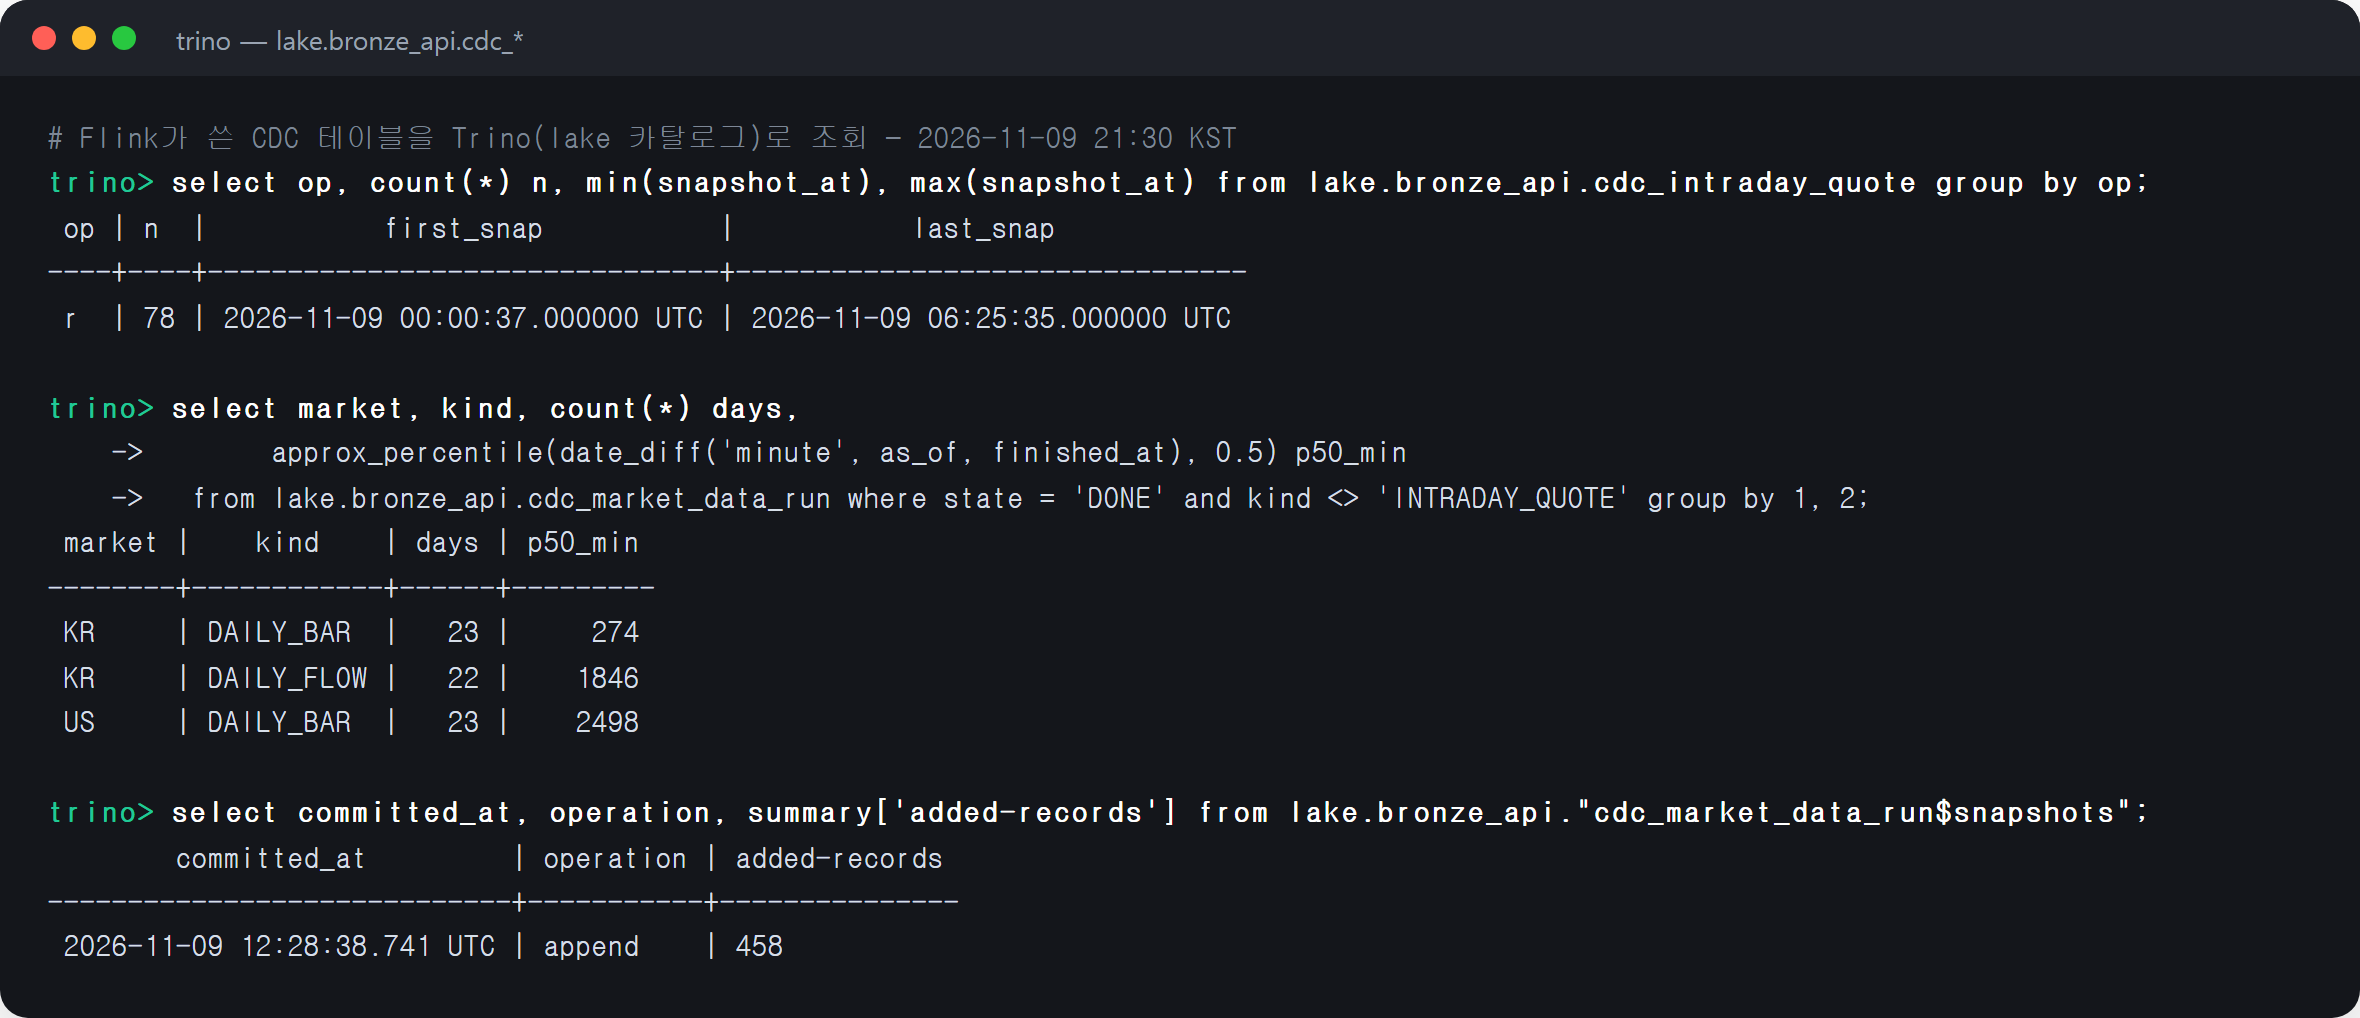
장중 시세는 36시간 뒤에 지워지고 완료 신호는 같은 행을 덮어쓰기 때문에 마지막 상태만 남습니다. 그래서 "그날 10:40 에 알림이 왜 안 울렸지?" 를 나중에 재현할 수가 없었습니다.
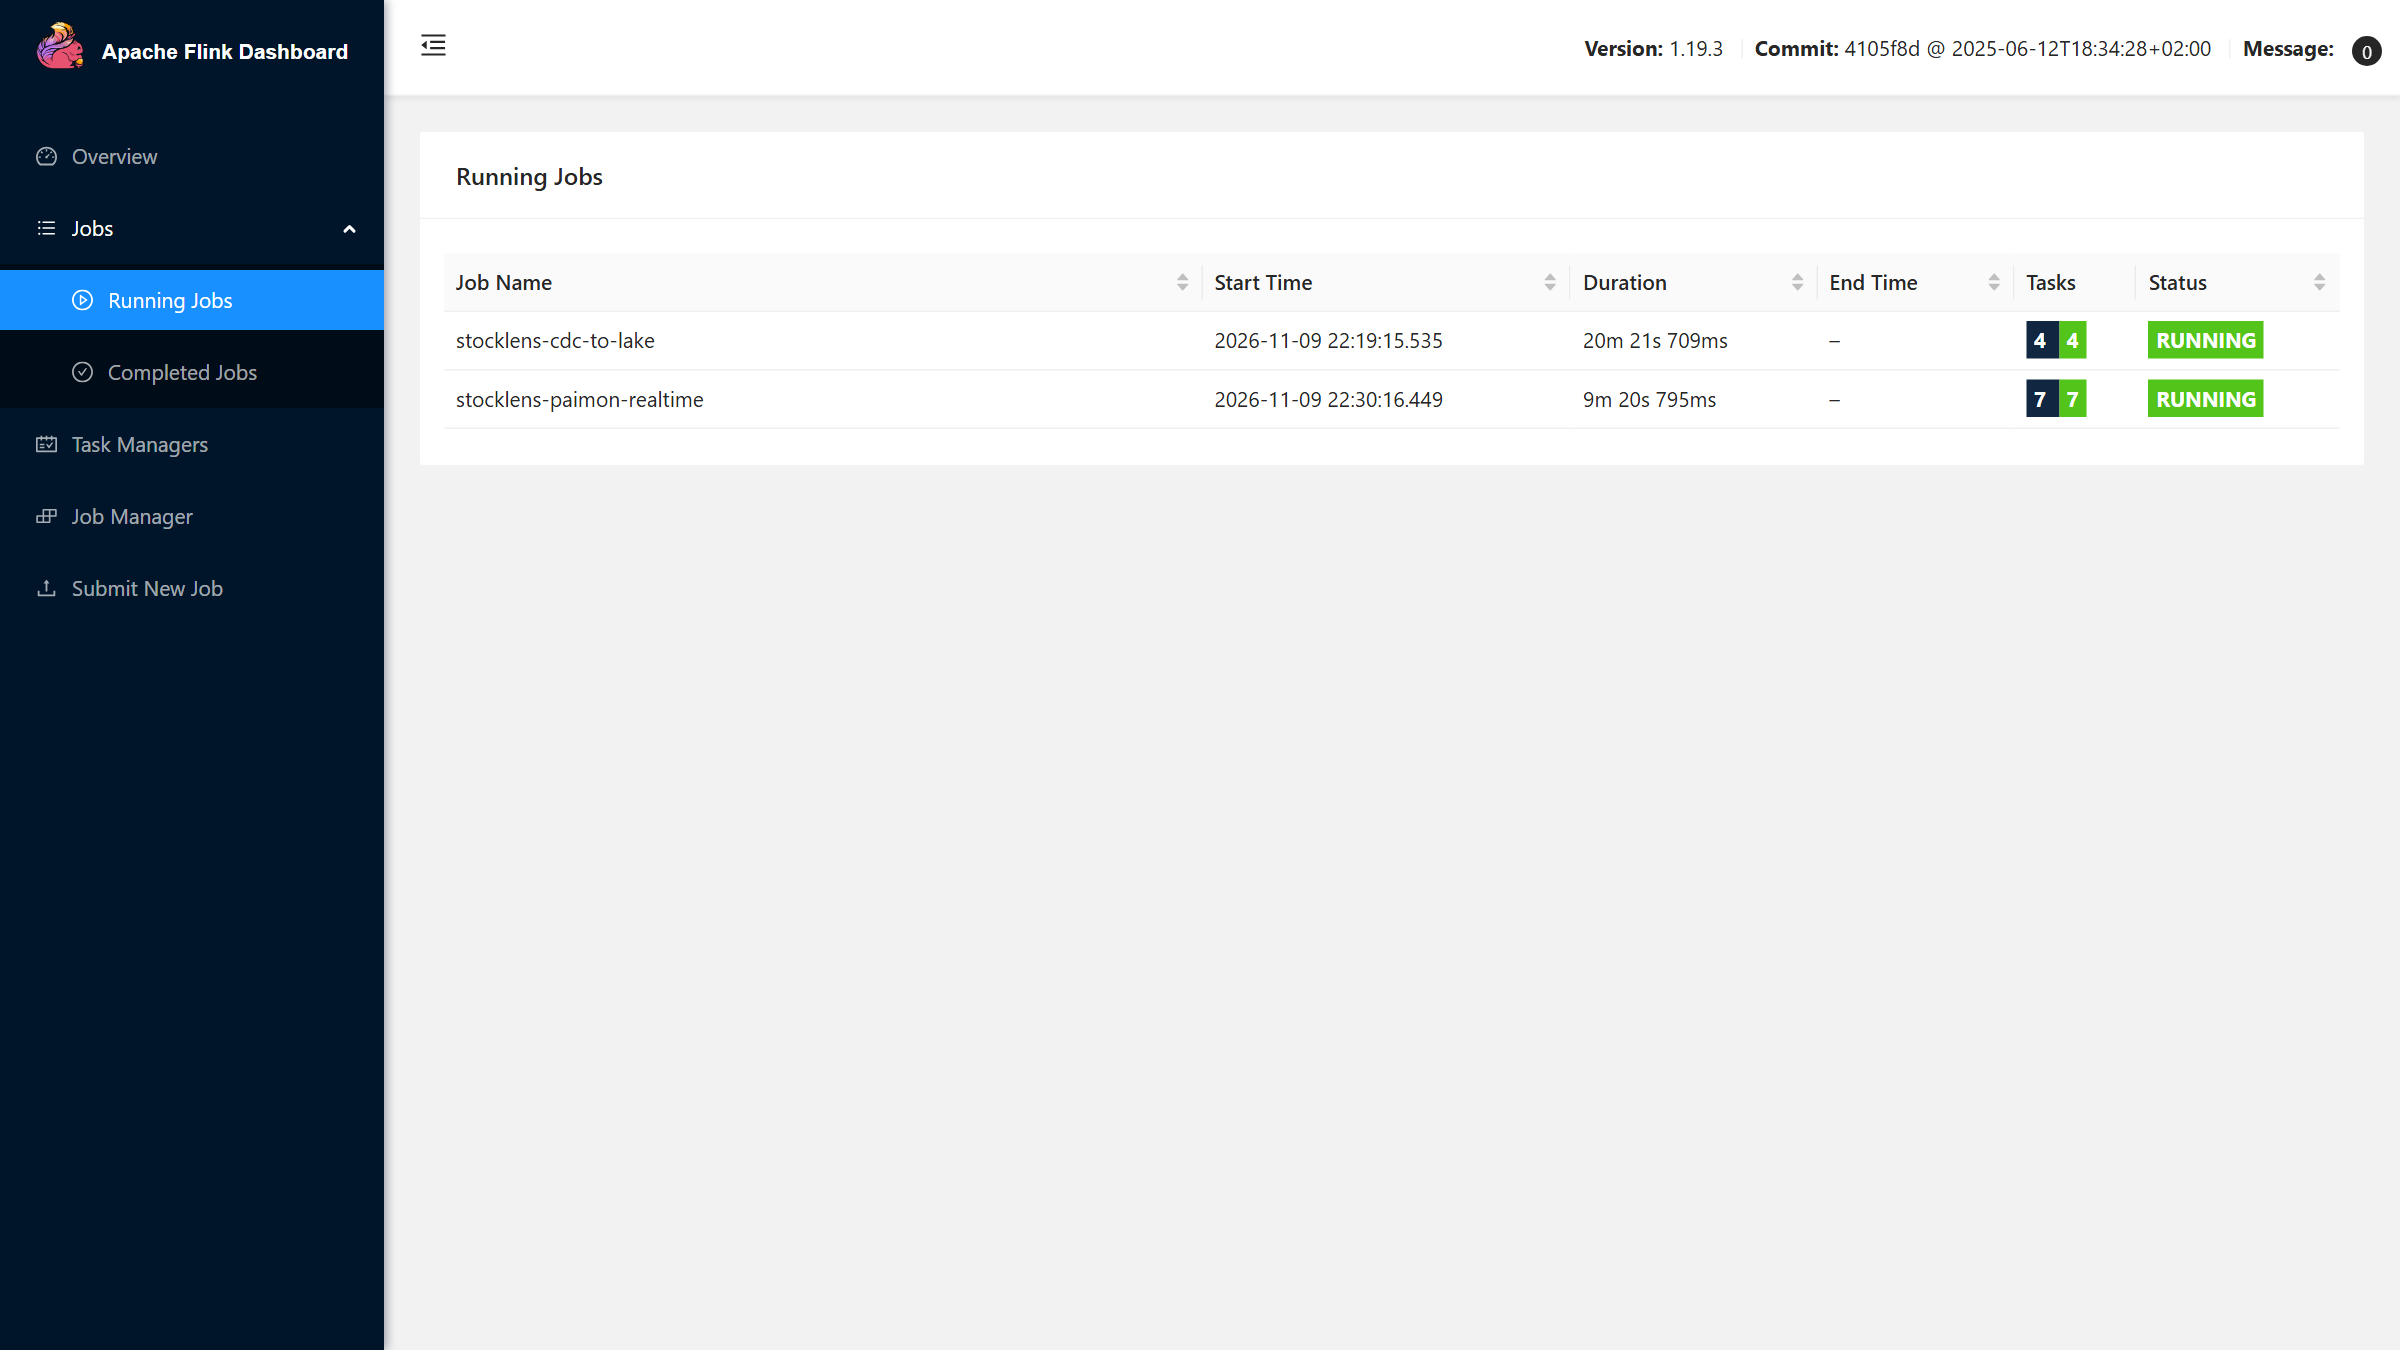
이 두 테이블의 변경 로그를 Debezium 으로 Kafka 에 올리고 Flink 가 Iceberg 에는 이력으로, Paimon 에는 "지금 상태" 로 반영하게 했습니다. 쓰는 쪽 코드는 한 줄도 바뀌지 않았고 DB 의 변경 로그를 읽는 쪽만 하나 늘었습니다.
4.5 모니터링과 경보
알림은 노드 CPU 가 아니라 "국내 일봉이 21시까지 왔는가" 같은 도메인 지표에 걸었습니다. Prometheus 규칙 14개를 적용했는데 10분 뒤에 그중 두 개가 실제로 울렸습니다.
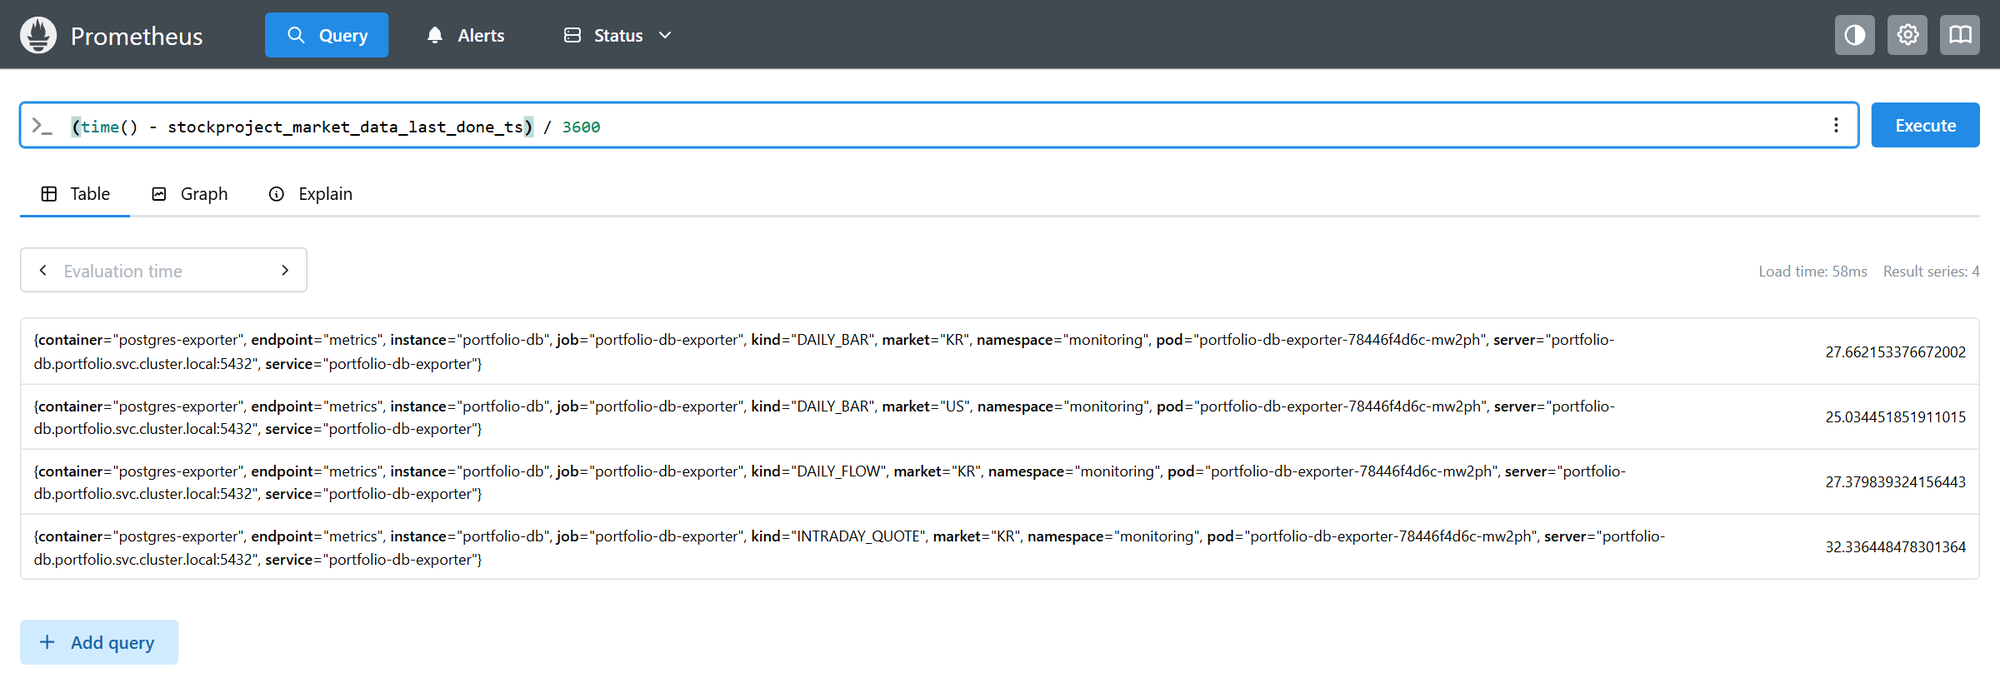
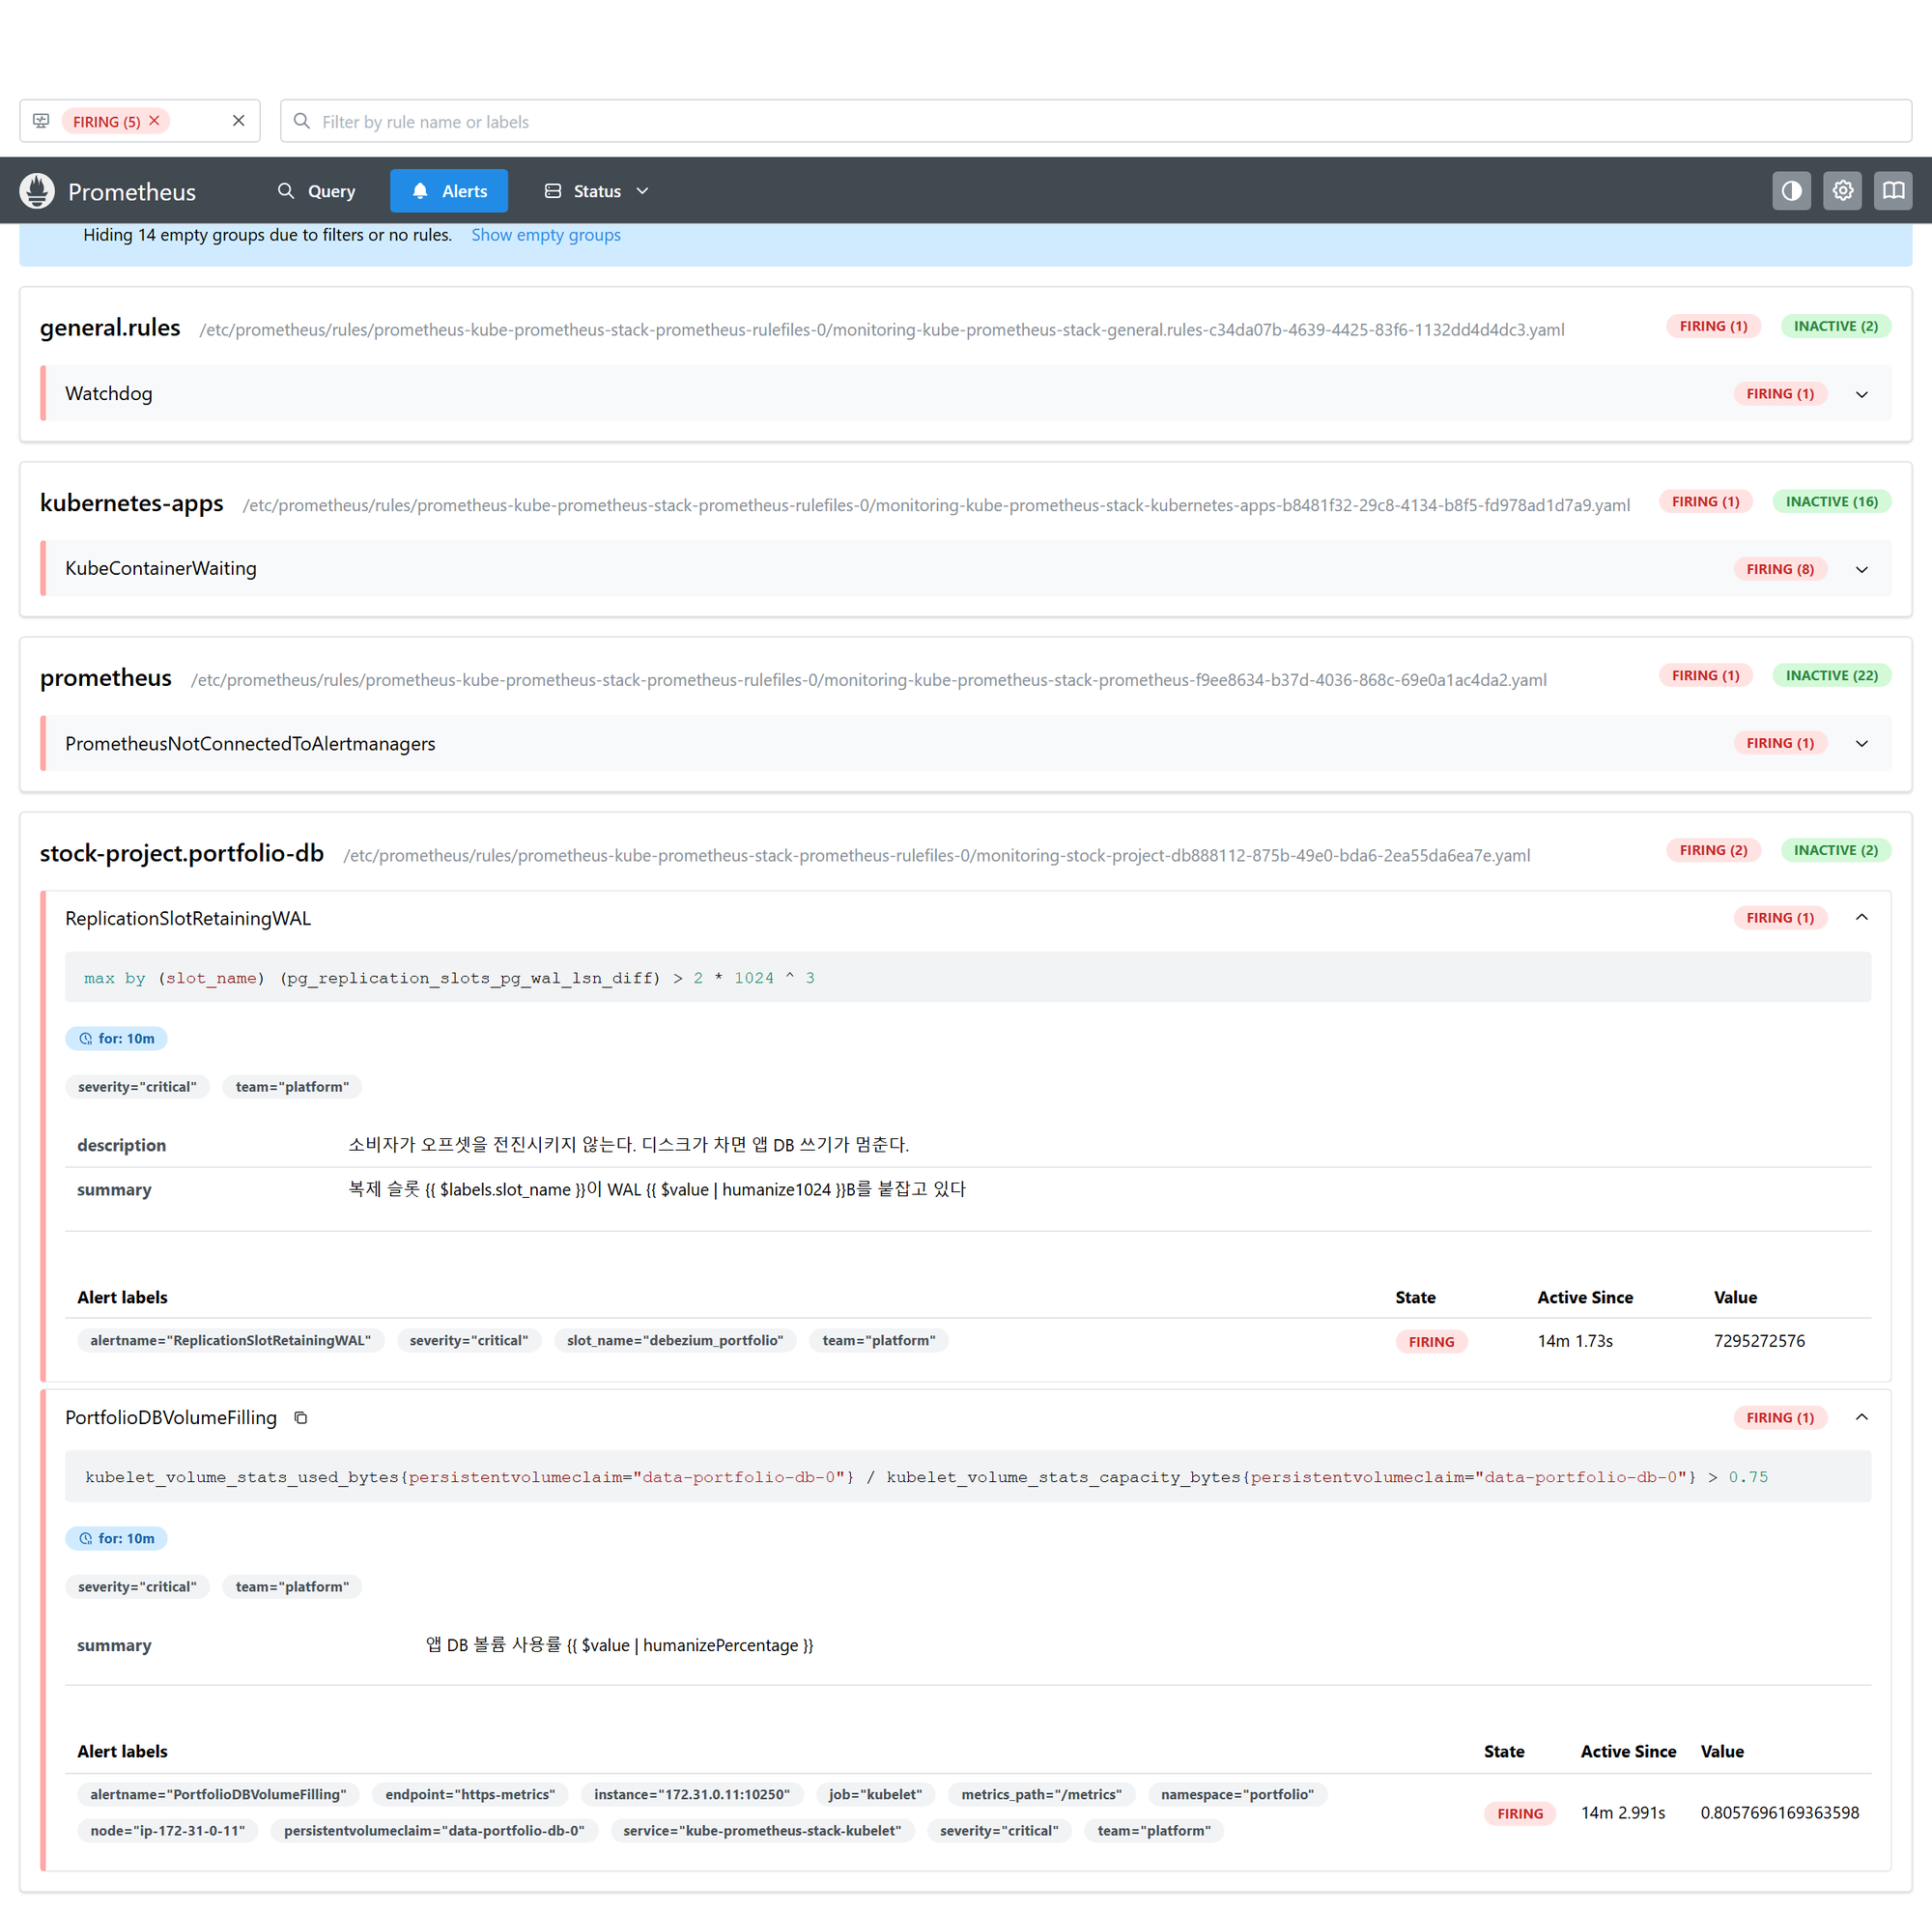
원인은 두 달 동안 일이 없던 Debezium 이었습니다. 구독하던 테이블에 변경이 없으니 복제 슬롯이 전진하지 않았고 PostgreSQL 은 그 뒤의 WAL 을 전부 보존하고 있었던 것입니다.
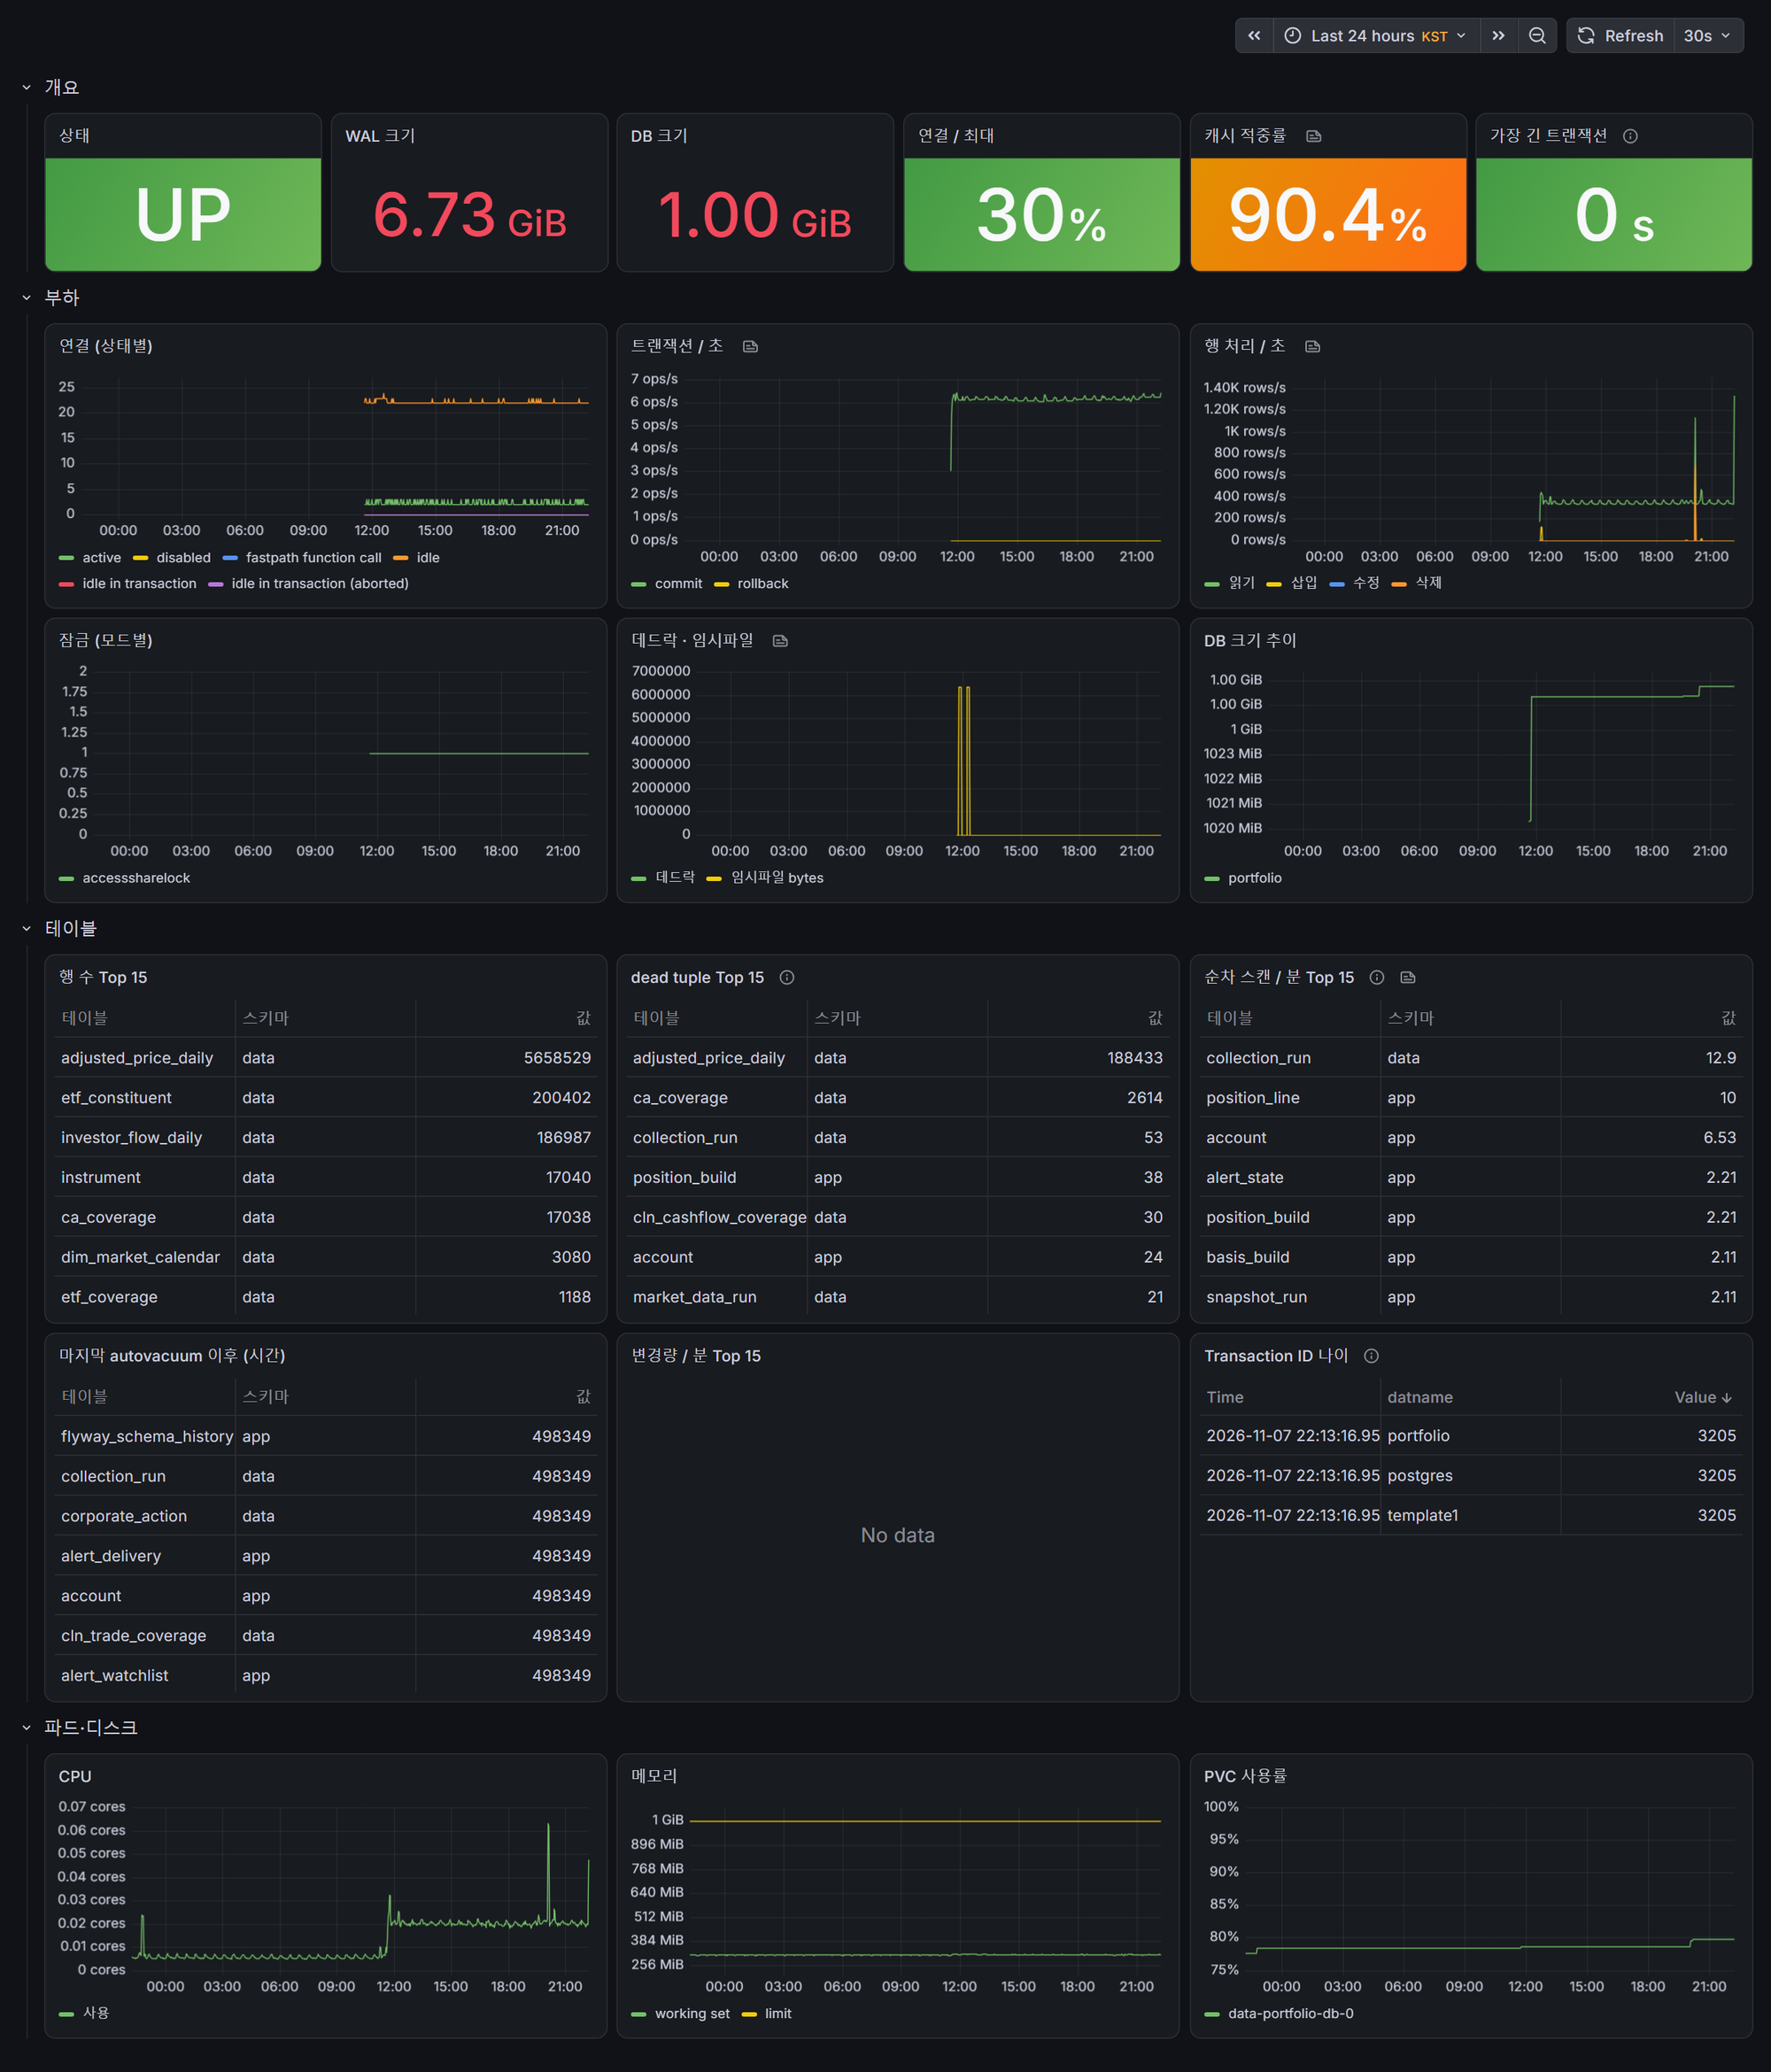
- WAL 약 6.9GB → 약 180MB
- 앱 DB 볼륨 사용률 80% → 12%
남은 2GB 가 찼다면 앱 DB 가 쓰기를 멈추고 서비스 전체가 멈췄을 것입니다. 그런데 Debezium 은 RUNNING 이었고 슬롯도 active 였습니다. 감시해야 할 것은 "살아 있나" 가 아니라 "전진하고 있나" 였습니다.
5. 옵티마이징
운영 기록에서 느린 곳과 남는 곳을 찾은 뒤, 손댈 수 있는 것을 바꾸고 전후를 쟀습니다.
| 영역 | 무엇을 | 전 | 후 |
|---|---|---|---|
| 앱 DB | 알림 평가 쿼리 (전 종목 최근 120봉) | 약 840ms | 약 370ms |
| Kubernetes | 가장 바쁜 노드의 CPU 예약 | 84% | 49% |
| Kubernetes | 워커 메모리 limit 합계 | 110% 이상 | 80% 이하 |
| Lake | 전체 Snapshot 수 | 약 5,100 | 약 1,500 |
| Lake | 옛 metadata 파일 | 약 1.3GB | 약 170MB |
5.1 앱 DB 커버링 인덱스
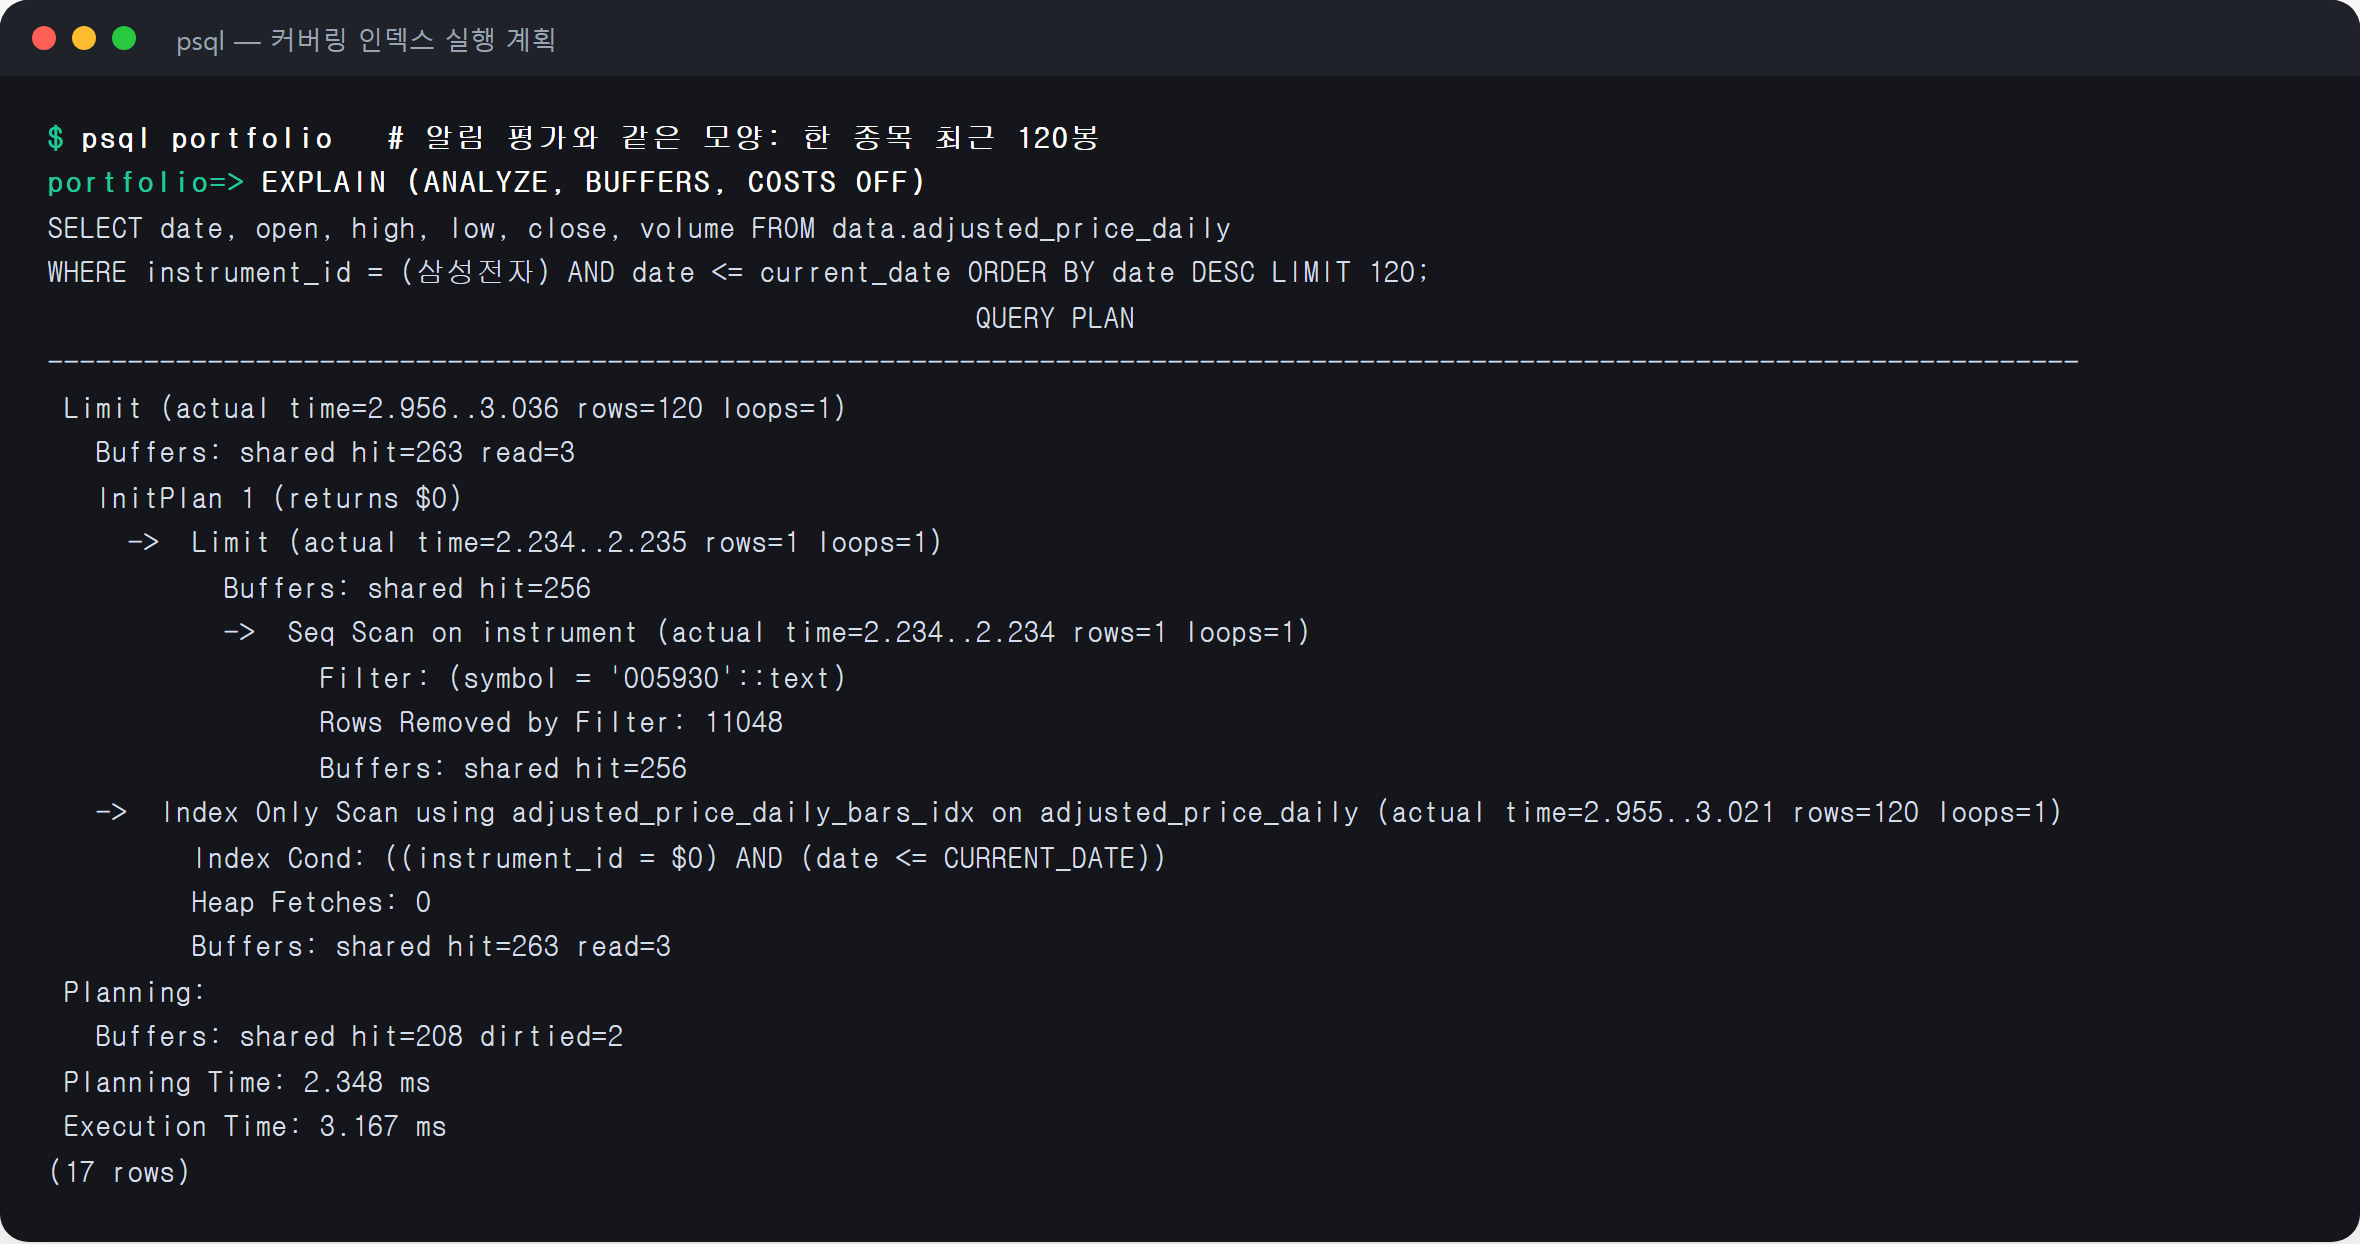
알림 평가는 종목마다 최근 120일치를 읽습니다. 데이터를 날짜별로 넣다 보니, 한 종목의 120일치가 테이블의 서로 다른 페이지 120개에 흩어져 있었습니다.
필요한 컬럼을 인덱스에 함께 담았더니(INCLUDE), 한 종목의 데이터가 인덱스 페이지 몇 개에 모이면서 테이블 본체를 읽지 않게 되었습니다. 대가는 인덱스 약 400MB 입니다.
5.2 Kubernetes 노드 재배치
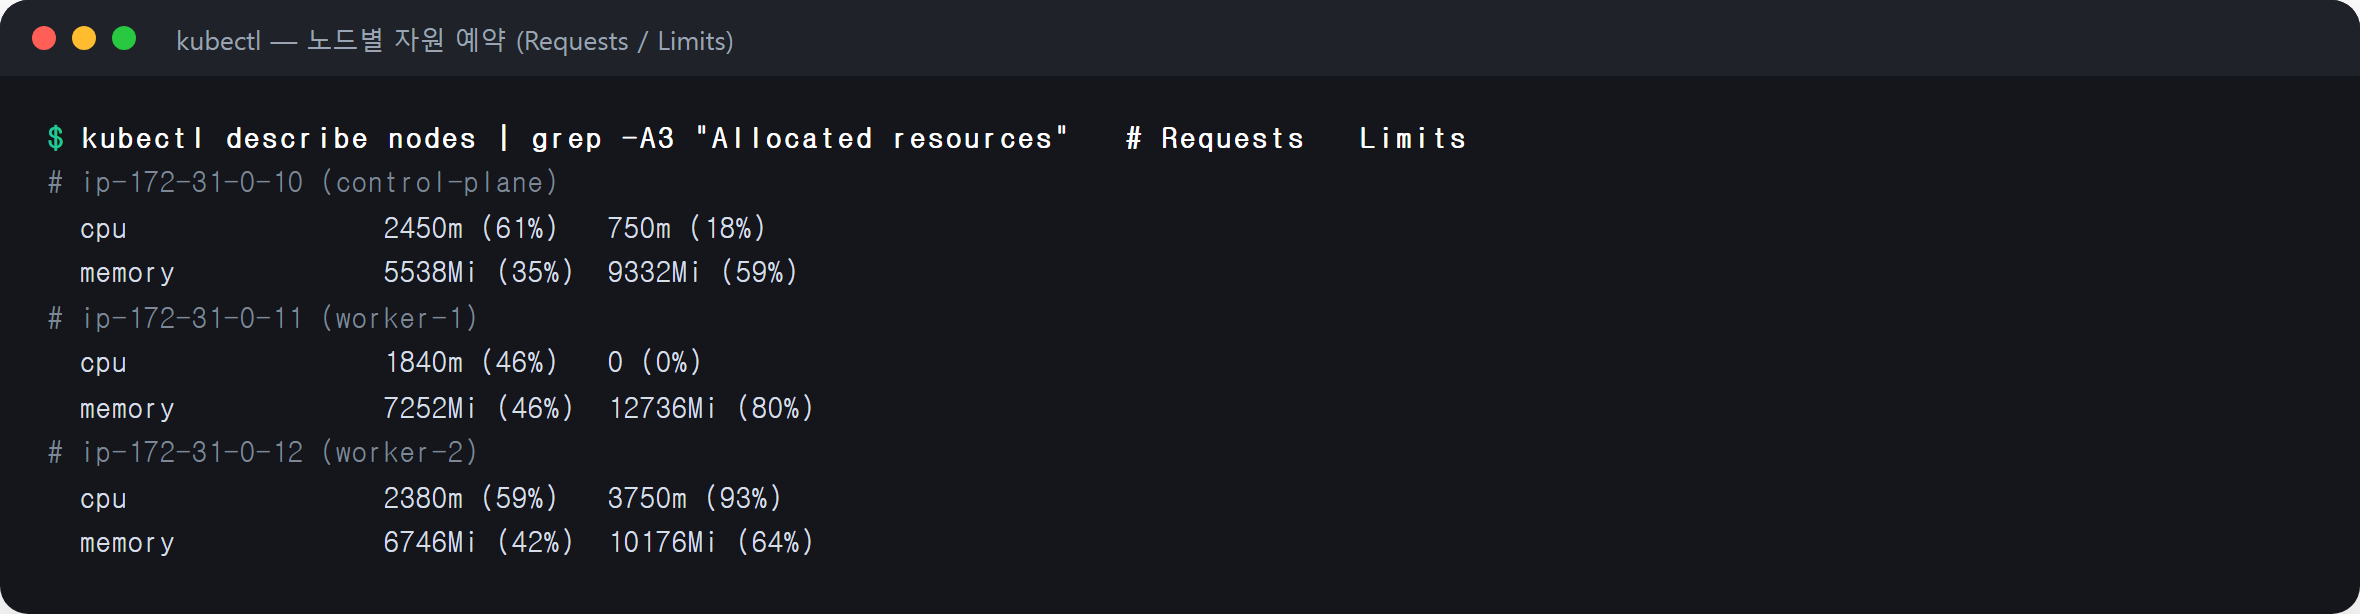
컨트롤플레인은 CPU 평균 약 14% 로 놀고 있었고 워커 두 대는 메모리 limit 합계가 노드 용량을 넘겨 있었습니다.
처음에는 컨트롤플레인의 taint 를 통째로 풀었습니다. 그런데 다음 날 EBS CSI 컨트롤러가 10시간째 Pending 인 것을 발견했는데 taint 가 없어지자 원래 못 들어오던 DaemonSet 이 들어와서 포트가 겹친 것이었습니다. taint 를 다시 걸고 옮겨도 되는 Pod 에만 toleration 을 주는 방식으로 바꿨습니다.
5.3 Lake 파일 정비
Lake 에는 작은 파일과 옛 Snapshot 이 쌓여 있었습니다. Spark 로 파일을 합치고 Snapshot 을 만료시켰는데 bronze 에서 실수를 하나 했습니다.
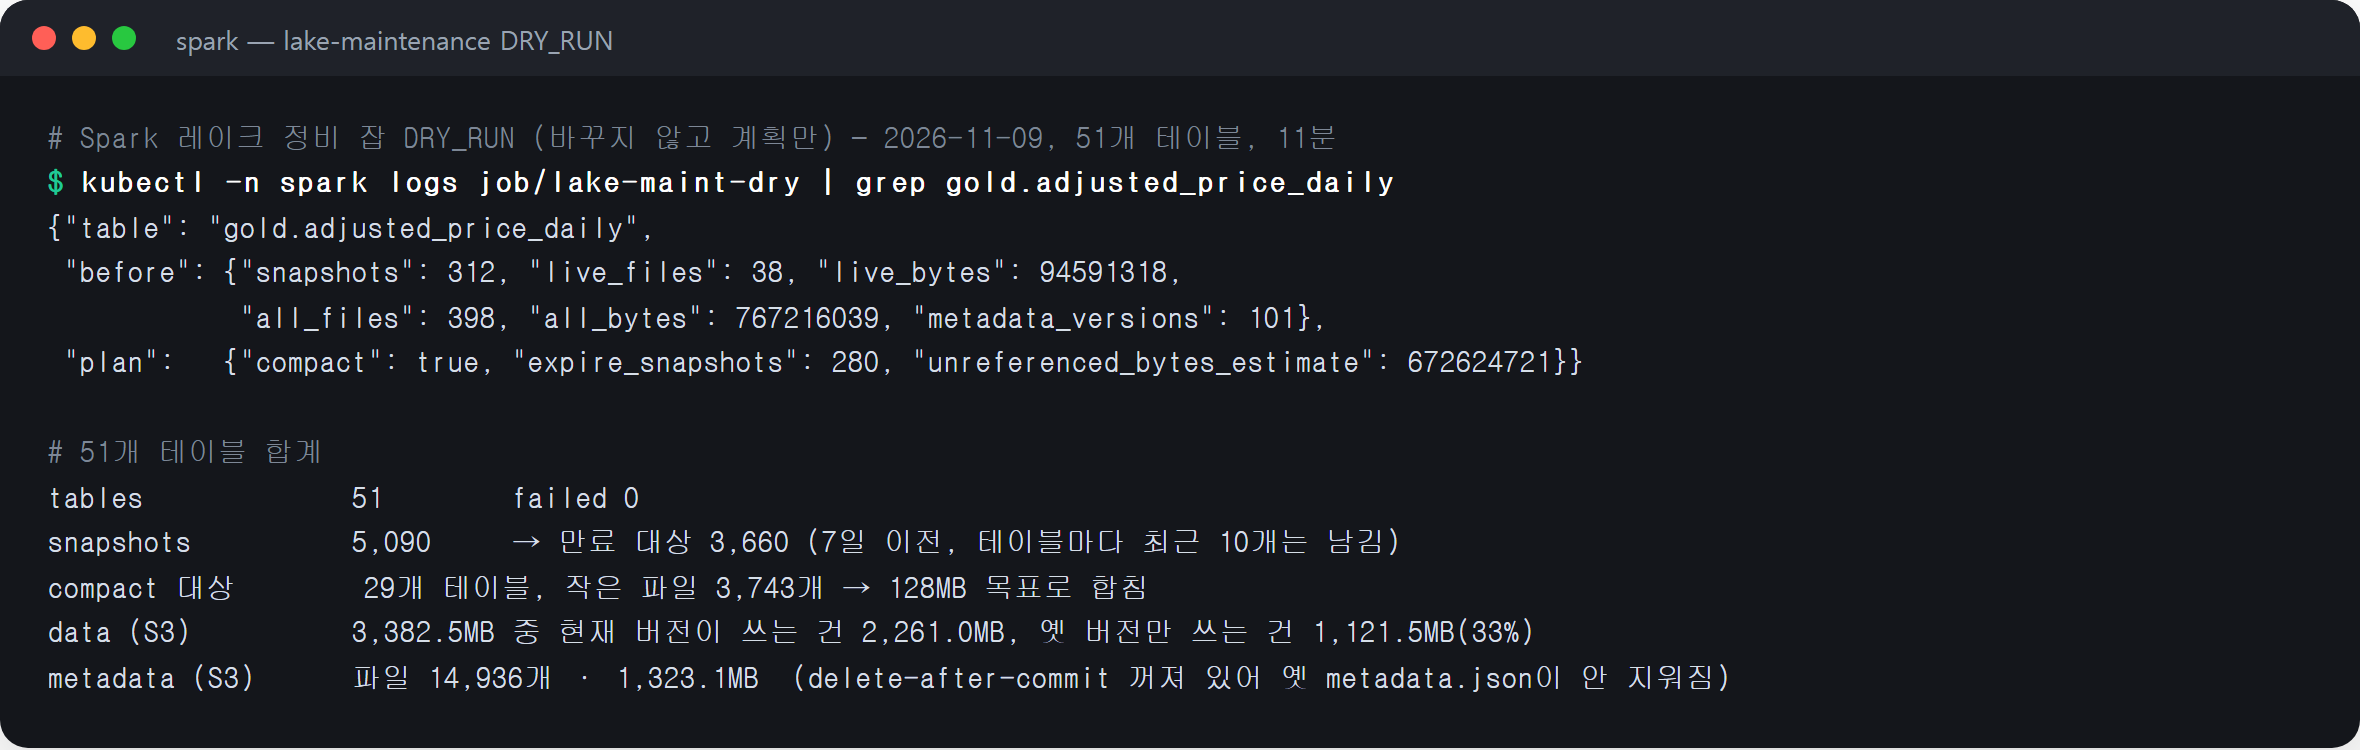
bronze 를 통째로 합쳤더니 Trino count(*) 는 약 2배 빨라졌습니다. 그런데 매일 도는 정제는 bronze 를 "최근 36시간" 으로 걸러서 읽고 있었고 합친 큰 파일에는 처음부터 지금까지의 적재가 섞여 있어서 걸러내기가 먹히지 않았습니다.
| "최근 36시간" 조회 | 읽는 파일 | 읽는 양 |
|---|---|---|
| 합치기 전 (약 1,600개) | 약 120개 | 약 94MB |
| 통째로 합친 뒤 (11개) | 10개 | 약 1.4GB (약 14배) |
다음 날 배치가 터질 수 있는 상태여서 그날 밤 합치기 직전 Snapshot 으로 되돌렸습니다. 이후 규칙을 "7일 지난 파일만, 적재 시각 순으로 정렬해서" 합치는 것으로 바꿨고 읽는 양은 그대로 둔 채 스캔 계획 시간만 20 ~ 45배 줄일 수 있었습니다.
6. 결론
7월에 설계를 시작해서 11월 중순까지, 여러 증권 계좌의 자산을 한곳에서 보고 조건이 맞으면 알림을 받는 앱의 데이터 쪽을 처음부터 끝까지 만들어 볼 수 있었습니다. 지금은 약 16,000 종목의 일봉이 매일 밤 Lake 를 거쳐 앱 DB 까지 들어가고, 계좌 잔고와 장중 시세도 정해진 주기로 수집되고 있습니다. 프로젝트를 마치면서 KPT 로 회고를 정리해 보았습니다.
6.1 Keep : 계속 가져갈 것
- 완료 신호를 처음부터 따로 둔 것 : 대상 종목이 전부 들어왔을 때만
DONE을 쓰도록 한 덕분에, 반쯤 들어온 데이터로 알림이 나간 적이 한 번도 없었습니다. - 원본을 Lake 에 남겨 둔 것 : KIS 가 과거 가격을 소급해서 바꿨을 때도 원본에서 다시 계산해서 복구할 수 있었습니다.
- 데이터 품질을 전수로 점검한 것 : 테스트가 전부 통과하는 상태에서도 가격 점프 45건이 나왔습니다. 테스트는 코드를 검증하고, 데이터는 따로 봐야 한다는 것을 알게 되었습니다.
- 도메인 지표에 알림을 건 것 : 노드 CPU 대신 "국내 일봉이 21시까지 왔는가" 같은 지표에 걸었더니, 적용한 지 10분 만에 서비스를 멈출 수도 있었던 WAL 문제를 잡아 줬습니다.
- 숫자를 재고 나서 고친 것 : 최적화는 모두 운영 기록에서 전후를 재면서 진행했고, 효과가 없거나 오히려 나빠진 것(bronze 통째로 합치기)도 바로 알아채고 되돌릴 수 있었습니다.
6.2 Problem : 아쉬웠던 것
- 스트리밍 스택을 너무 일찍 올린 것 : 요구사항이 배치로 충분한지 확인하기 전에 Kafka 와 Flink 부터 올렸고, 그 스택이 두 달 동안 일 없이 메모리를 가장 많이 쓰면서 WAL 문제까지 만들었습니다.
- 경보 없이 6주를 운영한 것 : 알림 규칙을 마지막 주에야 넣었기 때문에, 그 전까지의 장애는 절반 정도를 우연히 보거나 팀원이 물어봐서 알게 되었습니다.
- 목표 시각을 끝에 가서야 정한 것 : "국내 일봉은 21시까지" 같은 기준을 처음에 정해 두었다면, "해외 전체" 요구가 들어왔을 때 그 비용을 바로 이야기할 수 있었을 것입니다.
- 동기화 버튼을 누르고 최대 하루를 기다리는 구조 : 수집 자체는 약 5분이면 끝나는데, 배치가 하루에 한 번만 돌아서 사용자는 그만큼 기다려야 했습니다.
- 이미지 태그를 사람이 올려야 했던 것 : 코드를 머지해도 DAG 의 이미지 태그를 올리지 않으면 배포가 되지 않는데, 이걸 두 번 놓쳤습니다.
6.3 Try : 다음에 시도할 것
- 요구사항의 주기부터 확정하고 스택을 올린다 : "어떤 데이터가 사라지고 무엇이 쌓이는가" 를 먼저 묻고, 필요한 만큼만 올립니다.
- 첫날부터 도메인 지표에 알림을 건다 : 목표 시각을 먼저 정하고, 그 기준으로 알림 규칙과 수신처까지 같이 붙입니다.
- 수집 요청이 들어오면 바로 처리한다 : 요청 행을 감지해서 수집을 즉시 실행하면 하루 대기를 10분 안쪽으로 줄일 수 있습니다.
- 이미지 태그 갱신을 자동화한다 : 커밋 해시로 고정하는 것은 유지하되, CI 가 DAG 저장소에 태그를 올리는 PR 을 열도록 합니다.
- 데이터 품질 검사를 매일 돌린다 : 가격 점프와 OHLC 검사를 한 번의 점검으로 끝내지 않고 매일 도는 Task 로 넣습니다.
설계 문서로만 그려 보던 구조를 실제 데이터로 돌려 보고, 장애를 겪고, 숫자를 재서 고쳐 본 것이 이번 프로젝트에서 가장 크게 얻은 것이라고 생각합니다.
7. 참고
- GitHub Organization : stock-project-crew
- 설계 문서 저장소 : stock-project-crew/docs